PostgreSQL 慢查询诊断方法
本文使用 2021 年 2 月的 Pigsty 沙箱与仪表盘演示。
慢查询会占用连接、持有锁,并消耗 CPU 与 I/O。在备库上,长查询还可能与 WAL 重放冲突。PostgreSQL 会根据备库参数延迟重放或取消冲突查询,具体行为见热备冲突处理。
监控可以帮助我们找到受影响的查询,并比较变更前后的表现。
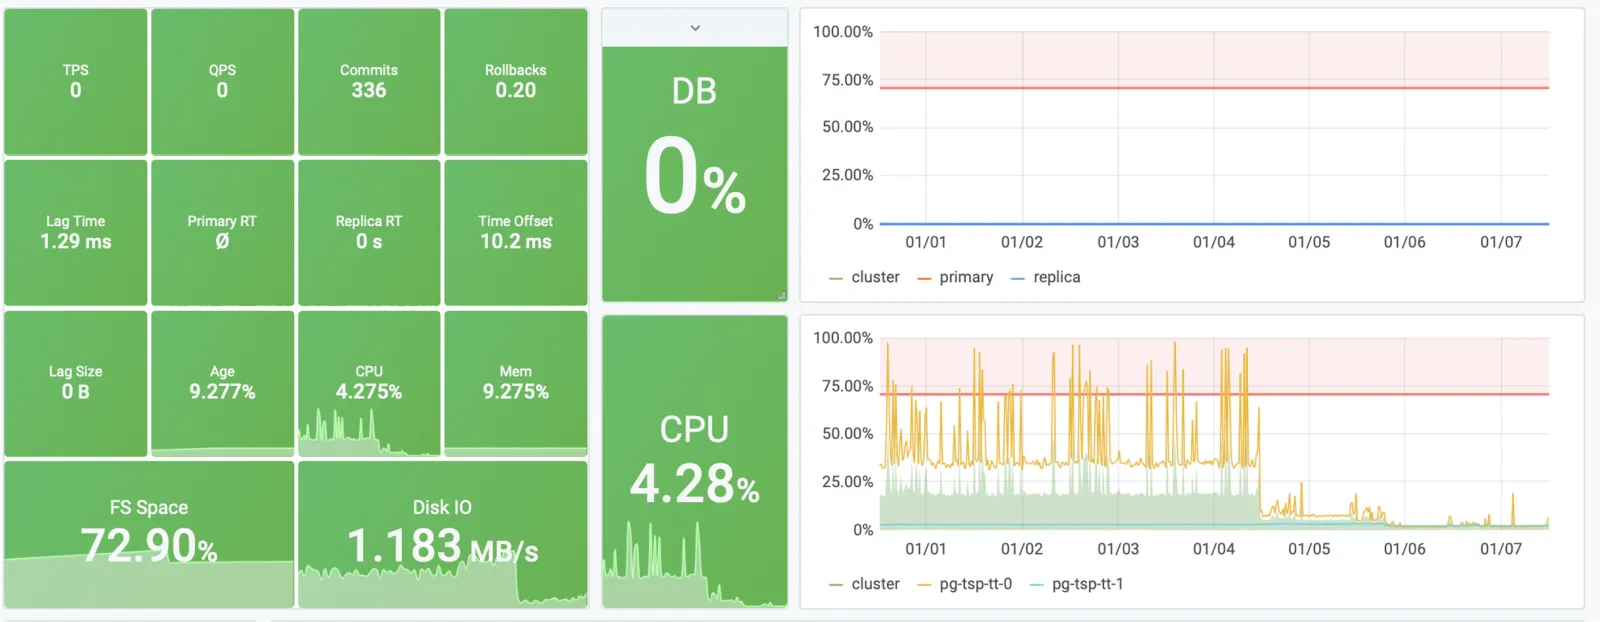
本例中,查询优化将 CPU 使用率从约 40% 降至 4%。
收集查询统计与日志
pg_stat_statements 扩展汇总相似语句的调用次数、执行时间、读取或影响的行数与 I/O 统计。按以下步骤启用:
- 将
pg_stat_statements加入shared_preload_libraries。 - 重启 PostgreSQL。
- 在需要读取统计信息的数据库中执行
CREATE EXTENSION pg_stat_statements。
查询 ID 标识归一化后的语句,不代表一次执行,也不保证使用同一个执行计划。统计列名会随 PostgreSQL 版本变化,使用时查阅对应版本的 pg_stat_statements 参考。
用 log_min_duration_statement 记录执行时间达到阈值的语句。日志适合分析某次慢执行。根据业务设置阈值:记录全部语句会增加日志量与采集开销。
累计平均值可能掩盖近期性能变化。通过连续采样,可以比较故障期间的响应时间、调用速率与 I/O。慢查询阈值应来自业务延迟要求;频繁点查与偶发批处理需要不同的阈值。
在沙箱中复现问题
本实验会主动删除索引,请使用可丢弃的 pgbench 测试数据库。
当时的 Pigsty 沙箱通过 make ri、make ro 和 make rw 初始化并运行 pg-test 集群上的负载。以下命令通过服务端口施加读写负载:
在不同终端运行两组负载,然后在主库上删除主键:
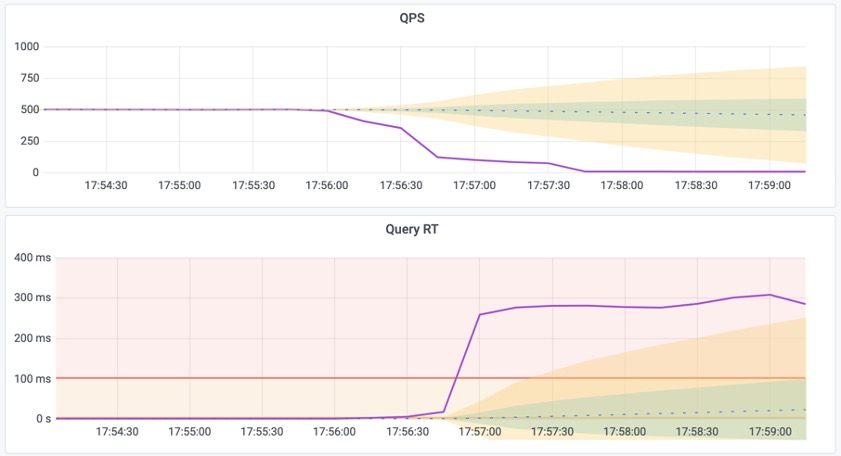
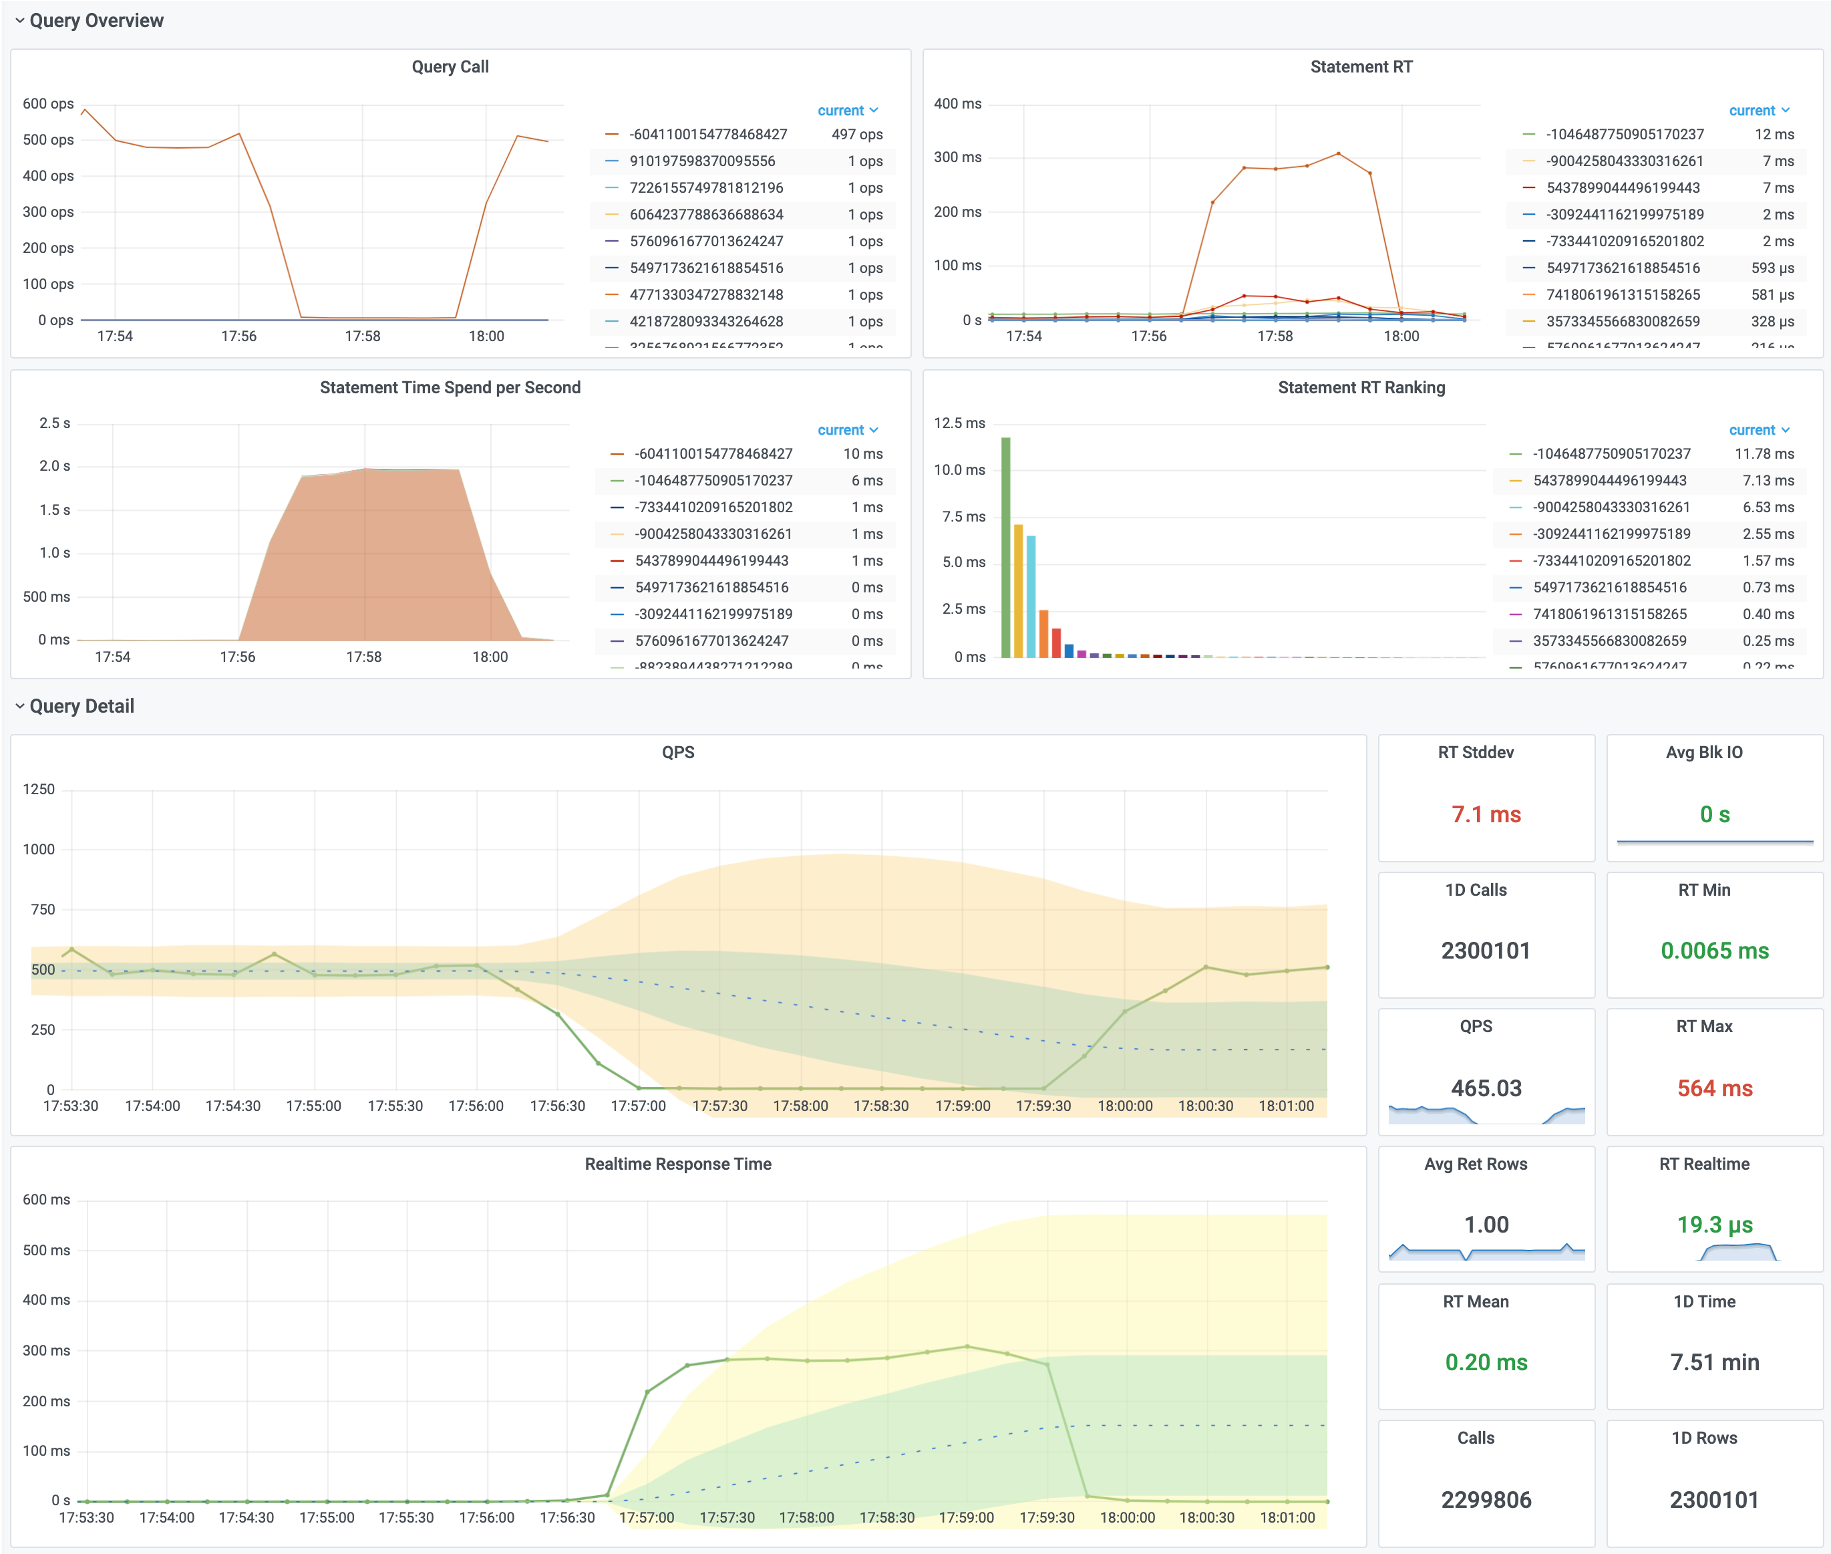
点查失去了索引。本次测试中,平均响应时间从约 1 ms 增至 300 ms,一个备库的 QPS 从 500 降至 7。
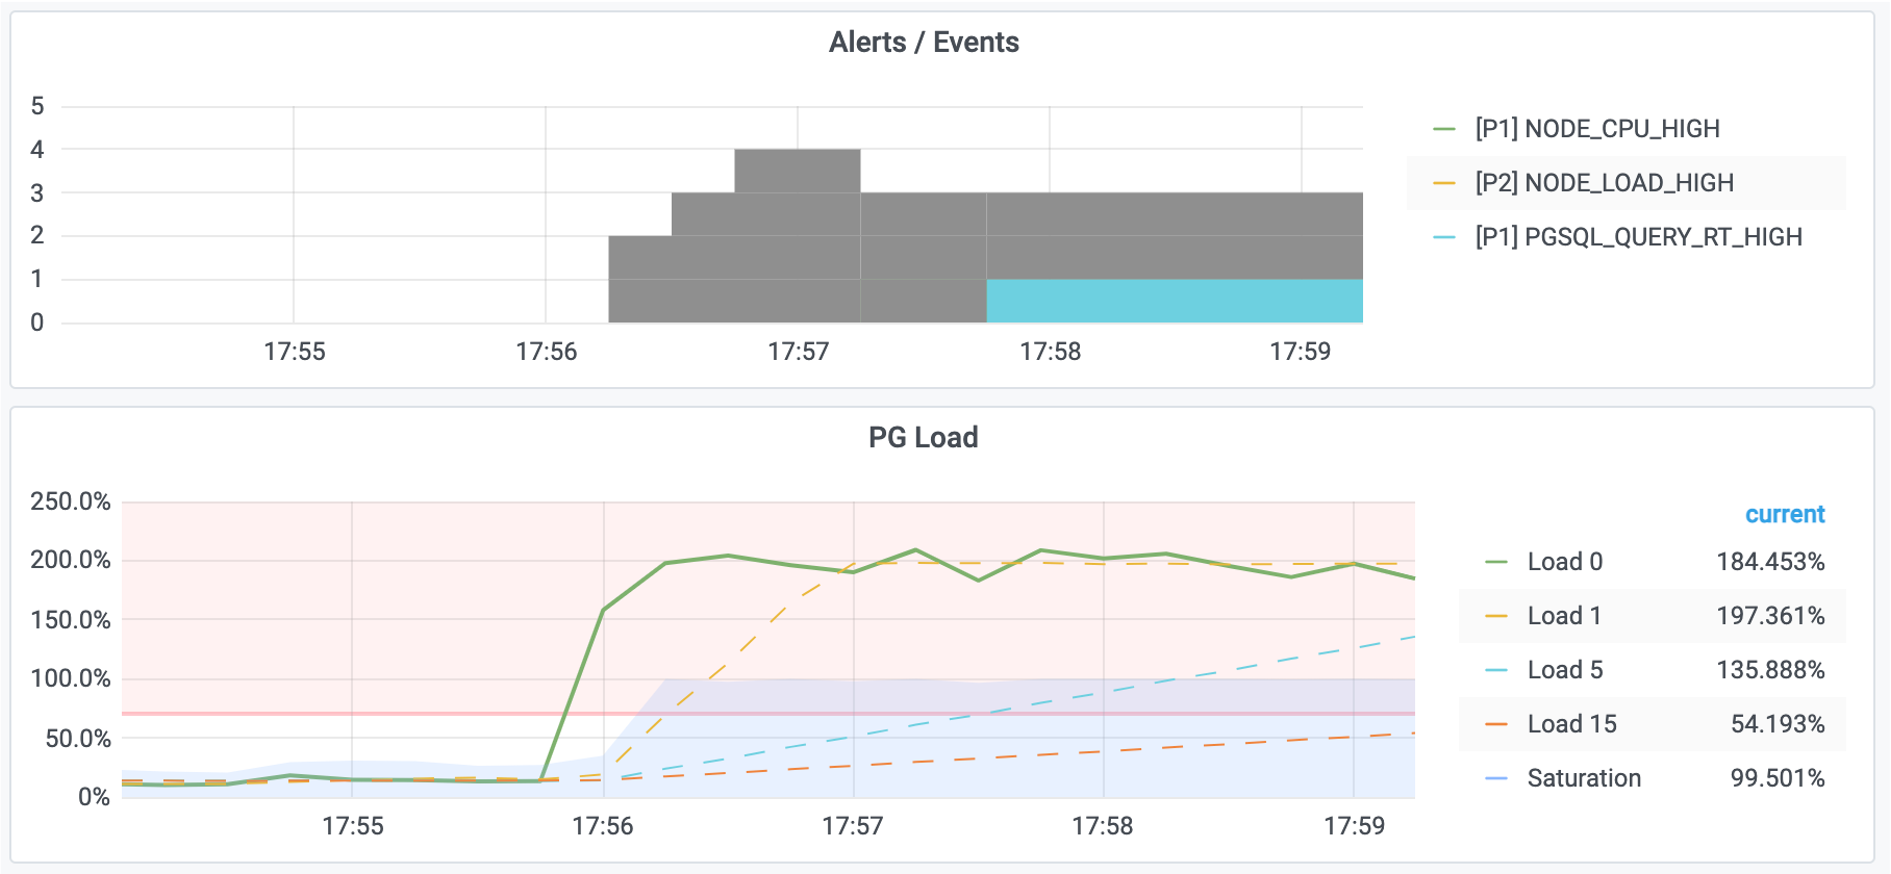
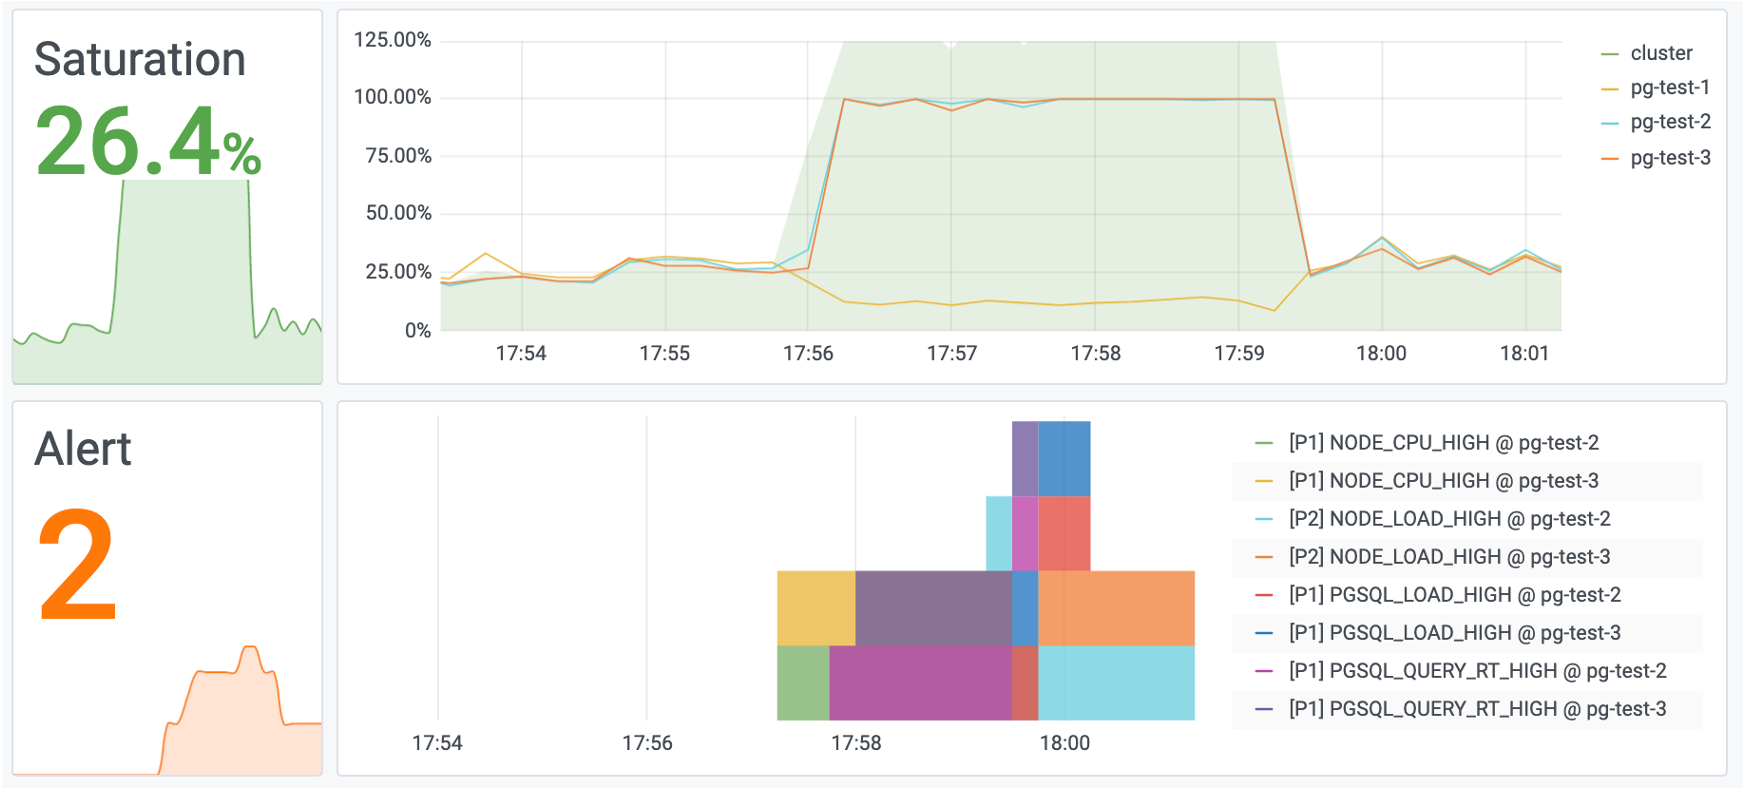
集群负载也随之上升,并触发告警。
定位查询
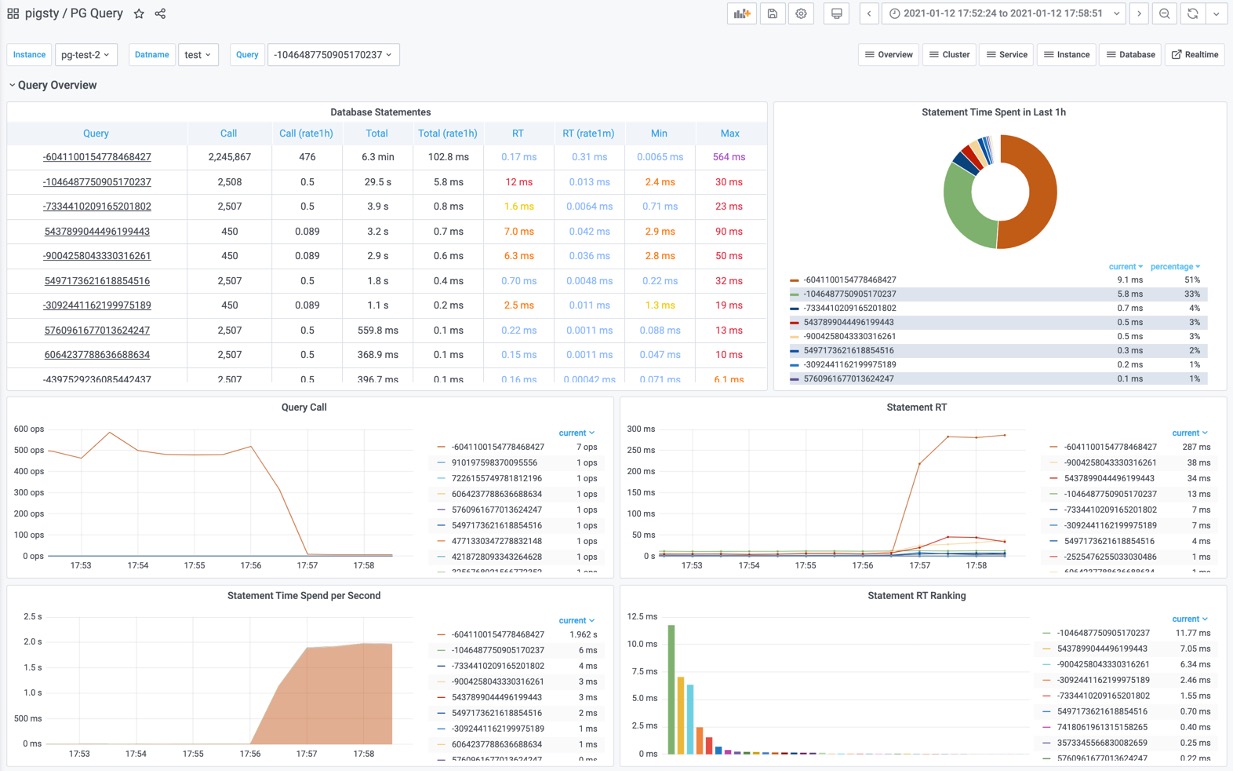
打开 PG Cluster 面板,找到受影响的实例。再打开 PG Query,定位响应时间和执行时间占比上升的语句。
本例中,查询 ID -6041100154778468427 的响应时间从约 17 μs 增至 280 ms,QPS 从 500 降至 7。
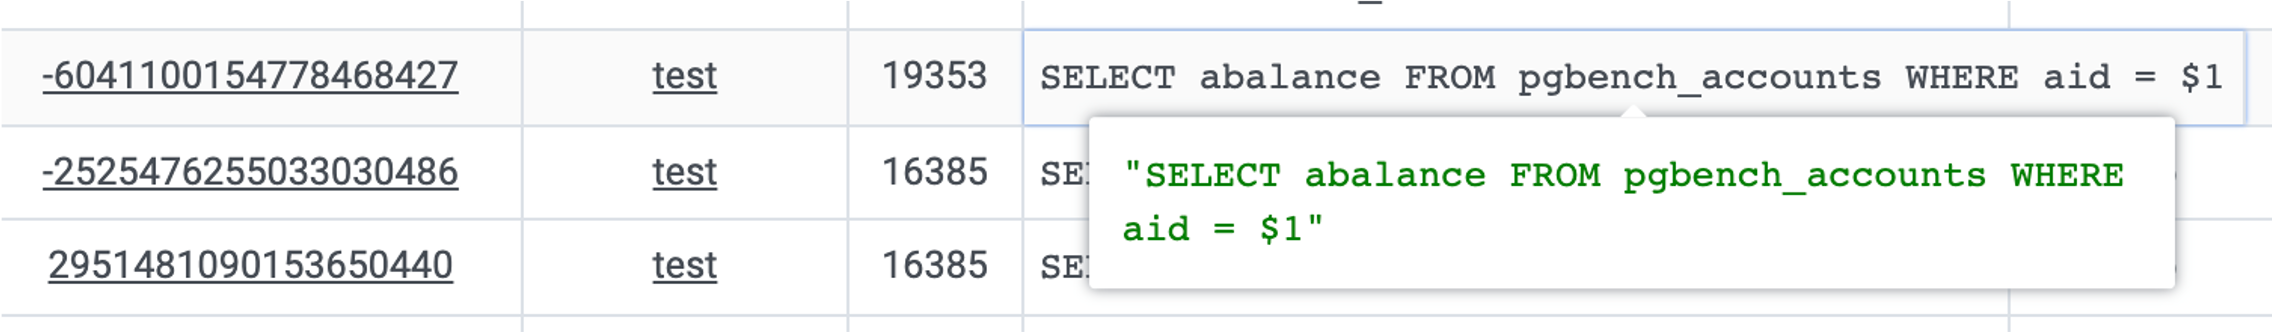
按查询 ID 打开 PG Query Detail,找到对应 SQL:
验证原因
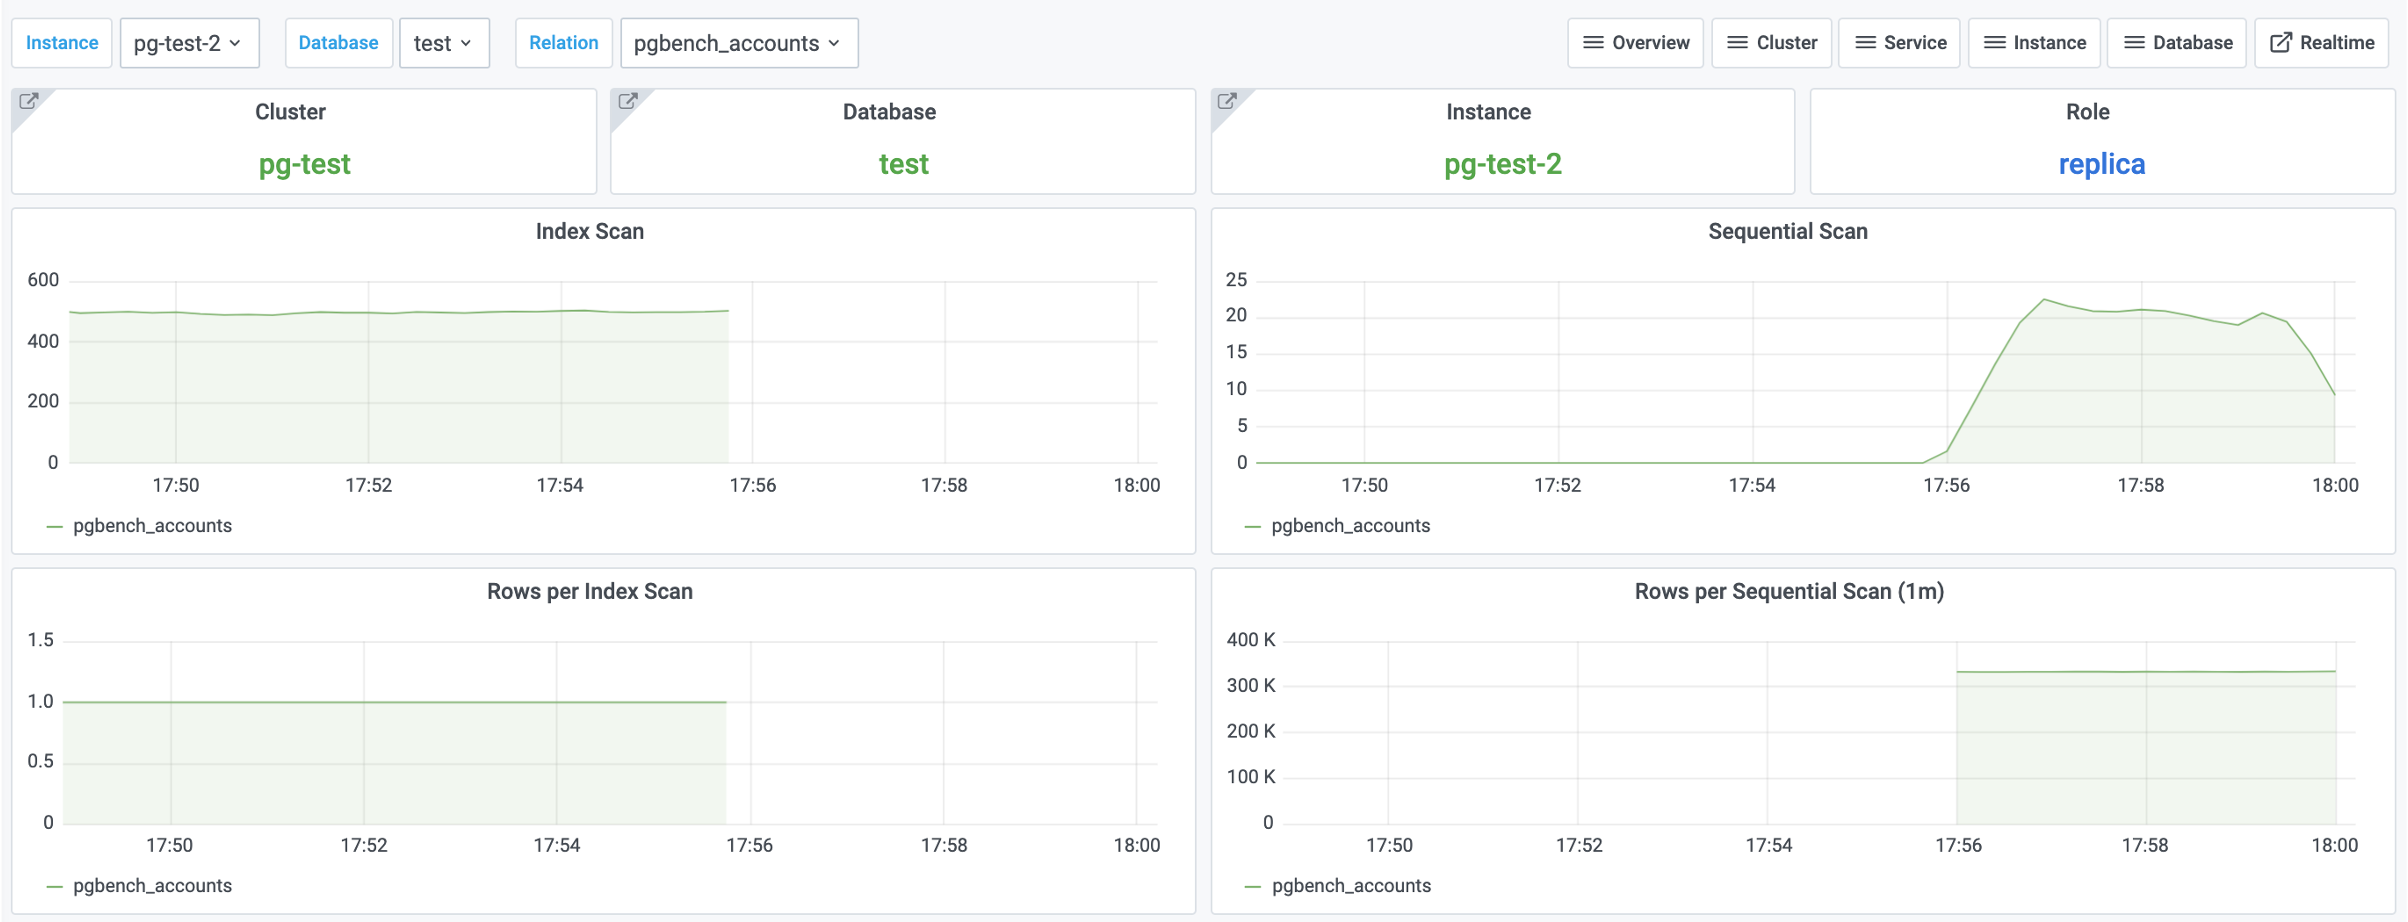
这条语句按 aid 读取一个账户。在 PG Table Catalog 中检查该列是否有索引,再到 PG Table Detail 比较 pgbench_accounts 的索引扫描与顺序扫描次数。
本实验中,删除主键后索引扫描降至零,顺序扫描随之增加,与索引缺失的判断一致。
修复并检查结果
在沙箱中为 aid 恢复索引:
这会恢复索引访问路径,但不会重建此前删除的主键约束。
用相同负载与时间区间比较变更前后的结果,记录查询延迟、吞吐量和资源使用情况。完成实验后停止测试负载。