PostgreSQL 宏观查询优化之 pg_stat_statements
本文记录 2023 年的监控方法,示例采用 PostgreSQL 15 的字段和当时的监控面板。
参考原文:Nikolay Samokhvalov 的 PostgreSQL HowTO: pg_stat_statements 系列(第一篇、第二篇、第三篇)。
慢查询会增加响应时间和资源消耗,也可能延长锁等待,增加连接压力。因此,查询优化是 DBA 的核心工作之一。
在查询优化这条路上,有两种不同的方法:
宏观优化:整体分析工作负载,对其进行剖分下钻,自上而下地识别并改进其中表现最糟糕的部分。
微观优化:结合执行计划、慢查询日志和等待事件,分析并改进一条具体查询。
今天我们先来说说前者,宏观优化 有三个主要目标与动机:
减少资源消耗:降低资源饱和的风险,优化CPU/内存/IO,通常以查询 总耗时/总IO 作为优化目标。
改善用户体验:最常见的优化目标,在OLTP系统中通常以降低 查询平均响应时间 作为优化目标。
平衡工作负载:确保不同查询组之间的资源使用/性能表现的比例关系得当。
这些目标需要查询级别的数据支撑。pg_stat_statements 就提供了这些数据。
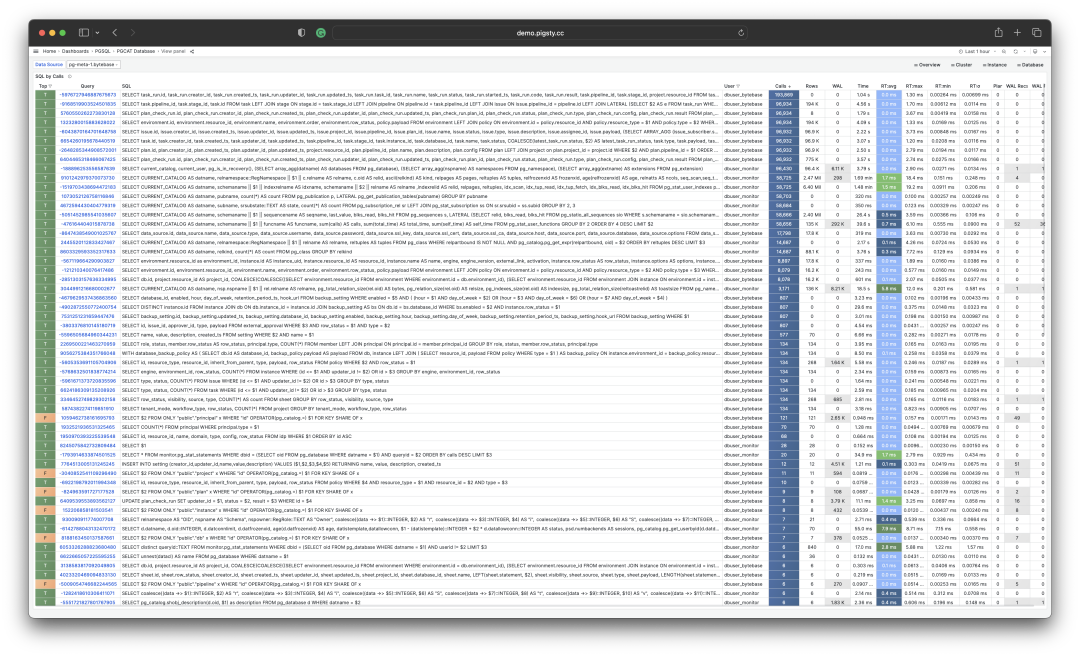
扩展插件:PGSS
pg_stat_statements,以下简称 PGSS ,是践行观宏之道的核心工具。
PGSS 出自 PostgreSQL 全球开发组官方之手,以第一方扩展插件的形式,随数据库内核本体一并发行,提供了跟踪 SQL 查询语句级别指标的方法。
我认为 PGSS 是生产监控的必备扩展。本文写作时,Pigsty 默认加载 PGSS 和 auto_explain,后者用于分析具体查询的执行计划。
将 pg_stat_statements 加入 shared_preload_libraries,重启 PostgreSQL,再在需要访问统计视图的数据库中执行 CREATE EXTENSION pg_stat_statements。PostgreSQL 15 还需要启用查询 ID 计算,默认的 compute_query_id = auto 即可满足要求。
PGSS 按规范化查询结构、数据库、用户和是否为顶层语句分组。同一查询组可以采用不同的执行计划。下面用建表语法展示 PostgreSQL 15 视图的字段;安装时应创建扩展,无需执行这段定义。
PostgreSQL 15 视图字段。所有时间字段的单位均为毫秒。下文的 pg_query_exec_time 指标将执行时间转换为秒。I/O 耗时需要启用 track_io_timing,计划统计需要启用 pg_stat_statements.track_planning。
执行统计在语句成功完成后更新。正在执行的语句看 pg_stat_activity,错误看日志。如果计划阶段成功、执行阶段失败,PGSS 仍可能记录计划统计。
queryid 取决于解析后的查询及其引用的数据库对象。物理副本通常具有相同的 ID。跨 PostgreSQL 大版本、逻辑副本,或删除后重建对象时,不应将它用作永久标识。
原始数据
PGSS 视图中的列可以分为三类:
描述性的标签列(Label):查询ID(queryid)、数据库 ID(dbid)、用户(userid),一个顶层查询标记,和标准化的查询文本(query)。
测量性的指标(Gauge):与最小、最大、均值标准差有关的八列统计量,以 min,max,mean,stddev 作为前缀,以 plan_time 与 exec_time 作为后缀。
累积性的指标(Counter):除了上面八列与标签列的 其他指标,例如 calls、rows 等,最重要、最有用的指标都在这一类里。
首先解释一下 queryid:queryid 是查询语句被解析后,剥离常量后生成规范化查询的哈希值,因此可以用来标识 同一类查询。不同的查询语句可能有着同样的 queryid (规范化后结构一样),同样的查询语句也可能有着不同的 queryid (例如因为 search_path 不同,导致实际查询的表不同)。
同样的查询可能会在不同的数据库中被不同的用户所执行。因此在 PGSS 视图中,queryid,dbid,userid,toplevel 四个标签列,共同组成了唯一标识一条记录的“主键”。
对于指标列而言,测量性质的指标(GAUGE) 主要是执行时间与计划时间相关的八个统计量,然而用户没有办法很好地控制这些统计量的统计范围,所以实用价值并不大。
真正重要的指标是 累积性的指标(Counter),例如:
calls :此查询组发生了多少次调用。
total_exec_time + total_plan_time:查询组累计耗费时间。
rows:查询组累计检索或影响的行数。
shared_blks_hit + shared_blks_read:缓冲池累计命中和读取操作次数。
wal_bytes:此组中的查询累计生成的 WAL 字节数。
blk_read_time 和 blk_write_time:累计花费在块读写IO上的时间
这里,最有意义的指标是 calls 与 total_exec_time,可以用于计算查询组的核心指标 QPS (吞吐量)与 RT(延迟/响应时间),但其他的指标也很有参考价值。
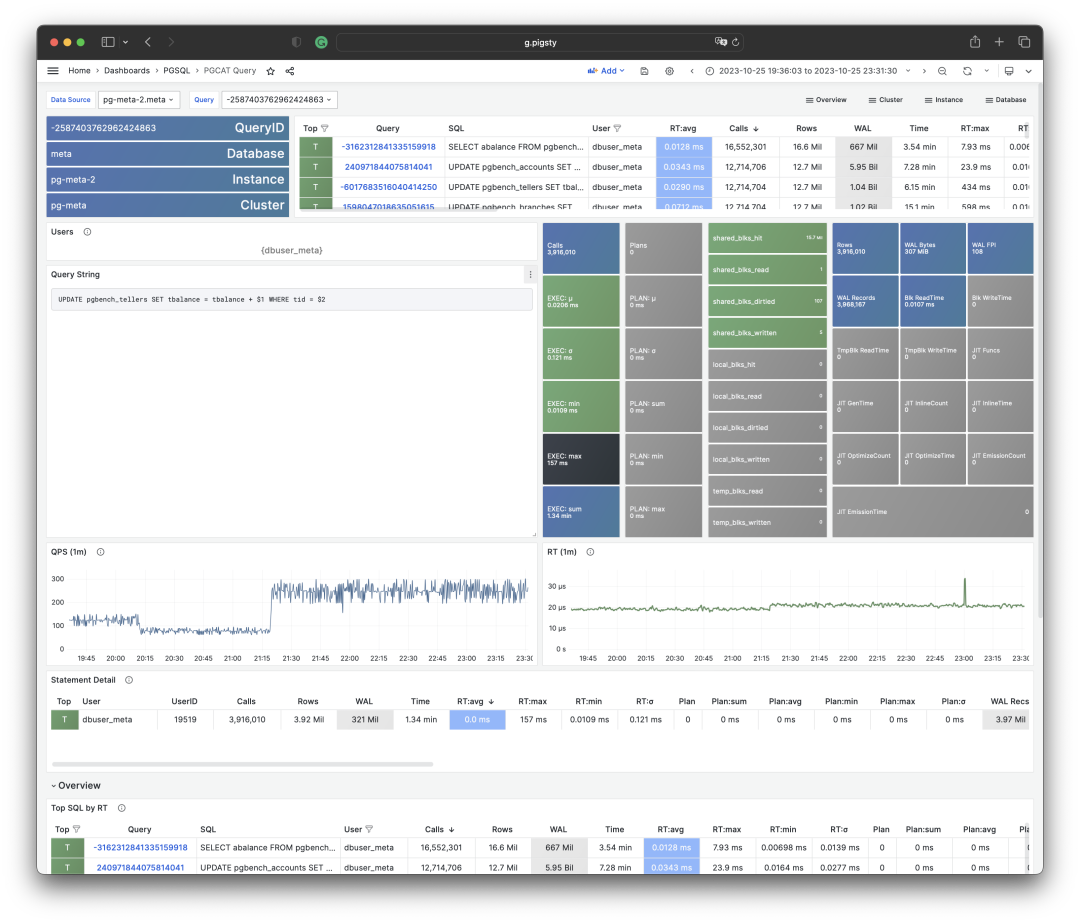
可视化展现 PGSS 视图的某个查询组快照
要衡量一段时间内的活动,至少比较两个快照。先匹配相同的查询组标识,再处理计数器重置或条目淘汰,最后计算差值。
单个快照表示该条目自开始统计以来的累积工作量。分析具体故障时,时间窗口内的增量更有用。
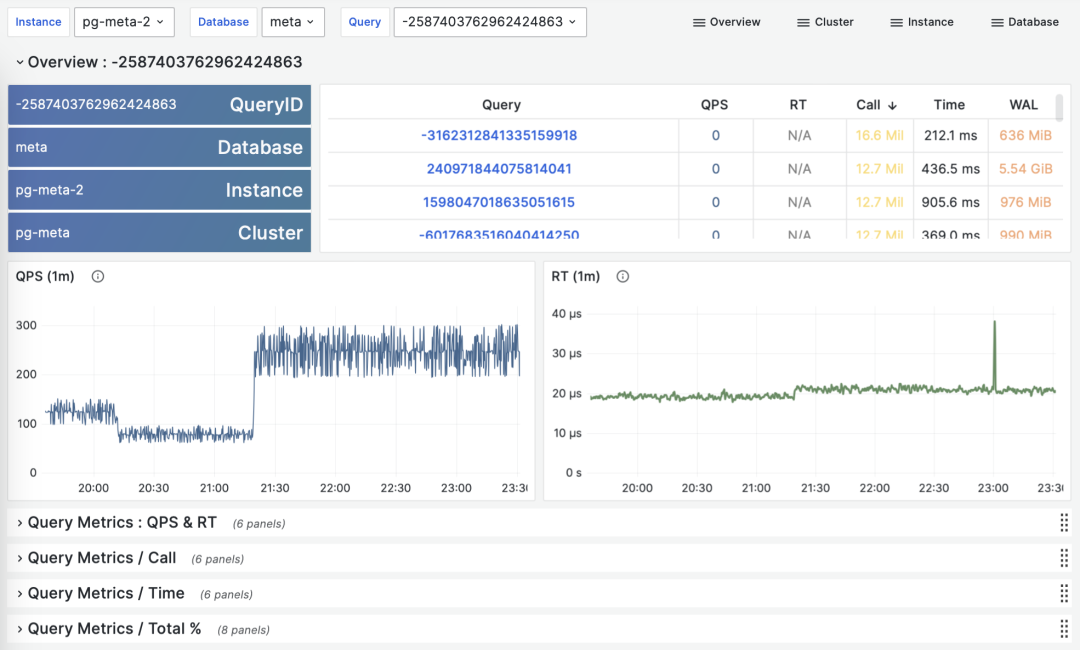
根据多个 PGSS 查询组快照计算历史时序指标
本文所用的 Pigsty 部署每隔 10 秒截取总耗时排名前 256 的查询快照。有了累积指标 M 在不同时刻的采样,就可以计算三类派生指标:
dM/dt :指标 M 基于时间的微分,即每秒的增量。
dM/dc:指标 M 基于调用次数的微分,即每次调用的平均增量。
%M:指标 M 在整个工作负载中所占的百分比。
这三类指标正好与宏观优化的三类目标相对应,对时间的微分 dM/dt 揭示了 每秒资源使用量,通常用于减少资源消耗的优化目标。对调用次数的微分 dM/dc 揭示了 每次调用的资源使用量,通常用于改善用户体验的优化目标。而百分比指标 %M 展示了查询组在整个工作负载中所占的百分比,通常用于平衡工作负载的优化目标。
对时间微分
让我们首先来看第一类指标:对时间的微分。在这里,我们可以使用的指标 M 包括:calls,total_exec_time,rows,wal_bytes,shared_blks_hit + shared_blks_read,以及 blk_read_time + blk_write_time。其他的指标也有参考意义,但让我们从最重要的开始。
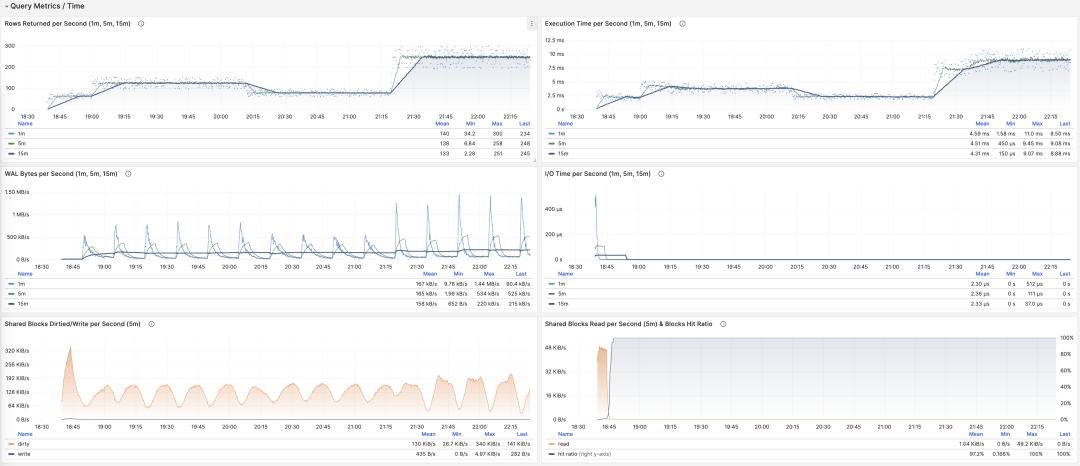
可视化展现对时间的微分指标 dM/dt
计算这些指标的方式其实很简单,我们只需要:
- 首先计算两个快照之间的指标值 M 的差值:M2 - M1
- 然后计算两个快照之间的时间差值:t2 - t1
- 最终计算 (M2 - M1) / (t2 - t1) 即可
生产环境通常会使用 5s,10s,15s,30s,60s 这样的数据采样间隔。对于负载分析通常会使用 1m, 5m,15m 作为常用的分析窗口大小。
例如,当我们计算 QPS 时,就会分别计算最近 1分钟,5分钟,15分钟的 QPS。窗口越长曲线就越平稳,更能反映长期变化趋势;但是会隐藏短期波动细节,不利于发现瞬时异常波动,所以不同粒度的指标需要结合来看。
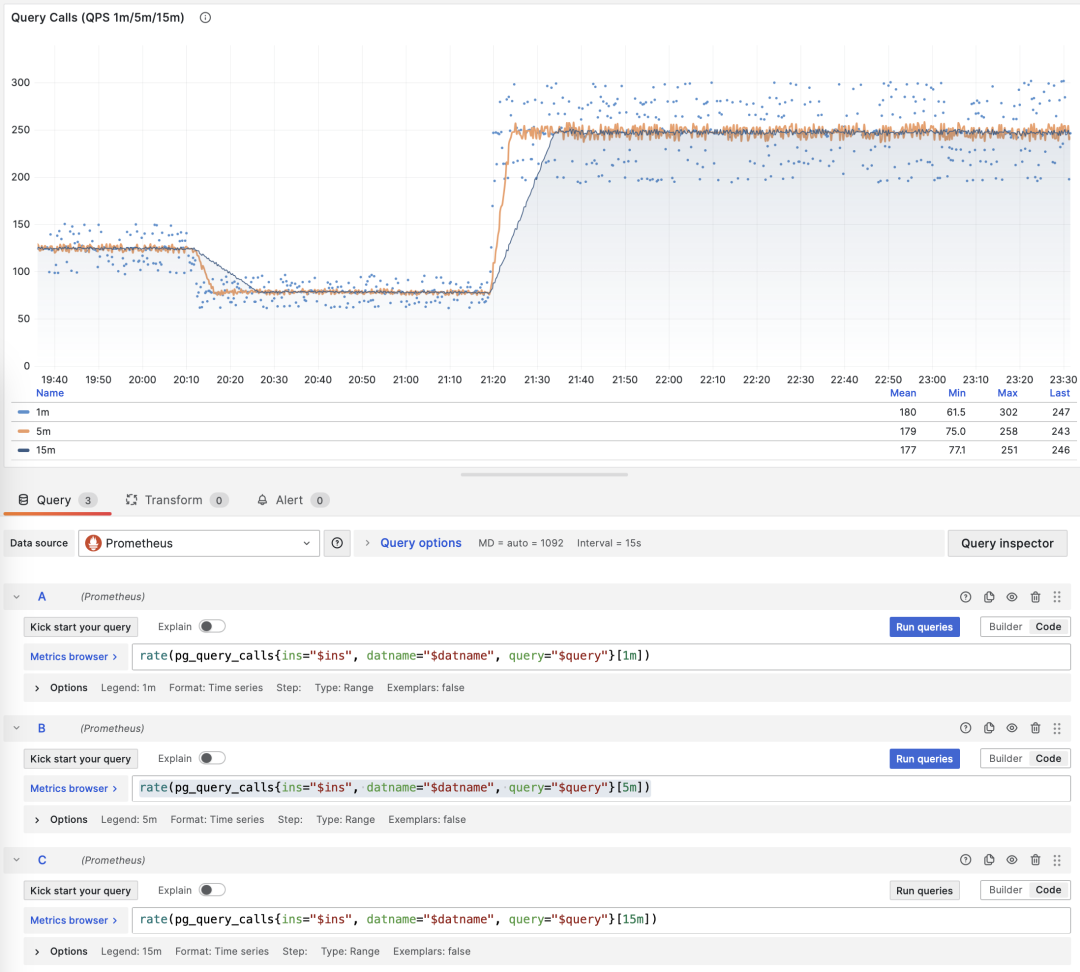
展示特定查询组 1/5/15 分钟窗口下的 QPS
例如,rate(pg_query_calls{}[1m]) 计算每条已采集查询组序列在最近一分钟内的 QPS。计算总量时,先筛选目标实例,再对这些序列求和。
QPS
当 M 是 calls 时,对时间求导的结果是 QPS,它的单位是每秒查询数(req/s),这是一个非常基础的指标。查询 QPS 属于吞吐量指标,直接反应了业务施加的负载状况,如果一个查询的吞吐量过高(例如,10000+)或者过低(例如,1-),有可能是值得关注的。
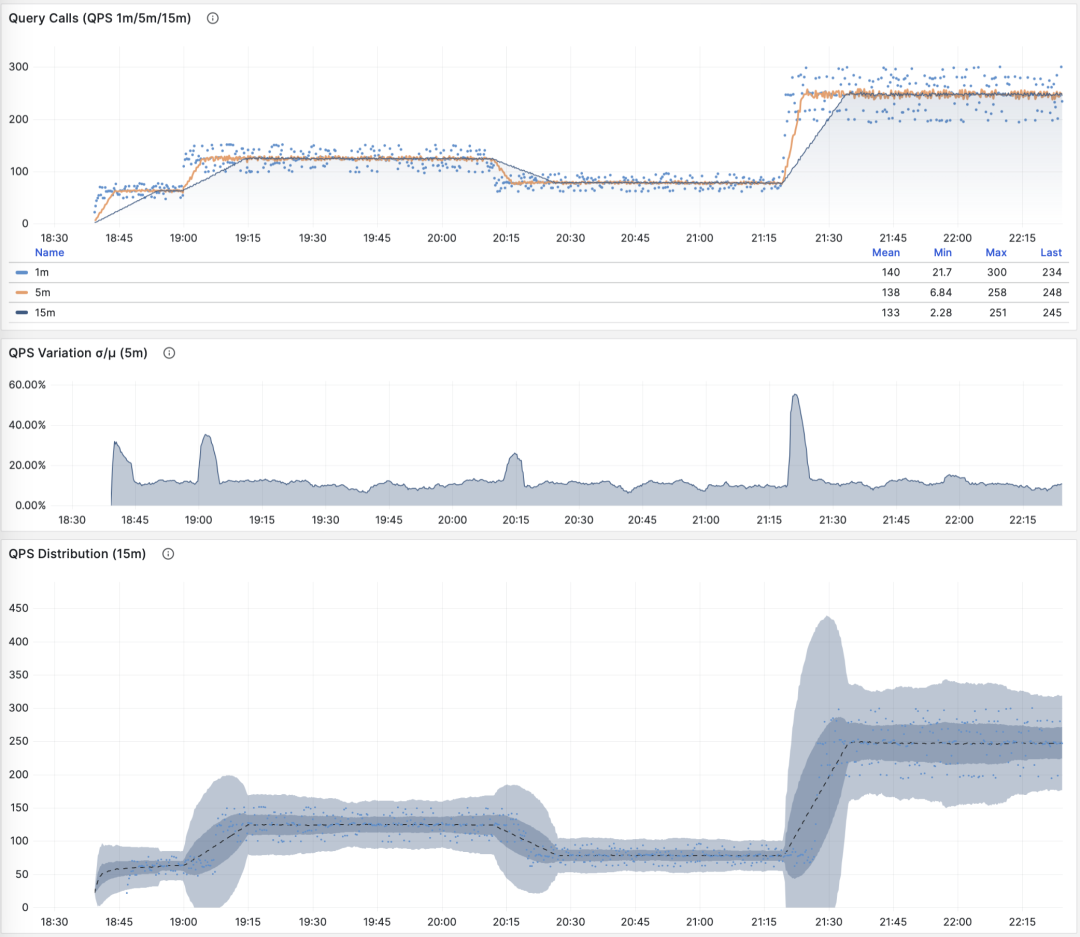
QPS:1/5/15 分钟 µ/CV, ±1/3σ分布
如果我们把所有查询组的 QPS 指标累加起来(且没超过PGSS的收集范围),就会得到所谓的 “全局QPS”。另一种获得全局 QPS 的方式是在客户端打点,在类似 PgBouncer 的连接池中间件上采集,或者使用 ebpf 探测。但都不如 PGSS 方便。
请注意,QPS 指标并不具备负载意义上的 横向可比性。不同查询组可能有着同样的 QPS,而单个查询的耗时却天差地别。甚至同一个查询组在不同时间点上产生的负载水平,也可能因为执行计划不同而发生巨大变化。每秒执行时长是一个更好的衡量负载的指标。
每秒执行时长
当 M 是 total_exec_time (+ total_plan_time,可选 )时,我们就会得到宏观优化中最重要的指标之一:在查询组上耗费的执行时间,有意思的是,这个导数的单位是 秒/每秒,所以分子分母相互约掉了,使得它实际上是一个无量纲的指标。
例如,2 s/s 表示这组查询每秒累积了两秒的服务端执行时间。多个后端并发执行即可产生这个值,即使只有一个 CPU 核也可能出现:执行时间包含等待时间。
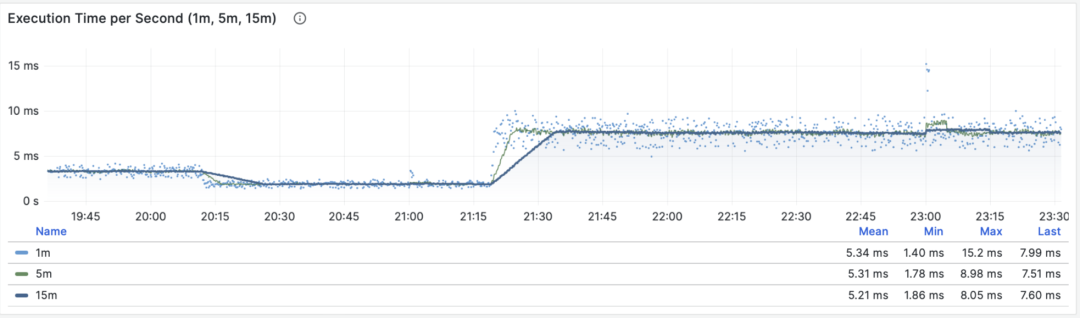
每秒执行时长:1/5/15 分钟均值
因此这里的值也可以理解为一个百分比:可以超过 100%,在这种视角下,它是一个类似于主机 load1, load5, load15 的指标,揭示了该查询组产生的 负载水平。如果除以 CPU 核数,甚至可以得到归一化的查询负载贡献度指标。
但是我们需要注意的是,执行时间中包括了等待锁,等待I/O的时间。所以确实可能出现这样的情况:查询执行时间很长,但却没有对 CPU 负载产生影响。所以如果要精细分析慢查询,我们还要参考 等待事件 来进一步分析才行。
每秒行数
当 M 是 rows 时,得到的是每秒检索或影响的行数。对于 SELECT 查询组,10000 rows/s 表示每秒产生一万行结果;对于 UPDATE 或 DELETE 查询组,它表示影响的行数,而不是发给客户端的数据量。
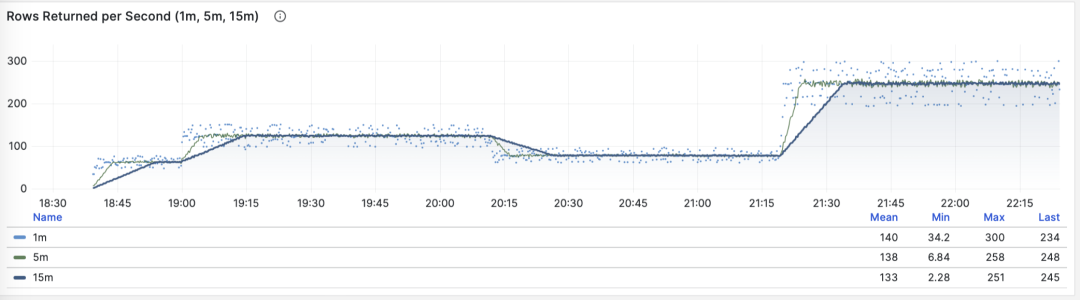
每秒检索或影响的行数:1/5/15 分钟均值
共享缓冲区访问带宽
当 M 是 shared_blks_hit + shared_blks_read 时,我们会得到每秒命中/读取的共享缓冲区块数,如果将其乘以默认块大小 8KiB(极少情况下有可能会是其他的大小,例如32KiB),我们就会得到一类查询“访问”内存磁盘的带宽:单位是字节/秒。
举个例子,如果某一类查询每秒访问50万次共享缓冲区,折合 3.8 GiB/s 的内部访问数据流:那么这就是一个显著负载,也许会是一个很好的优化候选项。也许你应该检查一下这个查询,看看它是否配得上这些“资源消耗”。
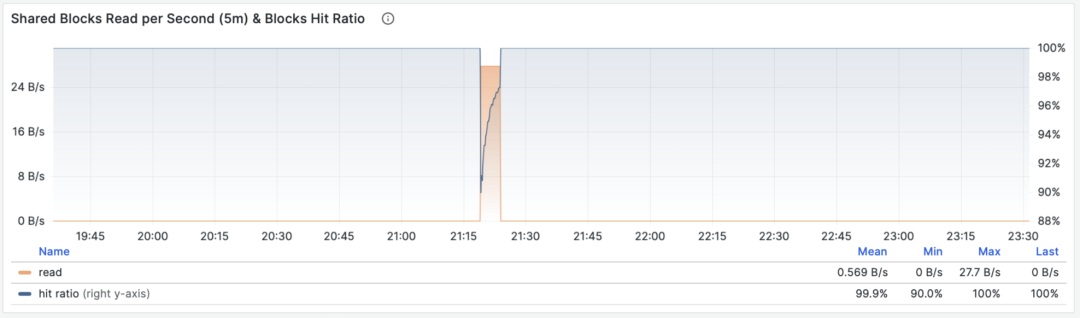
共享缓冲区访问带宽与缓冲区命中率
另一个值得参考的衍生指标是缓冲区命中率:即 hit / (hit + read) ,它可以用于分析性能变化的可能原因 —— 缓存未命中。当然,重复访问同一个共享缓冲池里的块,并不会真的重新读取,即使真的去读取,也不一定是读取磁盘,有可能是读内存中的FS Cache。所以这里只是一个参考值,但它确实是一个非常重要的宏观查询优化参考指标。
WAL日志量
当 M 是 wal_bytes 时,我们得到了该查询生成 WAL 的速率,单位是字节/每秒(B/s)。这个指标是在 PostgreSQL 13 新引入的,可以用来定量揭示查询产生的 WAL 大小:写入的 WAL 越多越快,刷写磁盘、物理复制/逻辑复制、日志归档的压力就会越大。
一个典型的例子是:BEGIN; DELETE FROM xxx; ROLLBACK; 。这样的事务删了很多数据,产生了大量 WAL 却没有执行任何有用的工作,通过这个指标可以将其揪出来。
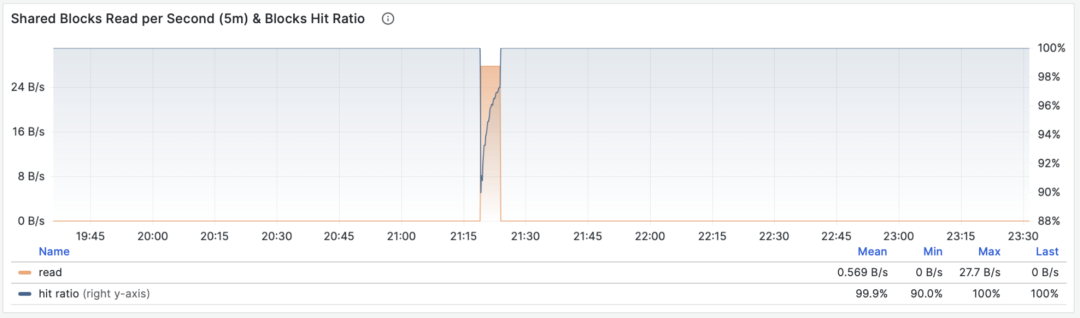
WAL字节率:1/5/15 分钟均值
DELETE 已经成功执行,之后显式执行的 ROLLBACK 撤销了事务。PGSS 会记录这条成功语句及其生成的 WAL。
SELECT 设置元组的 Hint Bit 时也可能生成 WAL。启用数据校验和或 wal_log_hints 后,检查点之后首次发生的此类页面修改可能需要写入全页镜像。参阅 WAL 配置。
可以检查 wal_fpi,判断读密集负载产生的 WAL 是否来自全页镜像。
共享缓冲区写脏/写回带宽
对于 13 以下的版本,共享缓冲区写脏/写回带宽指标可以作为一个近似下位替代,用于分析查询组的写入负载特征。
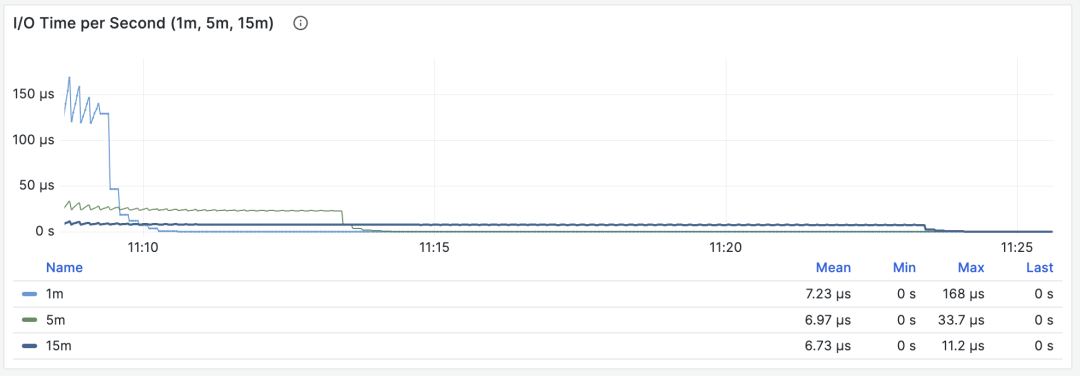
I/O耗时
当 M 是 blk_read_time + blk_write_time 时,先将毫秒转换为秒,再计算速率,得到每秒累积的 I/O 耗时。采集这些字段需要启用 track_io_timing。
I/O 耗时对于分析查询毛刺原因很有帮助
这些耗时包括由操作系统缓存满足的读取。结合主机磁盘指标,区分缓存读取与实际存储 I/O。
对时间微分的指标 dM/dt,可以展现出一个数据库实例/集群内部工作负载的全貌,对于优化资源使用的场景来说尤其有用。但是如果您的优化目标是改善用户体验,那么可能另一组指标 —— 对调用次数的微分 dM/dc,会更有参考意义。
对调用次数微分
计算 dM/dc 时,分母从时间差改为 调用次数的增量,结果表示每次完成的调用平均消耗多少资源。
这类指标重要性相比前者甚至更高,因为它提供了直接关乎用户体验的几个核心指标,比如最重要的 —— 查询响应时间 (RT,Response Time),或曰 延迟(Latency)。
计算这些指标的方式也很简单,我们只需要:
- 计算两个快照之间的指标值 M 的差值:M2 - M1
- 然后计算两个快照之间的 calls 差值:c2 - c1
- 然后计算 (M2 - M1) / (c2 - c1) 即可
对于 PromQL 实现来说,对于 调用次数的微分指标 dM/dc,可以用“对时间的微分指标 dM/dt” 计算得到。例如要计算 RT,就可以使用 每秒执行时长 / 每秒查询数 ,两指标相除即可:
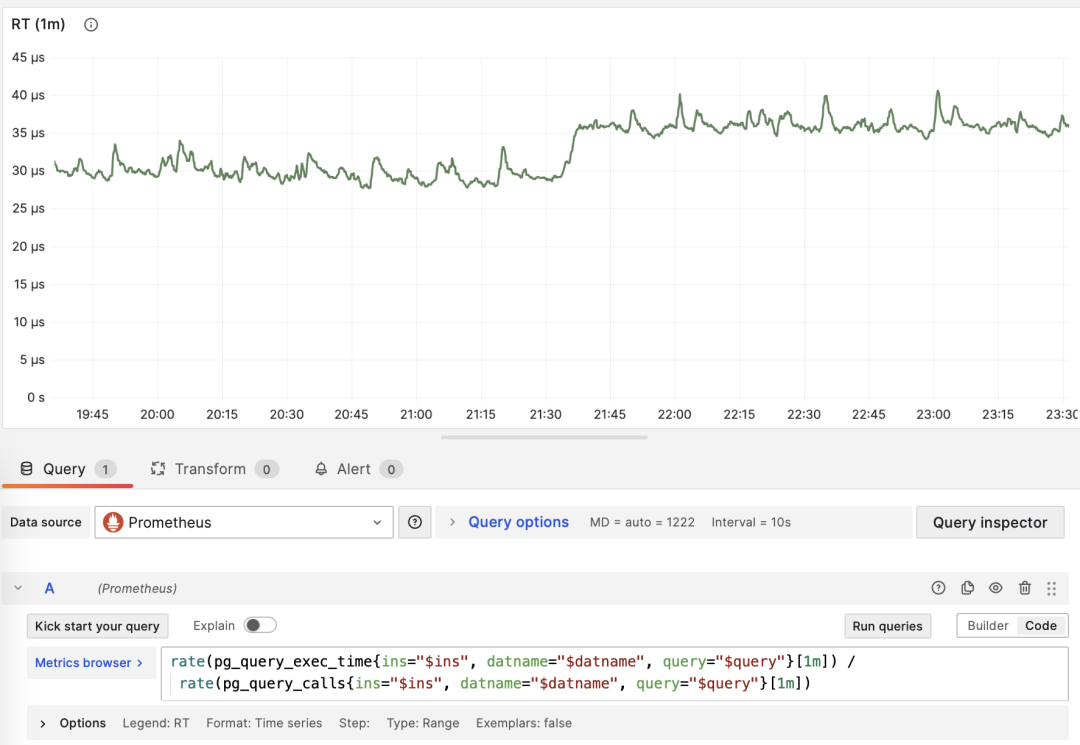
dM/dt 可以用于计算 dM/dc
调用次数
当 M 是 calls 时,对自己微分没有任何意义(结果会恒为 1)。
平均延迟/响应时间/RT
用 total_exec_time 的增量除以 calls 的增量,得到每次调用的平均服务端执行时间。PGSS 原始值算出的单位是毫秒,上面的 PromQL 示例使用秒。这是客户端响应时间的一部分;客户端计时还包含排队、网络和应用处理时间。启用计划统计后,可以另行加上计划耗时。
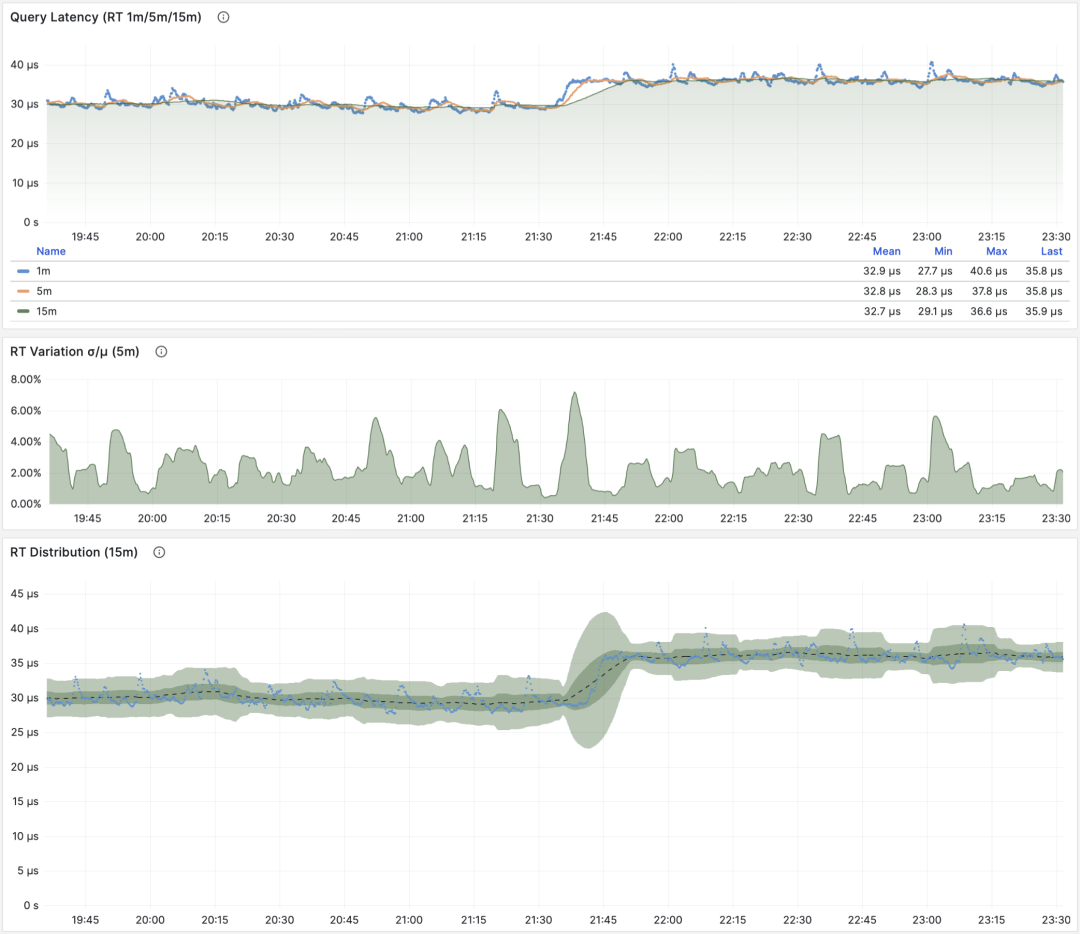
RT:1/5/15 分钟 µ/CV, ±1/3σ分布
这个均值覆盖已采集条目中的成功执行。pg_stat_statements.max 限制了 PGSS 可保留的查询组数量。比较工作负载时,需要确认采集覆盖范围。
客户端打点可以测量应用实际看到的响应时间。PgBouncer 和 PostgreSQL 14+ 还提供数据库级别的耗时汇总,PGSS 则提供查询组级别的细节。
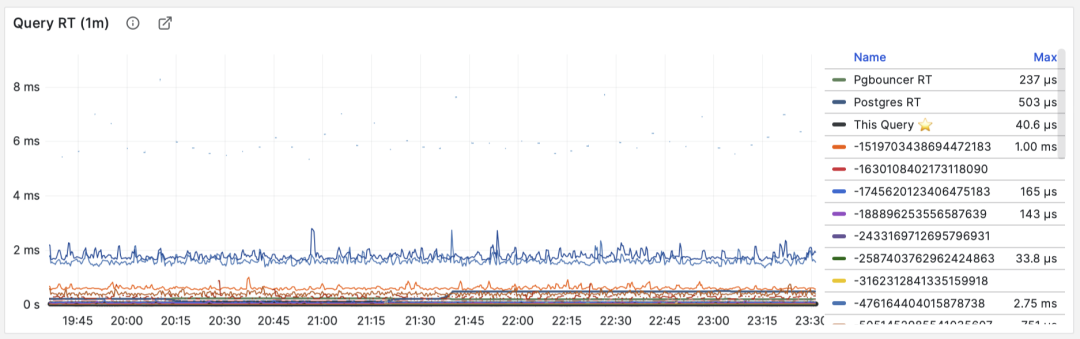
RT:语句级/连接池级/数据库级
在相近条件下比较同一查询组的 RT。如果平时均值低于 1 ms,突然升至 10 ms 以上,就值得调查。
当出现故障时, RT 视图对于定位原因也很有帮助:如果所有查询整体 RT 变慢,那么最有可能与资源不足有关。如果只是特定查询组的 RT 发生变化,那就更有可能是某些慢查询导致了问题,应当进一步调查分析。如果 RT 变化的时间点与应用发布部署吻合,则应当考虑是否要回滚这些部署。
此外,在性能分析,压力测试,基准测试时,RT 也是最重要的指标。你可以通过对比典型查询在不同环境(例如不同PG大版本、不同硬件、不同配置参数)下的延迟表现来评估系统的性能,并以此为依据不断对系统性能进行调整与改进。
对采样得到的 RT 序列计算均值和标准差,可以观察各时间窗口均值的波动。对这些均值计算分位数,得到的并不是单次查询耗时的 P95 或 P99。后者需要逐次观察值或耗时直方图。
评估 OLTP 性能时,应结合 RT、吞吐量和资源使用情况。
每次调用的平均行数
当 M 是 rows 时,得到每次调用平均检索或影响的行数。点查 SELECT 通常只返回少量结果;对于写语句,此值表示影响的行数。
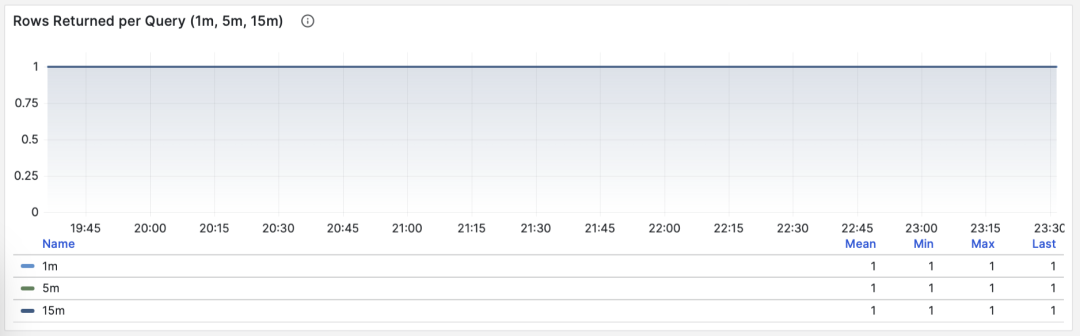
按照主键查询单条记录,平均返回行数稳定为1
如果一个查询组每次查询向客户端吐出几百甚至成千上万行记录,那么应当对其进行审视。如果这是有意而为之的设计,比如批量加载任务/数据转储,那么不需要做什么。如果这是由应用/客户端发起的请求,那么可能存在错误,比如语句缺少 LIMIT 限制,查询缺少分页设计,这样的查询应该进行调整修复。
平均共享缓冲区读取/命中
当 M 是 shared_blks_hit + shared_blks_read 时,dM/dc 表示每条查询平均访问共享缓冲区的次数。乘以块大小(通常为 8 KiB),即可得到每条查询访问的字节数,单位是 B/query。重复访问同一块会重复计数。
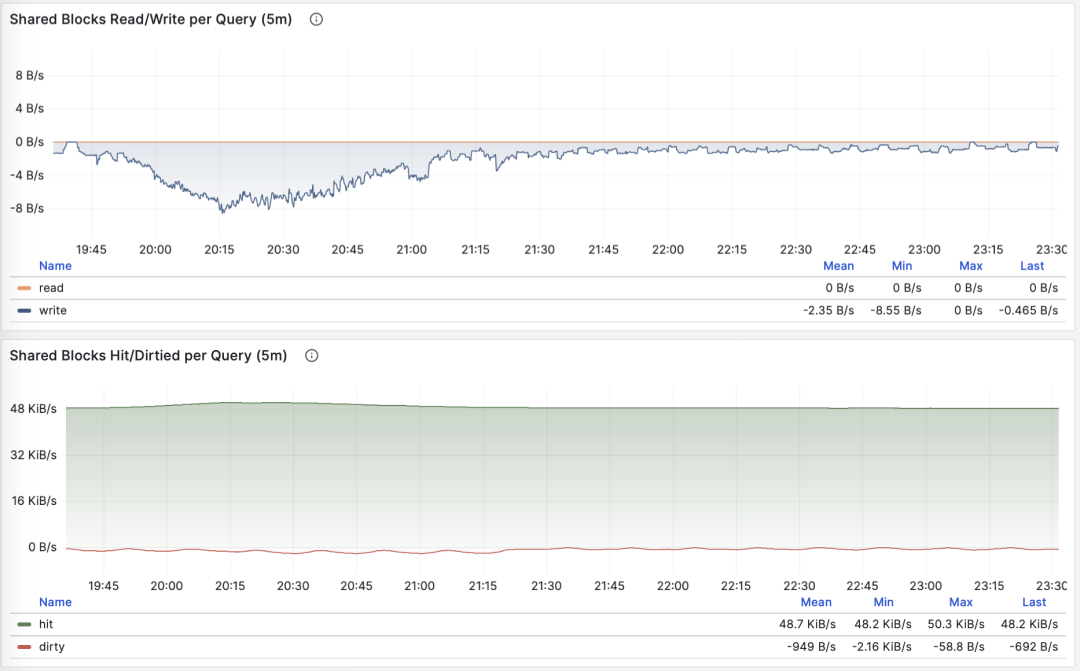
每条查询平均访问的共享缓冲区字节数
查询平均访问的数据量通常与平均返回的行数相匹配,如果你的查询平均只返回了几行,却访问了成M上G的数据块,那你就需要特别注意了:这样的查询对于数据冷热状态非常敏感,如果所有的块都在缓冲区中,它的性能可能还说的过去,但如果从磁盘冷启动,执行时间可能会出现戏剧性的变化。
PostgreSQL 缓冲区未命中时,仍可能从操作系统缓存读取。结合主机指标、pg_stat_kcache 扩展,或 PostgreSQL 16 的 pg_stat_io 视图分析实际 I/O。
另一种值得关注的模式是此指标的突变,这通常意味着该查询组的 执行计划可能出现了翻转/劣化,非常值得关注与进一步研究。
平均WAL日志量
当 M 是 wal_bytes 时,我们得到了每条查询平均生成 WAL 的大小,这是 PostgreSQL 13 新引入的字段。这个指标可以衡量查询的变更足迹大小,并计算读写比例等重要评估参数。
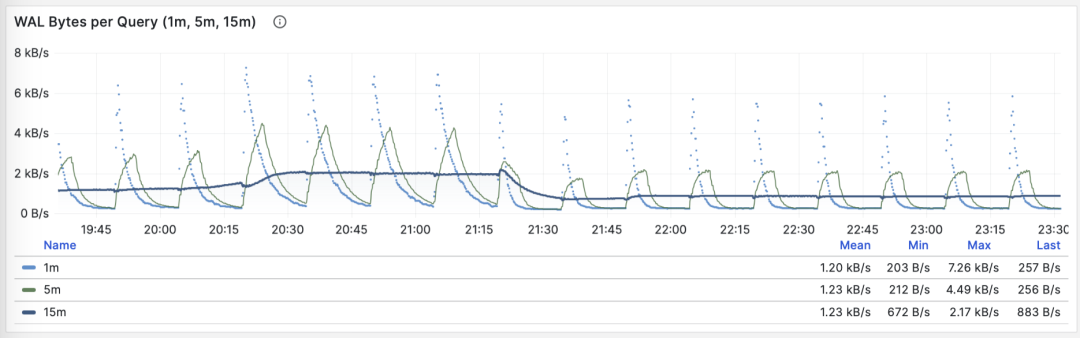
稳定的QPS却有着周期性WAL波动,可推断是 FPI 的影响
另一个用途是优化检查点/Checkpoint:如果你观察到此指标周期性的起伏(周期约等于 checkpoint_timeout),那么可以通过调整检查点间距,来优化查询产生 WAL 的数量。
dM/dc 描述一次调用的平均成本。用它评估查询修改,再检查工作负载总量,确认整体收益。
dM/dc 这样的指标为我们提供类似重要的绝对值指标,但如果想要找出哪些查询的优化潜在收益最大,还需要用到 %M 百分比指标。
百分比指标
现在我们来研究第三类指标,百分比指标。即某个查询组相对于整体工作负载所占的比例。
百分比指标 M% 为我们提供了某个查询组相对于整体工作负载的比例,帮助我们在频次、时间、I/O时间/次数上时识别出“主要参与者”,找出潜在优化收益最大的候选查询组,作为优先级评定的重要依据。
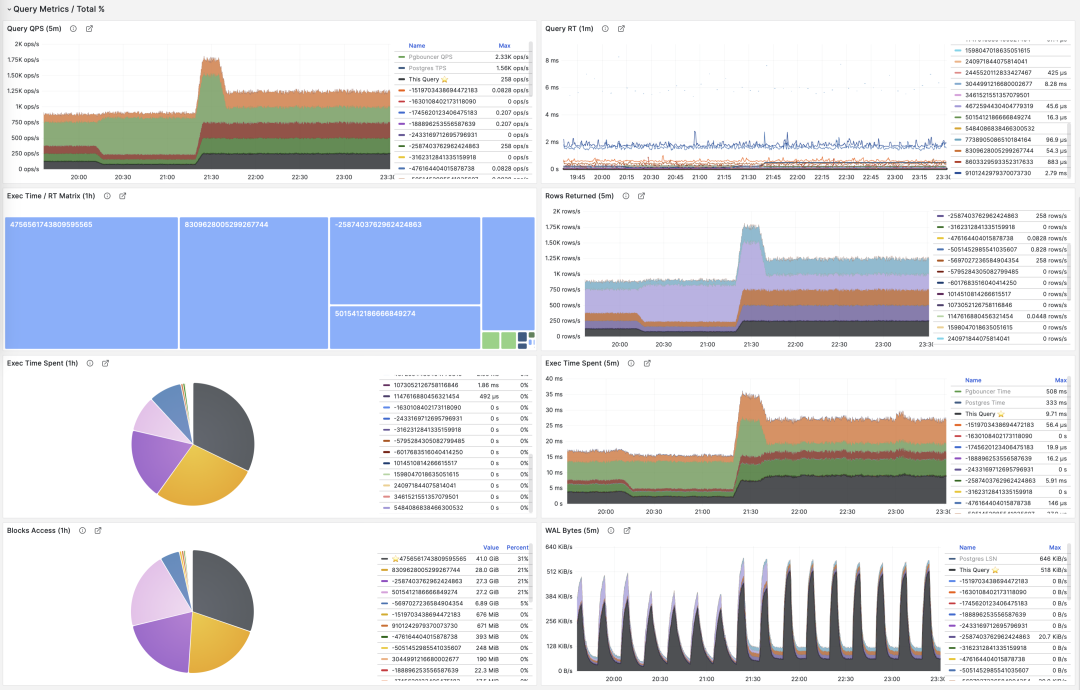
常用百分比指标 %M 一览
同样是 1000 QPS,一个查询组可能只占总调用量的 3%,也可能占 50% 以上。如果其中存在大量冗余调用,消除它们可以减少数据库工作量。对于高成本查询,还应比较它们占执行时间和 I/O 的比例。
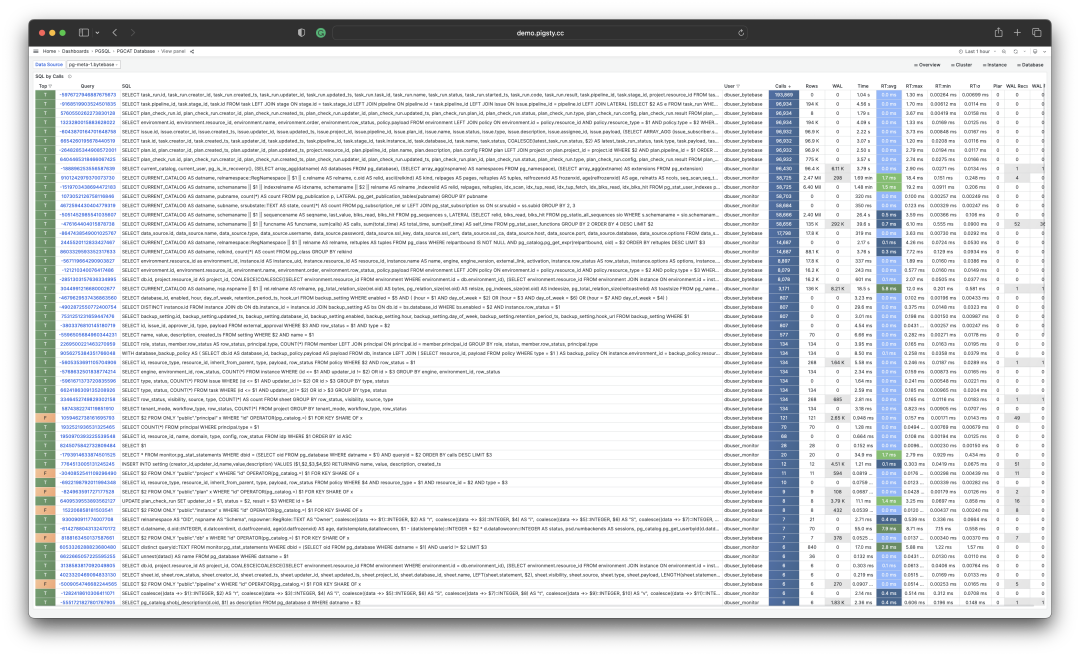
常见的优化策略是这样的:首先把所有查询组分别按照上面提到的重要指标:calls,total_exec_time,rows,wal_bytes,shared_blks_hit + shared_blks_read,以及 blk_read_time + blk_write_time 在一段时间内的 dM/dt 值进行排序取 TopN (比如 N=10 或者更多),加入优化候选列表中。
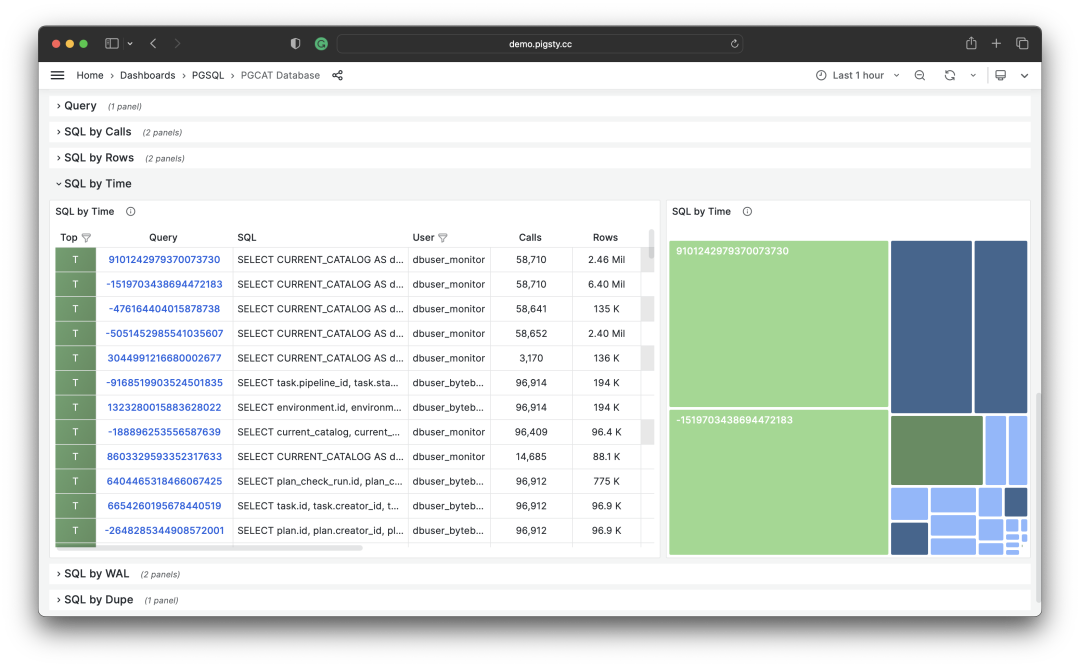
按照特定标准,选取待优化的 TopSQL
然后,对于优化候选列表中的每个查询组,依次分析其 dM/dc 指标,结合具体的查询语句与慢查询日志/等待事件进行分析,决定这是不是一个值得优化的查询。对于决定(Plan)进行优化的查询,就可以使用后续篇 “微观优化” 将要介绍的技巧进行调优(Do),并使用监控系统评估优化的效果(Check),总结分析后进入下一个 PDCA 戴明循环,持续进行管理优化。
除了对指标取 TopN 之外,还可以使用可视化的方式。可视化非常有助于从工作负载中识别 “主要贡献者”,复杂的判断算法可能还远比不上人类DBA对监控图形模式的直觉。想要形成比例感,我们可以借助饼图,树图或者堆叠的时序图。
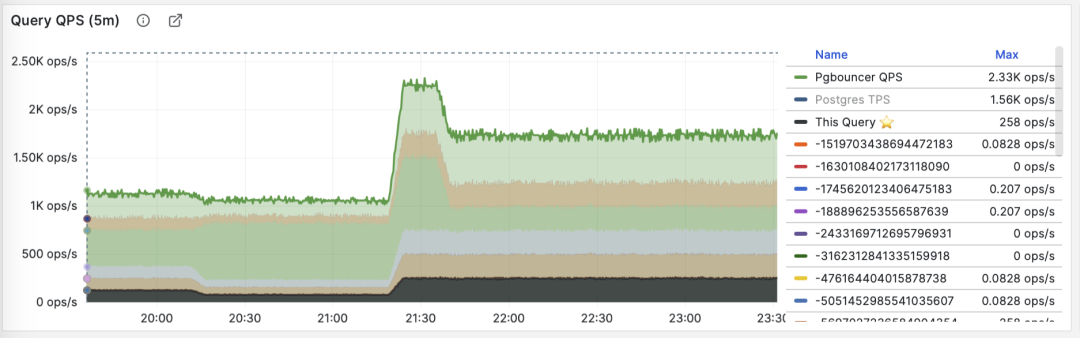
将所有查询组的 QPS 进行堆叠
例如,我们可以使用饼图来标识过去1小时内耗时/IO使用最大的查询,使用二维树图(大小代表总耗时,颜色代表平均RT)来展示一个额外的维度。并用堆叠时序图来展示比例随时间的变化关系。
我们也可以直接分析当下的 PGSS 快照,按照不同的关注点进行排序,按照您自己的标准选择有待优化的查询即可。
I/O 耗时对于分析查询毛刺原因很有帮助
总结
最后,让我们对上面的内容做一个总结。
PGSS提供了丰富的指标,其中最重要的累积指标可以使用三种方式进行加工处理:
dM/dt :指标 M 基于时间的微分,揭示了 每秒资源使用量,通常用于减少资源消耗的优化目标。
dM/dc:指标 M 基于调用次数的微分,揭示了 每次调用的资源使用量,通常用于改善用户体验的优化目标。
%M :百分比指标展示了查询组在整个工作负载中所占的百分比,通常用于平衡工作负载的优化目标。
通常,我们会根据 %M :百分比指标 Top 查询选择高价值的备选优化查询,并使用 dM/dt、dM/dc 指标进行进一步的评估,确认是否有优化空间和可行性,并评估优化后的效果。如此往复,不断循环。
理解了宏观优化的方法论后,我们就可以用这样的方法去定位优化慢查询了。这里给出了一个具体的 《 利用监控系统诊断PG慢查询》的例子。在下一篇中,我们将介绍关于 PostgreSQL查询 微观优化 的经验技巧。
参考
[1] PostgreSQL HowTO: pg_stat_statements by Nikolay Samokhvalov
[3] 利用监控系统诊断PG慢查询
[4] 如何用Pigsty监控现有PostgreSQL (RDS/PolarDB/自建)?