这是本节的多页打印视图。 .
文章
- 1: 在 Pigsty 中采用 Victoria 可观测性组件
- 2: 暂停代码提交的一周:PGCon.Dev 2024 参会记
- 3: PostgreSQL 宏观查询优化之 pg_stat_statements
- 4: 使用 Pigsty 监控现有 PostgreSQL:RDS、PolarDB 与自建数据库
- 5: PostgreSQL 慢查询诊断方法
- 6: Pigsty 首次发布
- 7: 黄金监控指标:错误延迟吞吐饱和
- 8: Pigsty PostgreSQL 监控系统介绍
- 9: PostgreSQL的KPI
- 10: PostgreSQL 监控系统概览
- 11: 关系膨胀的监控与治理
- 12: 监控 PostgreSQL 表大小
- 13: PostgreSQL 服务器日志配置
最初发表于 vonng.com 的 PostgreSQL 监控、诊断、容量与日志文章。各篇保留原发布日期、署名、插图与历史背景,并配有英文译文。
当前版本的安装与操作方法见 PG Exporter 使用手册。
1 - 在 Pigsty 中采用 Victoria 可观测性组件
本文记录 2025 年 12 月的 Pigsty v4 测试版。
准备 Pigsty v4.0 时,我将默认的 Prometheus 和 Loki 服务替换为 VictoriaMetrics 与 VictoriaLogs,并加入 VictoriaTraces。目标是降低存储与内存消耗,改善仪表盘和日志查询的响应时间。
之前的使用经验
在探探时,我们用十二台 64 核、256 GB 内存的 Prometheus 节点监控约五千万个时间序列。我的测试中,三节点 VictoriaMetrics 集群可以处理这些负载,一台配置更高的服务器也能承载。内存和磁盘用量约为原方案的四分之一,查询速度约快四倍。
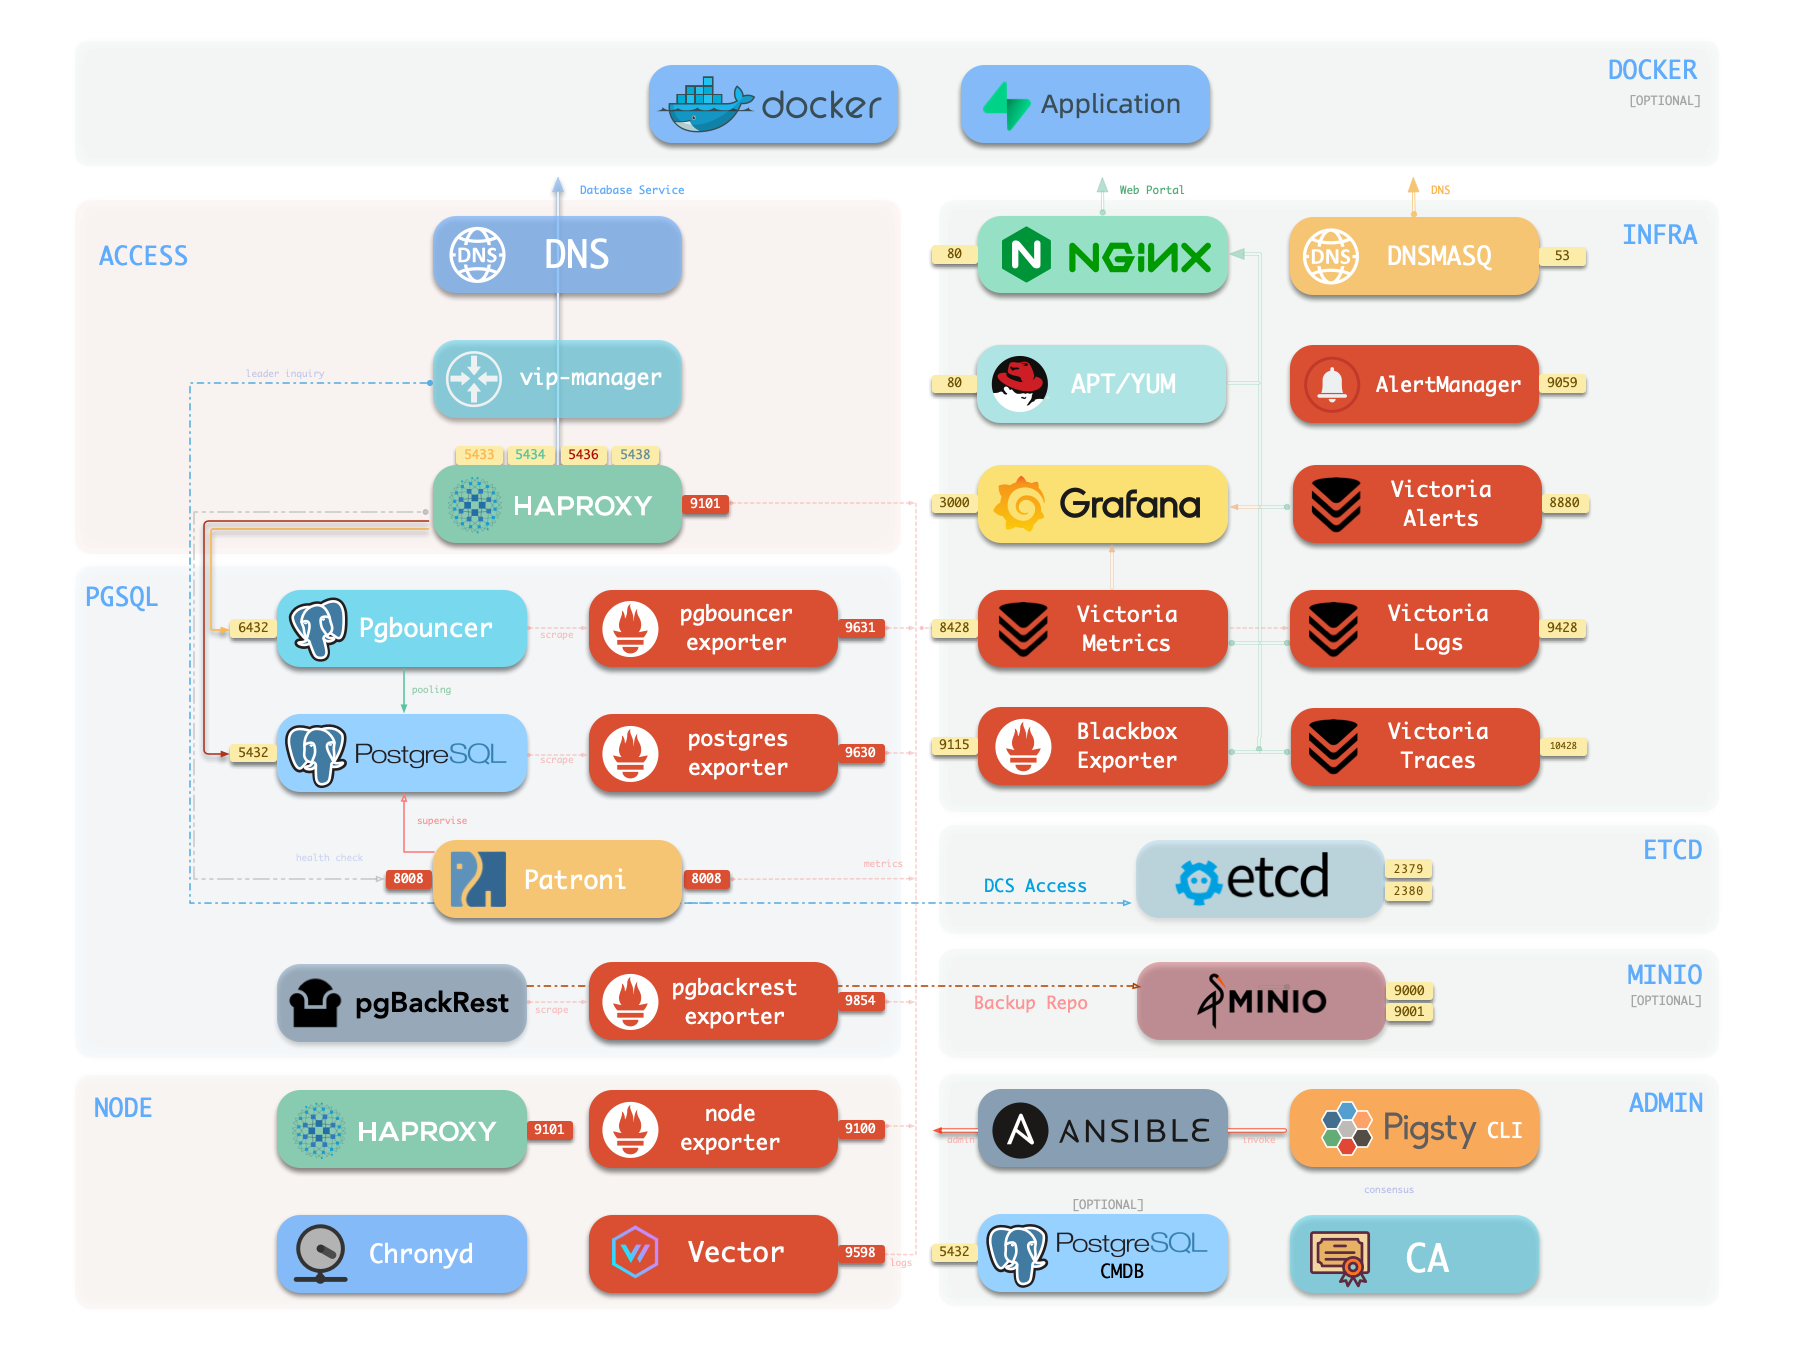
Pigsty 起初将 VictoriaMetrics 作为可选模块。为影视飓风部署监控系统,加上 Promtail 计划停止维护,促成了这次基础设施更新。Promtail 是日志采集代理,Loki 本身并未停止维护。
Aliaksandr Valialkin 在内存分配控制和存储效率上的工作,也是我测试这套系统的原因。
十节点测试
在 v4 测试版中,我收集了十个节点的指标与日志。运行一天后的结果如下:
| 项目 | 观测值 |
|---|---|
| 时间序列 | 约 12 万 |
| VictoriaMetrics 内存 | 约 600 MB |
| 已存储指标样本 | 约 11 亿 |
| 指标存储 | 约 440 MB |
| 日志记录 | 约 50 万行 |
| 日志存储 | 不到 6 MB |
| 整套监控服务,含 Grafana 与 Alertmanager | 约 0.2 vCPU、1 GB 内存 |
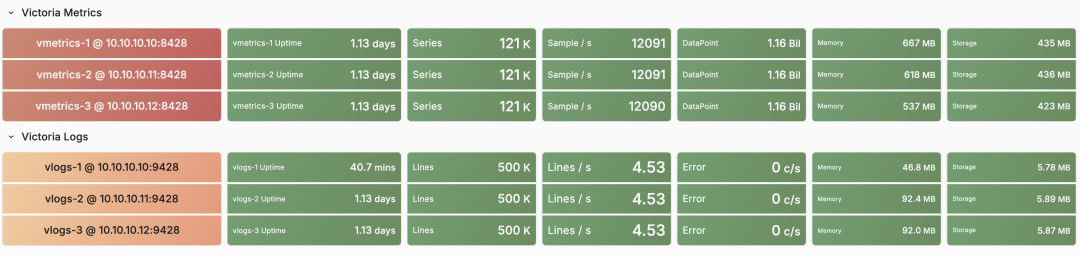
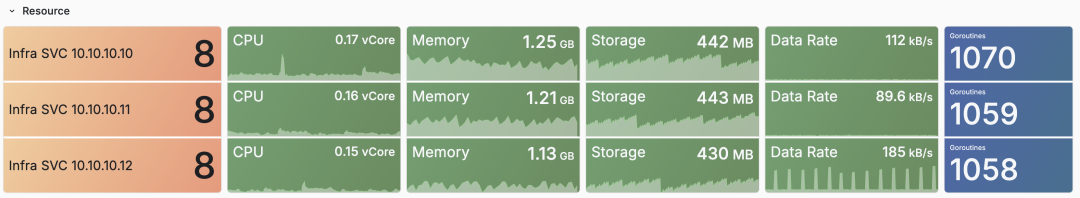
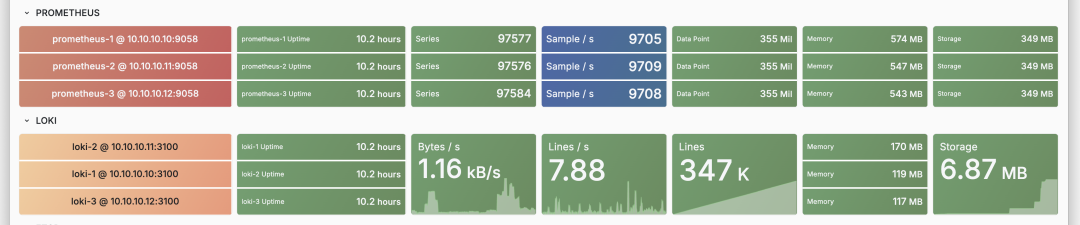
我还在十节点环境运行了 Pigsty v3.7 的 Prometheus 与 Loki 方案。十小时后,其资源使用已接近或超过 Victoria 方案。两组读数的采集时长不同:Prometheus 与 Loki 为十小时,Victoria 为一天。
对日常使用更直接的改善,是这套环境中的仪表盘加载和日志查询变快了。
指标、日志与追踪
VictoriaMetrics 接收 Prometheus 指标,并提供兼容的查询 API。PG Exporter 继续暴露同一个 /metrics 端点。已有仪表盘可以改用 VictoriaMetrics 数据源;迁移时需核对查询结果,因为 MetricsQL 与 PromQL 存在差异。记录规则与告警规则由独立的 vmalert 服务计算。
VictoriaMetrics 支持单机与集群部署。
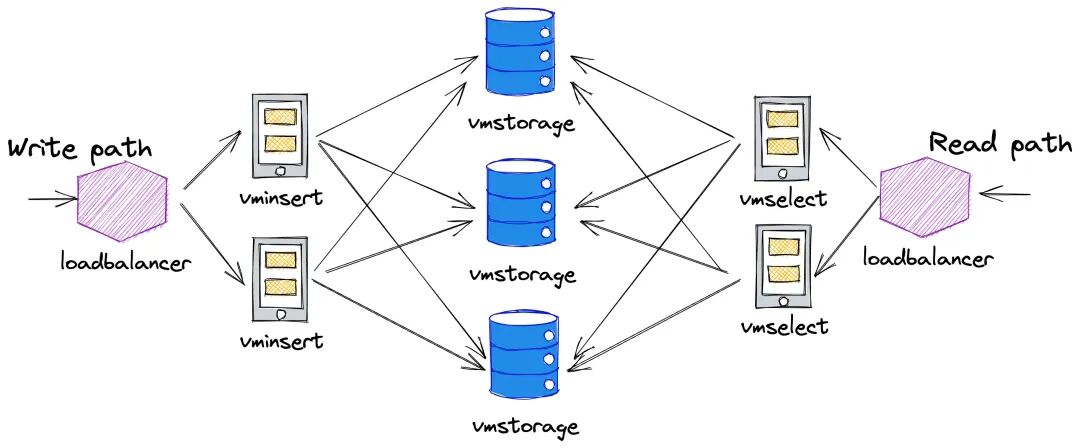
单台服务器足以处理本次负载,因此我采用独立的单机副本提供冗余,省去了分布式存储的管理。每个副本分别采集、存储指标。
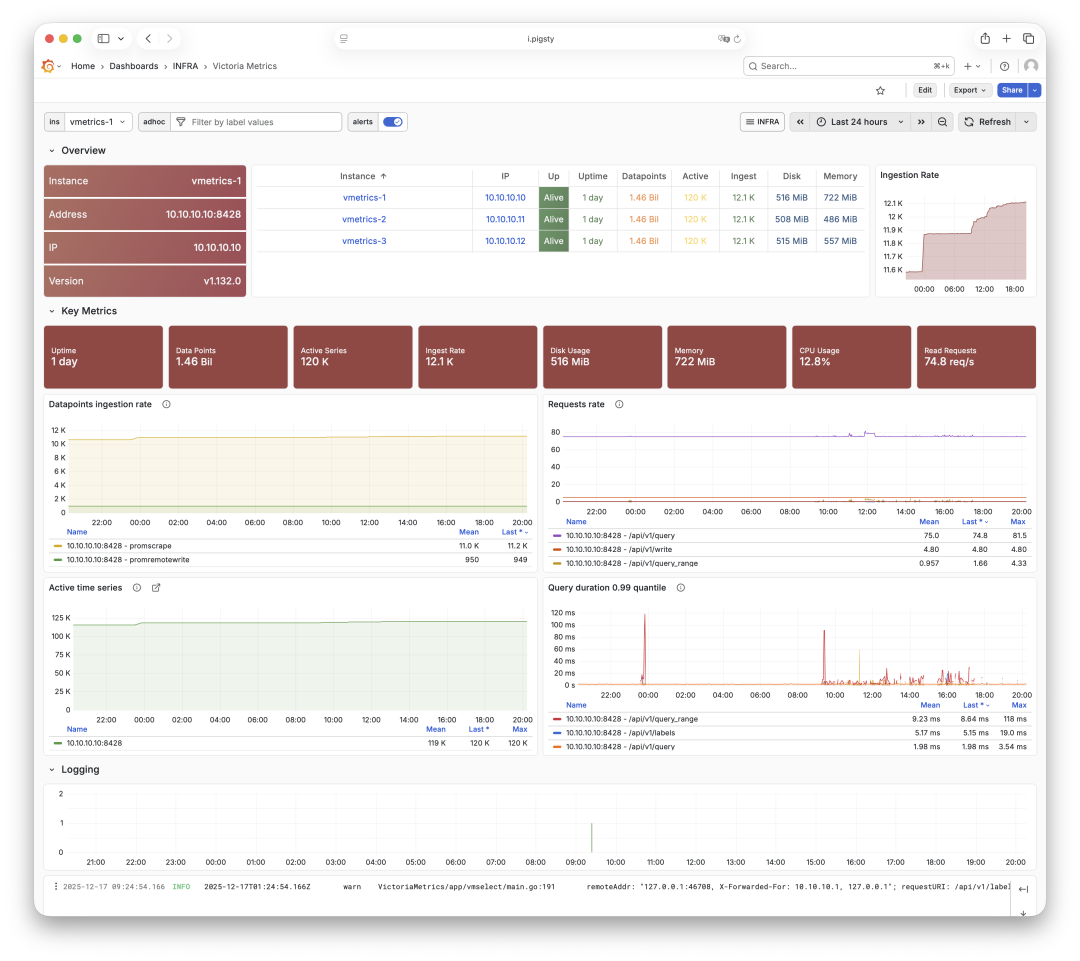
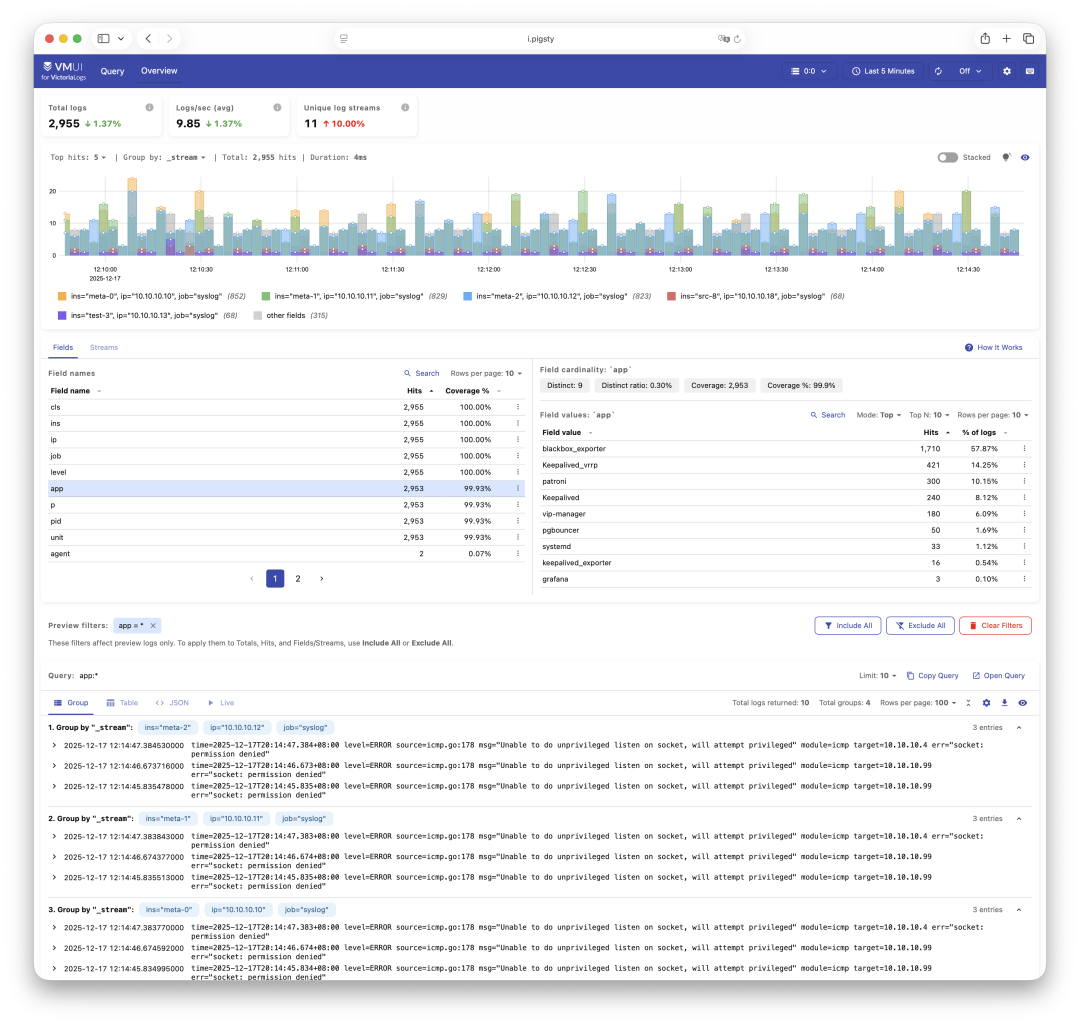
在原有部署中,扩大日志查询的时间范围,有时会使 Loki 查询超时。改善日志查询速度是此次采用 VictoriaLogs 的主要原因之一。
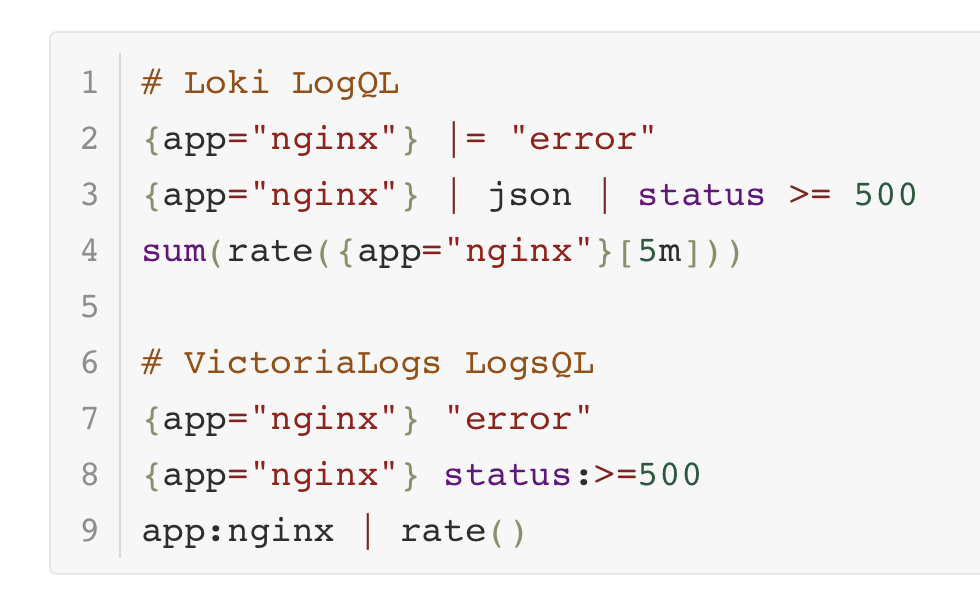
VictoriaLogs 存储日志,使用 LogsQL。由 Loki 迁移时,需要修改 LogQL 查询和日志采集配置。本次部署使用 Vector 替代 Promtail。
LogsQL 允许不指定流选择器就进行搜索。例如,"error" "timeout" 可以查找同时包含两个词的日志。这适合尚不清楚哪个服务出错的排查场景,语法见 VictoriaLogs 文档。
VictoriaTraces 提供追踪数据存储。本次 Beta 测试覆盖指标与日志。
Pigsty 集成
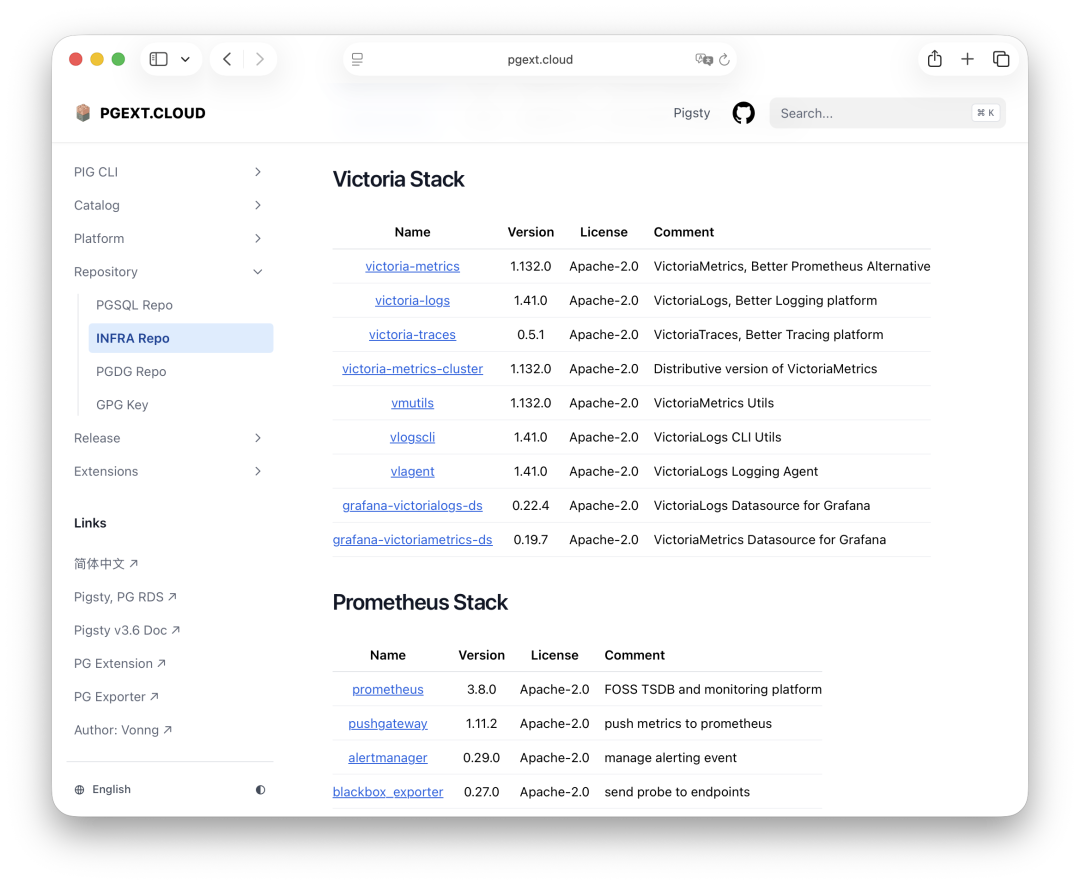
Pigsty 基础设施仓库提供 Victoria 组件、工具和 Grafana 插件的 RPM 与 DEB 软件包。infra 部署负责配置存储目录、服务、Grafana 数据源、仪表盘与 Nginx 路由。
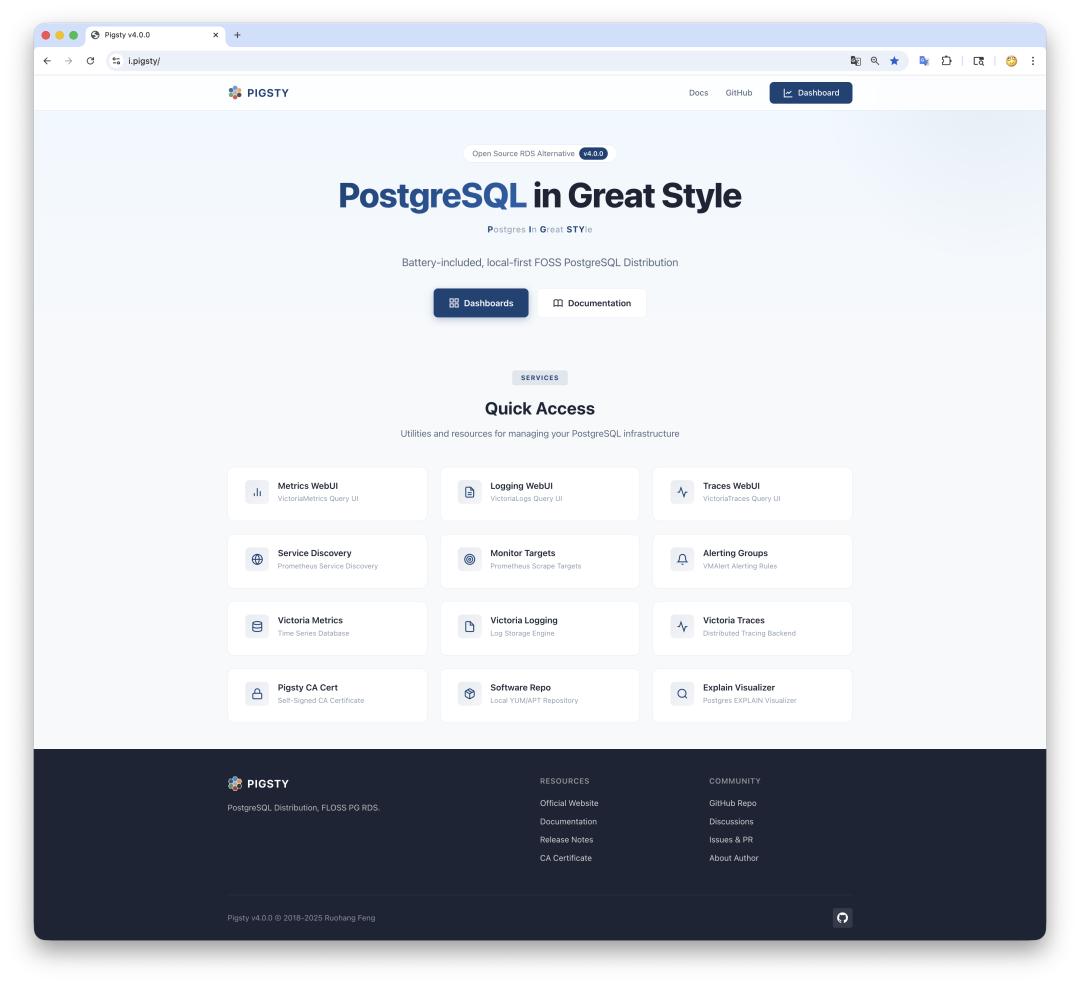
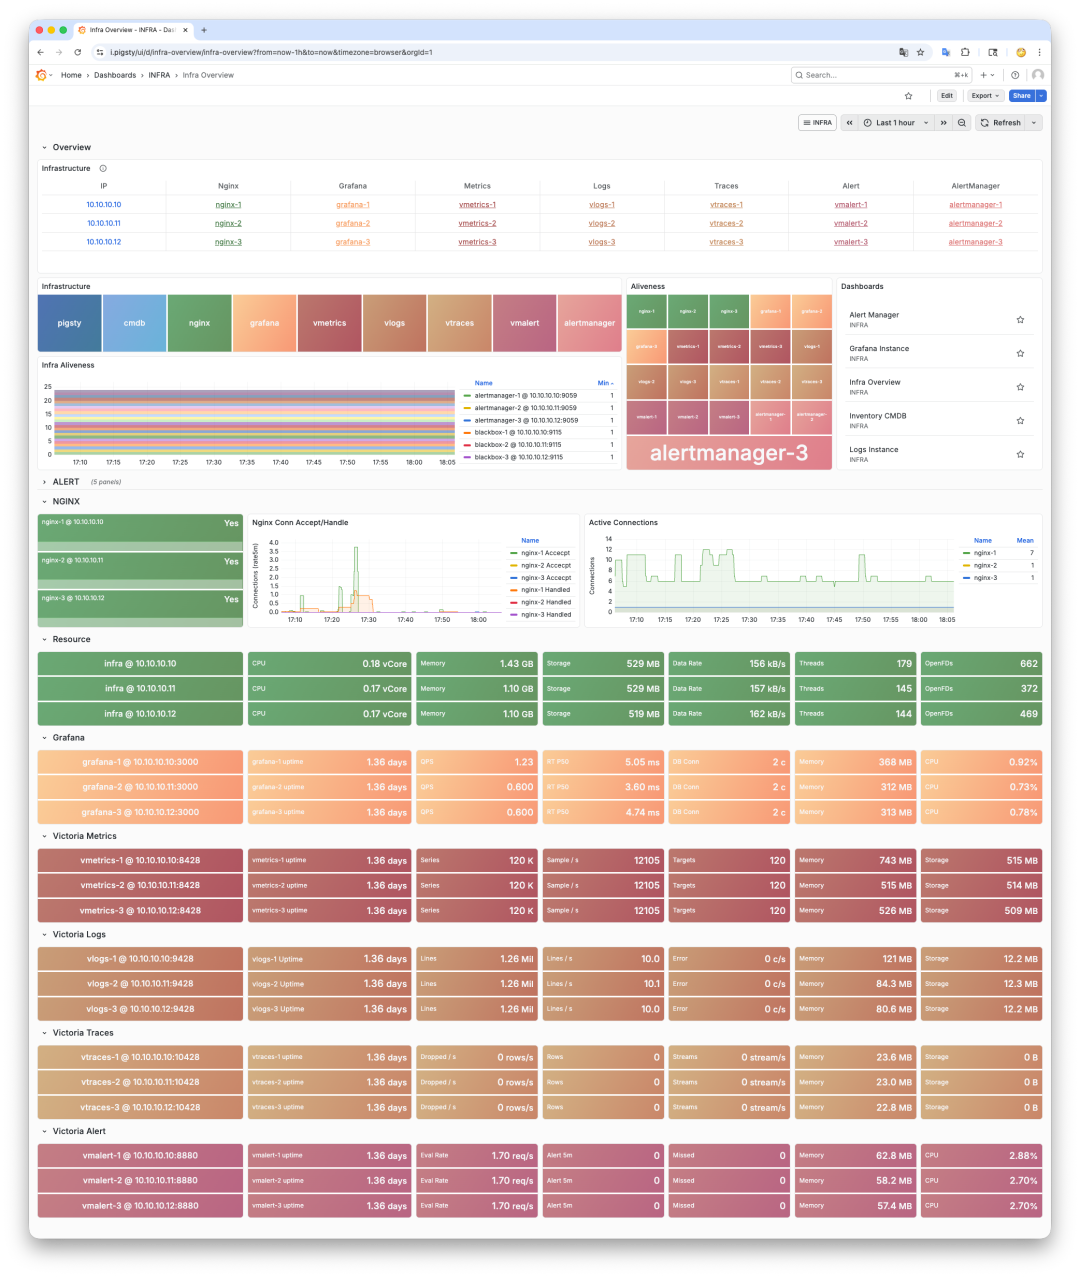
Nginx 通过配置的基础设施域名暴露服务。监控栈包括 VictoriaMetrics、VictoriaLogs、VictoriaTraces、Grafana、vmalert 与 Alertmanager。
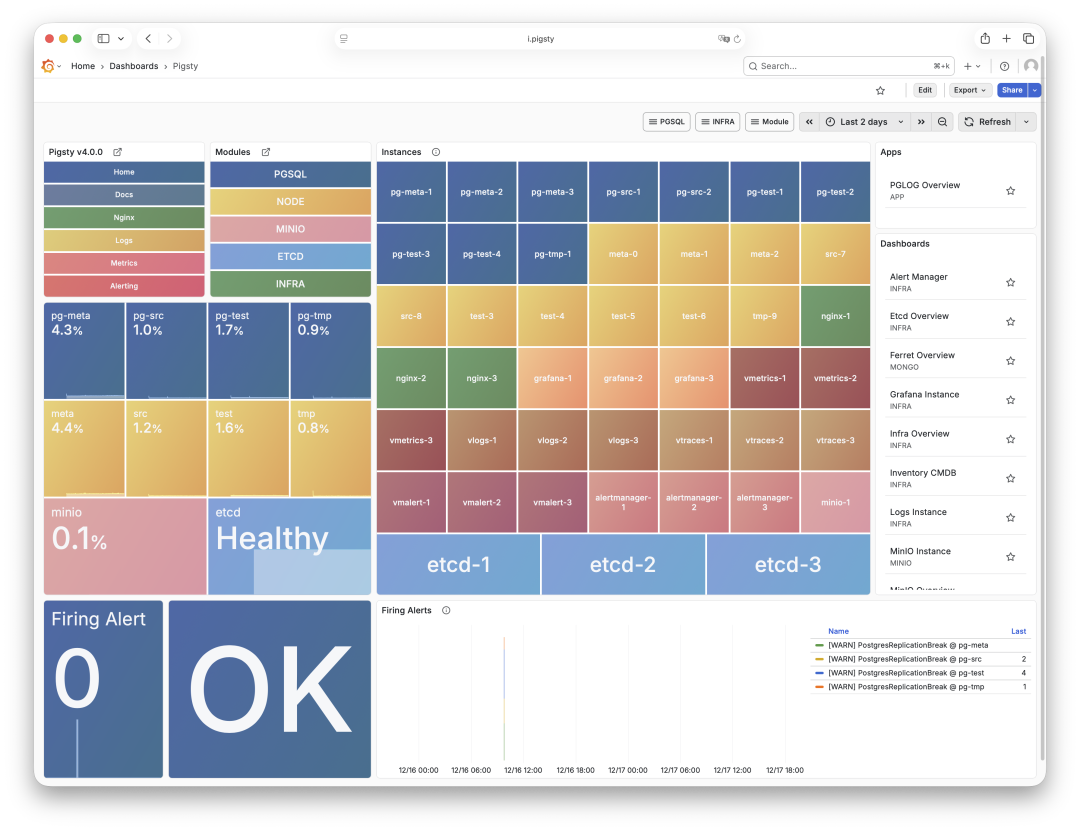
部署也配置了这些服务的自监控。新增应用目标可通过抓取配置接入。
当时的测试版部署
2025 年 12 月的测试版使用 infra 配置模板,仅安装监控服务,不安装 PostgreSQL 或 etcd。下方命令展示当时的流程。在新主机上部署,请使用当前 Pigsty 基础设施指南。
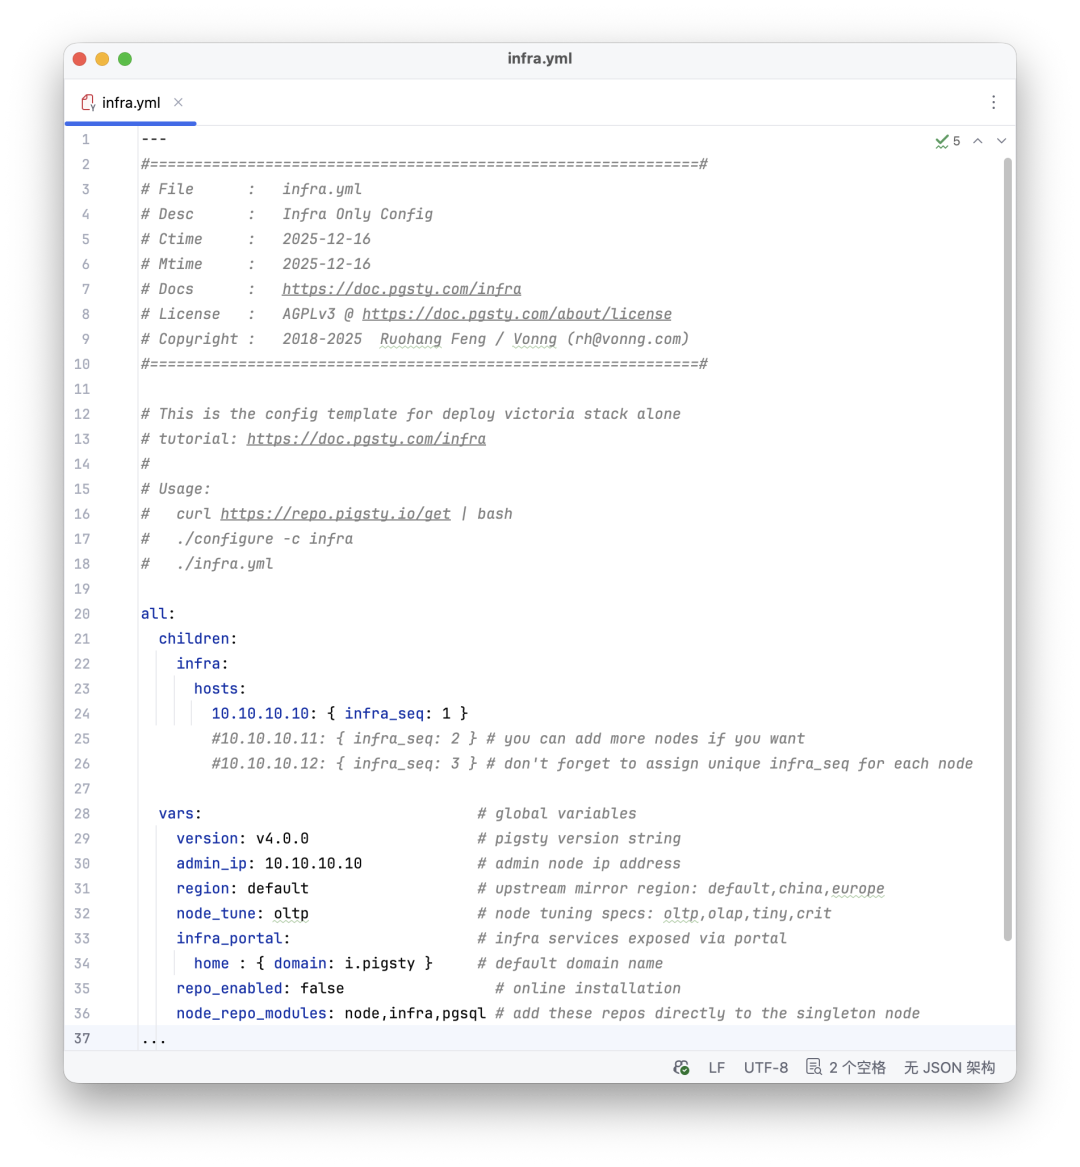
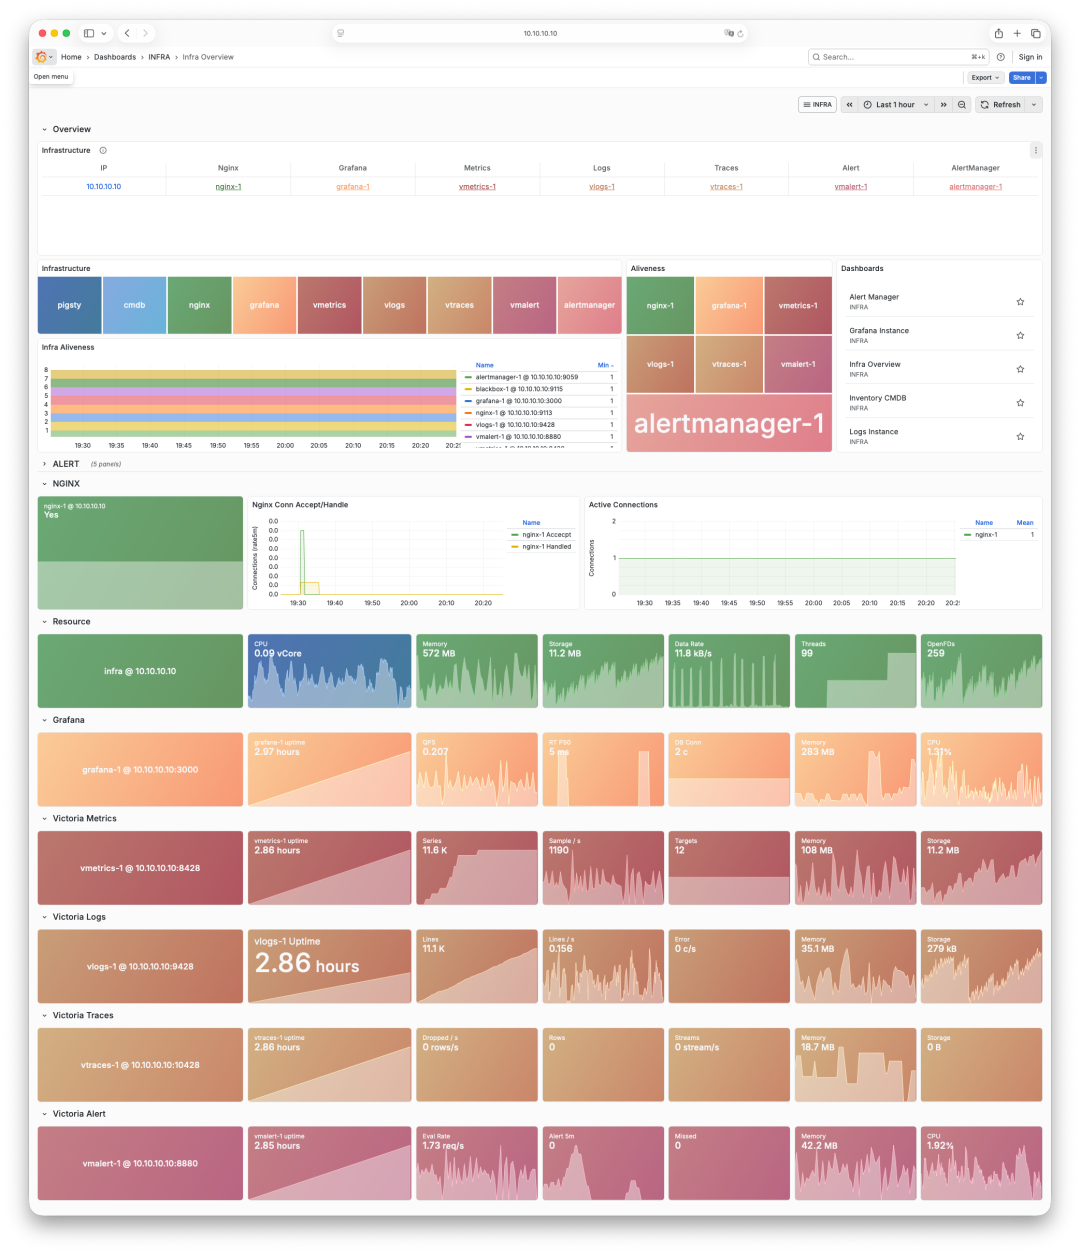
配置三个基础设施节点时,模板会部署三个相互独立的副本。
文章写作时,v4.0 剩余工作包括仪表盘和文档,正式版计划在 2026 年 1 月发布。Victoria 原生分布式部署属于后续任务。
这次迁移降低了我们负载下的资源消耗,并改善了查询响应。这是我选择将其作为 Pigsty 默认监控栈的原因。
2 - 暂停代码提交的一周:PGCon.Dev 2024 参会记
本文是 2024 年 6 月的参会记录,职务、软件包数量和技术提案均按当时情况叙述。
PGCon.Dev 的前身 PGCon 从 2007 年至 2023 年在加拿大渥太华举办,是 PostgreSQL 开发者讨论项目方向的年度聚会。2024 年,新的组织团队接替 Dan Langille,将会场移至温哥华的 SFU 港区活动中心。
全都来参会了,谁还在写代码?
Peter Eisentraut 在会后统计发现,大会前后相邻的两次 PostgreSQL 代码提交间隔六天十二小时四十九分钟,是二十多年来最长的一次提交间隔。开发者们在线下也有许多事情可聊。
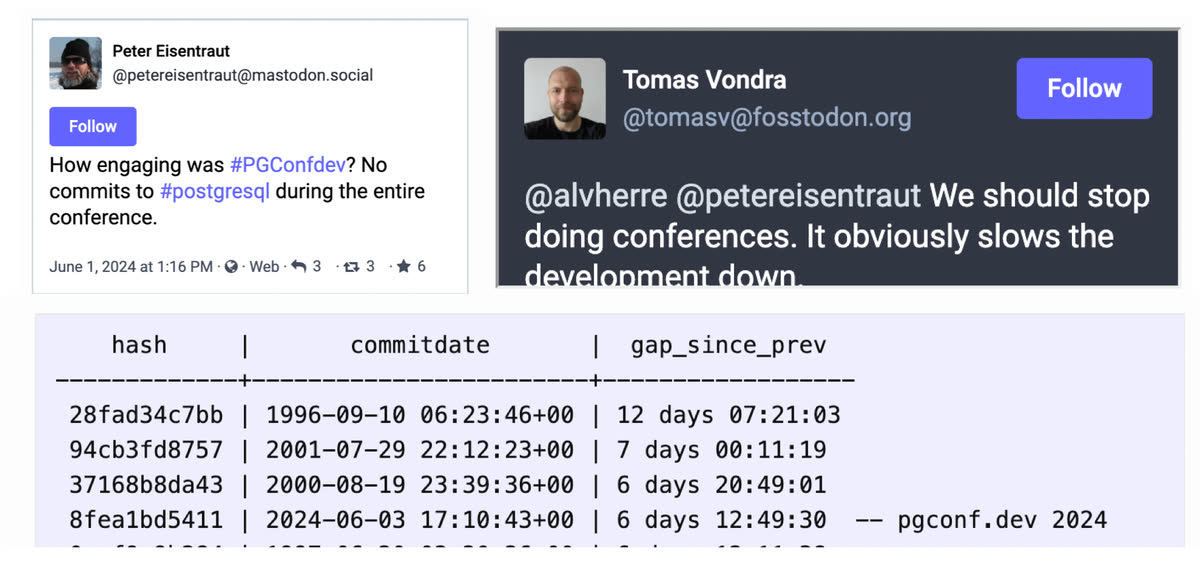
考虑到前几次中断都发生在二十年前的项目早期……
虽然我已经拥抱 PostgreSQL 十年了,但线下现场参加全球 PG Hacker 们的会议还是第一次,所以我非常感谢组织团队为组织这次活动所做的工作。
PGCon.Dev 2024 于 5 月 31 日闭幕。这篇文章本该当时写完,却被紧接着的温哥华和班夫国家公园之行耽搁了。今天补上参会的见闻与记录。
第零天:扩展生态峰会
大会的第零天是领导层会议,我注册了下午的 Extension Ecosystem Summit 扩展生态峰会。
说起来,这个扩展生态峰会也许跟我还有点关系。两个月前我写了一篇文章《PostgreSQL正在吞噬数据库世界》,主题是 PostgreSQL 的繁荣扩展生态是它的重要特点。 写完后将其翻译成了英文《Postgres is eating the database world》发到了 Medium 与 Hacker News 上,总共有几十万的阅览量,基本应该覆盖了整个 PG 社区。
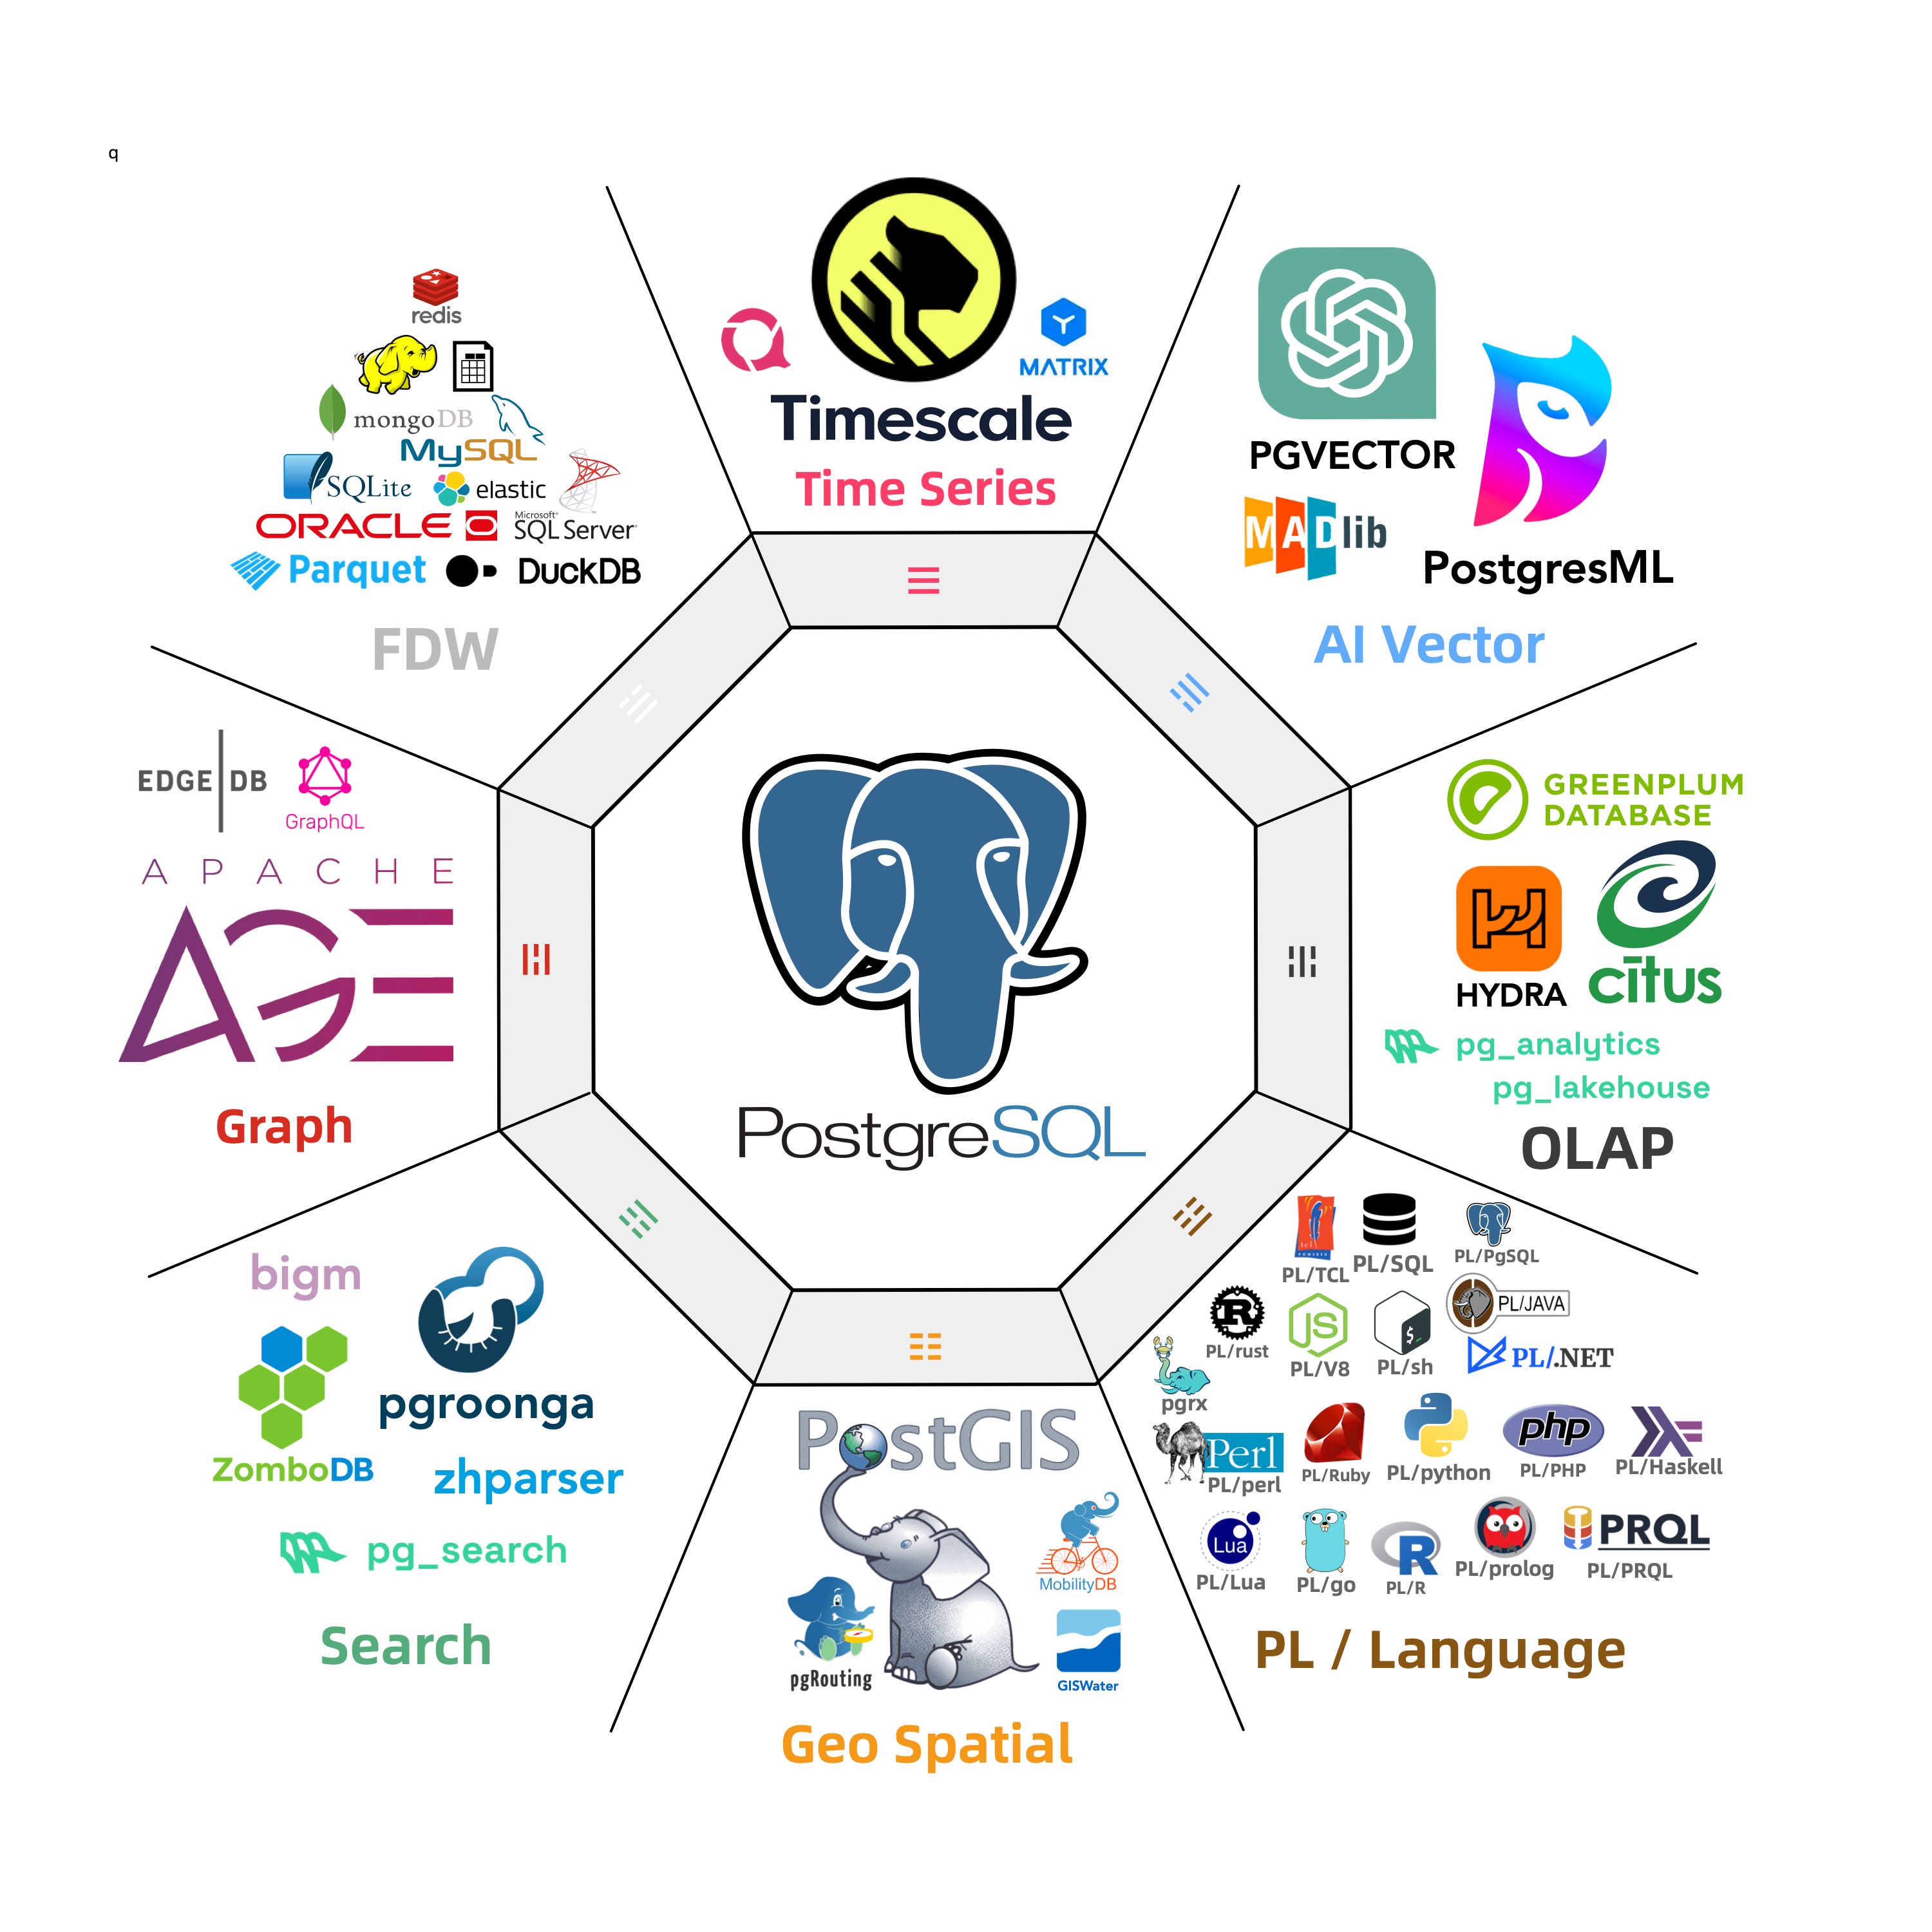
此前,扩展机制的重要性并没有达成共识,即使在 PG 社区与一些资深成员的眼中,关于扩展他们只是觉得 PostGIS 和 PGVector 好像很不错 —— 前者是地理空间数据库的事实标准,后者是AI领域当红炸子鸡 —— 向量数据库的砸盘掀桌者。 但 PG 生态中强大的扩展绝不仅仅只有这两个,在抛出了这个极为繁荣的 PG 扩展生态 Landscape 后,立即引起了社区成员的极大兴趣与关注,很快关于PG扩展的讨论发酵了起来。
在这次扩展峰会之前,PG 社区已经举办了六次迷你扩展峰会对此事进行了密集的讨论,六位主讲嘉宾兼主持人在最近两个月中,从不同的角度介绍了关于扩展生态的建设工作,并阐述了对 PG 扩展生态发展的愿景,会议的视频回放可以在 YouTube 上看到。
在这次大会中,有许多与扩展生态,可扩展性有关的议题,甚至还有一个专门的扩展峰会,也许确实是有点关系的。这场扩展峰会分了上下两场,每场都有几个 Topic,大家挑选感兴趣的主题参与。 我挑了 David Wheeler 的 Binary Packaging 主题分会参与讨论,其他参与者包括 PGDG Yum 仓库维护者 Devrim,Debian 仓库维护者大法师 Tomasz Rybak,以及 Neon 的 PG 主要贡献者 Andreas Scherbaum。都是些老前辈,好在我也算是 YUM/APT 仓库的建设者/维护者,能实质参与到讨论中。
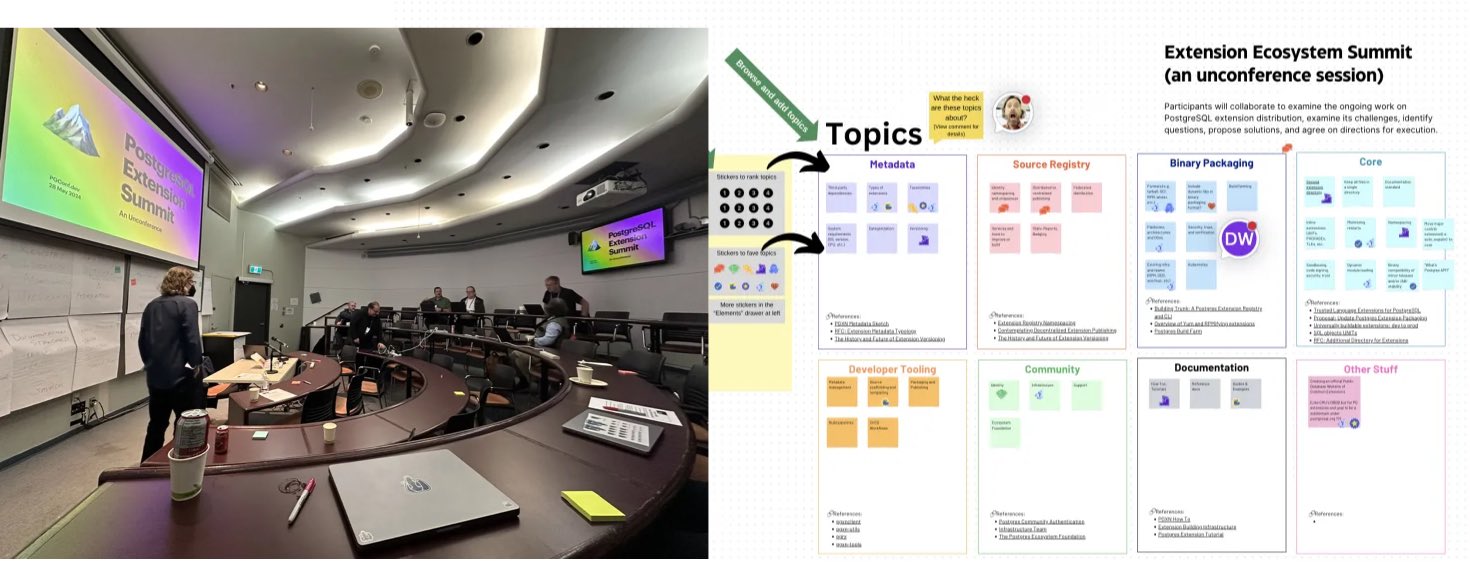
在上半场,来自 Tembo 的 David 一直想做一个 PGXN v2,作为 PG 生态扩展分发的标准,搞一些 OCI 构建扩展的花活。当然,现有事实标准的维护者 Devrim 和 Tomasz 肯定是不乐意的。我支持这两位老爷子,毕竟我做的是 PG 发行版,内核组的活儿跟我直接关系不大,但 YUM/APT 仓库的负责人跟我的关系最紧密,RPM / Deb 包分发扩展已经是一种相当成熟可靠的方式了,整 OCI 这些我个人觉得意义不大。
下半场,我参加了 Omnigres 创始人 Yurii Rashkovskii 主持的 Extension in Core 分会场,讨论了关于扩展目录结构,元数据,命名冲突,版本控制,二进制分发的一些想法。并且和负责 PG RPM 仓库的 Devrim 老爷子聊了很多关于扩展的问题。
在扩展峰会后,Devrim 打出 “Keith粉丝团” 的 Slogan
第一天:主题分享与酒吧社交
PGCon.Dev 最核心的部分当然是大会议题,在 PG大会2024开幕 中我已经选定了感兴趣的主题,绝大多数分享都没有让我失望 —— 比起国内各种 XX 大会无聊的产品宣介,无关痛痒的技术细节与架构分享,PGConf.Dev 的分享要有趣且扎实得太多了。
5月28号 / 周二举行了 PostgreSQL 开发者与领导层闭门会议,以及 PGCon.Dev 扩展生态峰会。大会正式的议程在周三,也就是 29 号开始。
开场由 Jonathan Katz 与 Melanie Plageman 主持,前者是 PG 核心组七人之一,AWS RDS 的首席产品经理;后者是新近成为 PG 提交者,来自微软的 PostgreSQL 开发者。当然,开幕式上最精彩的一幕,就是发现了著名 xz 后门的 “英雄开发者” Andres Freund 被拉上了台,披上了超级英雄的披风。
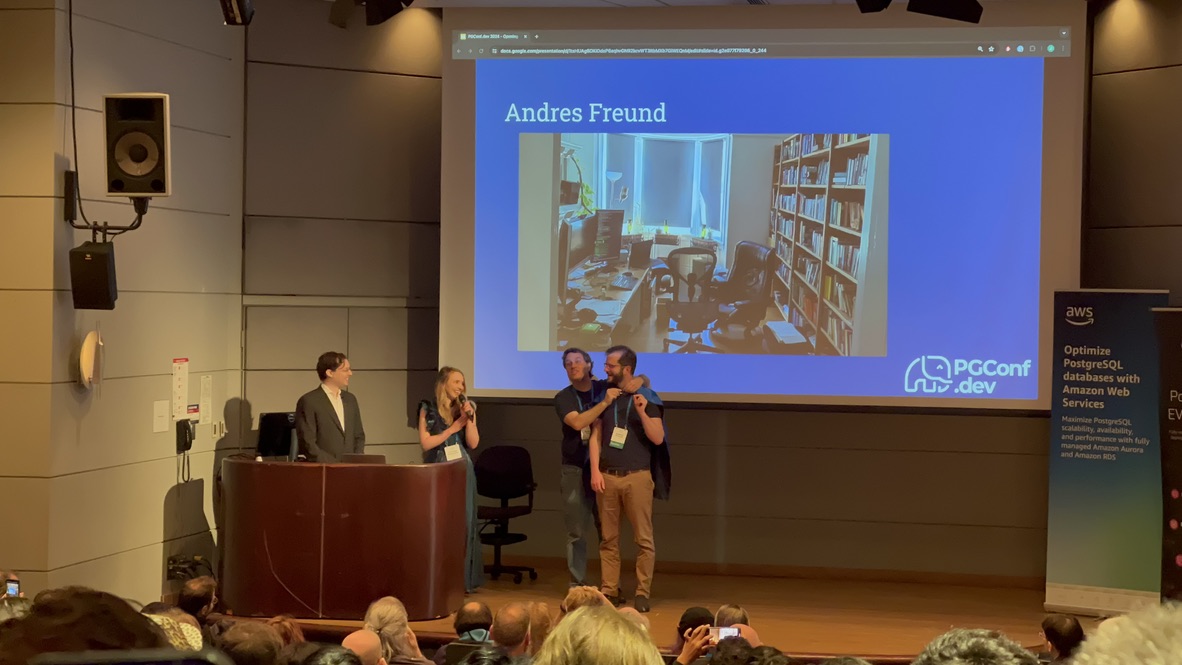
开幕式之后就开始了常规 Session Track,目前还没有会议的视频放出,但我相信以加拿大的办事效率,“用不了多久” 就能在 YouTube 上看到了。大部分的 Session 都是三选一的。我选了几个场次,下面是摘要:
将扩展的边界推向新边疆
第一场来自 Yurii , “将 PG 扩展的边界推向新边疆”。讨论的内容其实是 PostgreSQL 应该提供什么样的扩展 API ? PostgreSQL 有着极佳的可扩展性,但这一套 API 已经是十几年前 9.x 留下的了。尤里的提议旨在解决现有扩展机制的一些问题。比如:如何同时安装两个不同版本的扩展插件?如何避免一部分扩展插件安装后需要重启数据库的问题?如何让PG像管理数据一样管理扩展?如何处理扩展的依赖关系?
Yurii 和 Viggy 创办了 Omnigres ,旨在让 PostgreSQL 直接成为一个应用开发平台(比如直接在数据库里跑 HTTP 服务器等任务)。为了做到这一点,他们为 PostgreSQL 设计的一套新的扩展 API 与管理机制。我认为一些改进很有创新性,是 PG 内核扩展机制的前沿探索实践。PDF地址
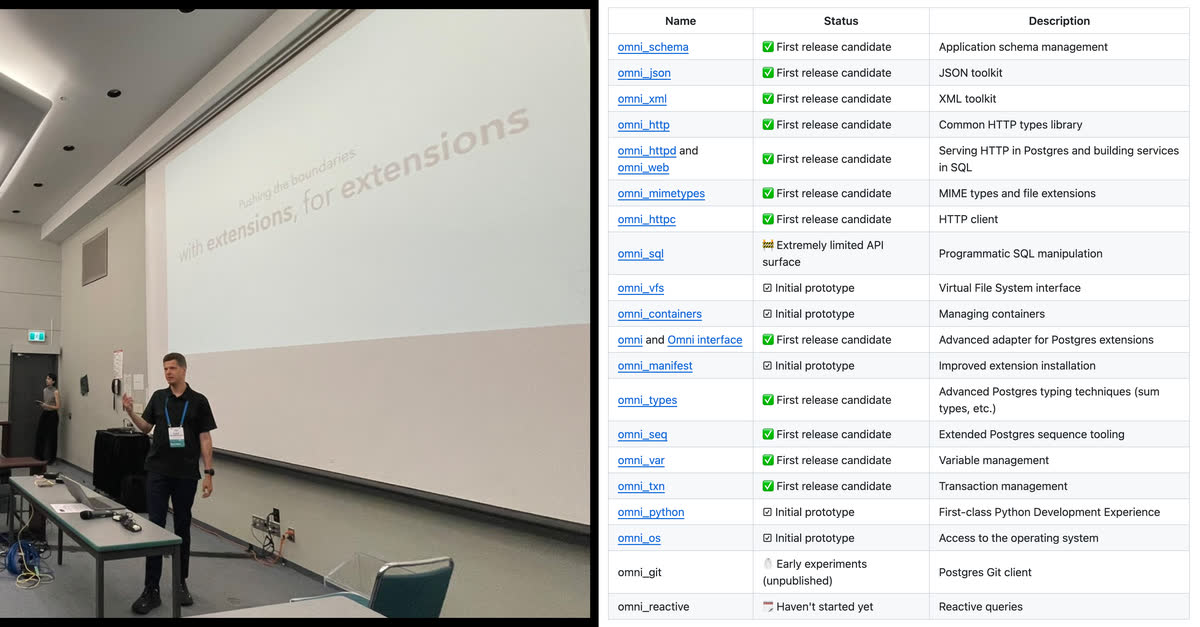
我和 Viggy 与 Yurii 聊的非常愉快,Yurii 手把手带我编译安装试用了一把 Omni。而我也准备在下一个 Pigsty 的版本中,就加入对 Omni 系列扩展的支持,让这个强大的应用开发框架开箱即用。
数据库中的无政府状态
第二场分享来自学术界(CMU),师从网红教授 Andy Pavlo 的阿比盖尔·金,主题为:数据库中的无政府状态 —— 数据库管理系统可扩展性的调查与评估。我对这个主题非常感兴趣,因为 Pigsty 将 PG可扩展性为首要价值主张,收录了 255 个扩展插件,而 Kim 的这个研究带来了一些有趣的发现。
在 Kim 比较的系统中,PostgreSQL 支持所研究的十类扩展点中的九类,覆盖范围最广。她的调查列出了 375 个以上的 PostgreSQL 扩展。
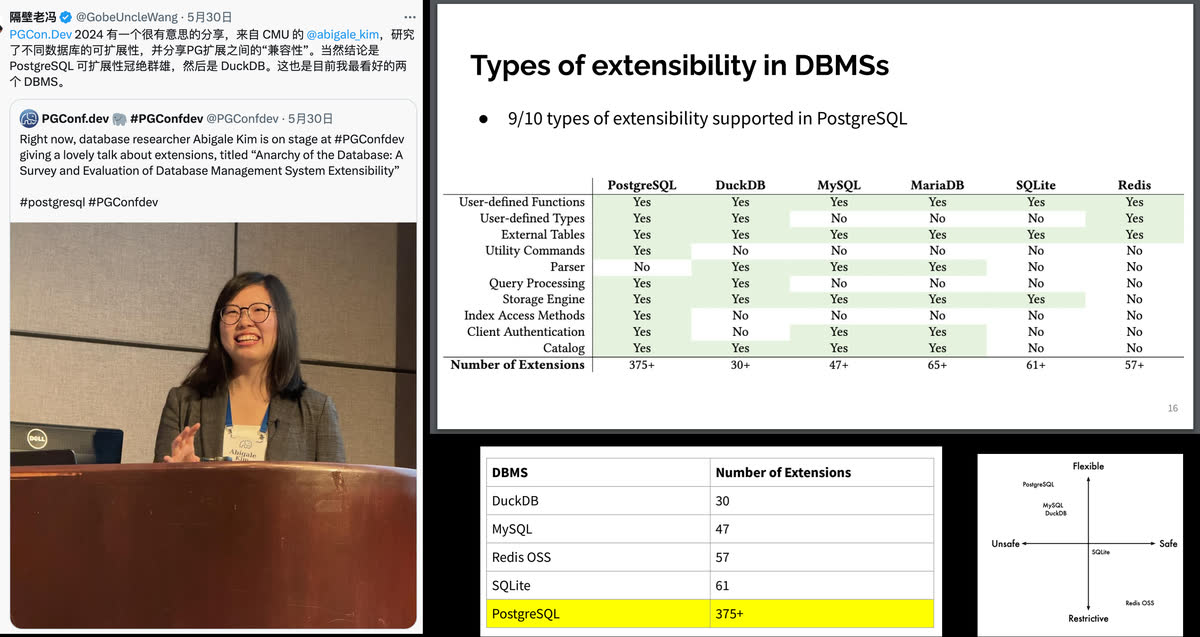
更有价值的是,Kim 定量分析了这些扩展之间的兼容性水平,得到了一个兼容性矩阵,并有一些有趣的发现 —— 例如,最为强大的 TimescaleDB 和 Citus 最容易与其他扩展发生冲突。而这样的信息对于用户与发行版维护者来说是非常有价值的。
我跟 Kim 聊天时说,这项研究为比较数据库可扩展性提供了具体数据。演讲幻灯片
PostgreSQL是如何被误用与滥用的
下午第一场,Crunchy Data 的 Karen Jex 从用户角度介绍了 PostgreSQL 初学者常犯的错误。这些例子对我来说很熟悉,但可以帮助开发者了解新用户如何使用数据库。
PostgreSQL与人工智能生态
下午的第二场,Bruce Momjian 分享了这个主题。Bruce 是 PGDG 发起人,从一开始到现在一直都是 PG 核心委员,也是中国各种 PG 会议的老熟人与常客了。
我本来以为分享的内容会是介绍一下PG生态的向量数据库扩展,或者类似 PGML,PG4ML 这样的机器学习扩展插件,结果竟然是如何利用 PostgreSQL 的多维数组与查询,实现神经网络的推理与训练。这样的把戏很好玩儿,但我很早也折腾过,没啥实用价值。
和 Bruce 吃饭聊天的时候也提到这个话题,Bruce 解释说,Jonathan Katz 为了介绍PG生态的向量数据库扩展 PGVector,需要一个话题来作为综述引子,于是就把 Bruce 拉壮丁过来灌水了,哈哈… PDF地址
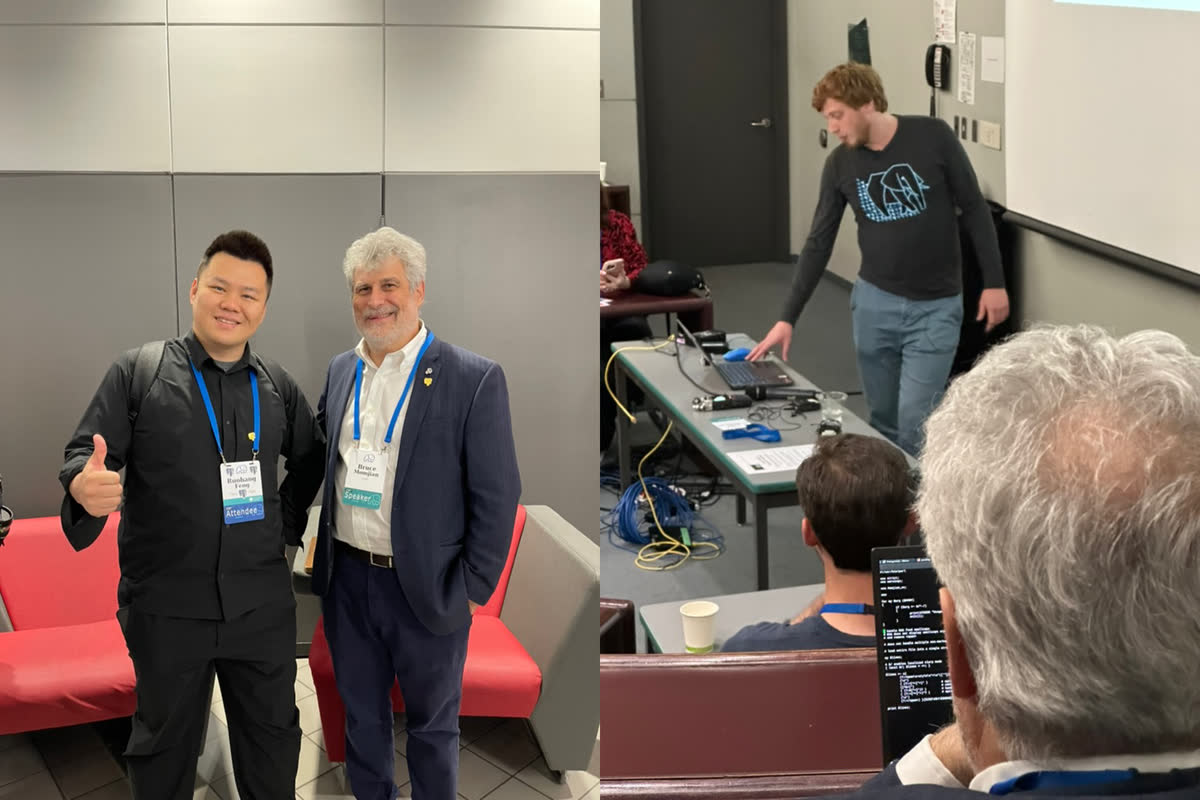
让我看看,Bruce在偷偷写什么代码?竟然是 ArgParser
会后和 Bruce 聊了很多有趣的话题,往年国内 PG 技术大会都喜欢请 Bruce 过来,或者远程做一个开幕分享。Bruce 说他很想再来中国,不过现在国际形势冲突加剧,美国大使馆发布的中国旅游风险等级太高,他也不敢过来了,让人遗憾。
构建PB级别的PostgreSQL部署
下午第三场,Chris Travers 介绍了他们从 Elasticsearch 迁移到分区、分片 PostgreSQL 部署的经历。按他的报告,原系统保留 30 天的数据,规模为 1 PB;迁移后的 PostgreSQL 部署存储了 10 PB 数据。
让我印象深刻的是这套系统在 10 PB 规模下的运维经验。演讲幻灯片介绍了这个具体案例。
临时加场:当数据库遇上新硬件
这是本次大会中我最喜欢的演讲。Margo Seltzer 是 UBC 教授、美国国家工程院院士,曾任教于哈佛,也是 BerkeleyDB 的作者之一。
Margo 的演讲极具激情与感染力,并一针见血地指出了数据库领域面临的几个核心问题。例如,数据库的瓶颈已经不再是磁盘的IO性能,而是主内存的速度瓶颈。而硬件领域的趋势 —— HBM,CXL 也许是解决这些问题的答案,但具体怎么做,那就是在座的各位 PG Hacker 需要面对的挑战了。
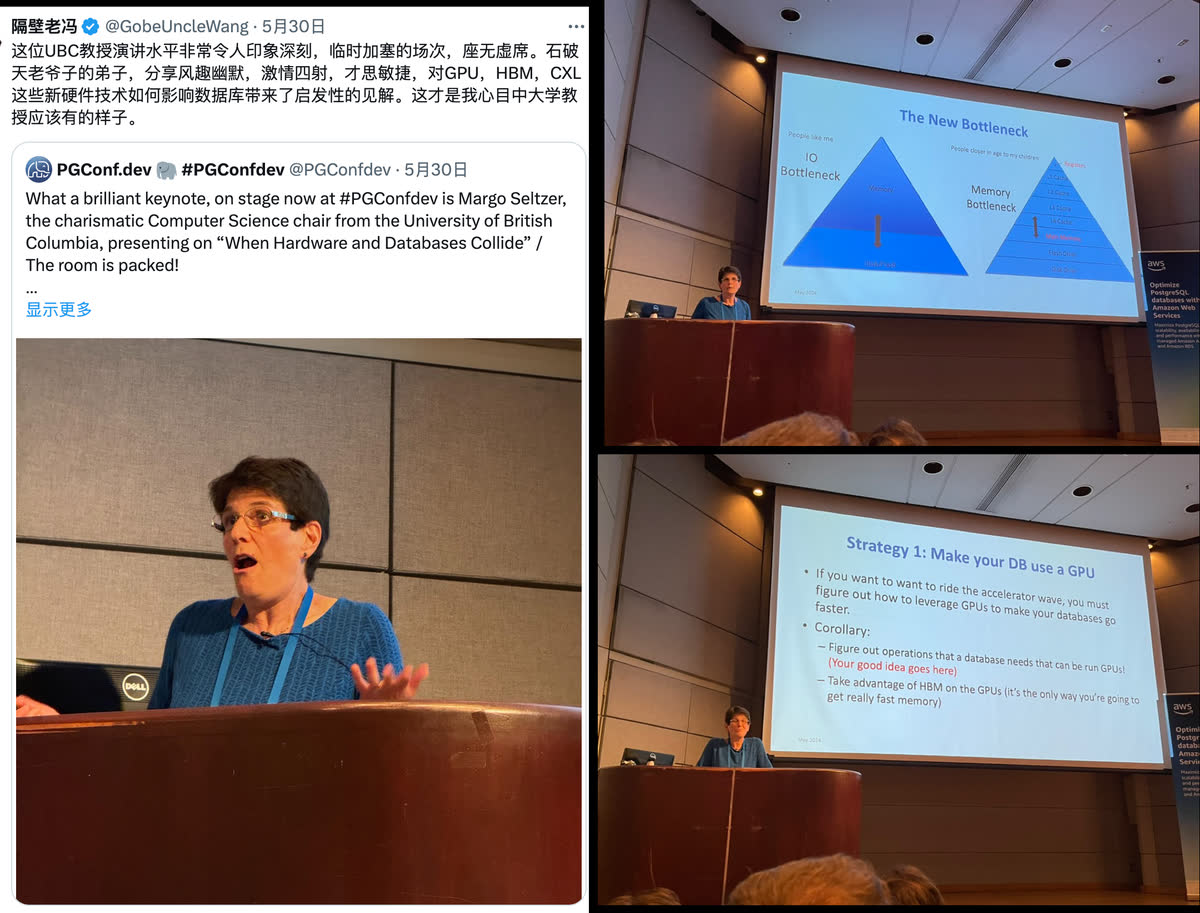
我很喜欢 Margo 直接而有感染力的演讲方式。大会视频发布后,值得再听一遍。
酒吧社交活动
Margo 的分享结束后便是大会的官方 Social Event,在会场一街之隔的 Waterfront 车站里的 Rogue Kitchen & Wetbar, 位置极好 —— 窗外就是温哥华地标,太平洋海景。
大家可以随意交流,结识新老朋友。我和许多人都聊了很多有趣的话题,比如 Devrim,Tomasz,Yurii,Keith 等等等等。同样作为发行版/RPM维护者,我和 Devrim 老爷子尤其详谈甚欢,许多积存已久的问题也得到了想要的答案。
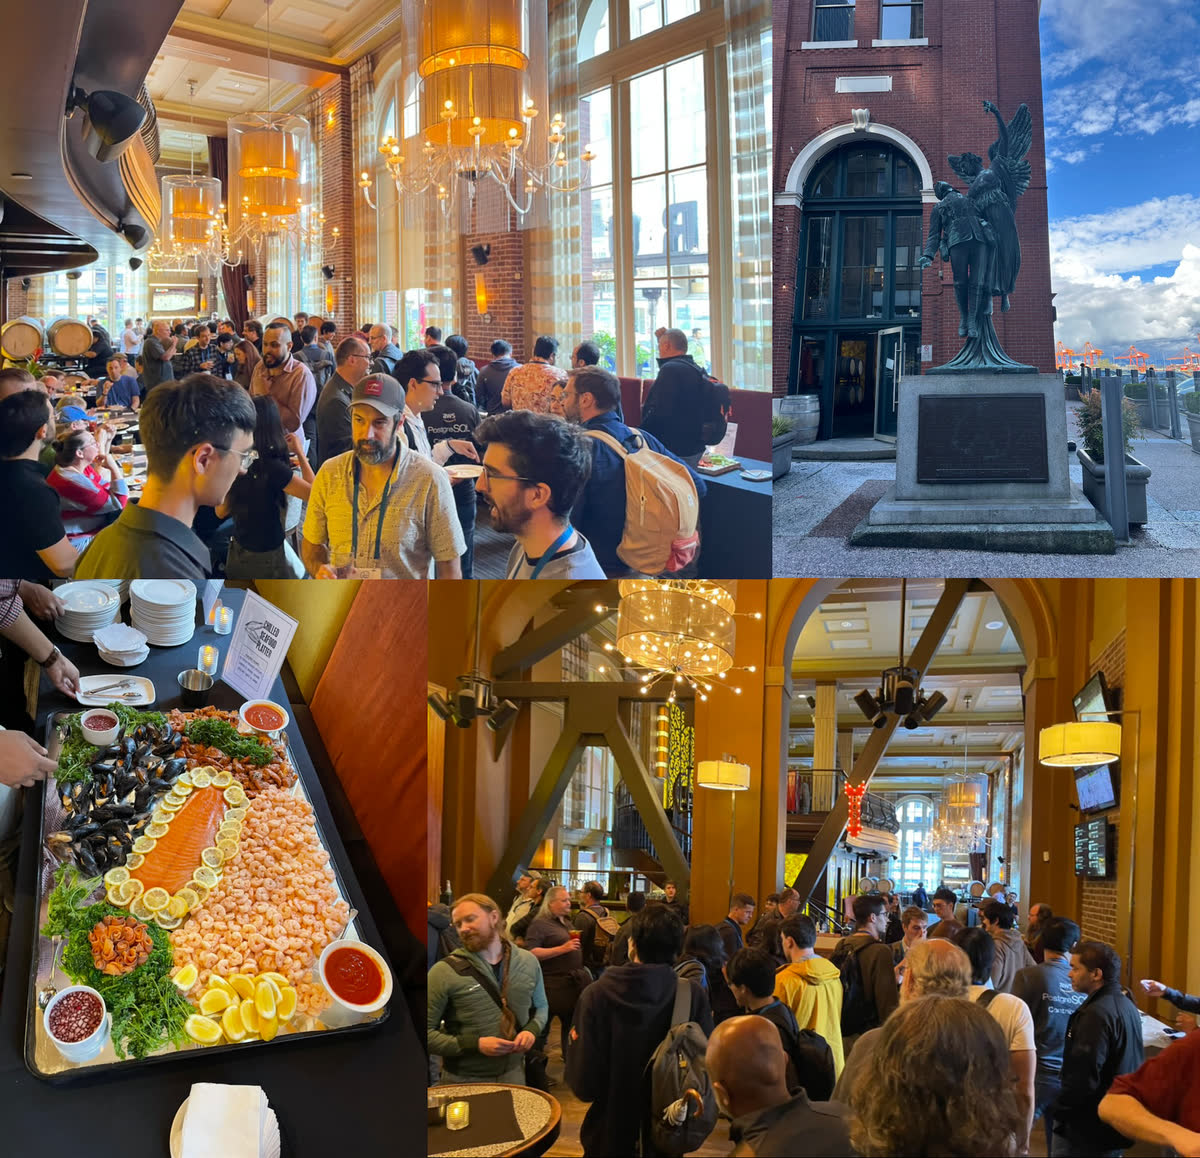
很多人都是老朋友了,难得相见一面,都聚在一起聊天。两杯啤酒下肚,许多人都打开心扉。再加上在场的都是 PG 同好,陌生人只要对个眼神也可以很轻松地聊起来。
于是在三四个小时的觥筹交错中,我和在场的 PG Hacker 基本都混了个熟脸。餐后 Melanie 喊我们去玩桌游,但我的英语做个专业演讲还行,但还没好到和 Native Speaker 玩猜词游戏和狼人杀的程度,甚是遗憾。
第二天的主题与活动
PostgreSQL 线程模型
第一天晚上的社交活动预热完,第二天大家就热情熟络得多了。今天的分享主题比较值得一提的是 “多线程 PostgreSQL”,成功做到了座无虚席。大家都很关注 Heikki 发起的这场讨论。Heikki 介绍了PG进程模型与线程模型的利与弊,详细实现路径与当前进展。
线程模型的收益有不少:更便宜的连接(等于内置连接池),共享的关系缓存,计划缓存,动态调整共享内存区域的能力,修改配置无需重启,Vacuum可以更加激进,运行中的 Explain Analyze,方便地限制每条连接的内存使用。但以 Tom Lane 为首的反对的声音也不小:这样可能会引入大量 Bug,丧失多进程模型隔离性的优势,以及 —— 引入大量的不兼容性,许多扩展都需要针对新的模型重写修改。
Heikki 提出了目标与相当详细周密的计划供在座的 Hacker 们评审 —— 在五到七年内,完成到线程模型的转换,最终目标是没有中间状态。有趣的是,Heikki现场在 PPT 里引用了最大反对者 Tom Lane 的一段评论:“在此说明,我认为这会是一场灾难,导致大量代码悄无声息的崩坏,让事情脱离我们的控制”。
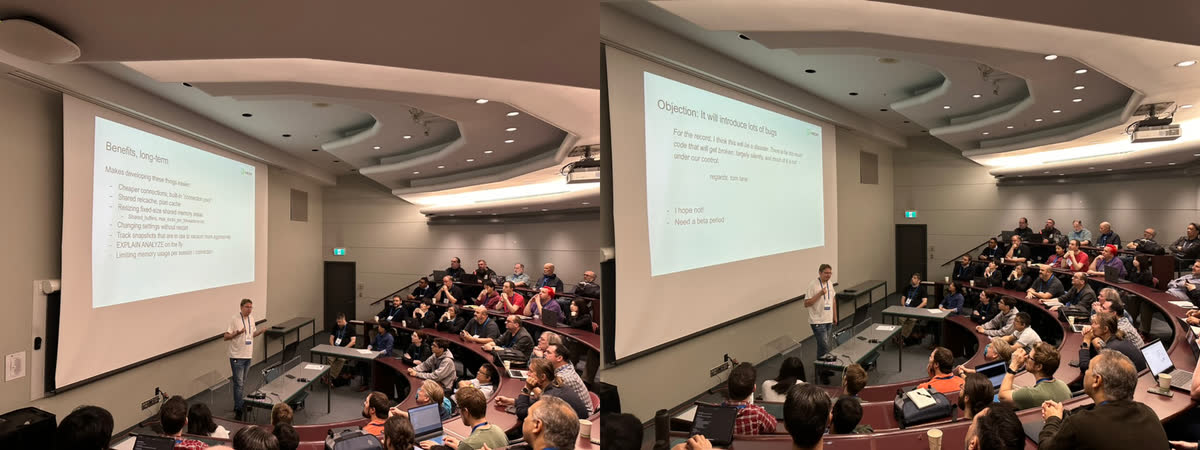
虽然被当场揶揄,但这一次 Tom Lane 现场听着也是慈祥微笑,并没有直接表示反对。而最大的反对声音不是来自 Tom Lane,而是扩展维护者,一位维护了好几个扩展插件的老爷子问到扩展兼容性怎么办?(主要是分配/使用内存的方式)Heikki 表示只能要求这些扩展作者在五年左右的过渡期内重写修改适配新的模型。气得这位老爷子直接愤而离场出去了。
鉴于线程模型对现有扩展生态的巨大冲击,我对这件事并不看好。我也与 Heikki 和 Tom lane 以及其他 Hacker 聊了一下关于线程模型的观点,总的来说,社区持谨慎观望态度。目前的进展也仅仅是在 PG 17 中重构了与 fork exec 有关的调用代码,并标记出使用的全局变量以便后续修改。即使真得发生,那也至少是 PG 2x 的事了。
走廊社交与大厅闲聊
第二天议题场次比第一天稍微水了一点点,所以更多的人参加的是 “Hallway Track”,就是在走廊大厅里和别人聊天。作为一个 i 人,我其实蛮不擅长这种场合的,但现场热烈的氛围很快就感染了我。再加上昨天晚上的酒吧社交环节大家也混了个脸熟,所以也算轻车熟路了。
在这样的场合中,想要开启一场和陌生人的对话,其实非常简单。你也不需要主动搭讪或者咋样,就只要眼神接触一下,对话就自然而然地触发了。给我的感觉和打 RPG 游戏一样,按下空格触发 NPC 对话。然后自我介绍一下,说说自己干嘛的,这不是就顺便把 Pigsty 广告到 PG 社区的每一个角落啦?
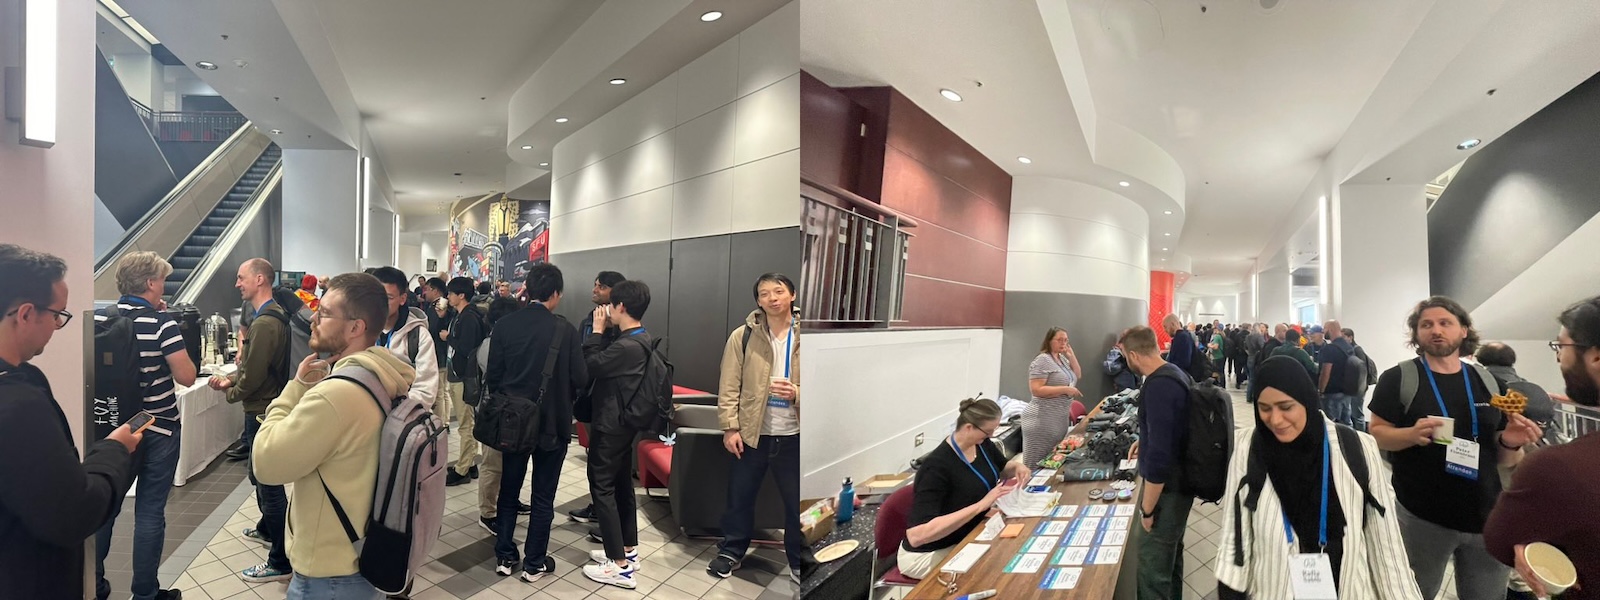
作为第一次现场参加 PGCon.Dev 的人,我很惊讶地发现自己有着与新人不匹配的知名度与关注度。有近半的参会者看到我的胸牌 Vonng / Pigsty 就认识我了 —— 主要还是归功于我之前写的那篇 PG 大爽文《PostgreSQL is eating the Database world》,Jonathan 跟我吐槽到说最近这篇文章天天出现在他的时间线上,整个 PG 社区的人基本上都看过了。
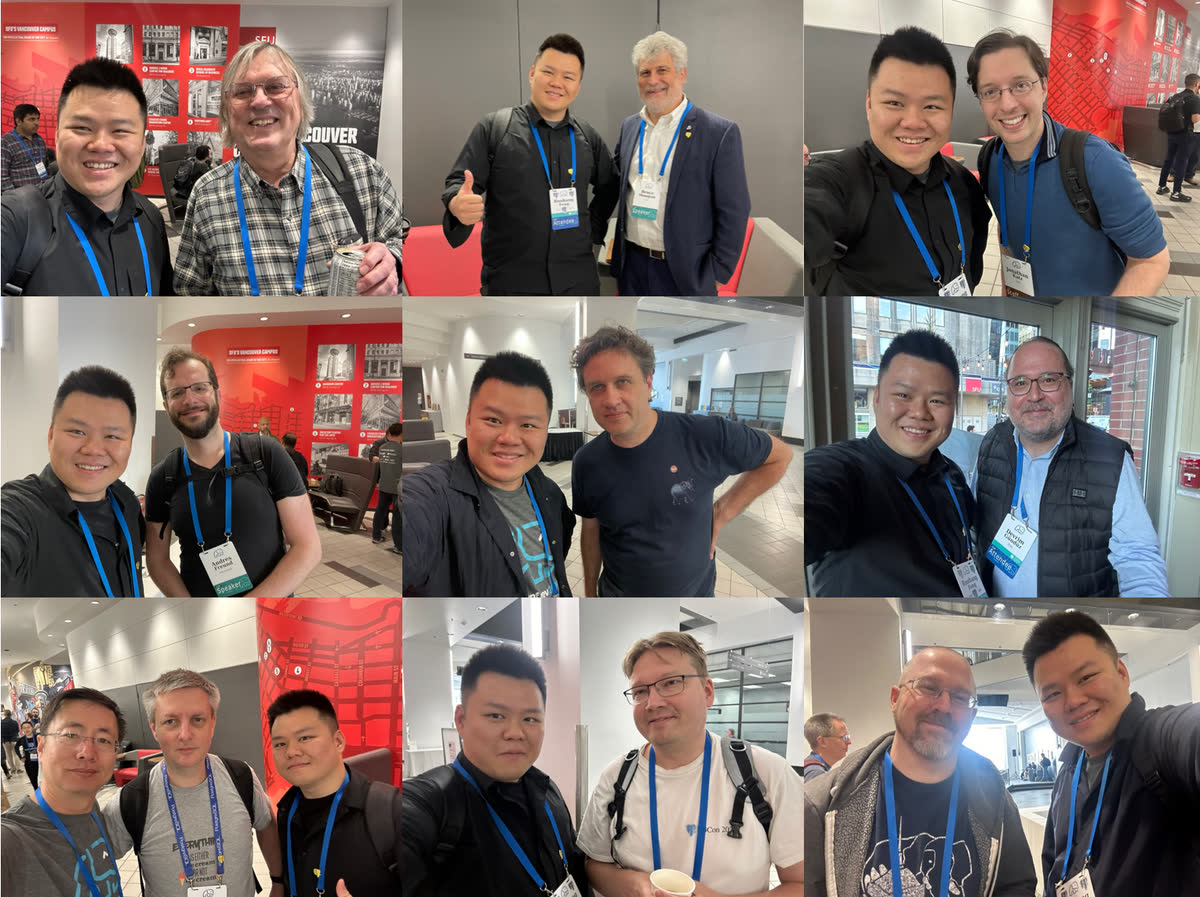
合影:Tom, Bruce, Jonathan, Andres, Robert Haas, Devrim, Scherbaum, Heikki, Keith,…
当然说起社交,最简单粗暴的诀窍就是礼多人不怪 —— 我准备了一盒胸针,PostgreSQL 的吉祥物 Logo Slonik,镀金的,还带个小亚克力盒子。我给每一个和我聊天的 PG Hacker 都送了一个,这个胸针成为了本次大会备受欢迎的抢手货。好多人都在胸前或者会牌上别上了,而没拿到的人就在问:咦你们这个在哪里拿的,是贡献者奖励吗?
Bruce 对这个胸针爱不释手,说:“哎呀这个精巧的徽章真是太可爱了,一看就不是那种便宜货”(但其实镀金其实不贵的),然后我就又送了他一个。总之,礼多人不怪,靠着 Pigsty,PG爽文,和 Slonik 小胸针,也算是在 PG 大会上吃开了。
小聚:多国社区会餐
中午,瀚高做东,把美国PG社区,欧洲PG社区,还有日本PG社区的几位头面参会者拉到一起聚餐,一家温哥华的广东菜馆。图中从左前开始逆时针顺序分别是,瀚高北美研究院的 Grant Zhou,瀚高创始人苗健,欧洲PG用户组/ Neon 的 Andreas Scherbaum,有PG核心组/ 美国EDB 的 Bruce Momjian,荣誉退休的前核心组成员 / pgEdge 的 Jan Wieck,制作各种PG贡献者硬币,社区周边的 Mark Wong,以及日本社区的 Tatsuro Yamada (山田達郎)与 Kyotaro Horiguchi (堀口恭太郎),最后是我。
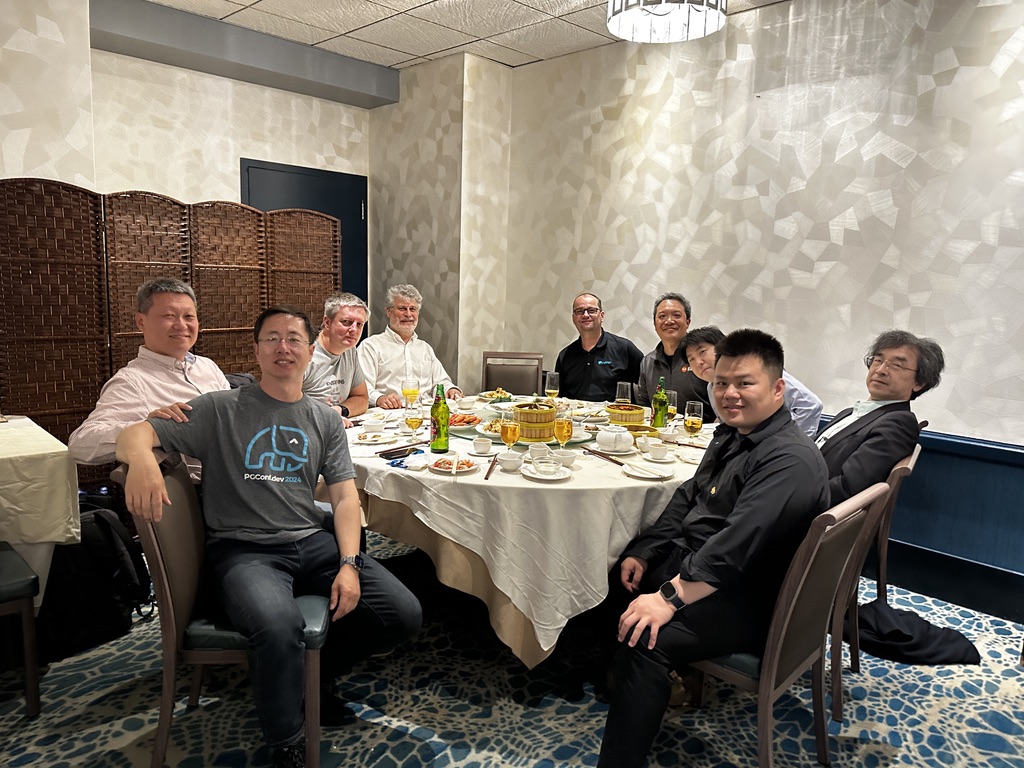
在饭桌上我们聊了各种各样的话题,坐在我边上的两位日本 PG 社区友人很有趣,堀口桑是一位 PG 核心贡献者,在 WAL 复制 / 多字节字符串处理上有很多贡献,还是 pg_hint_plan 的作者。另一位山田桑也是 PG 贡献者,对 Pigsty 很感兴趣,在本次大会上进行了题为 《索引建议不受待见,但很管用》的分享。
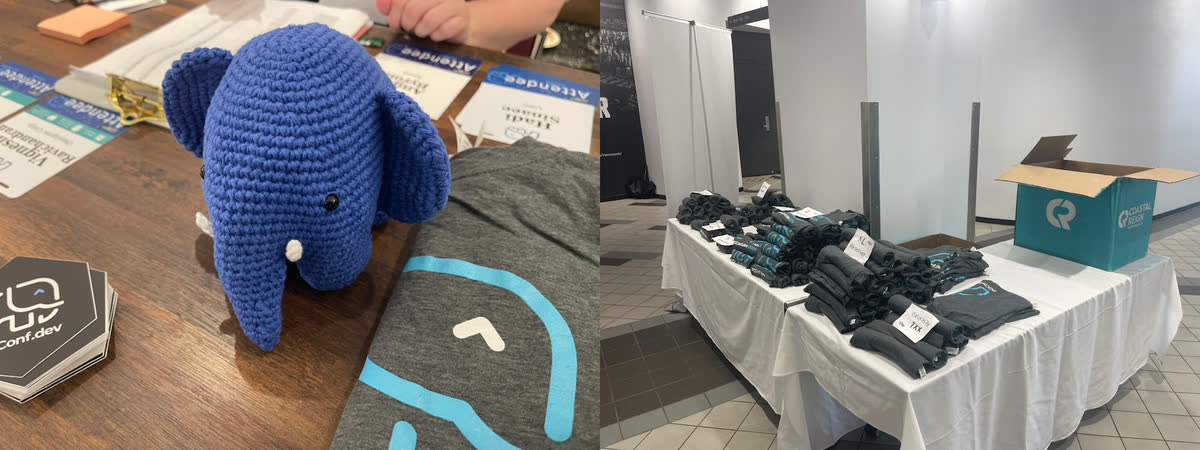
Mark Wong 也是 PG 社区的主要贡献者,PGUS 的组织者,开发了一系列 PG 监控扩展,但更有趣的是他还负责 PG 社区的周边,贡献者硬币,衣服,贴纸,还有这个特别可爱的毛线团小象也是他自己手工缝制的,让人爱不释手。据说他上次做的公仔在 PG Conf US 被人顺走了哈哈,所以这次看得可牢了。
Bruce 是 PG 中文社区的老朋友了,上面介绍过了;来自德国的 Andreas Scherbaum 是欧洲 PG 大会的组织者,我们一起参加了扩展峰会的 Binary Distribution 讨论,也邀请我们到时候去参加;瀚高是唯一一个出现在 PGCon.Dev 的中国数据库厂商,苗总从山东飞过来参加,也跟我们分享了一些国产数据库的故事与密辛。
在回会场的路上,我和 Jan Wieck 聊了很多,他是老一代光荣退休的 PG 核心组成员,也是 PL/pgSQL,PL/TCL,外键,视图,规则系统,TOAST,BGWriter,统计进程这些耳熟能详的PG核心功能的作者,他也是 Slony 的作者。路上我说我也想当一个 Major Contributor,他便与我分享了他参与 PG 贡献的故事:银行职员,工作需要用到数据库,就慢慢开始一步一步变成核心贡献者了 —— 他勉励我更多地参与到 PostgreSQL 贡献来,PG社区的未来就看你们年轻人的了。
让PG社区参与更有包容性
第二天下午与昨天一样,有一个无需三选一的特殊场次,主题是 社区建设,由 Robert Haas 主持。3 位新晋的 PG 提交者轮流分享他们成为提交者的历程,与遇到的挑战和问题,分别是:泽田正彦,阿米特·兰格特,梅兰妮·普拉格曼。总体上社区参与面临的几个主要挑战是:非英语母语者的参与问题,时区差异,带有情绪的电子邮件沟通。
Robert Haas 在会后的博客中提到:他真的很想看到更多来自印度与日本的人参与到 PG 的高级职位中来,因为这两个国家有着庞大的开发者社区,却没有核心组成员,高级职位代表性不足。
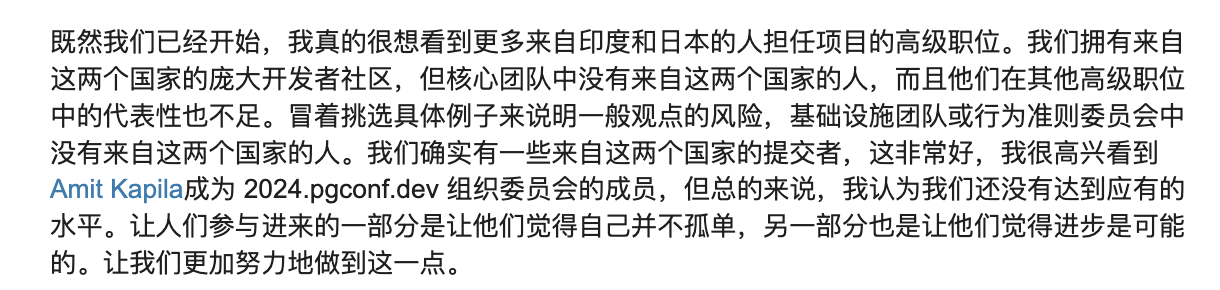
这场讨论提到了印度和日本,没有提到中国,让我有些感慨。我希望看到更多中国用户与开发者持续参与 PostgreSQL 上游。拓数派的 Richard Guo 当年刚成为 PostgreSQL committer。
据我了解,本次从中国前来参会的有瀚高的四位和我,共五人。
我希望自己的参与能帮助更多中文社区的用户和开发者建立联系,让他们的工作更容易被全球社区了解,也为后续合作创造机会。
闪电演讲
第二天下午的最后一个议程叫做: 闪电演讲。顾名思义,就是一个人只给5分钟,超时就立刻轰下来。大家都很干练,11 个主题整个才花了 45 分钟。在酒吧相谈甚欢的 Keith 分享了一些关于 PG Monitor 的改进,Peter Eisentraut 分享了关于 SQL 标准的跟进。当然,要说我最喜欢的分享,当属 Devrim Gündüz 关于 PG RPMs 的闪电演讲。昨天酒吧喝酒的时候,他神秘兮兮地说明天要放个大招,震撼全场,果不其然,在5分钟里讲完了 75 页的 PPT,气氛非常欢快~。
许多 PostgreSQL 用户直接安装二进制软件包。当时我为 Pigsty 维护 34 个扩展的软件包,Devrim 则在 PGDG RPM 仓库维护一百多个扩展。这些打包工作让更多用户能够安装和使用扩展。
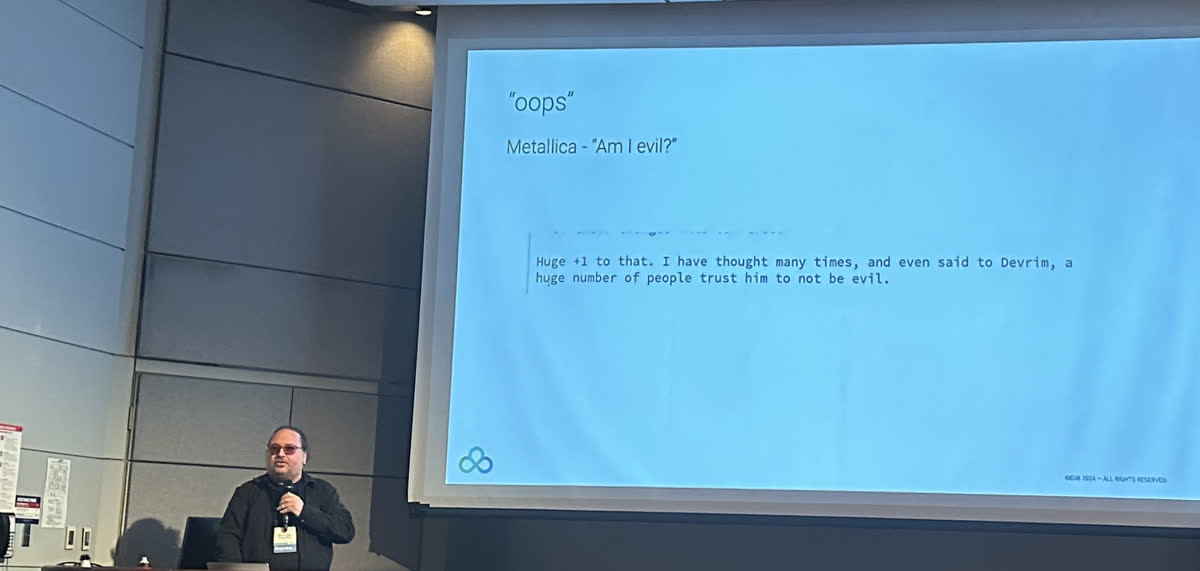
Devrim 要是想干坏事,那破坏力说不定比 xz 要大多了
Devrim 老爷子是一个很有意思的人,土耳其人,现居伦敦,还兼职酒吧 DJ 打碟,身上有一个 PostgreSQL Logo 的纹身,是 PGDG RPM 仓库的维护者。我跟他聊了一个多小时,了解了 PGDG 仓库的方方面面,讨论了许多问题。比如,一个扩展想弄进 PGDG 仓库里,一般需要什么条件,是什么流程。Devrim 说他会去关注 PGXN ,以及社区讨论,像最近大火的 pgvector 向量数据库扩展就是有人推荐给他,然后就收录进去了。我就白了一眼说:你看看推给你的那个人莫不是我…,哈哈哈哈。
说起来很有趣,在最近发布 Pigsty v2.7 中,我发现我维护的34个扩展里有4个 pgsql-http, pgsql-gzip, pg_net, pg_bigm 被纳入了 PGDG 官方仓库。我一和 Devrim 提起这个事,他就笑眯眯地跟说我:我跑到你的 Pigsty 网站扩展列表上扒拉了一圈,发现有几个不错的,就弄进官方仓库了。我就问,我打包的那些不错的 RUST 扩展有没有机会弄进官方仓库里?他马上义正严辞地表态 —— 这些 Go 和 Rust 异端插件想也别想!但反正你不是自己弄了个 YUM / APT 软件仓库专门放这些扩展吗?
我和 Devrim 聊得非常尽兴。最后我答应当一个 PG扩展猎手,发掘新的 PG 插件。如果觉得不错就交给他,收纳进 PG 的官方仓库里。
第三天:Unconference
如果说 PGCon.Dev 最精髓特色的节目是什么,那一定是 Unconference (自组织会议)。Unconference 没有预设的议程,而是由参与者在现场决定讨论的主题。
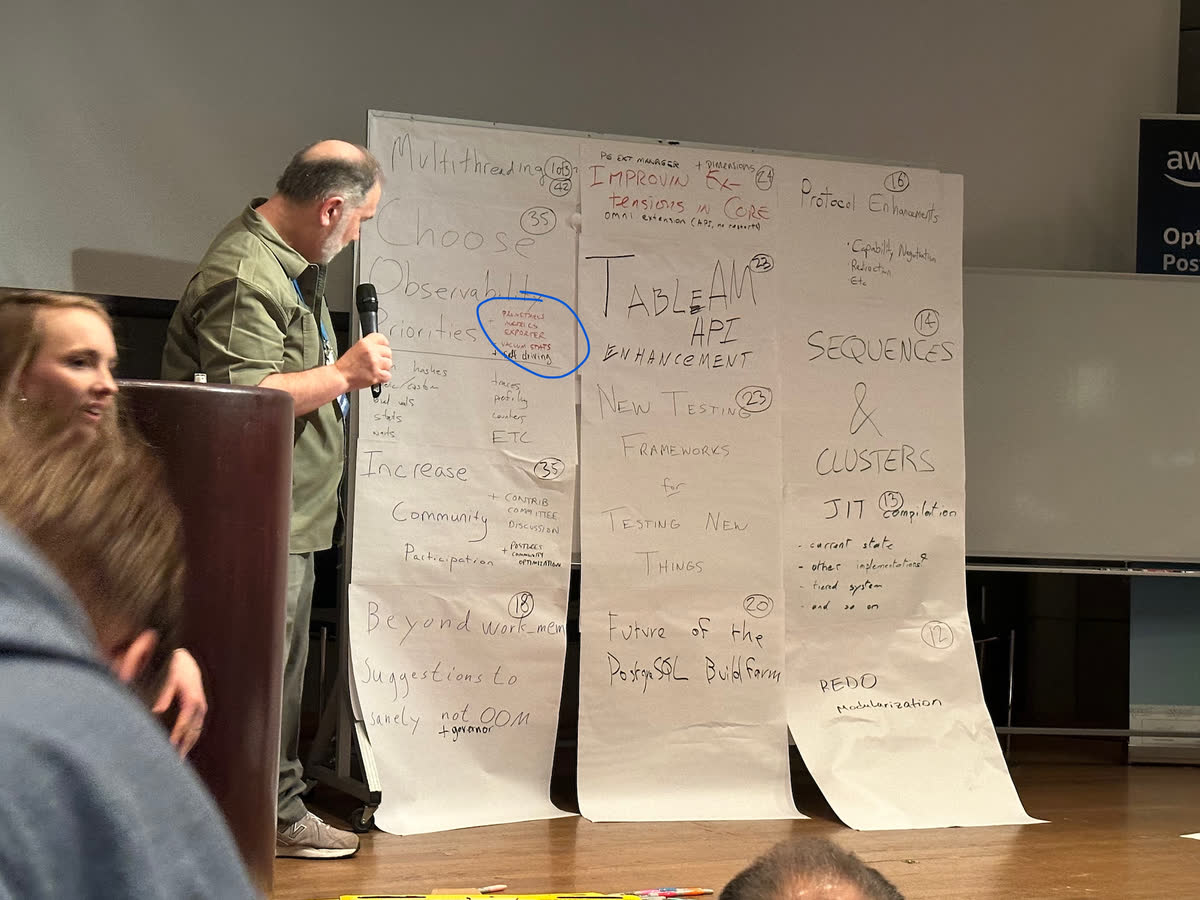
大会第三天全天的议程都是 Unconference,Joseph Conway 主持了 Unconference Organization 议程,愿意讲的人上去提交自己想介绍的主题,然后大家投票。当然我也上去提交了一个 Built-in Prometheus Metrics Exporter 的主题。
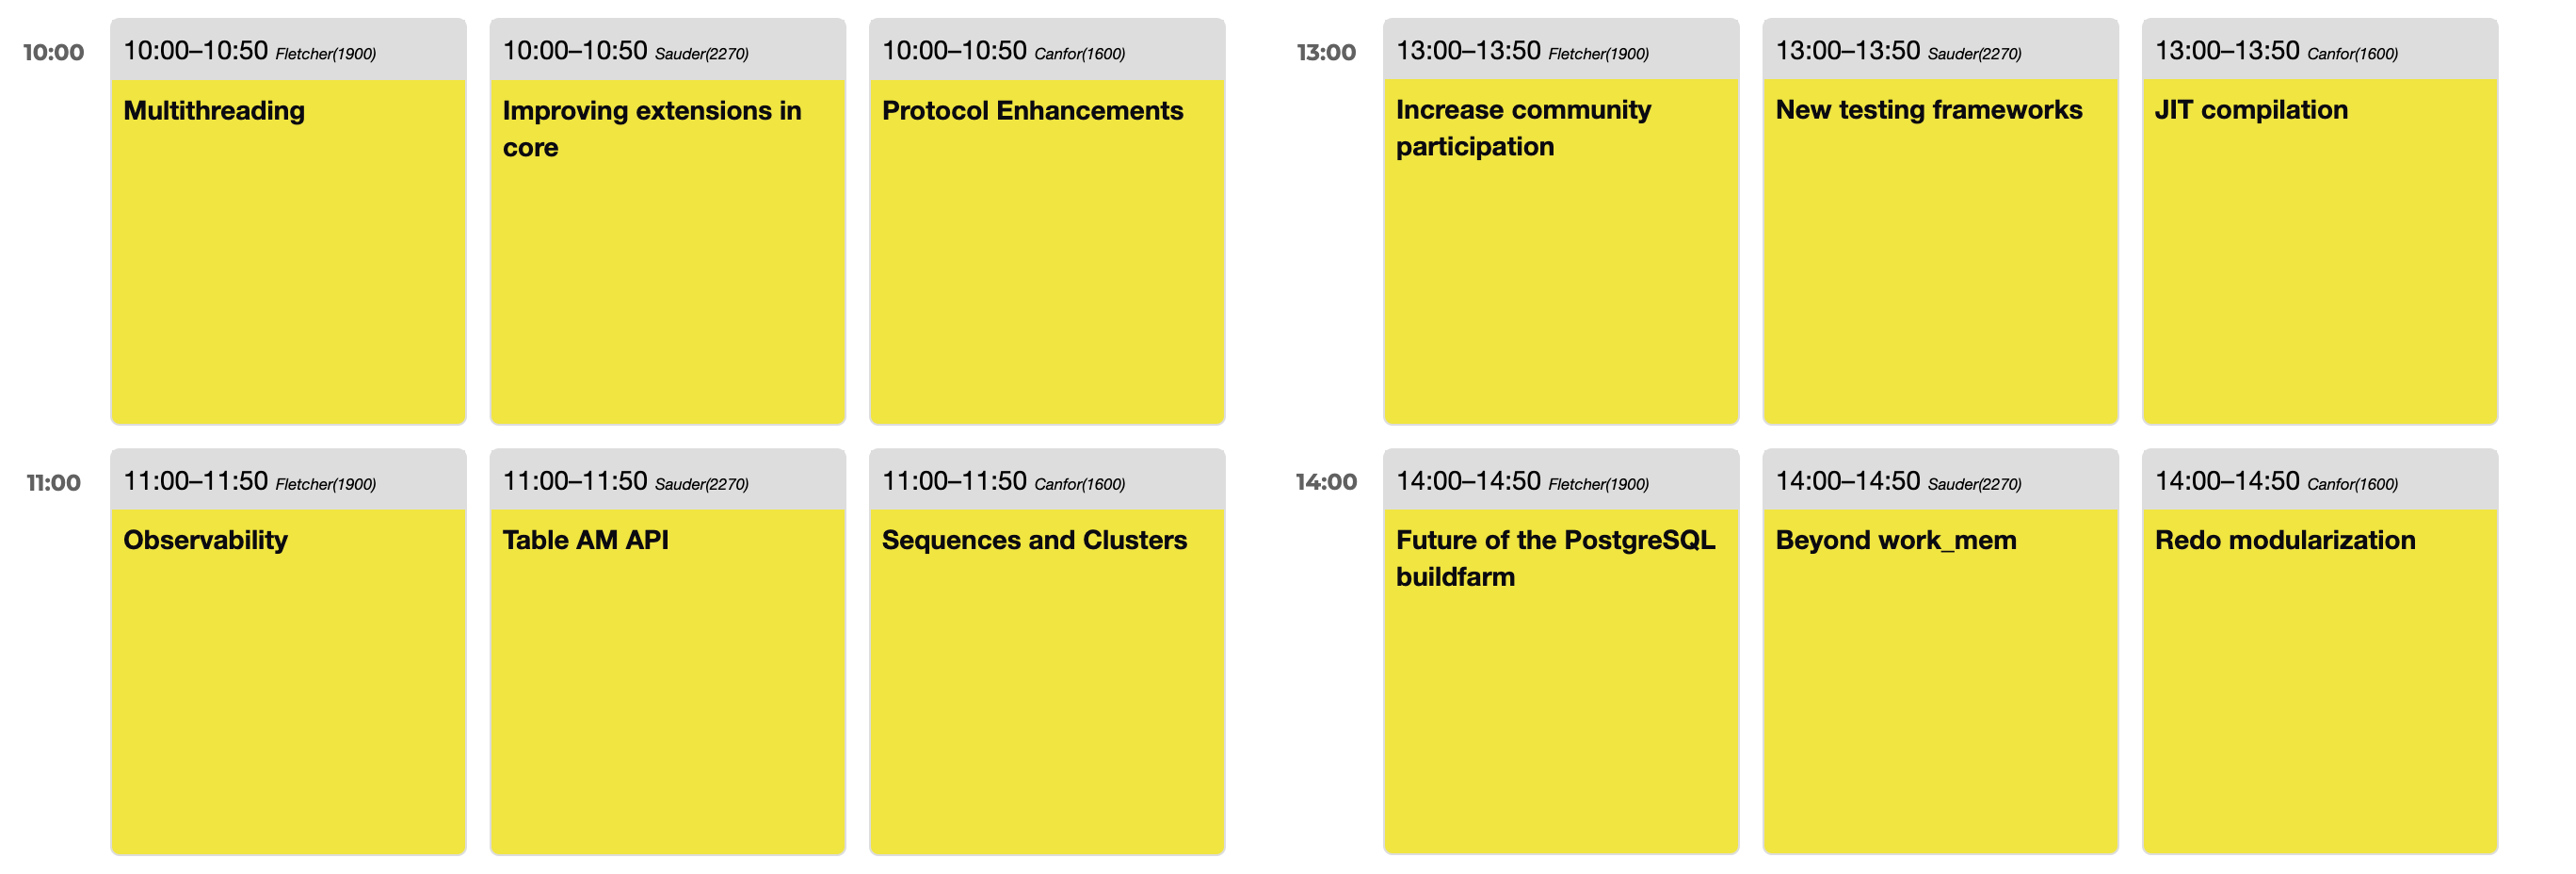
提交完后,每个议题主讲人上台简介自己的 Topic,并尽可能合并同类项,我的话题不出意料地被合入 Jeremy 发起的 Observability 主题里了。接下来就是大家投票选出感兴趣的演讲。排名前三的主题是: 多线程(42票),可观测性(35票),增强社区参与(35票)。 最后选出的主题如下:
作为 pg_exporter 的作者,我提出为 PostgreSQL 添加第一方监控扩展,内置 Prometheus 端点,通过 HTTP 提供指标。
这个提案希望减少管理独立 Exporter 的工作,并在崩溃恢复等无法接受 SQL 连接的阶段提供内部状态。这些能力仍需要在 PostgreSQL 中实现和验证。
实现的方案是采用类似 bgw_replstatus 扩展使用的后台工作进程,监听一个额外端口,通过 HTTP 对外暴露监控指标。内容上基本上也以我编写的 pg_exporter 作为蓝本,除了少量系统关键指标外,所有指标都通过一张 Collector 配置表进行定义。
这个想法得到了一些在座 PG Hacker 的关注。EDB ,CloudNativePG 的一些开发者也开始评估 pg_exporter 能否直接用在他们的发行版中,作为监控解决方案的一部分。现场所有对可观测性感兴趣的成员成立了一个 Observability SIG,并通过邮件列表进行后续的讨论。
议题:关于对龙芯提供支持
在大会最后两天中,我还与几位 PG Hacker 讨论了一些关于国产芯片,国产操作系统,中文字符集相关的中国特色数据库议题。
在之前发出的问题征集中,PG分会的类总提出了一个很好的建议,能不能让 PGDG 全球仓库支持龙芯 LoongArch 架构?国产芯片和国产操作系统厂商很乐意赞助这样的构建环境。带着这个问题,我询问了 RPM 仓库维护者 Devrim 老爷子;以及 Debian 侧的 Tomasz Rybak (备注:PGDG APT 仓库的维护者是 Christoph Berg,但 Tomasz 维护了 Debian 仓库中许多 PostgreSQL 相关的软件包),看看有没有可行性。
不过可惜的是,目前龙芯架构对于PG社区构建二进制使用的 OS 还没有提供支持 —— 例如 EL 系的 CentOS 7,Rocky 8,Rocky 9 ,以及 Debian 10/11/12 都无法在龙芯上运行。所以 Devrim 老爷子的回答是 No:而且构建的 Pipeline 必须在他们自己的机器和环境上可以跑起来,所以赞助云服务器的方式可能是走不通的。Tomasz 对于这个问题持开放态度,因为据说后面龙芯可能会支持 Debian13 ,那么就可以考虑把一些 PG 包的支持加进来。
总的来说,让 PG 官方 RPMs 支持龙芯架构估计没戏,但 APT 还是有可能的。但要龙芯支持主流开源社区 Linux OS Distro,这个事才有可能;如果是龙芯 + 一堆国产操作系统,那想都不要想,100% 没戏。
议题:关于服务端中文字符集支持
Jeremy Schneider 的分享介绍了排序规则变化带来的问题。他对简单、稳定排序方式的偏好,与我自己的实践相近。演讲幻灯片详细说明了其中的取舍。
会后在大厅里,我和 Jeremy 进一步地讨论了这个问题,核心组的 Peter Eisentraut 也参与了进来。Jeremy 问我中国用户是怎样使用字符集与 Collation 的,我说新应用大体上都用的是 C.UTF8,通常只有一些政企单位和传统行业的老系统才会去折腾服务端中文字符集。
我们还讨论了信息系统对 GB18030 字符输入、输出、处理和编码识别的兼容需求。
PostgreSQL 当时支持 GB18030 客户端编码,也可以通过 convert_to 转换为这种编码的字节串,但不支持将它用作服务端编码。ICU 排序规则也不会增加服务端编码支持。我还向 Peter 提出,convert_to(..., 'gb18030') 对大约 20 个新增汉字可能存在映射问题。Jeremy 和 Peter 都表示会继续调查。
闭幕式
自组织会议聊完后,大会也进入到了最后的尾声。 Jonathan Katz 与 Melanie Plageman 主持了闭幕式。确实是一场非凡的大会,让人意犹未尽。
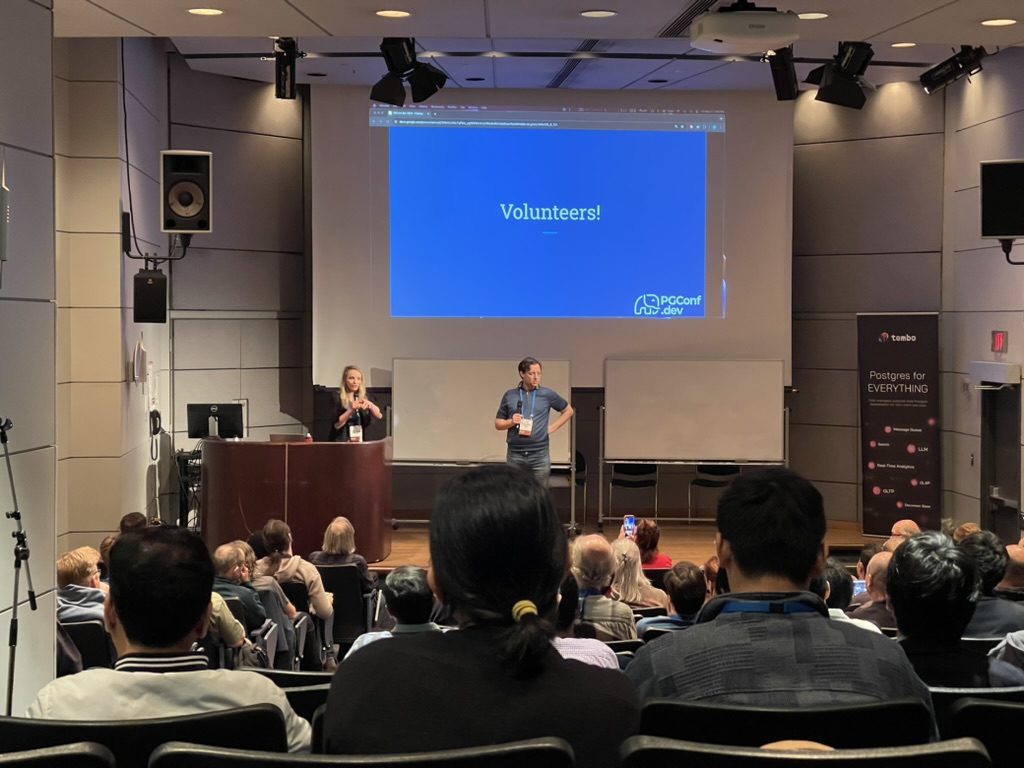
明年的 PGCon.Dev 2025 也会在加拿大举办,可能在温哥华,多伦多,渥太华或蒙特利尔四者之一。今年摸清楚了大会的调性与流程,我想明年可以去上台分享一个关于 Pigsty 或者 PG 可观测性的话题了。
顺带一提,参会的效果确实很明显,参会后,Pigsty 的海外下载 CDN 流量(这还只是一家云上的一部分)出现显著增长,打掉了我接近大几百G 的流量。更多的国际友人了解到了国内的 PostgreSQL 数据库发行版 Pigsty,哈哈。
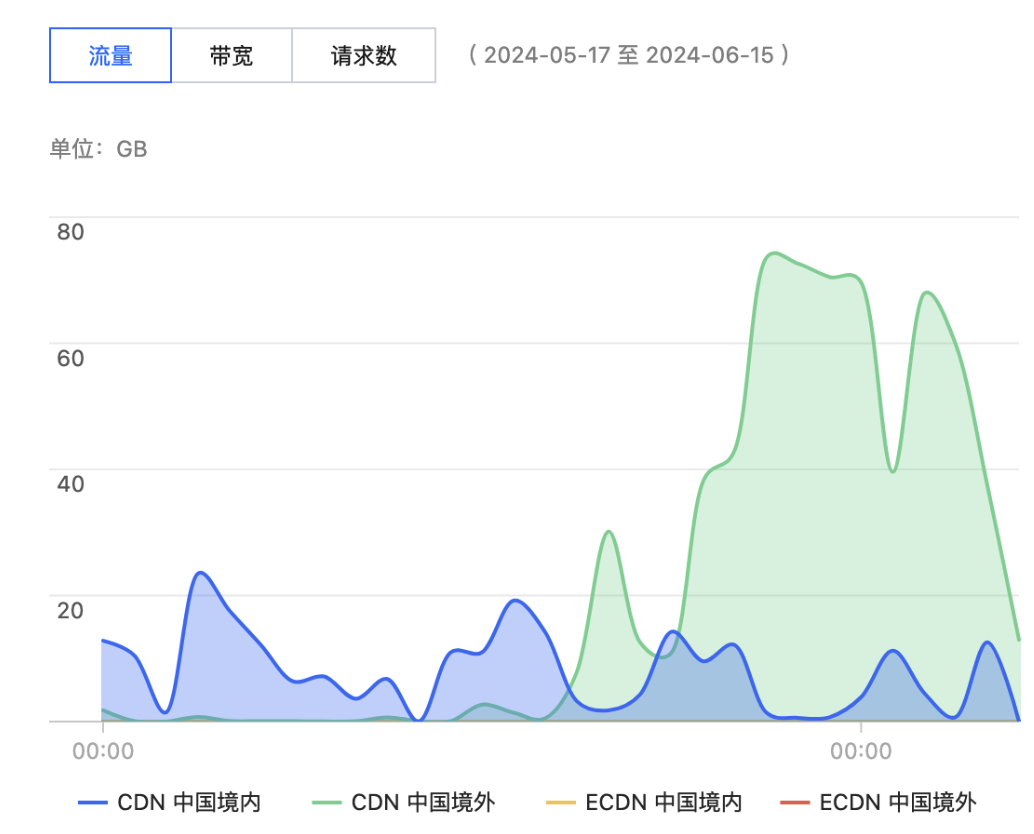
参会后来自海外的 CDN 流量有了一波暴增
大会的 PPT 一部分已经开放下载。当然,对 PostgreSQL 与 Pigsty 感兴趣的朋友也可以微信搜索 pigsty-cc 加群直接下载或参与讨论。以及,下面是一些 PGCon.Dev 相关的博客与文章:
3 - PostgreSQL 宏观查询优化之 pg_stat_statements
本文记录 2023 年的监控方法,示例采用 PostgreSQL 15 的字段和当时的监控面板。
参考原文:Nikolay Samokhvalov 的 PostgreSQL HowTO: pg_stat_statements 系列(第一篇、第二篇、第三篇)。
慢查询会增加响应时间和资源消耗,也可能延长锁等待,增加连接压力。因此,查询优化是 DBA 的核心工作之一。
在查询优化这条路上,有两种不同的方法:
宏观优化:整体分析工作负载,对其进行剖分下钻,自上而下地识别并改进其中表现最糟糕的部分。
微观优化:结合执行计划、慢查询日志和等待事件,分析并改进一条具体查询。
今天我们先来说说前者,宏观优化 有三个主要目标与动机:
减少资源消耗:降低资源饱和的风险,优化CPU/内存/IO,通常以查询 总耗时/总IO 作为优化目标。
改善用户体验:最常见的优化目标,在OLTP系统中通常以降低 查询平均响应时间 作为优化目标。
平衡工作负载:确保不同查询组之间的资源使用/性能表现的比例关系得当。
这些目标需要查询级别的数据支撑。pg_stat_statements 就提供了这些数据。
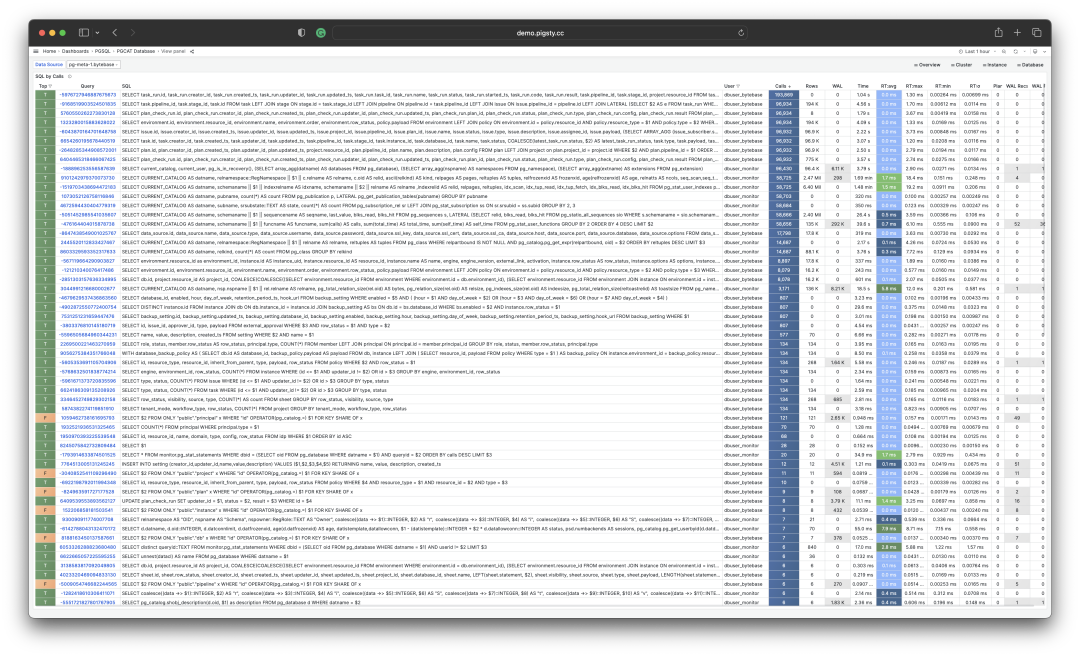
扩展插件:PGSS
pg_stat_statements,以下简称 PGSS ,是践行观宏之道的核心工具。
PGSS 出自 PostgreSQL 全球开发组官方之手,以第一方扩展插件的形式,随数据库内核本体一并发行,提供了跟踪 SQL 查询语句级别指标的方法。
我认为 PGSS 是生产监控的必备扩展。本文写作时,Pigsty 默认加载 PGSS 和 auto_explain,后者用于分析具体查询的执行计划。
将 pg_stat_statements 加入 shared_preload_libraries,重启 PostgreSQL,再在需要访问统计视图的数据库中执行 CREATE EXTENSION pg_stat_statements。PostgreSQL 15 还需要启用查询 ID 计算,默认的 compute_query_id = auto 即可满足要求。
PGSS 按规范化查询结构、数据库、用户和是否为顶层语句分组。同一查询组可以采用不同的执行计划。下面用建表语法展示 PostgreSQL 15 视图的字段;安装时应创建扩展,无需执行这段定义。
PostgreSQL 15 视图字段。所有时间字段的单位均为毫秒。下文的 pg_query_exec_time 指标将执行时间转换为秒。I/O 耗时需要启用 track_io_timing,计划统计需要启用 pg_stat_statements.track_planning。
执行统计在语句成功完成后更新。正在执行的语句看 pg_stat_activity,错误看日志。如果计划阶段成功、执行阶段失败,PGSS 仍可能记录计划统计。
queryid 取决于解析后的查询及其引用的数据库对象。物理副本通常具有相同的 ID。跨 PostgreSQL 大版本、逻辑副本,或删除后重建对象时,不应将它用作永久标识。
原始数据
PGSS 视图中的列可以分为三类:
描述性的标签列(Label):查询ID(queryid)、数据库 ID(dbid)、用户(userid),一个顶层查询标记,和标准化的查询文本(query)。
测量性的指标(Gauge):与最小、最大、均值标准差有关的八列统计量,以 min,max,mean,stddev 作为前缀,以 plan_time 与 exec_time 作为后缀。
累积性的指标(Counter):除了上面八列与标签列的 其他指标,例如 calls、rows 等,最重要、最有用的指标都在这一类里。
首先解释一下 queryid:queryid 是查询语句被解析后,剥离常量后生成规范化查询的哈希值,因此可以用来标识 同一类查询。不同的查询语句可能有着同样的 queryid (规范化后结构一样),同样的查询语句也可能有着不同的 queryid (例如因为 search_path 不同,导致实际查询的表不同)。
同样的查询可能会在不同的数据库中被不同的用户所执行。因此在 PGSS 视图中,queryid,dbid,userid,toplevel 四个标签列,共同组成了唯一标识一条记录的“主键”。
对于指标列而言,测量性质的指标(GAUGE) 主要是执行时间与计划时间相关的八个统计量,然而用户没有办法很好地控制这些统计量的统计范围,所以实用价值并不大。
真正重要的指标是 累积性的指标(Counter),例如:
calls :此查询组发生了多少次调用。
total_exec_time + total_plan_time:查询组累计耗费时间。
rows:查询组累计检索或影响的行数。
shared_blks_hit + shared_blks_read:缓冲池累计命中和读取操作次数。
wal_bytes:此组中的查询累计生成的 WAL 字节数。
blk_read_time 和 blk_write_time:累计花费在块读写IO上的时间
这里,最有意义的指标是 calls 与 total_exec_time,可以用于计算查询组的核心指标 QPS (吞吐量)与 RT(延迟/响应时间),但其他的指标也很有参考价值。
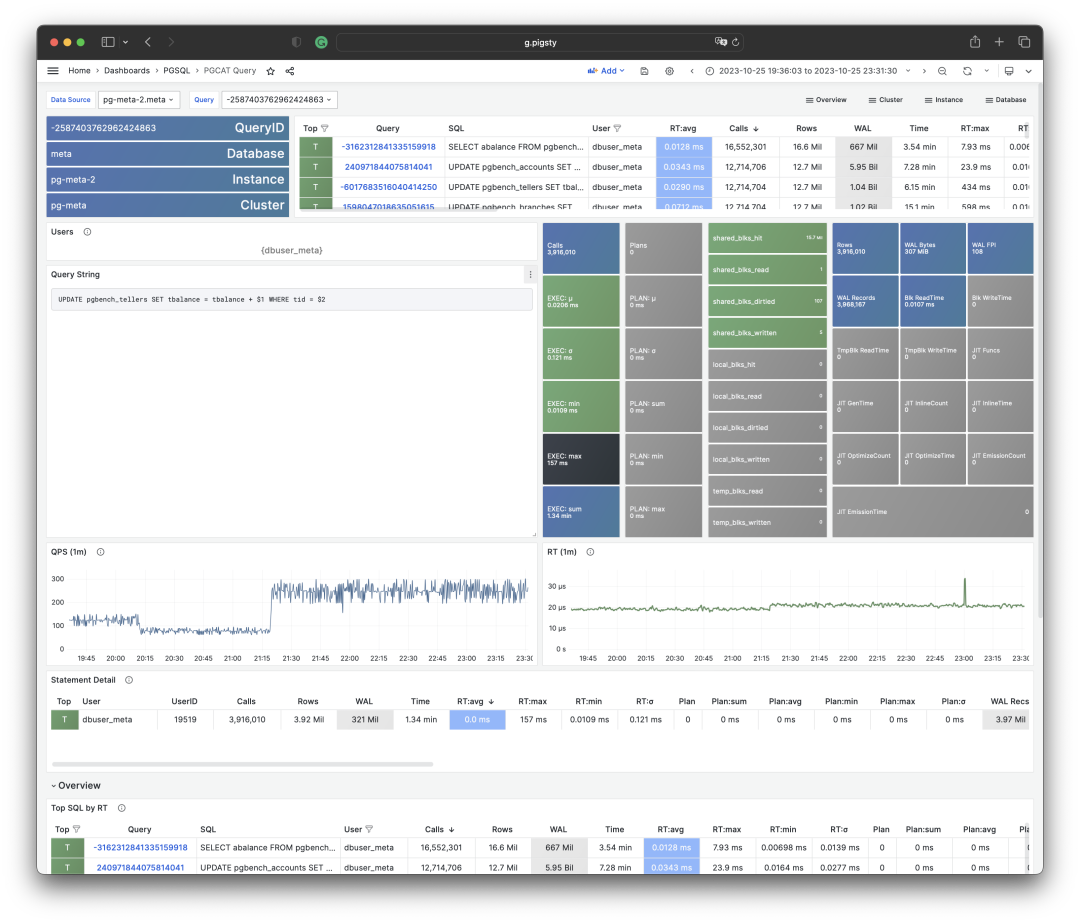
可视化展现 PGSS 视图的某个查询组快照
要衡量一段时间内的活动,至少比较两个快照。先匹配相同的查询组标识,再处理计数器重置或条目淘汰,最后计算差值。
单个快照表示该条目自开始统计以来的累积工作量。分析具体故障时,时间窗口内的增量更有用。
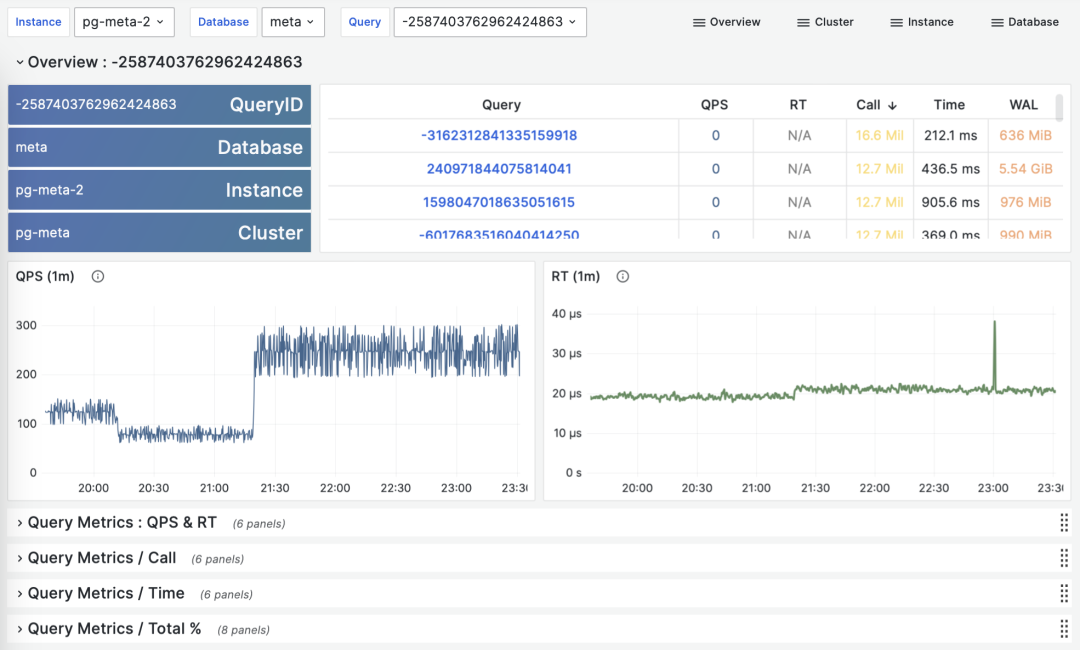
根据多个 PGSS 查询组快照计算历史时序指标
本文所用的 Pigsty 部署每隔 10 秒截取总耗时排名前 256 的查询快照。有了累积指标 M 在不同时刻的采样,就可以计算三类派生指标:
dM/dt :指标 M 基于时间的微分,即每秒的增量。
dM/dc:指标 M 基于调用次数的微分,即每次调用的平均增量。
%M:指标 M 在整个工作负载中所占的百分比。
这三类指标正好与宏观优化的三类目标相对应,对时间的微分 dM/dt 揭示了 每秒资源使用量,通常用于减少资源消耗的优化目标。对调用次数的微分 dM/dc 揭示了 每次调用的资源使用量,通常用于改善用户体验的优化目标。而百分比指标 %M 展示了查询组在整个工作负载中所占的百分比,通常用于平衡工作负载的优化目标。
对时间微分
让我们首先来看第一类指标:对时间的微分。在这里,我们可以使用的指标 M 包括:calls,total_exec_time,rows,wal_bytes,shared_blks_hit + shared_blks_read,以及 blk_read_time + blk_write_time。其他的指标也有参考意义,但让我们从最重要的开始。
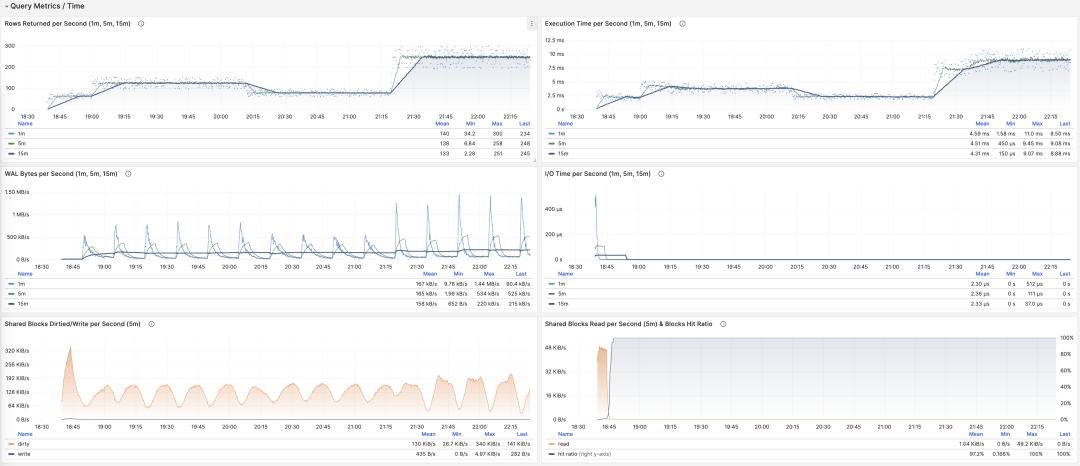
可视化展现对时间的微分指标 dM/dt
计算这些指标的方式其实很简单,我们只需要:
- 首先计算两个快照之间的指标值 M 的差值:M2 - M1
- 然后计算两个快照之间的时间差值:t2 - t1
- 最终计算 (M2 - M1) / (t2 - t1) 即可
生产环境通常会使用 5s,10s,15s,30s,60s 这样的数据采样间隔。对于负载分析通常会使用 1m, 5m,15m 作为常用的分析窗口大小。
例如,当我们计算 QPS 时,就会分别计算最近 1分钟,5分钟,15分钟的 QPS。窗口越长曲线就越平稳,更能反映长期变化趋势;但是会隐藏短期波动细节,不利于发现瞬时异常波动,所以不同粒度的指标需要结合来看。
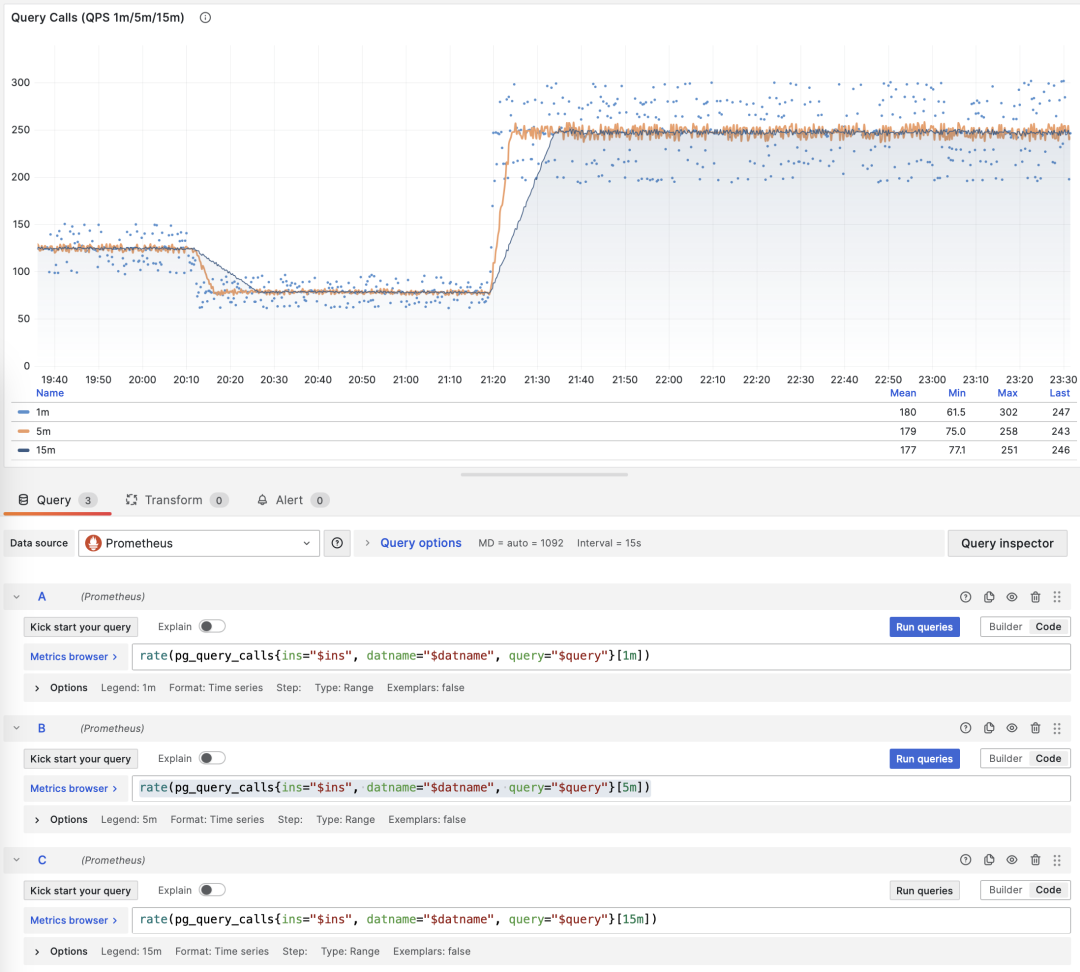
展示特定查询组 1/5/15 分钟窗口下的 QPS
例如,rate(pg_query_calls{}[1m]) 计算每条已采集查询组序列在最近一分钟内的 QPS。计算总量时,先筛选目标实例,再对这些序列求和。
QPS
当 M 是 calls 时,对时间求导的结果是 QPS,它的单位是每秒查询数(req/s),这是一个非常基础的指标。查询 QPS 属于吞吐量指标,直接反应了业务施加的负载状况,如果一个查询的吞吐量过高(例如,10000+)或者过低(例如,1-),有可能是值得关注的。
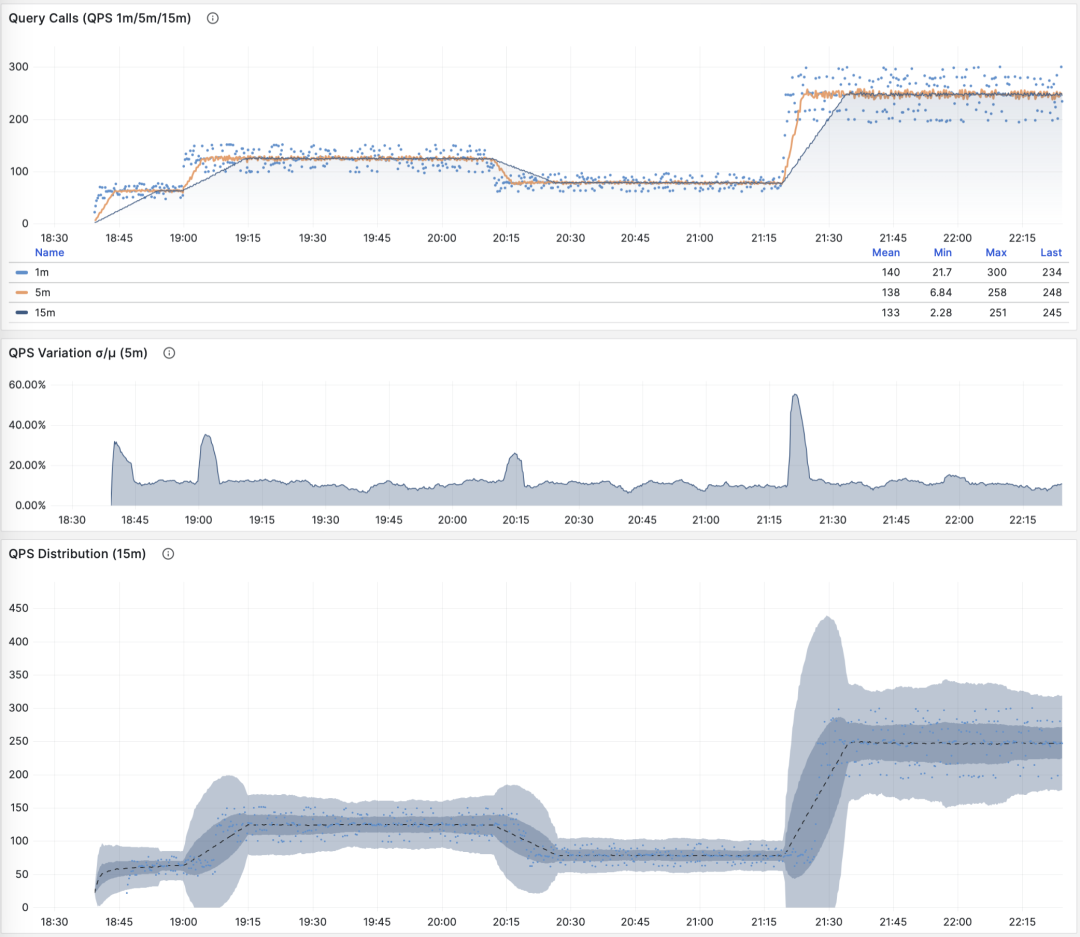
QPS:1/5/15 分钟 µ/CV, ±1/3σ分布
如果我们把所有查询组的 QPS 指标累加起来(且没超过PGSS的收集范围),就会得到所谓的 “全局QPS”。另一种获得全局 QPS 的方式是在客户端打点,在类似 PgBouncer 的连接池中间件上采集,或者使用 ebpf 探测。但都不如 PGSS 方便。
请注意,QPS 指标并不具备负载意义上的 横向可比性。不同查询组可能有着同样的 QPS,而单个查询的耗时却天差地别。甚至同一个查询组在不同时间点上产生的负载水平,也可能因为执行计划不同而发生巨大变化。每秒执行时长是一个更好的衡量负载的指标。
每秒执行时长
当 M 是 total_exec_time (+ total_plan_time,可选 )时,我们就会得到宏观优化中最重要的指标之一:在查询组上耗费的执行时间,有意思的是,这个导数的单位是 秒/每秒,所以分子分母相互约掉了,使得它实际上是一个无量纲的指标。
例如,2 s/s 表示这组查询每秒累积了两秒的服务端执行时间。多个后端并发执行即可产生这个值,即使只有一个 CPU 核也可能出现:执行时间包含等待时间。
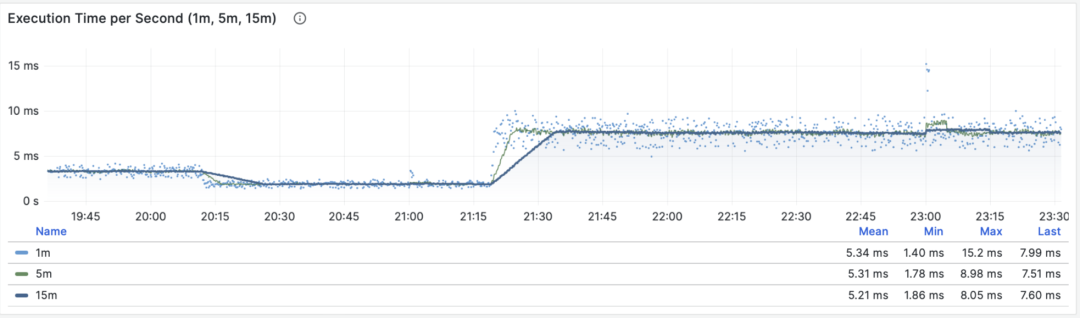
每秒执行时长:1/5/15 分钟均值
因此这里的值也可以理解为一个百分比:可以超过 100%,在这种视角下,它是一个类似于主机 load1, load5, load15 的指标,揭示了该查询组产生的 负载水平。如果除以 CPU 核数,甚至可以得到归一化的查询负载贡献度指标。
但是我们需要注意的是,执行时间中包括了等待锁,等待I/O的时间。所以确实可能出现这样的情况:查询执行时间很长,但却没有对 CPU 负载产生影响。所以如果要精细分析慢查询,我们还要参考 等待事件 来进一步分析才行。
每秒行数
当 M 是 rows 时,得到的是每秒检索或影响的行数。对于 SELECT 查询组,10000 rows/s 表示每秒产生一万行结果;对于 UPDATE 或 DELETE 查询组,它表示影响的行数,而不是发给客户端的数据量。
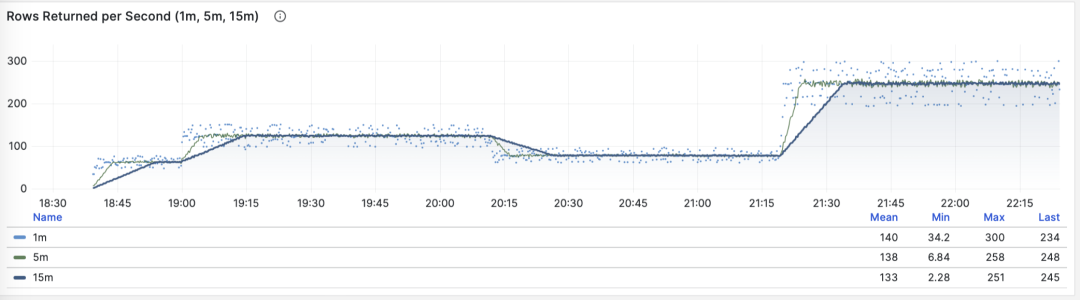
每秒检索或影响的行数:1/5/15 分钟均值
共享缓冲区访问带宽
当 M 是 shared_blks_hit + shared_blks_read 时,我们会得到每秒命中/读取的共享缓冲区块数,如果将其乘以默认块大小 8KiB(极少情况下有可能会是其他的大小,例如32KiB),我们就会得到一类查询“访问”内存磁盘的带宽:单位是字节/秒。
举个例子,如果某一类查询每秒访问50万次共享缓冲区,折合 3.8 GiB/s 的内部访问数据流:那么这就是一个显著负载,也许会是一个很好的优化候选项。也许你应该检查一下这个查询,看看它是否配得上这些“资源消耗”。
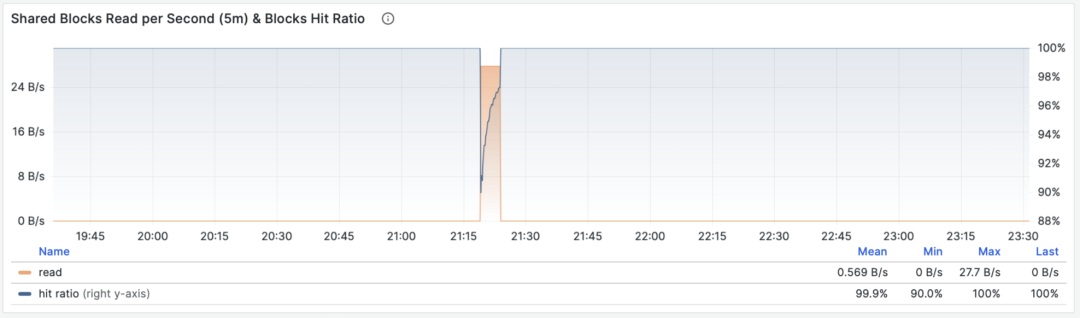
共享缓冲区访问带宽与缓冲区命中率
另一个值得参考的衍生指标是缓冲区命中率:即 hit / (hit + read) ,它可以用于分析性能变化的可能原因 —— 缓存未命中。当然,重复访问同一个共享缓冲池里的块,并不会真的重新读取,即使真的去读取,也不一定是读取磁盘,有可能是读内存中的FS Cache。所以这里只是一个参考值,但它确实是一个非常重要的宏观查询优化参考指标。
WAL日志量
当 M 是 wal_bytes 时,我们得到了该查询生成 WAL 的速率,单位是字节/每秒(B/s)。这个指标是在 PostgreSQL 13 新引入的,可以用来定量揭示查询产生的 WAL 大小:写入的 WAL 越多越快,刷写磁盘、物理复制/逻辑复制、日志归档的压力就会越大。
一个典型的例子是:BEGIN; DELETE FROM xxx; ROLLBACK; 。这样的事务删了很多数据,产生了大量 WAL 却没有执行任何有用的工作,通过这个指标可以将其揪出来。
WAL字节率:1/5/15 分钟均值
DELETE 已经成功执行,之后显式执行的 ROLLBACK 撤销了事务。PGSS 会记录这条成功语句及其生成的 WAL。
SELECT 设置元组的 Hint Bit 时也可能生成 WAL。启用数据校验和或 wal_log_hints 后,检查点之后首次发生的此类页面修改可能需要写入全页镜像。参阅 WAL 配置。
可以检查 wal_fpi,判断读密集负载产生的 WAL 是否来自全页镜像。
共享缓冲区写脏/写回带宽
对于 13 以下的版本,共享缓冲区写脏/写回带宽指标可以作为一个近似下位替代,用于分析查询组的写入负载特征。
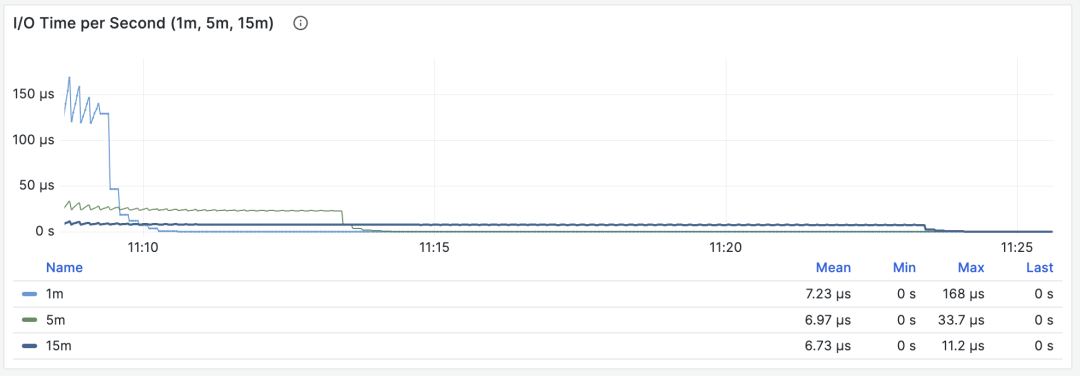
I/O耗时
当 M 是 blk_read_time + blk_write_time 时,先将毫秒转换为秒,再计算速率,得到每秒累积的 I/O 耗时。采集这些字段需要启用 track_io_timing。
I/O 耗时对于分析查询毛刺原因很有帮助
这些耗时包括由操作系统缓存满足的读取。结合主机磁盘指标,区分缓存读取与实际存储 I/O。
对时间微分的指标 dM/dt,可以展现出一个数据库实例/集群内部工作负载的全貌,对于优化资源使用的场景来说尤其有用。但是如果您的优化目标是改善用户体验,那么可能另一组指标 —— 对调用次数的微分 dM/dc,会更有参考意义。
对调用次数微分
计算 dM/dc 时,分母从时间差改为 调用次数的增量,结果表示每次完成的调用平均消耗多少资源。
这类指标重要性相比前者甚至更高,因为它提供了直接关乎用户体验的几个核心指标,比如最重要的 —— 查询响应时间 (RT,Response Time),或曰 延迟(Latency)。
计算这些指标的方式也很简单,我们只需要:
- 计算两个快照之间的指标值 M 的差值:M2 - M1
- 然后计算两个快照之间的 calls 差值:c2 - c1
- 然后计算 (M2 - M1) / (c2 - c1) 即可
对于 PromQL 实现来说,对于 调用次数的微分指标 dM/dc,可以用“对时间的微分指标 dM/dt” 计算得到。例如要计算 RT,就可以使用 每秒执行时长 / 每秒查询数 ,两指标相除即可:
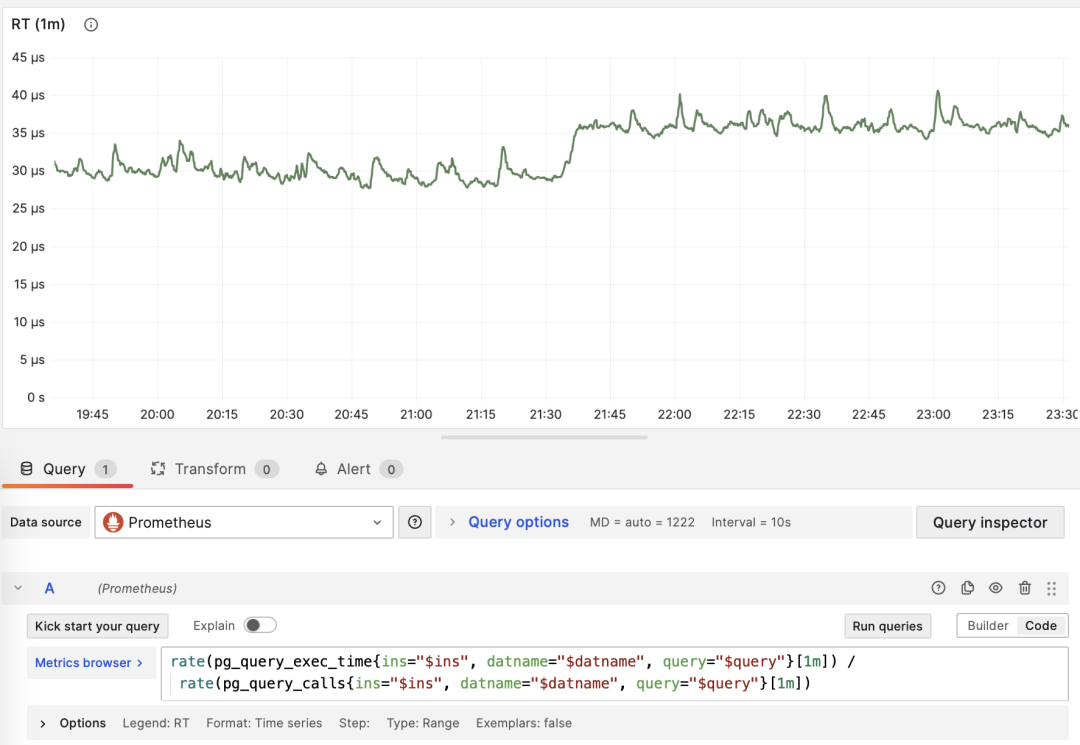
dM/dt 可以用于计算 dM/dc
调用次数
当 M 是 calls 时,对自己微分没有任何意义(结果会恒为 1)。
平均延迟/响应时间/RT
用 total_exec_time 的增量除以 calls 的增量,得到每次调用的平均服务端执行时间。PGSS 原始值算出的单位是毫秒,上面的 PromQL 示例使用秒。这是客户端响应时间的一部分;客户端计时还包含排队、网络和应用处理时间。启用计划统计后,可以另行加上计划耗时。
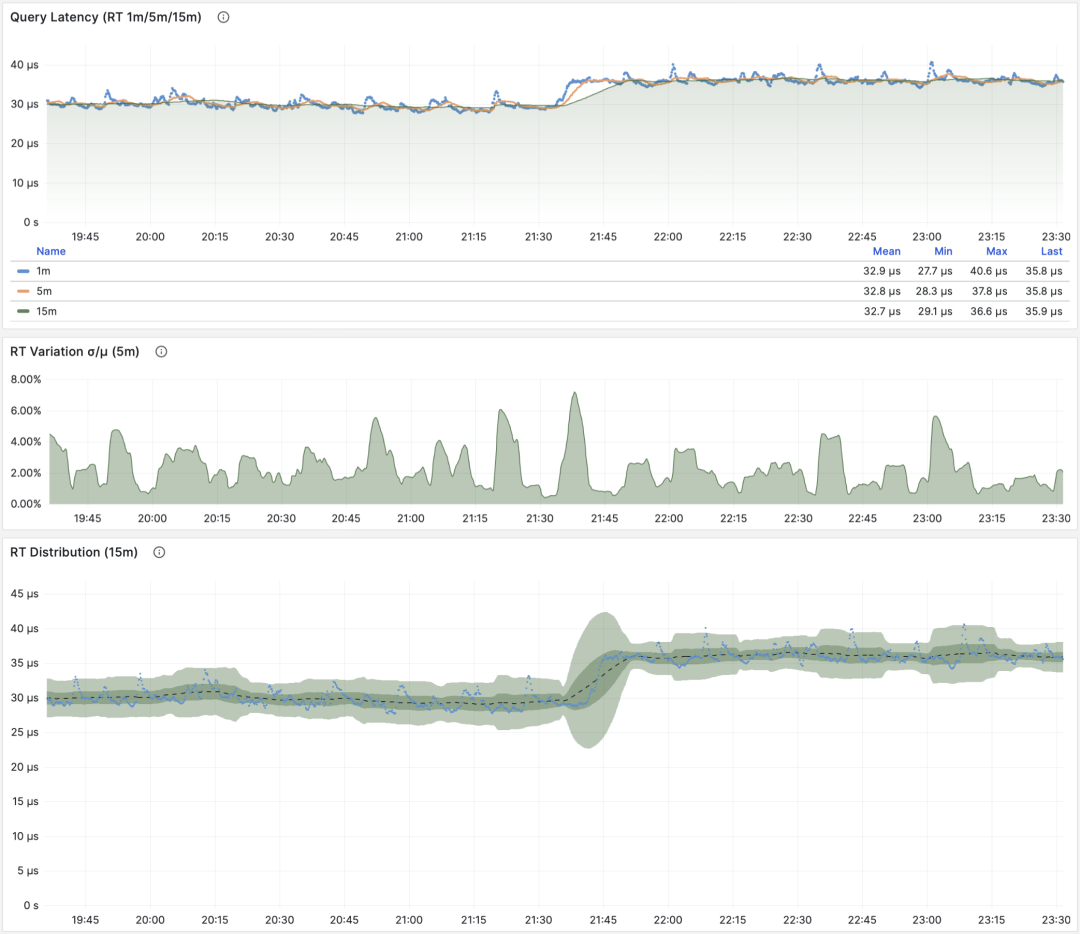
RT:1/5/15 分钟 µ/CV, ±1/3σ分布
这个均值覆盖已采集条目中的成功执行。pg_stat_statements.max 限制了 PGSS 可保留的查询组数量。比较工作负载时,需要确认采集覆盖范围。
客户端打点可以测量应用实际看到的响应时间。PgBouncer 和 PostgreSQL 14+ 还提供数据库级别的耗时汇总,PGSS 则提供查询组级别的细节。
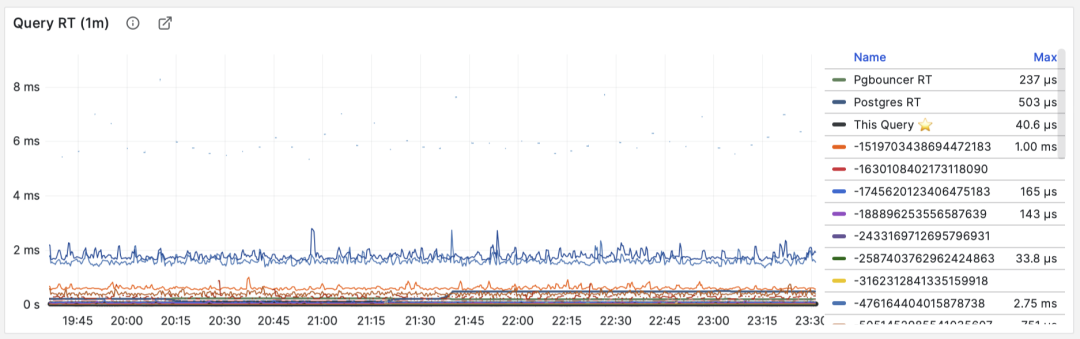
RT:语句级/连接池级/数据库级
在相近条件下比较同一查询组的 RT。如果平时均值低于 1 ms,突然升至 10 ms 以上,就值得调查。
当出现故障时, RT 视图对于定位原因也很有帮助:如果所有查询整体 RT 变慢,那么最有可能与资源不足有关。如果只是特定查询组的 RT 发生变化,那就更有可能是某些慢查询导致了问题,应当进一步调查分析。如果 RT 变化的时间点与应用发布部署吻合,则应当考虑是否要回滚这些部署。
此外,在性能分析,压力测试,基准测试时,RT 也是最重要的指标。你可以通过对比典型查询在不同环境(例如不同PG大版本、不同硬件、不同配置参数)下的延迟表现来评估系统的性能,并以此为依据不断对系统性能进行调整与改进。
对采样得到的 RT 序列计算均值和标准差,可以观察各时间窗口均值的波动。对这些均值计算分位数,得到的并不是单次查询耗时的 P95 或 P99。后者需要逐次观察值或耗时直方图。
评估 OLTP 性能时,应结合 RT、吞吐量和资源使用情况。
每次调用的平均行数
当 M 是 rows 时,得到每次调用平均检索或影响的行数。点查 SELECT 通常只返回少量结果;对于写语句,此值表示影响的行数。
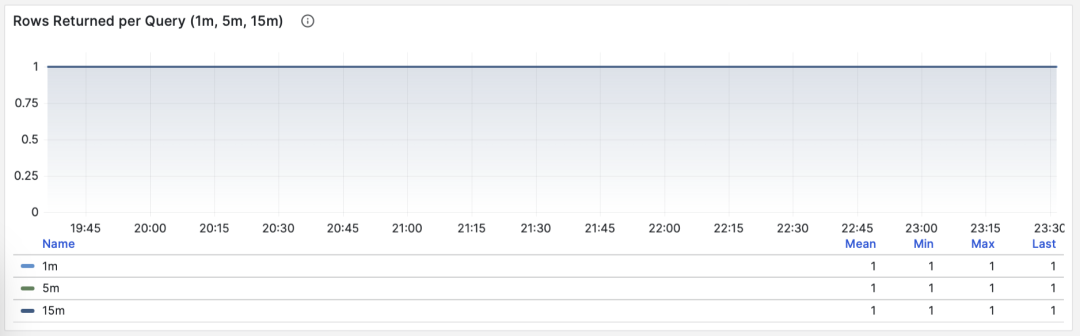
按照主键查询单条记录,平均返回行数稳定为1
如果一个查询组每次查询向客户端吐出几百甚至成千上万行记录,那么应当对其进行审视。如果这是有意而为之的设计,比如批量加载任务/数据转储,那么不需要做什么。如果这是由应用/客户端发起的请求,那么可能存在错误,比如语句缺少 LIMIT 限制,查询缺少分页设计,这样的查询应该进行调整修复。
平均共享缓冲区读取/命中
当 M 是 shared_blks_hit + shared_blks_read 时,dM/dc 表示每条查询平均访问共享缓冲区的次数。乘以块大小(通常为 8 KiB),即可得到每条查询访问的字节数,单位是 B/query。重复访问同一块会重复计数。
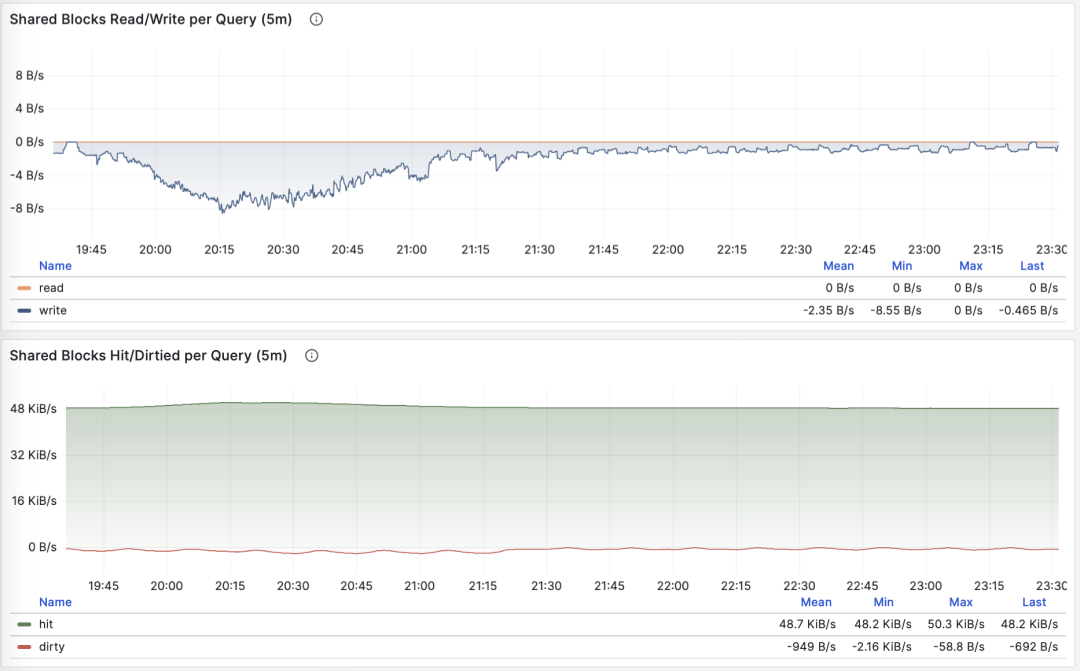
每条查询平均访问的共享缓冲区字节数
查询平均访问的数据量通常与平均返回的行数相匹配,如果你的查询平均只返回了几行,却访问了成M上G的数据块,那你就需要特别注意了:这样的查询对于数据冷热状态非常敏感,如果所有的块都在缓冲区中,它的性能可能还说的过去,但如果从磁盘冷启动,执行时间可能会出现戏剧性的变化。
PostgreSQL 缓冲区未命中时,仍可能从操作系统缓存读取。结合主机指标、pg_stat_kcache 扩展,或 PostgreSQL 16 的 pg_stat_io 视图分析实际 I/O。
另一种值得关注的模式是此指标的突变,这通常意味着该查询组的 执行计划可能出现了翻转/劣化,非常值得关注与进一步研究。
平均WAL日志量
当 M 是 wal_bytes 时,我们得到了每条查询平均生成 WAL 的大小,这是 PostgreSQL 13 新引入的字段。这个指标可以衡量查询的变更足迹大小,并计算读写比例等重要评估参数。
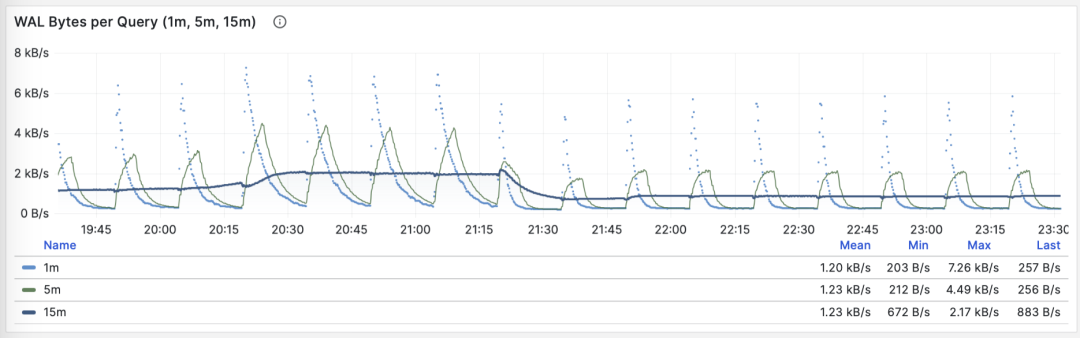
稳定的QPS却有着周期性WAL波动,可推断是 FPI 的影响
另一个用途是优化检查点/Checkpoint:如果你观察到此指标周期性的起伏(周期约等于 checkpoint_timeout),那么可以通过调整检查点间距,来优化查询产生 WAL 的数量。
dM/dc 描述一次调用的平均成本。用它评估查询修改,再检查工作负载总量,确认整体收益。
dM/dc 这样的指标为我们提供类似重要的绝对值指标,但如果想要找出哪些查询的优化潜在收益最大,还需要用到 %M 百分比指标。
百分比指标
现在我们来研究第三类指标,百分比指标。即某个查询组相对于整体工作负载所占的比例。
百分比指标 M% 为我们提供了某个查询组相对于整体工作负载的比例,帮助我们在频次、时间、I/O时间/次数上时识别出“主要参与者”,找出潜在优化收益最大的候选查询组,作为优先级评定的重要依据。
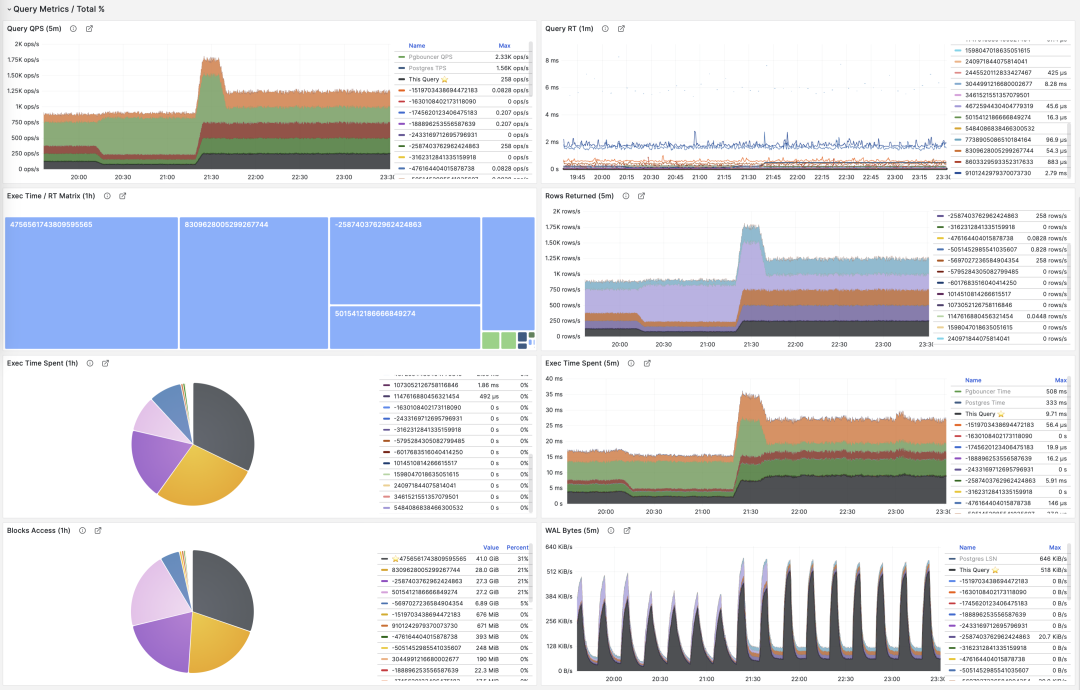
常用百分比指标 %M 一览
同样是 1000 QPS,一个查询组可能只占总调用量的 3%,也可能占 50% 以上。如果其中存在大量冗余调用,消除它们可以减少数据库工作量。对于高成本查询,还应比较它们占执行时间和 I/O 的比例。
常见的优化策略是这样的:首先把所有查询组分别按照上面提到的重要指标:calls,total_exec_time,rows,wal_bytes,shared_blks_hit + shared_blks_read,以及 blk_read_time + blk_write_time 在一段时间内的 dM/dt 值进行排序取 TopN (比如 N=10 或者更多),加入优化候选列表中。
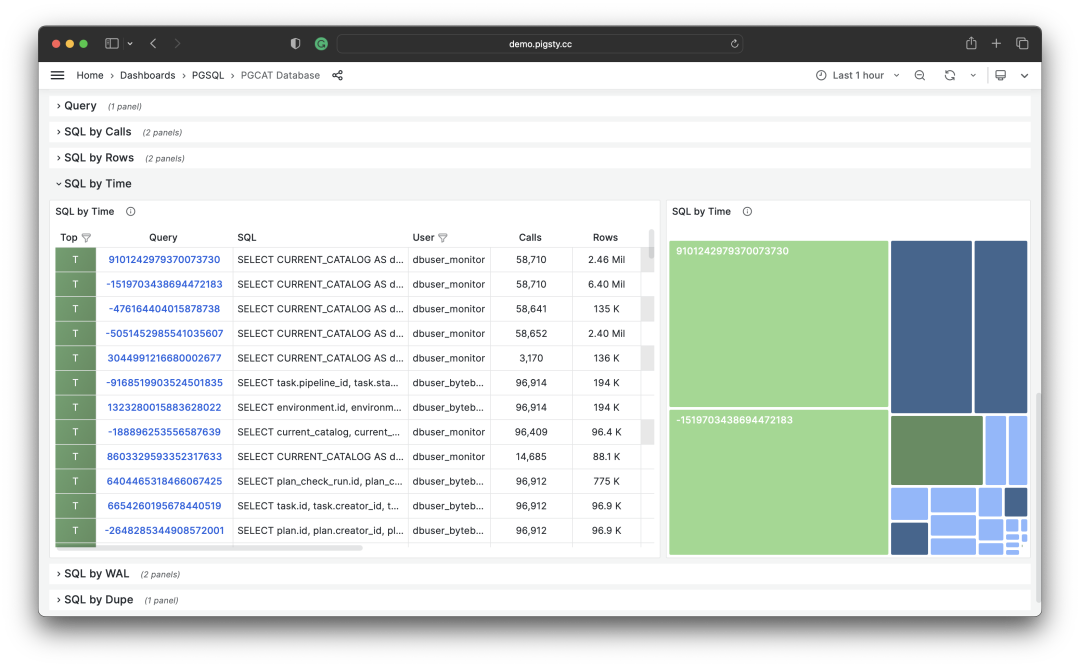
按照特定标准,选取待优化的 TopSQL
然后,对于优化候选列表中的每个查询组,依次分析其 dM/dc 指标,结合具体的查询语句与慢查询日志/等待事件进行分析,决定这是不是一个值得优化的查询。对于决定(Plan)进行优化的查询,就可以使用后续篇 “微观优化” 将要介绍的技巧进行调优(Do),并使用监控系统评估优化的效果(Check),总结分析后进入下一个 PDCA 戴明循环,持续进行管理优化。
除了对指标取 TopN 之外,还可以使用可视化的方式。可视化非常有助于从工作负载中识别 “主要贡献者”,复杂的判断算法可能还远比不上人类DBA对监控图形模式的直觉。想要形成比例感,我们可以借助饼图,树图或者堆叠的时序图。
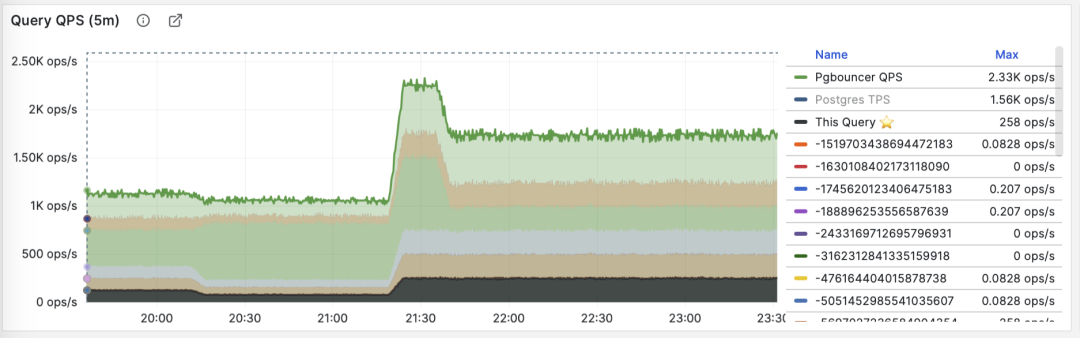
将所有查询组的 QPS 进行堆叠
例如,我们可以使用饼图来标识过去1小时内耗时/IO使用最大的查询,使用二维树图(大小代表总耗时,颜色代表平均RT)来展示一个额外的维度。并用堆叠时序图来展示比例随时间的变化关系。
我们也可以直接分析当下的 PGSS 快照,按照不同的关注点进行排序,按照您自己的标准选择有待优化的查询即可。
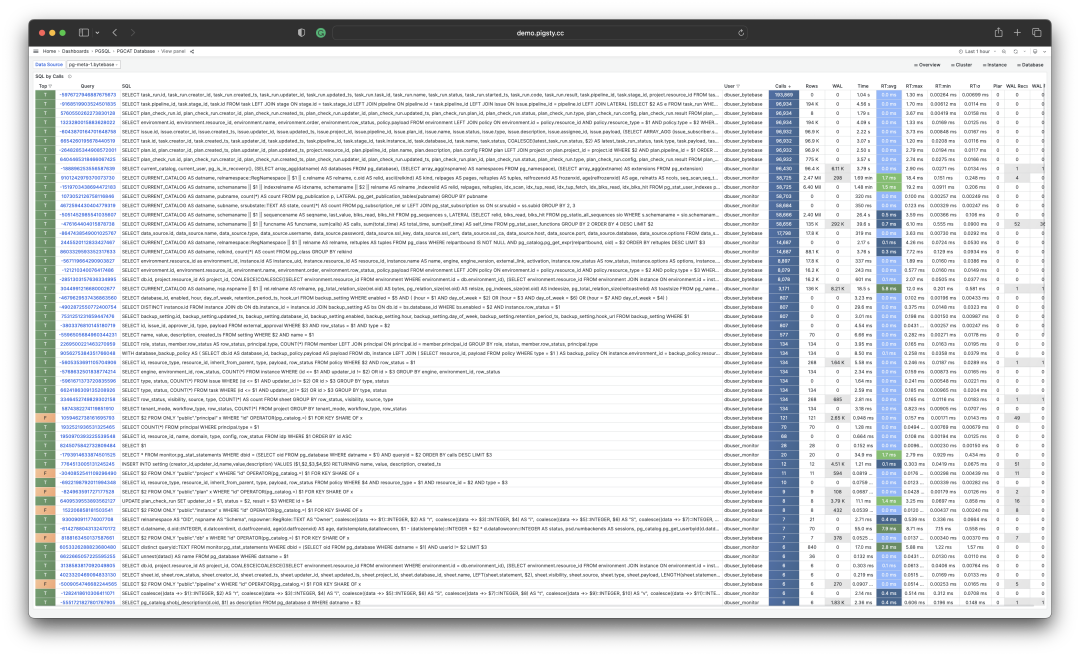
I/O 耗时对于分析查询毛刺原因很有帮助
总结
最后,让我们对上面的内容做一个总结。
PGSS提供了丰富的指标,其中最重要的累积指标可以使用三种方式进行加工处理:
dM/dt :指标 M 基于时间的微分,揭示了 每秒资源使用量,通常用于减少资源消耗的优化目标。
dM/dc:指标 M 基于调用次数的微分,揭示了 每次调用的资源使用量,通常用于改善用户体验的优化目标。
%M :百分比指标展示了查询组在整个工作负载中所占的百分比,通常用于平衡工作负载的优化目标。
通常,我们会根据 %M :百分比指标 Top 查询选择高价值的备选优化查询,并使用 dM/dt、dM/dc 指标进行进一步的评估,确认是否有优化空间和可行性,并评估优化后的效果。如此往复,不断循环。
理解了宏观优化的方法论后,我们就可以用这样的方法去定位优化慢查询了。这里给出了一个具体的 《 利用监控系统诊断PG慢查询》的例子。在下一篇中,我们将介绍关于 PostgreSQL查询 微观优化 的经验技巧。
参考
[1] PostgreSQL HowTO: pg_stat_statements by Nikolay Samokhvalov
[3] 利用监控系统诊断PG慢查询
[4] 如何用Pigsty监控现有PostgreSQL (RDS/PolarDB/自建)?
4 - 使用 Pigsty 监控现有 PostgreSQL:RDS、PolarDB 与自建数据库
本文记录 2023 年 9 月的 Pigsty 与阿里云使用流程,命令、价格和界面均对应当时版本。
Pigsty 是一个 PostgreSQL 发行版,也可以单独用于监控 PostgreSQL 与主机。本文以阿里云为例,在一台 ECS 上安装 Pigsty,再接入已有的 PolarDB 与 RDS for PostgreSQL。
操作流程
教程分为四步:
- 创建用于部署 Pigsty 的 ECS 服务器。
- 在 ECS 上完整安装单机版 Pigsty。
- 配置 PolarDB / RDS 的监控用户、模式、视图与访问名单。
- 将数据库实例接入 Pigsty 监控。
当时使用按量付费资源需要阿里云账户余额超过 ¥100,本例资源费用约为 ¥4 / 小时。
为什么增加这套监控?
云服务已经提供 RDS 监控。我在使用时,还需要更多指标来分析慢查询、诊断故障和评估容量,因此增加了这套监控。
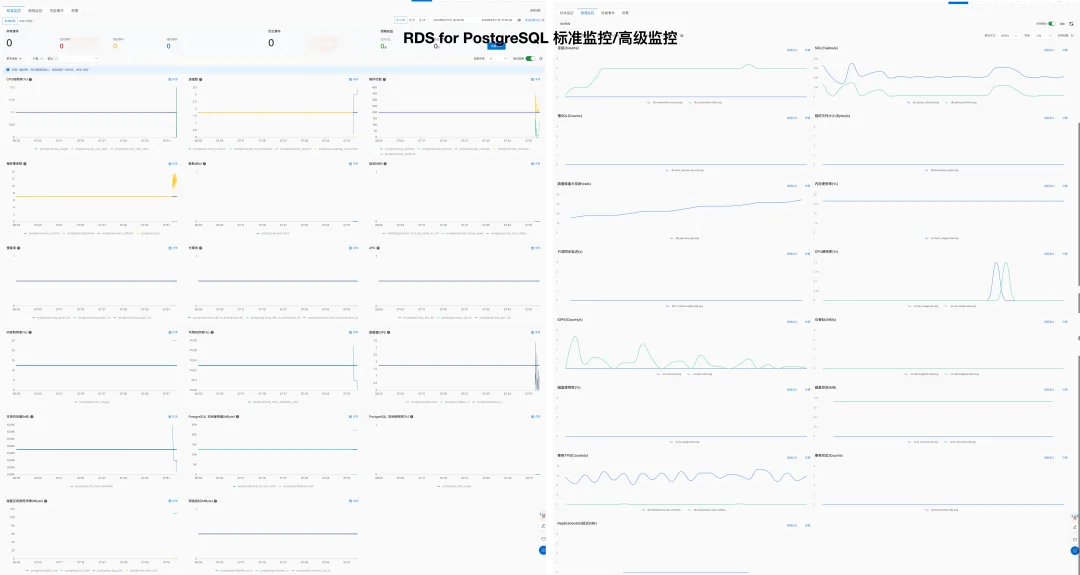
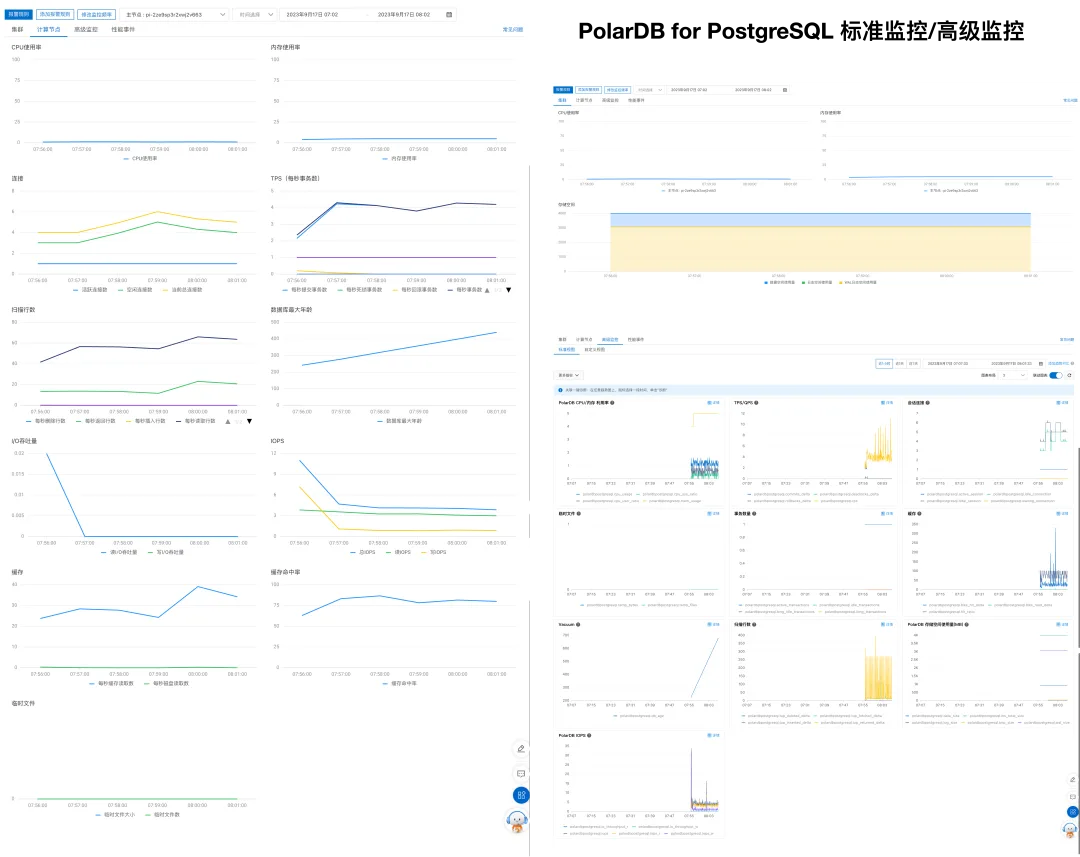
Pigsty 使用 Grafana 与 Prometheus,并将它们打包为可统一安装的 INFRA 模块。Pigsty 管理的主机、HAProxy、PostgreSQL、PgBouncer、etcd、Redis、MinIO,以及监控基础设施本身,都会纳入监控。预置面板和告警规则用于查看运行状态与排查问题。
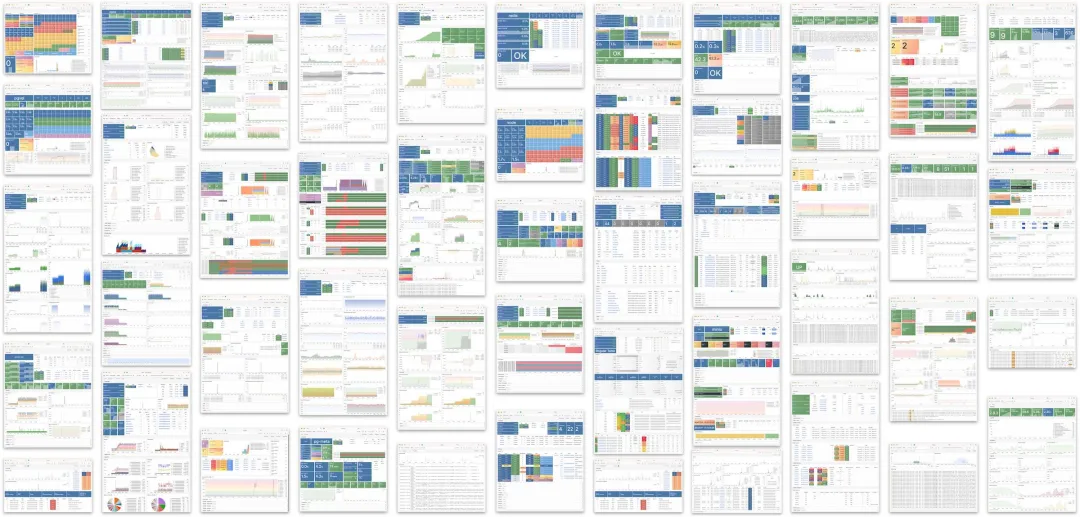
当时的完整系统使用三千多类指标,覆盖数据库与配套组件。面板按集群、实例和对象组织数据,可以查看表、索引、函数的活动,也可以汇总到集群层面。页面链接用于切换视图,时间范围选择器用于比较当前状态与历史趋势。
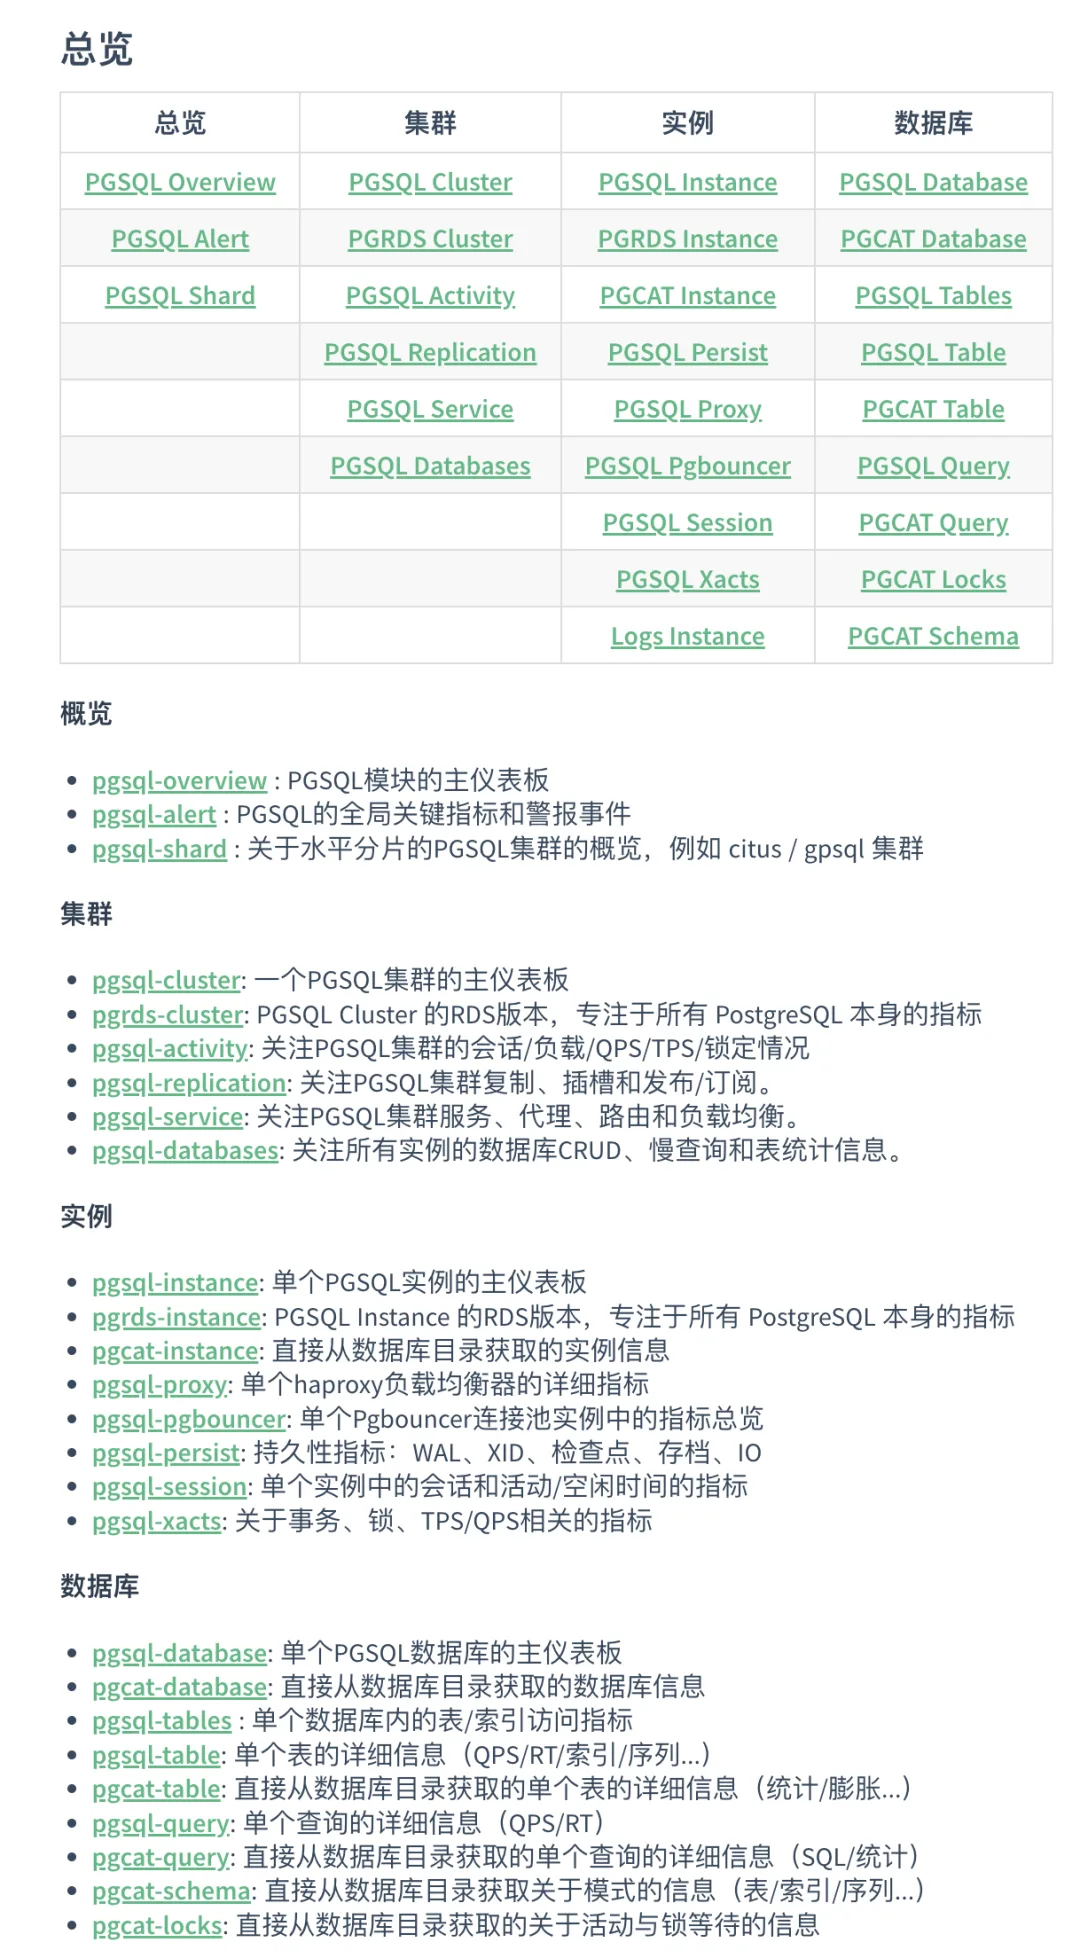
监控现有 PostgreSQL,特别是托管云数据库时,可获得的数据取决于服务提供的访问接口。这种接入方式通常没有主机、高可用组件、连接池和原生数据库日志数据,主要使用 PostgreSQL 自身的指标。
可以通过公开演示查看监控界面。
创建 ECS 服务器
本例使用 x86_64 ECS,操作系统范围为 EL 7–9,当时推荐 Rocky Linux 8.6 或 9.1,最低配置为 1 核 CPU、2 GB 内存。可以在云控制台创建,也可以使用 Pigsty 提供的 Terraform 模板。
演示模板使用内网地址 10.10.10.10 和示例密码 PigstyDemo4,并分配一个公网 IP。
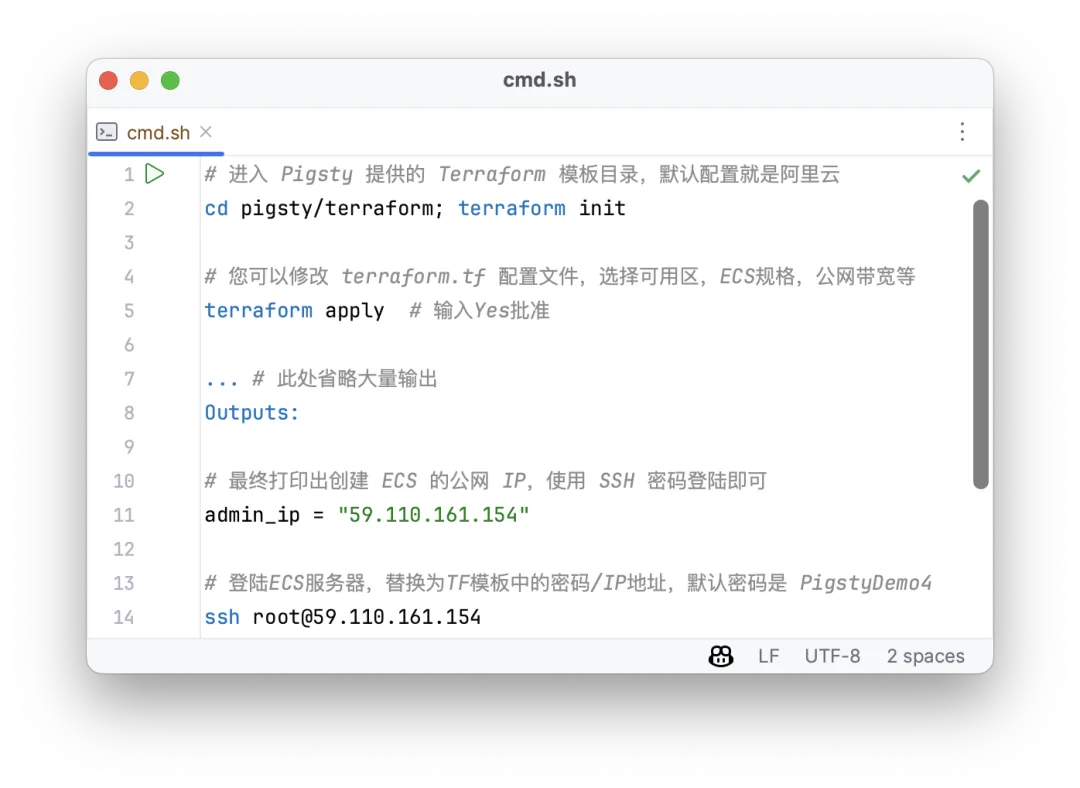
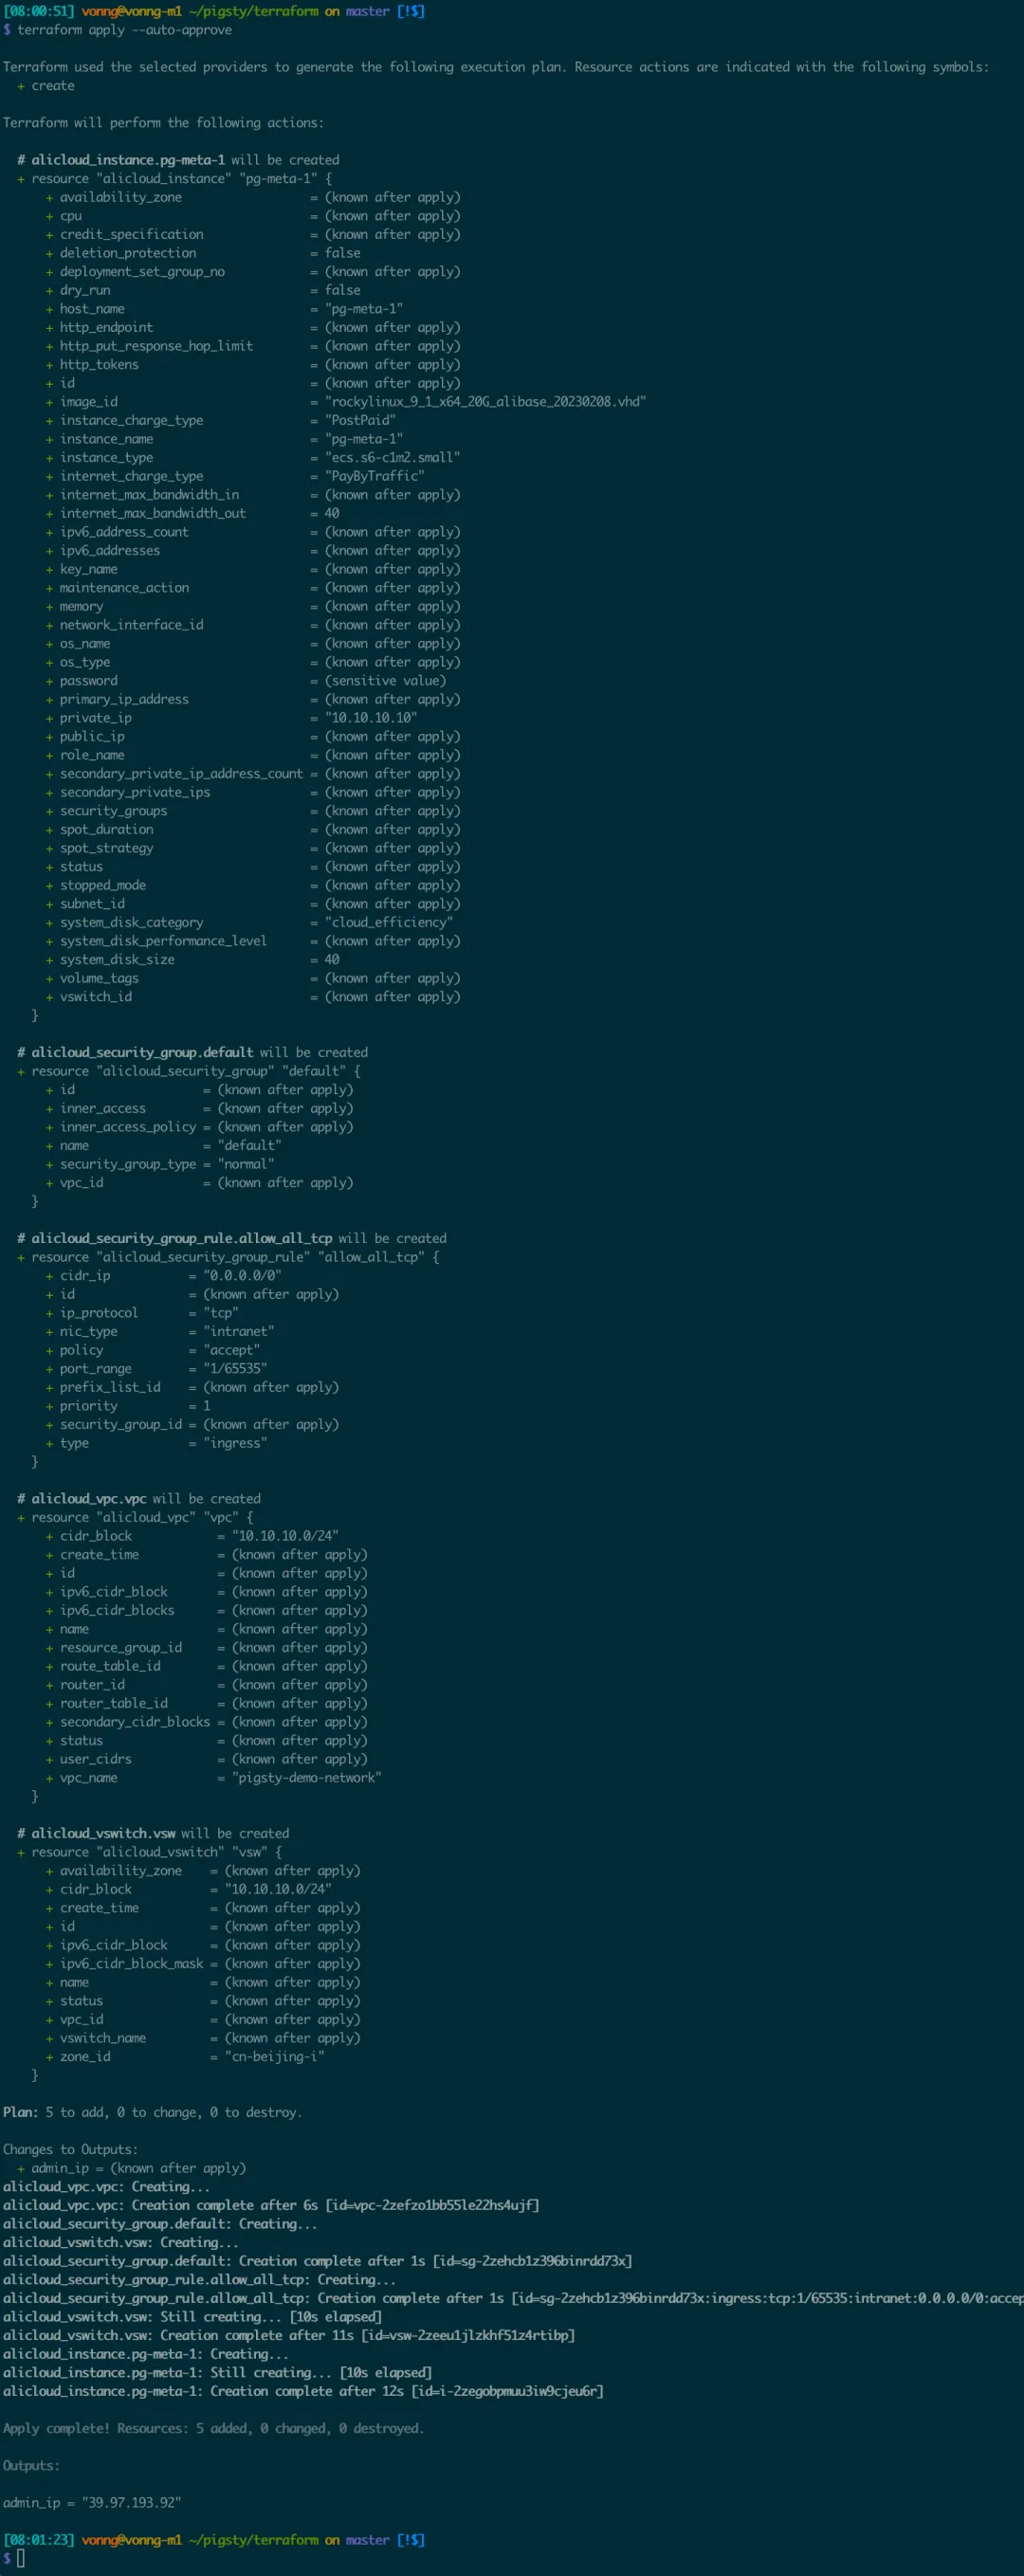
在 ECS 上安装单机版 Pigsty
登录 ECS 后,当时的安装流程如下:
使用离线包时,本例完整安装耗时约十分钟。当前流程见 Pigsty 安装指南。
安装后,通过 ECS 公网地址的 3000 端口访问 Grafana。面板中已经包含新环境自身的监控数据。本例使用默认账号 admin / pigsty。
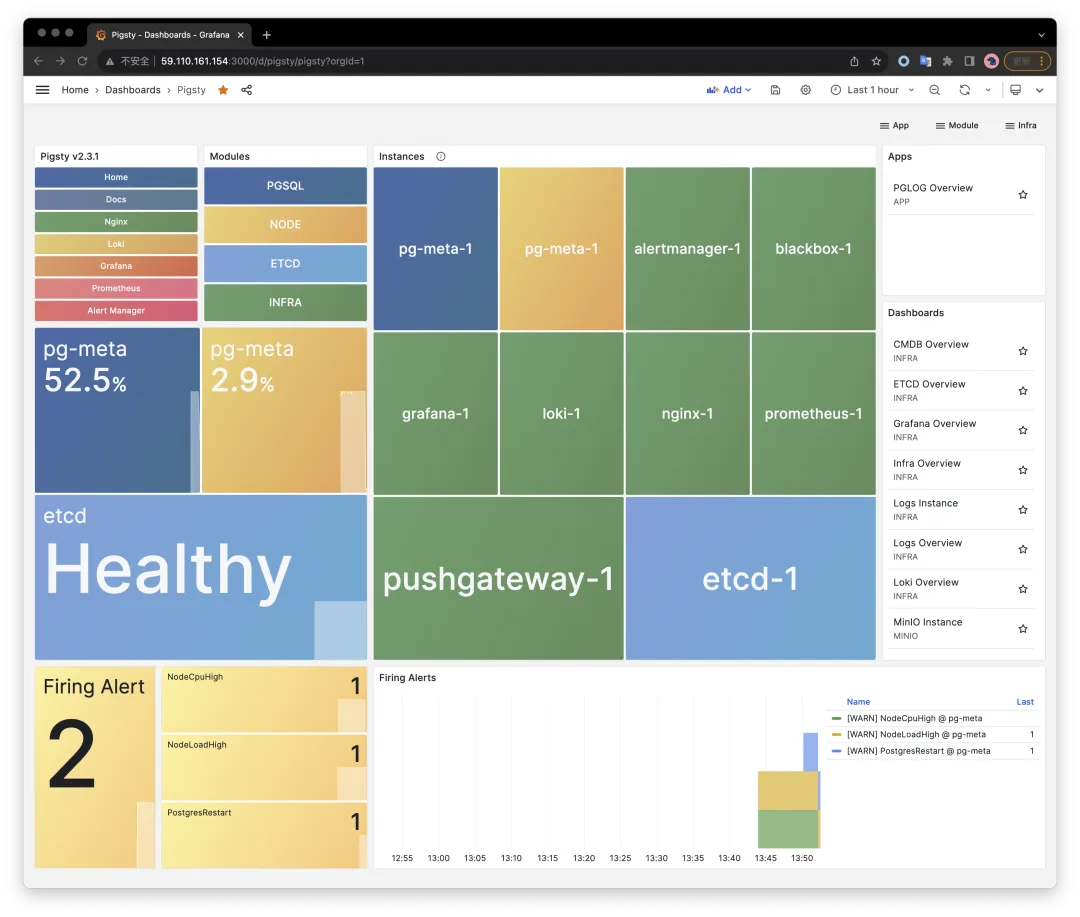
使用域名和 HTTPS 访问 Web 界面。更换示例密码,并限制监控系统的访问来源。
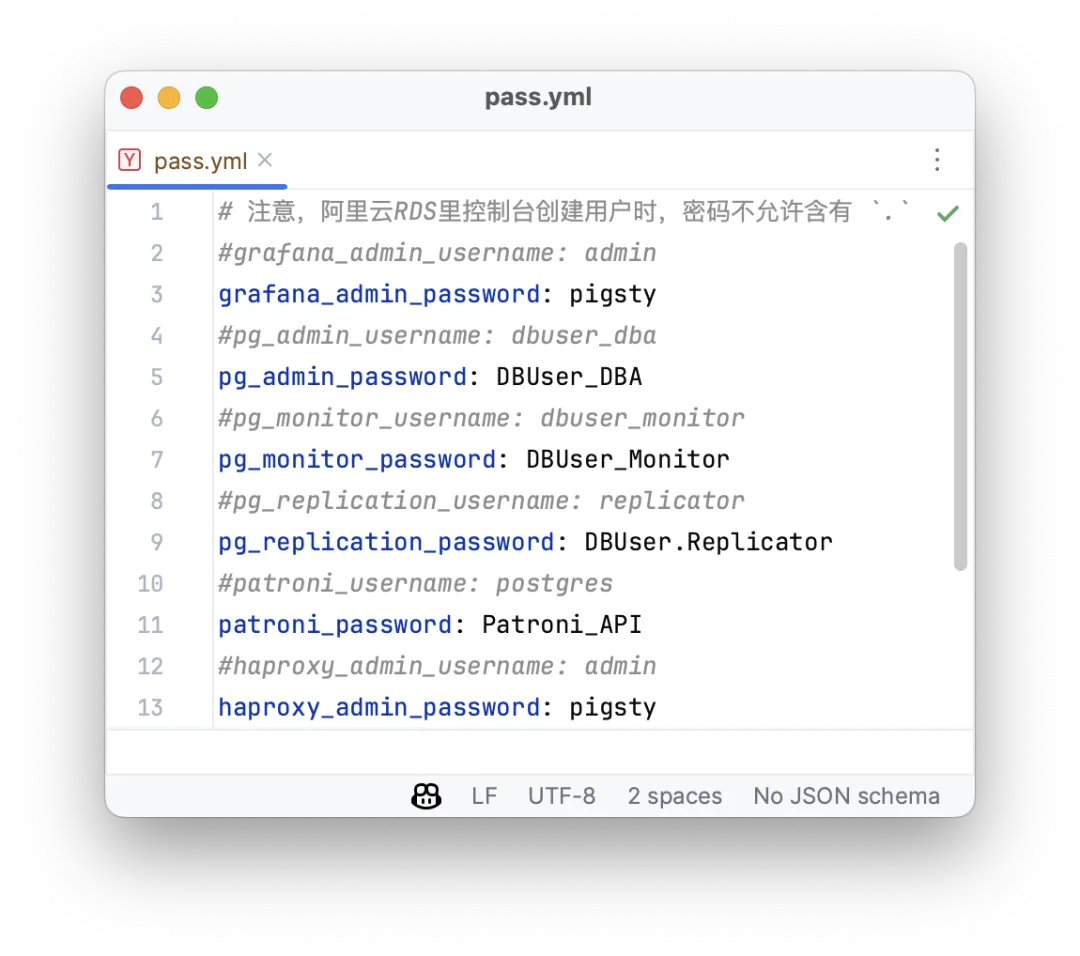
配置 PolarDB / RDS 监控
Exporter 需要一个从 ECS 可访问的数据库连接地址、具有所需读取权限的监控账号,以及所选采集器使用的扩展。
本例的 PolarDB 配置步骤是:
- 创建 ECS 可以访问的集群。本例使用同一可用区和子网。
- 创建管理账号
dbuser_dba,用于初始配置。 - 将 ECS 内网地址
10.10.10.10加入集群访问名单。 - 创建数据库,本例名为
test。
用管理账号连接数据库,将示例主机名替换为实际集群地址,并按提示输入密码:
用此账号创建专用监控用户,也可以通过云控制台创建。
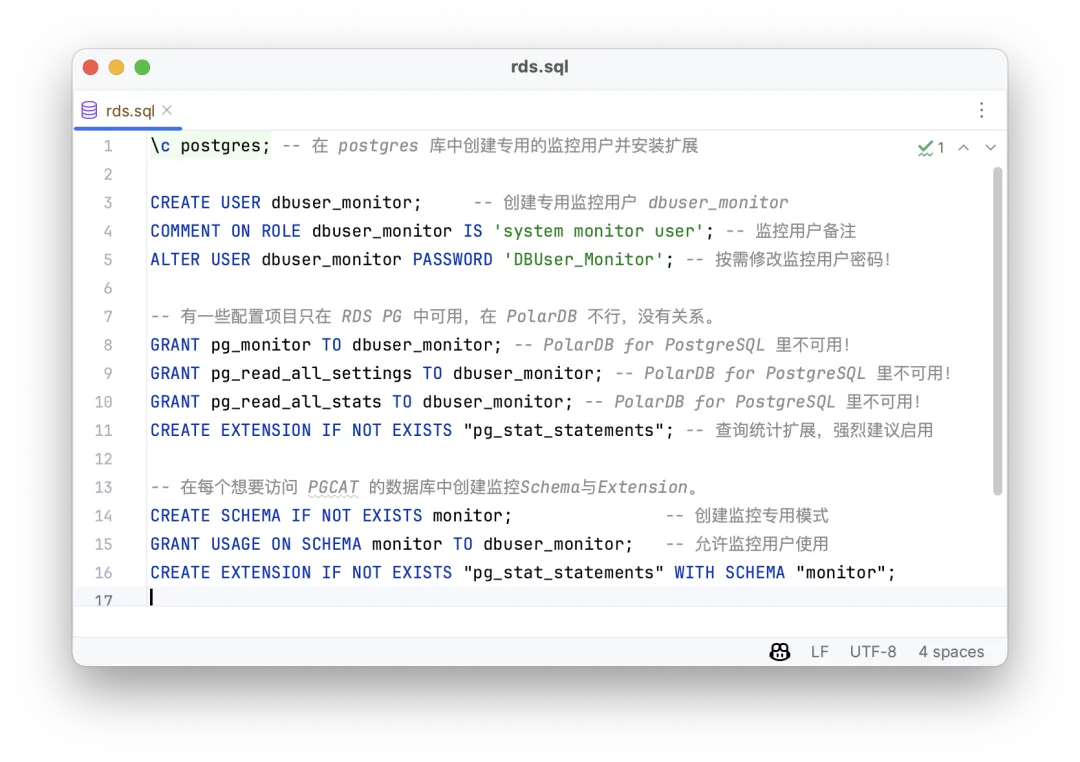
安装 pg_stat_statements,获取查询调用次数与执行耗时等语句级统计。
将现有数据库接入监控
在 pigsty.yml 中填写数据库实例的身份与连接信息。当时的配置位置是 all.children.infra.vars.pg_exporters:字典的键为唯一分配的本地 Exporter 端口,值为目标实例的配置。
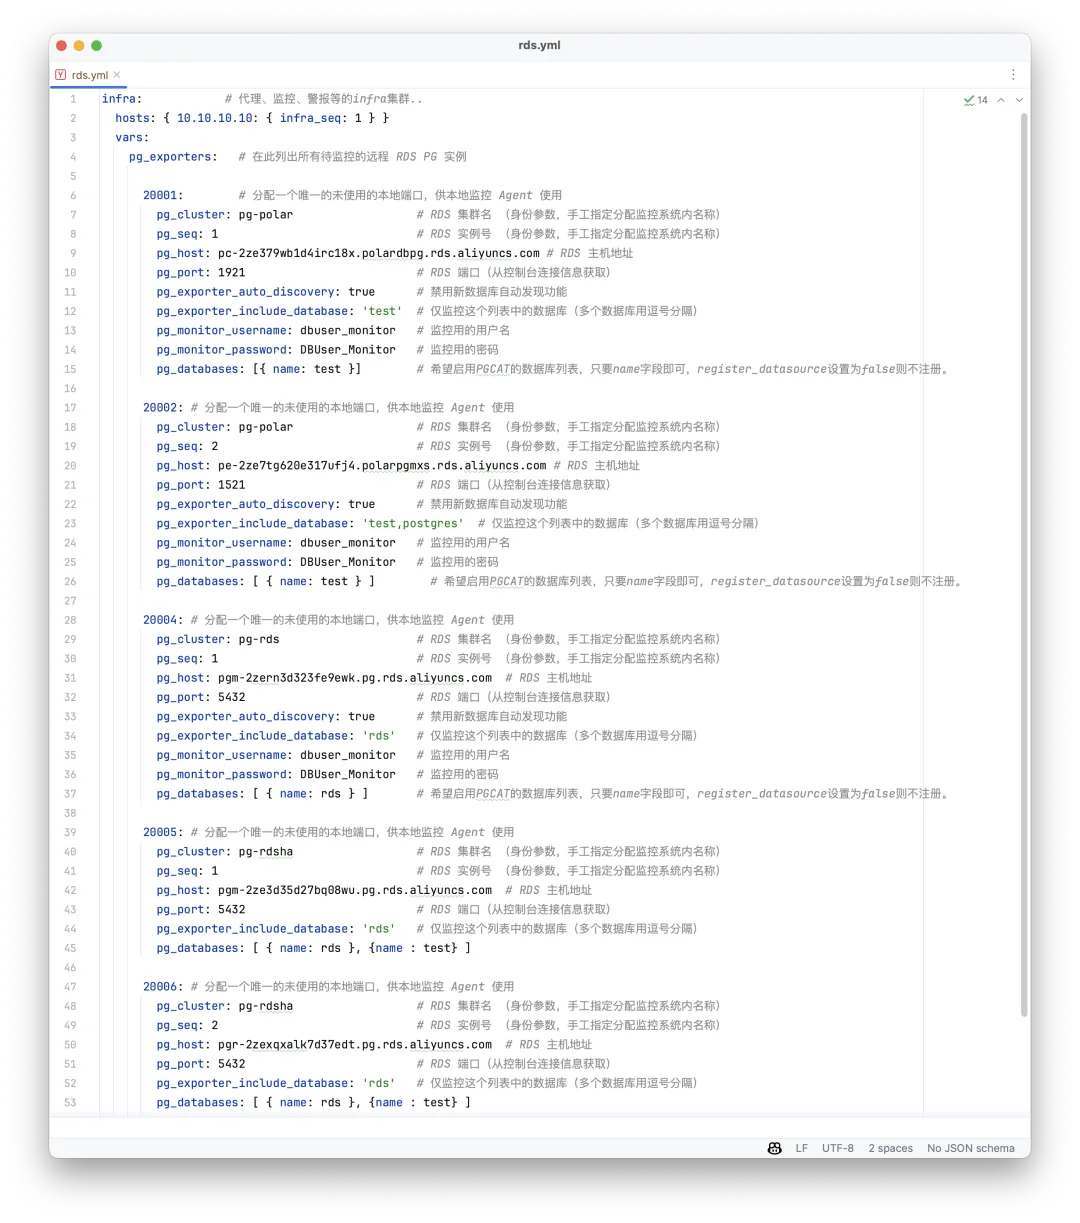
本例接入三个集群:
pg-polar:一主一从的 PolarDB 集群。pg-rds:基础版单节点 RDS for PostgreSQL 实例。pg-rdsha:带有一个只读节点的高可用 RDS 集群。
上图展示了配置。通常需要修改 pg_cluster、pg_seq 与 pg_host;端口不是 5432 时,还需要设置 pg_port。其他参数按需覆盖。
定义目标后,将各集群加入监控:
随后可以在 Pigsty 中看到这三个集群。
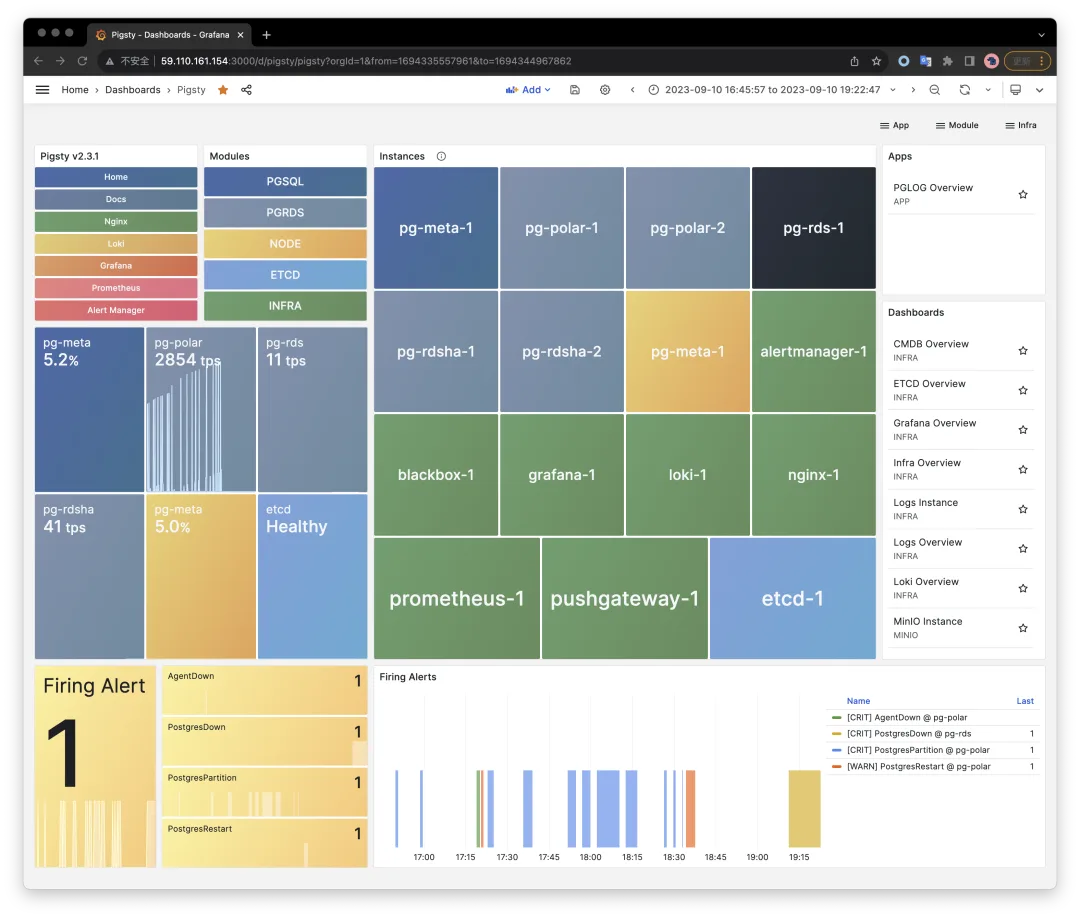
点击浅蓝色的集群名或实例名,打开对应的 PGRDS 面板。
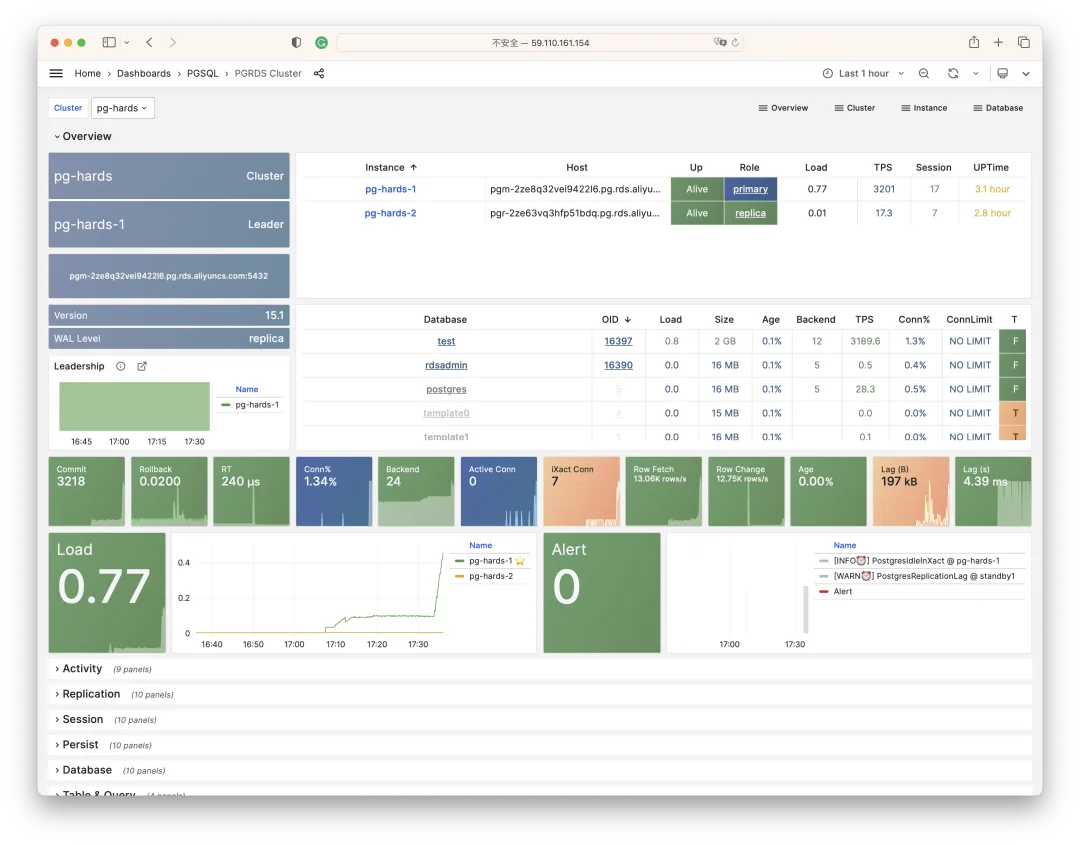
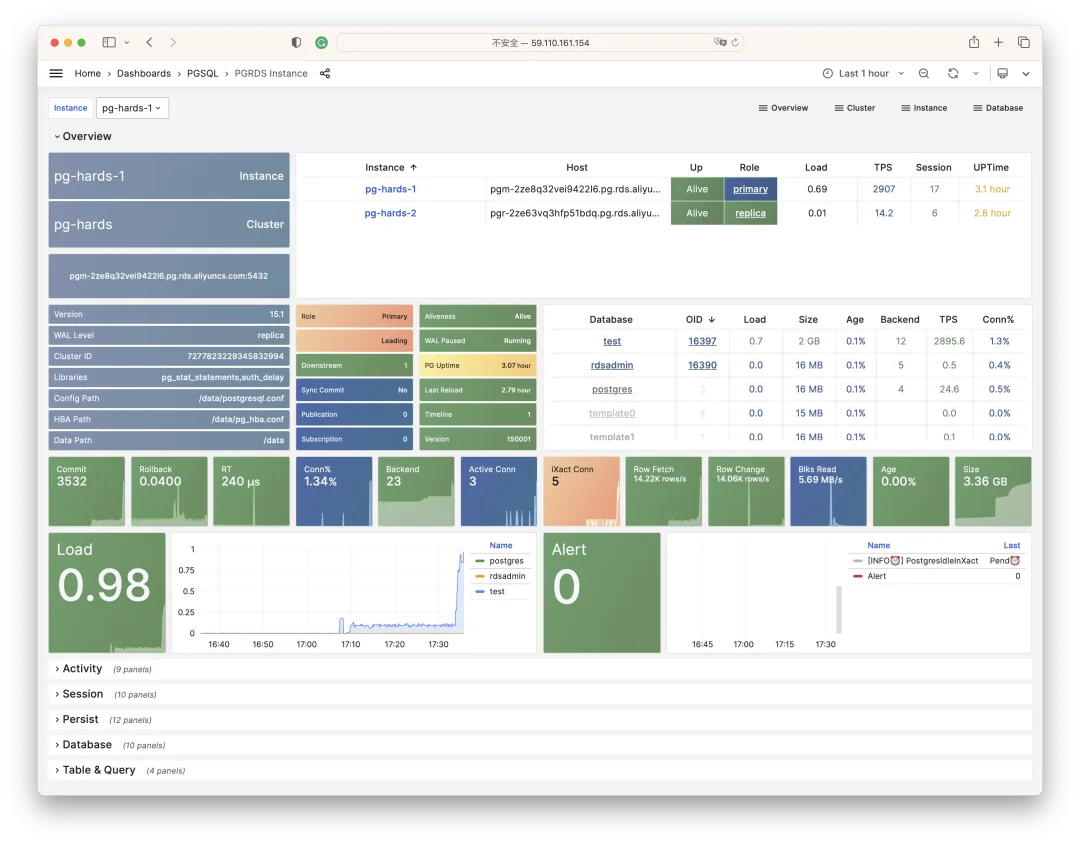
首屏显示集群成员、存活状态、数据库列表与导航,以及 13 个核心指标。点击面板可以查看详情。
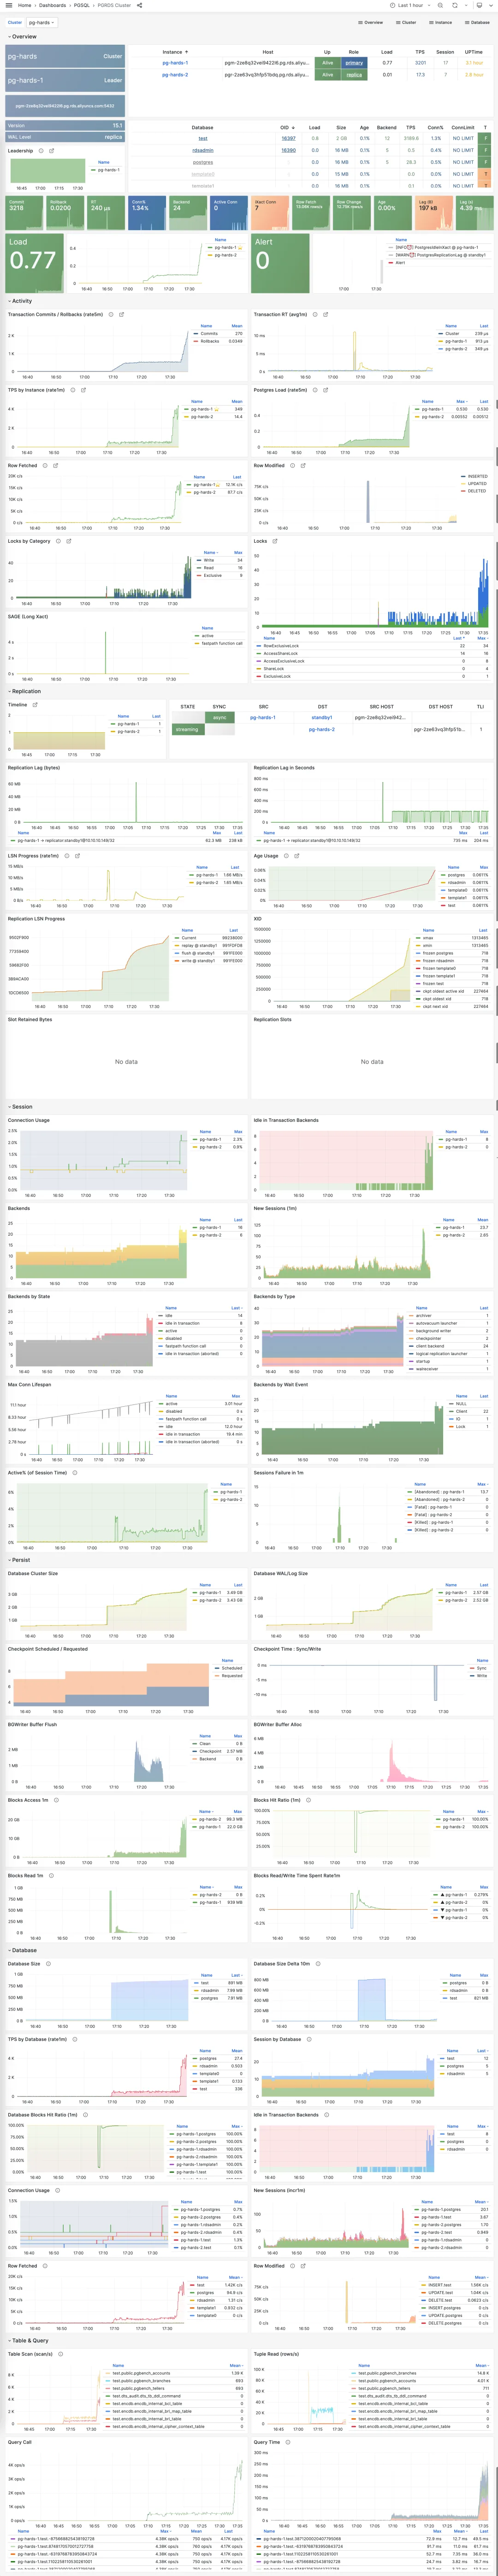
通过图表中的链接,可以在 PGRDS Cluster 与 PGRDS Instance 之间切换,查看集群汇总或单个实例。
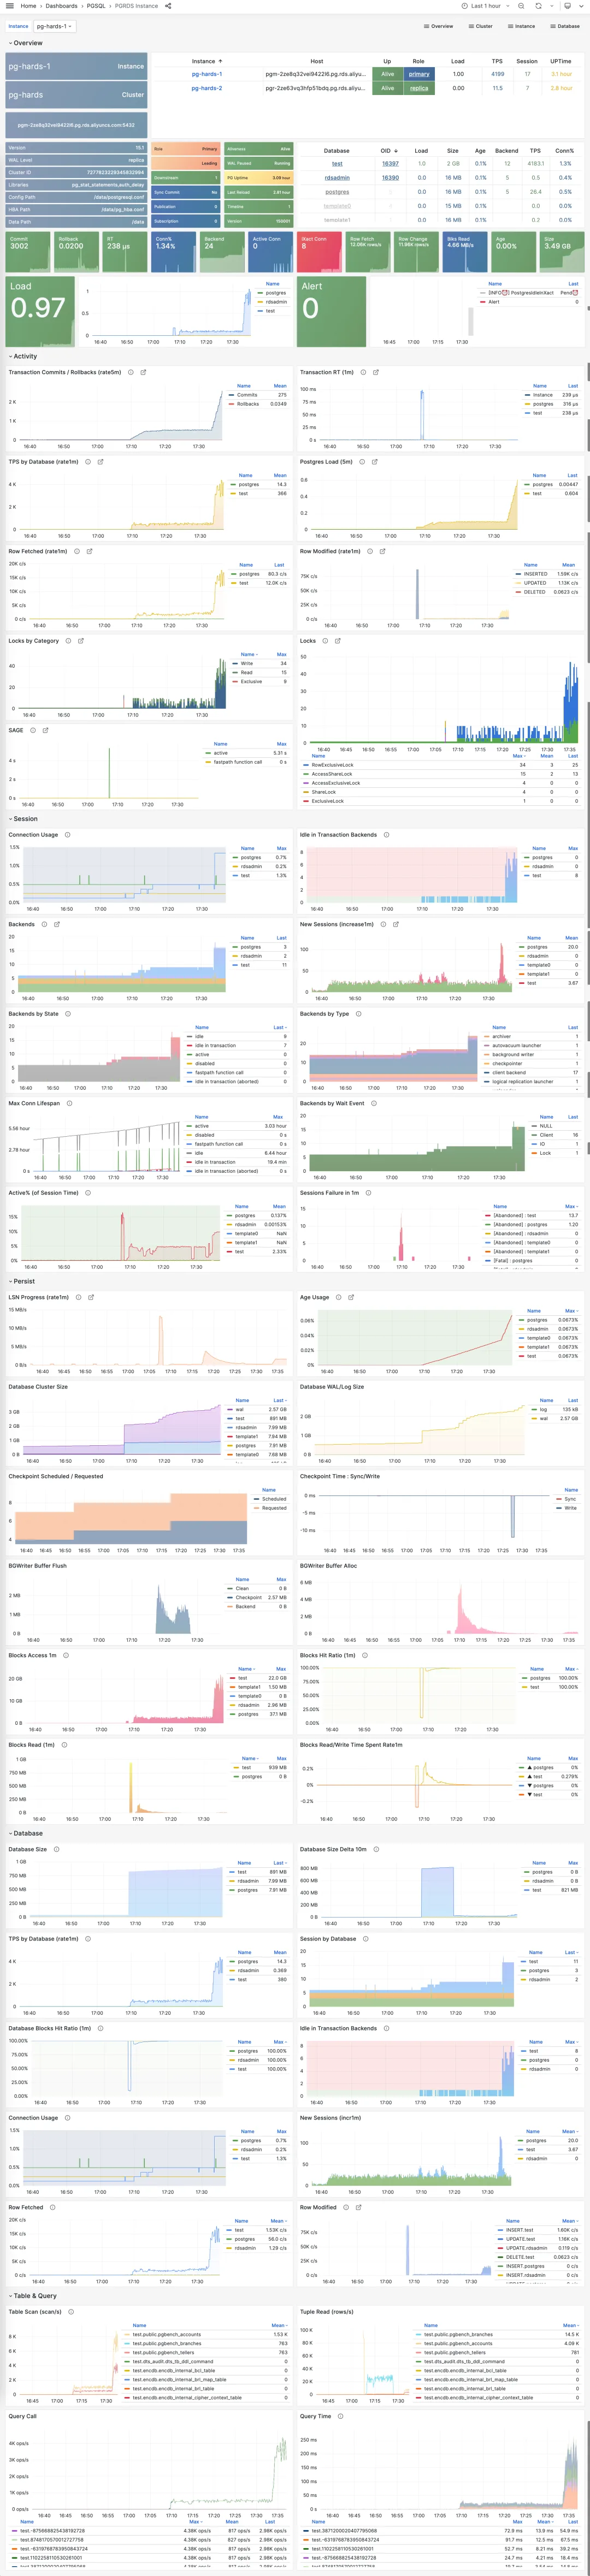
Overview 与 Database 面板也可用于这些实例,展示各类查询的 QPS、响应时间,以及每张表的读写活动。
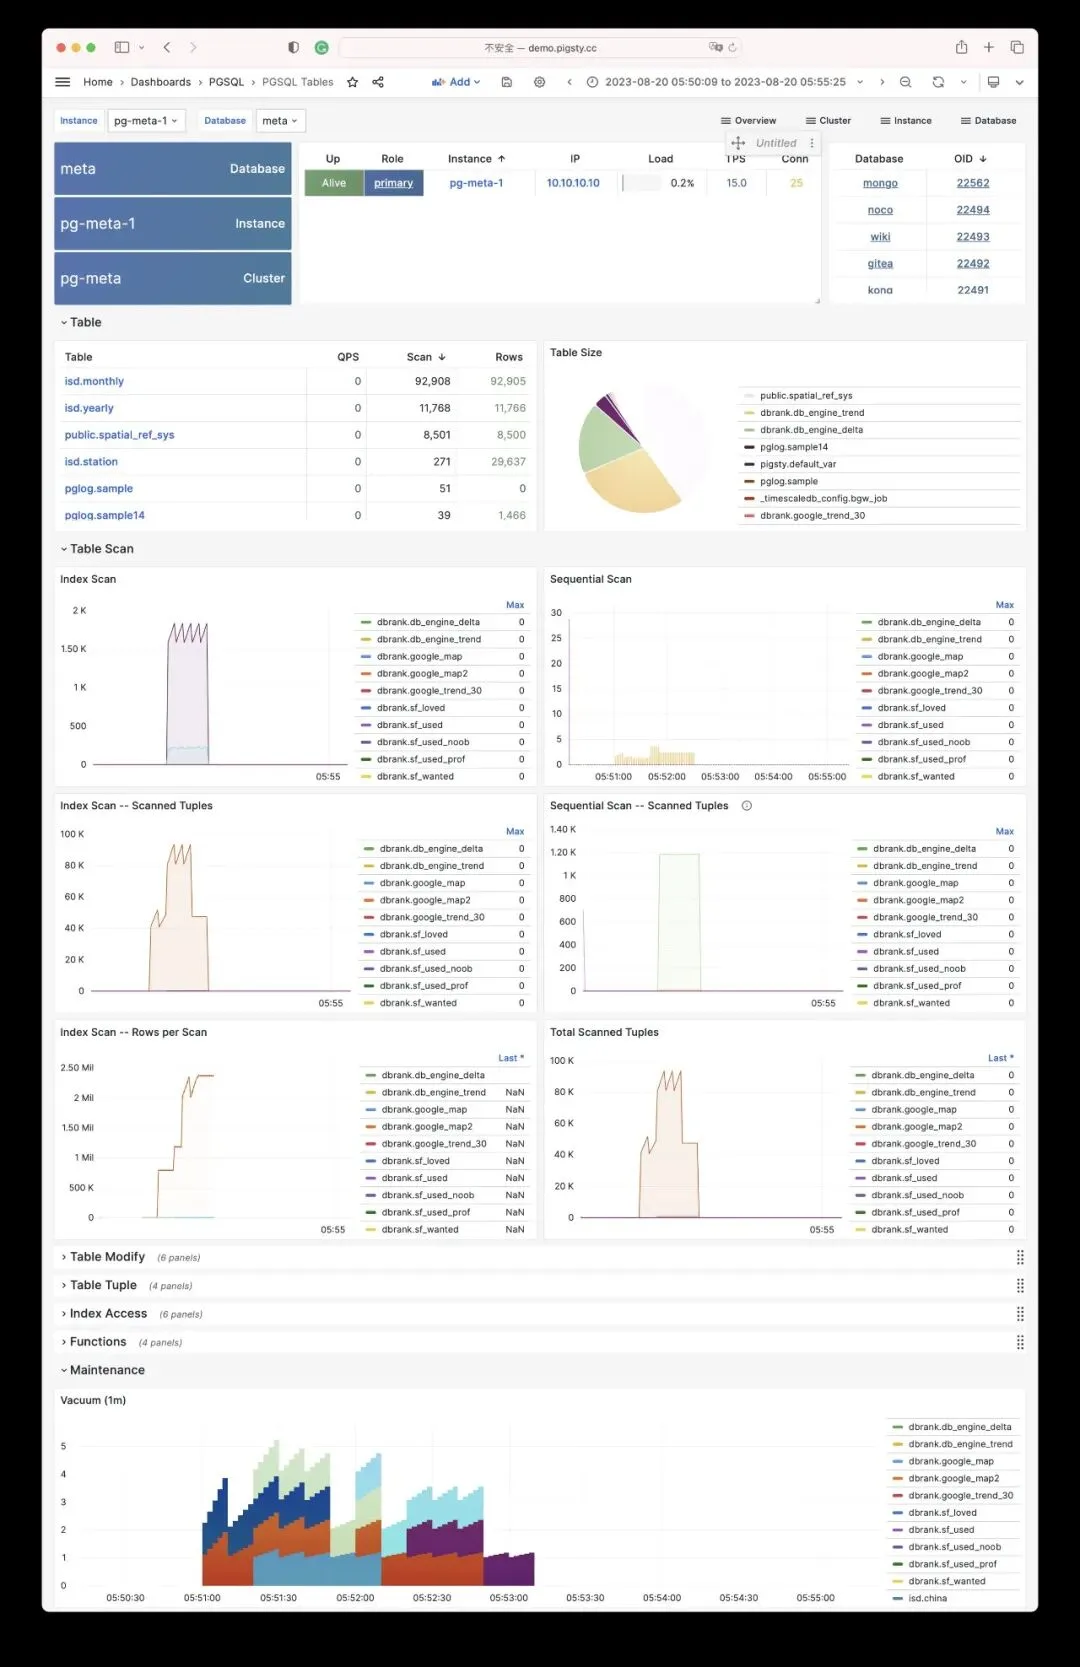
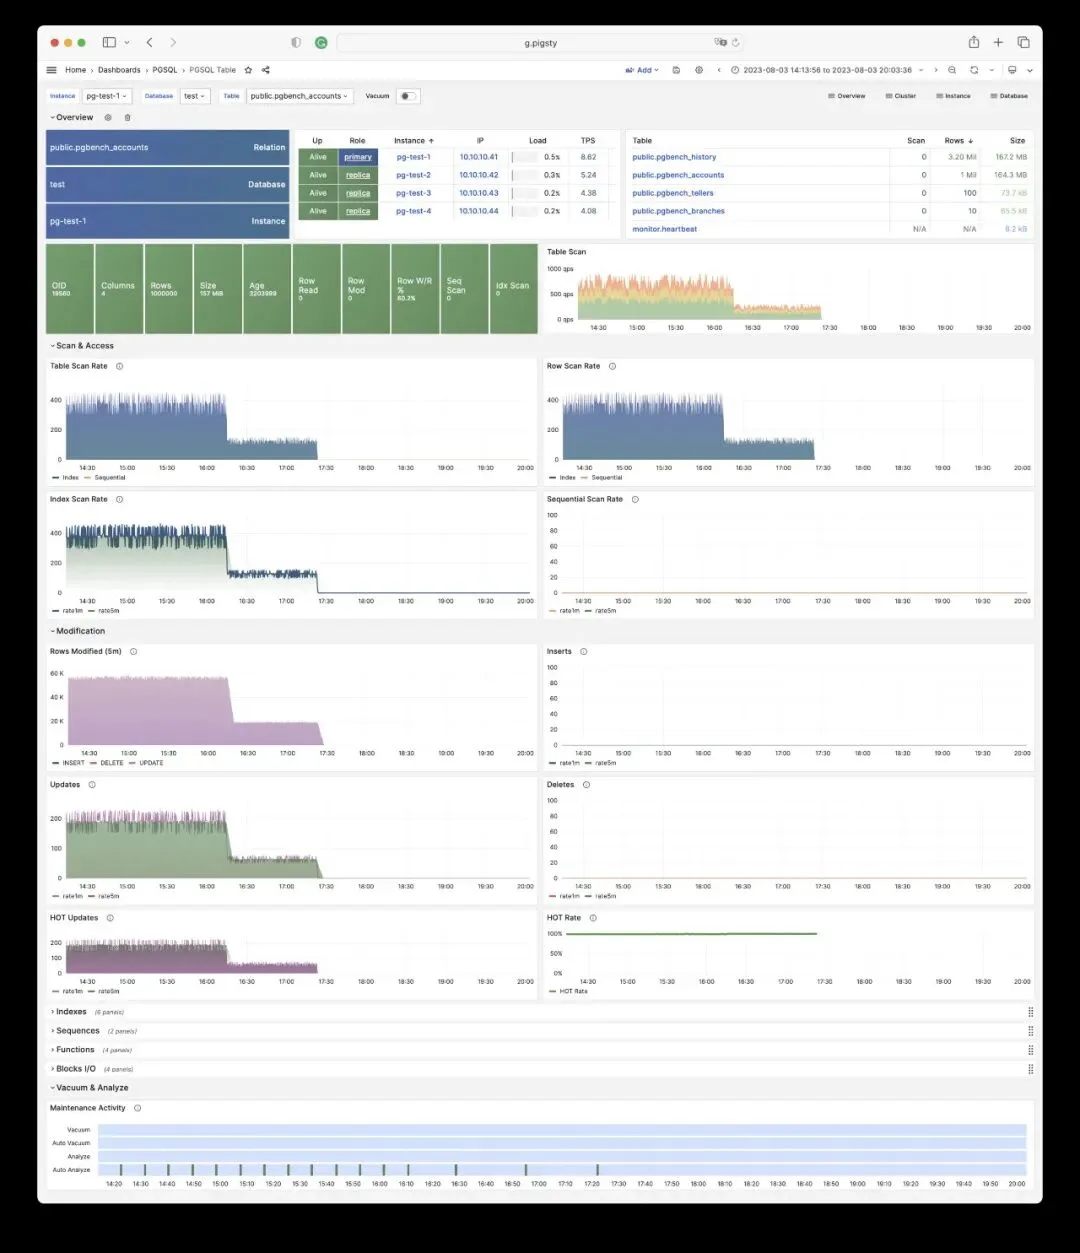
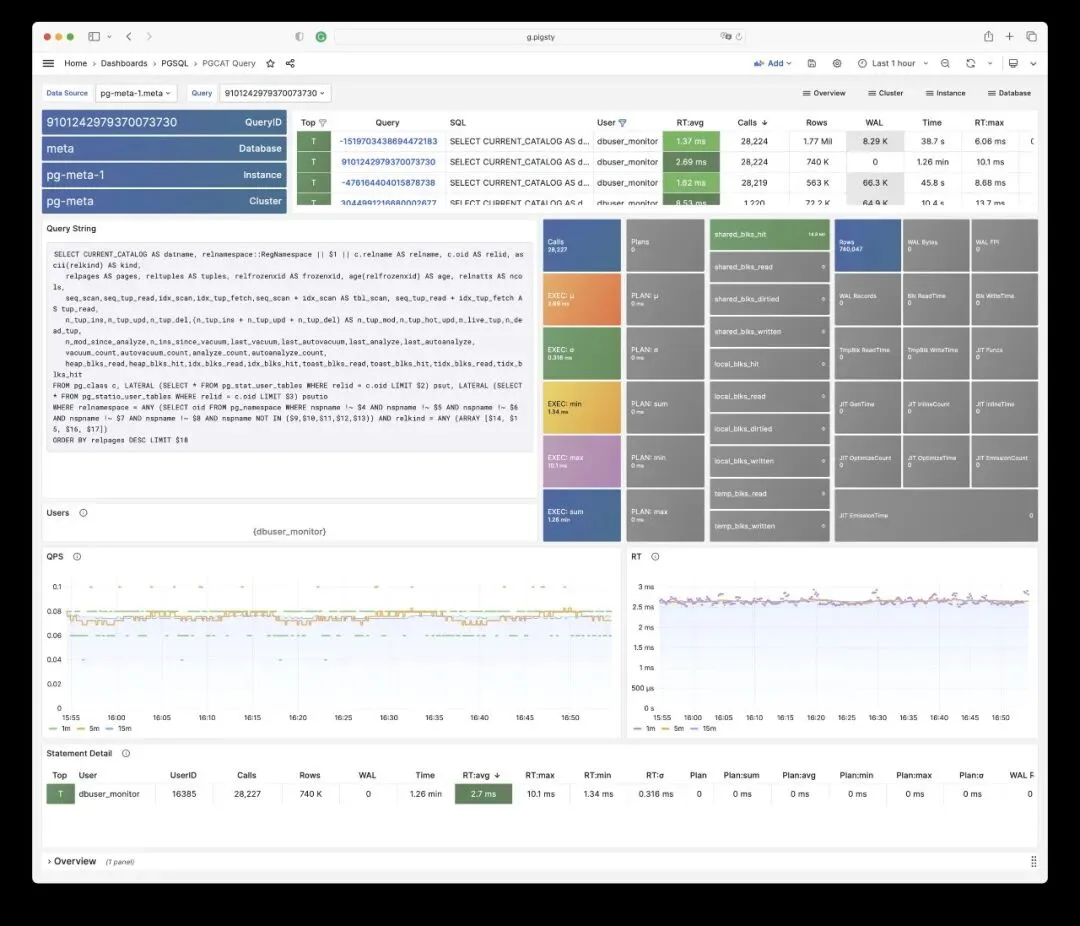
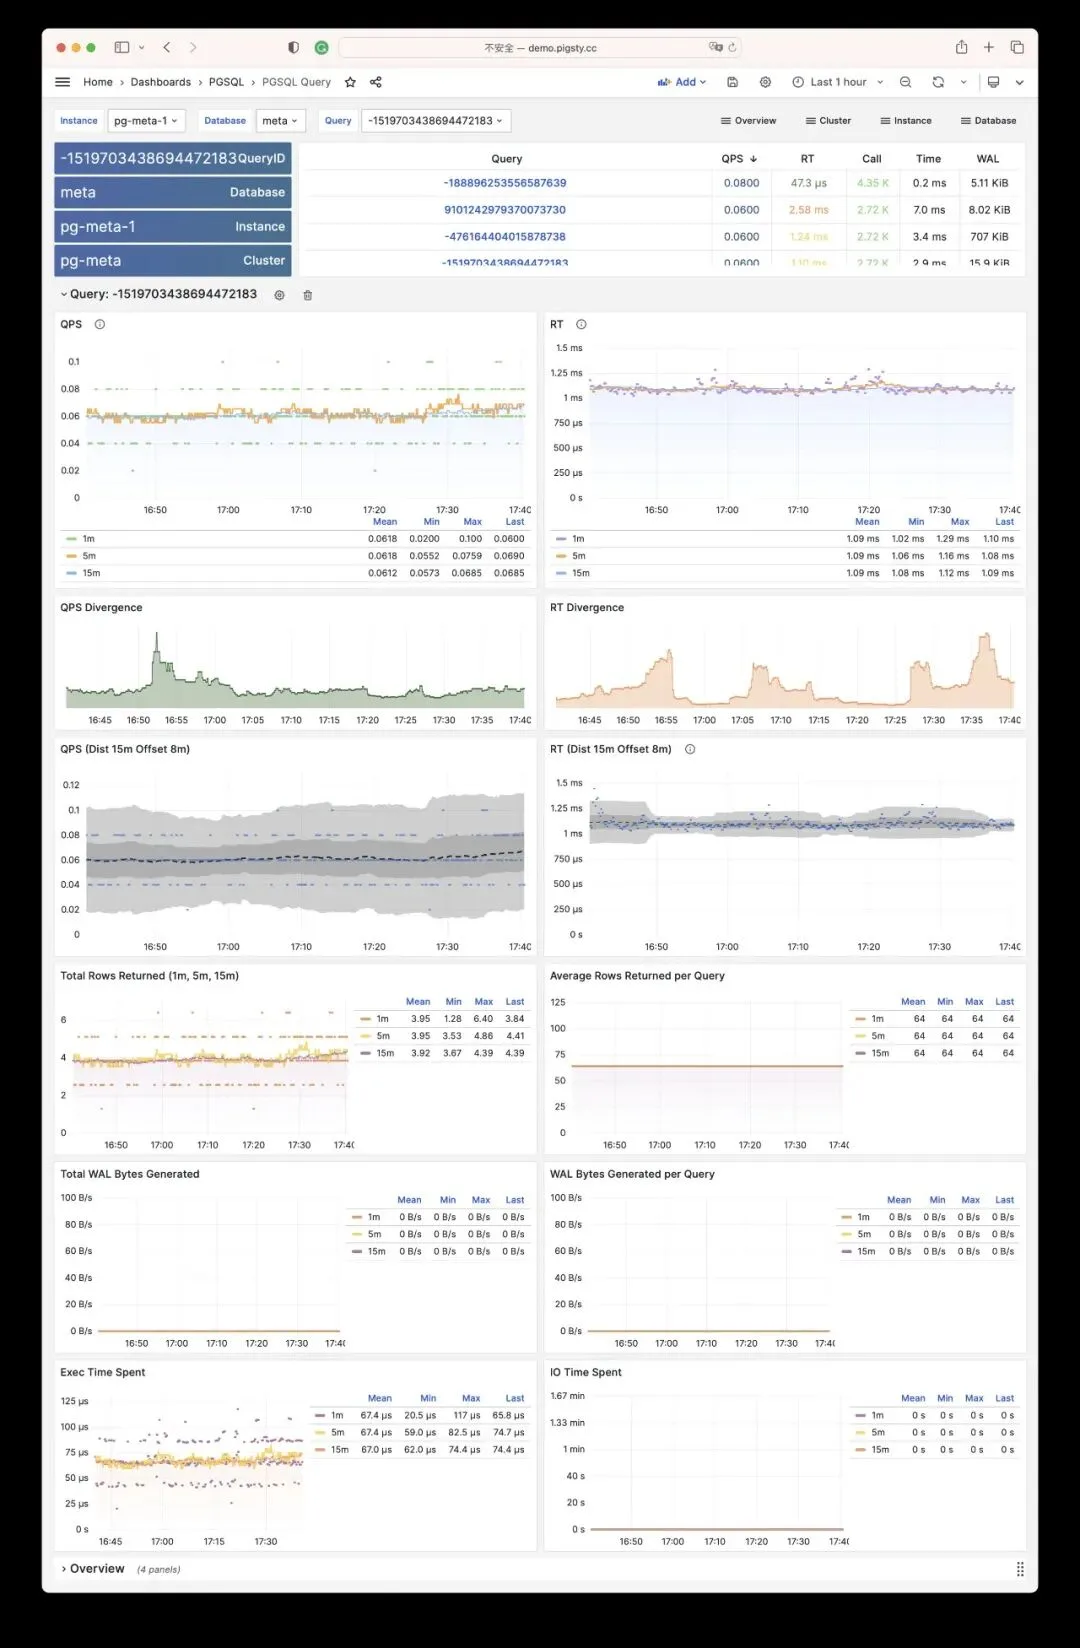
配置可选的数据库数据源后,还可以直接查询系统目录,查看当前锁等待与 Top SQL。
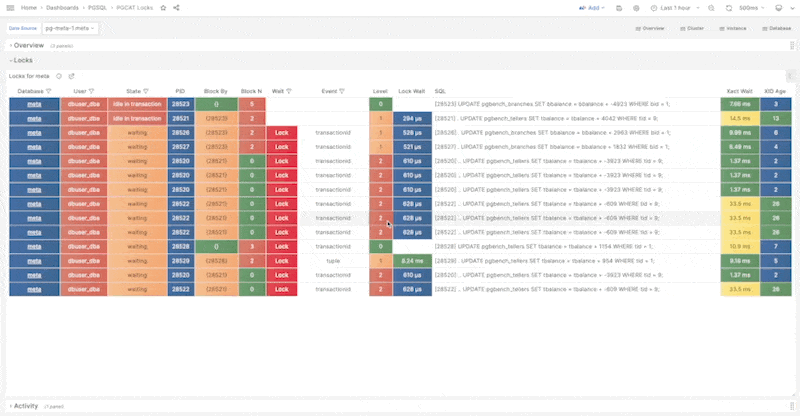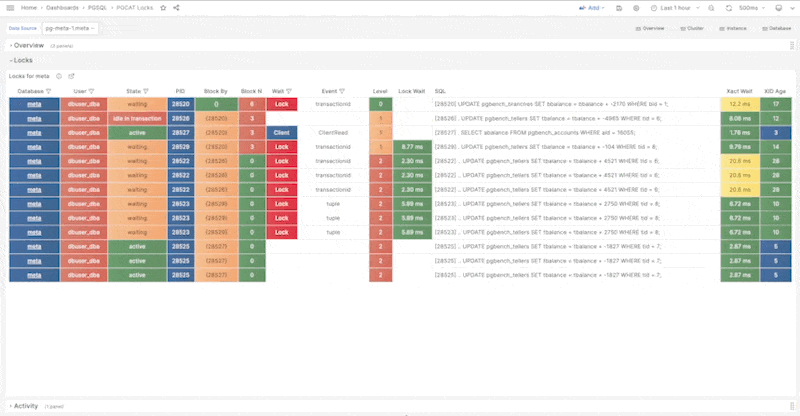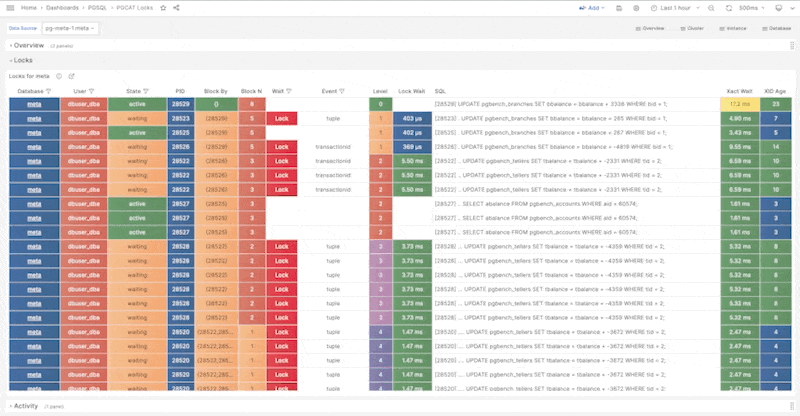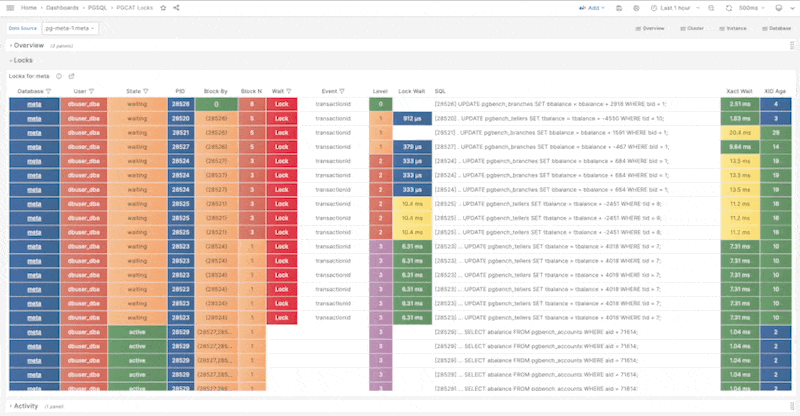
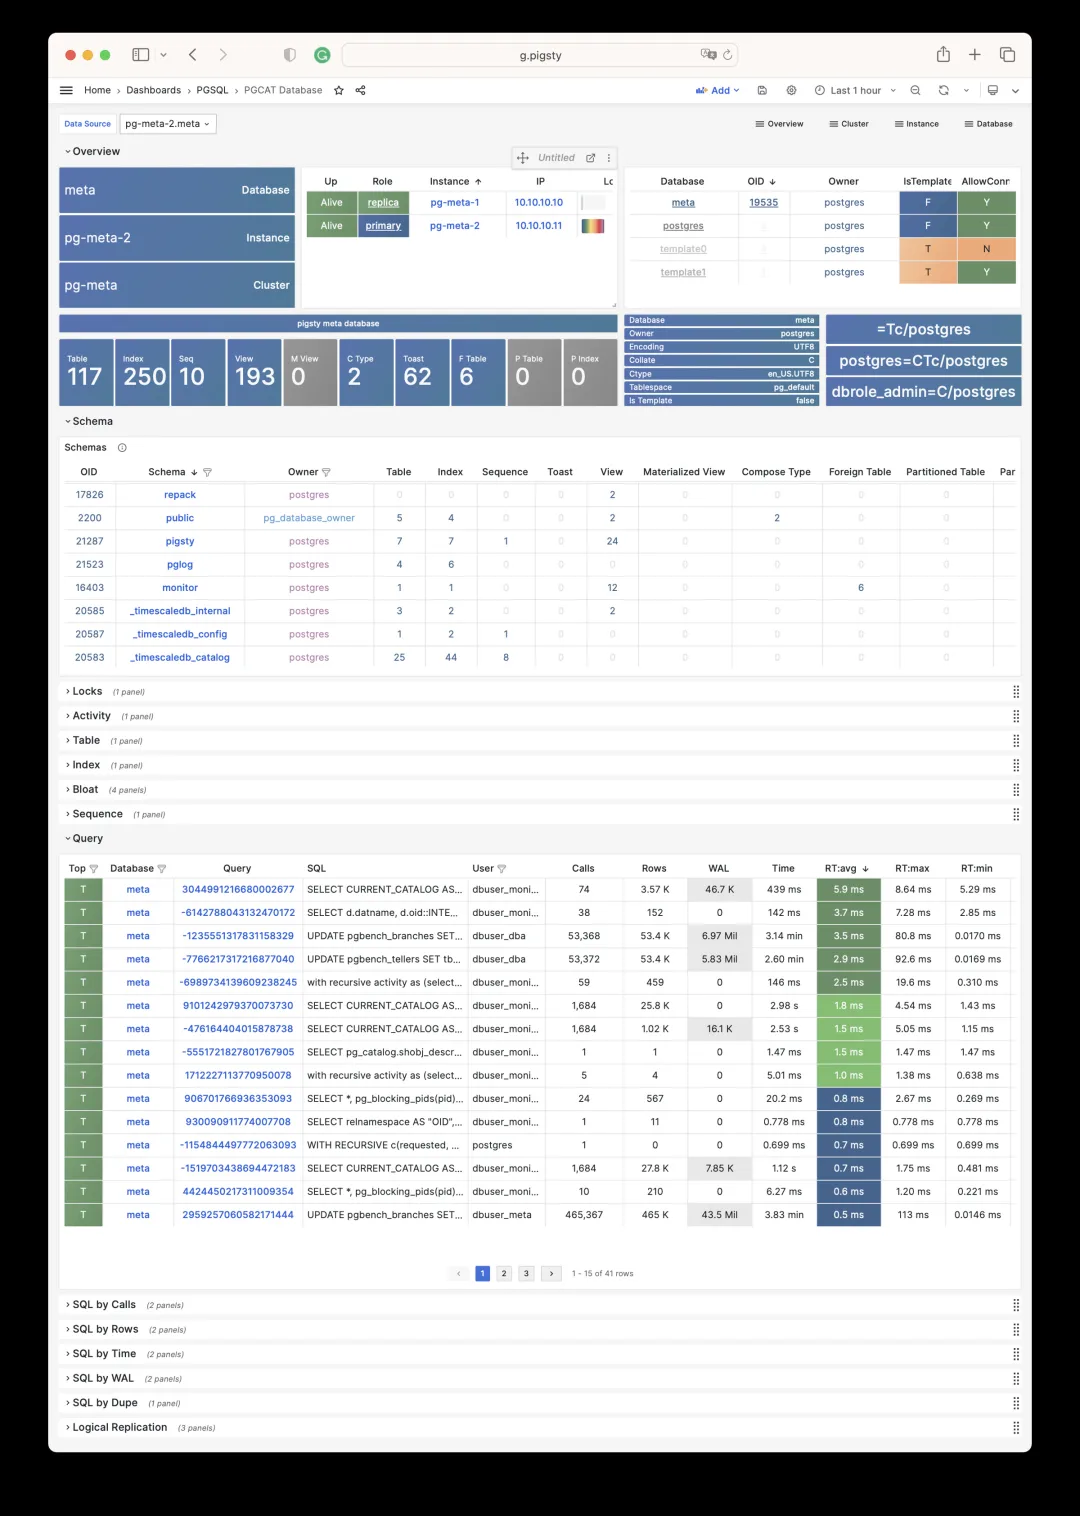
更多细节见 Pigsty 文档、公开演示与本文开头的视频教程。
加入 PGSQL × Pigsty 交流群,可在微信搜索 pigsty-cc 联系 Pigsty 小助手。
5 - PostgreSQL 慢查询诊断方法
本文使用 2021 年 2 月的 Pigsty 沙箱与仪表盘演示。
慢查询会占用连接、持有锁,并消耗 CPU 与 I/O。在备库上,长查询还可能与 WAL 重放冲突。PostgreSQL 会根据备库参数延迟重放或取消冲突查询,具体行为见热备冲突处理。
监控可以帮助我们找到受影响的查询,并比较变更前后的表现。
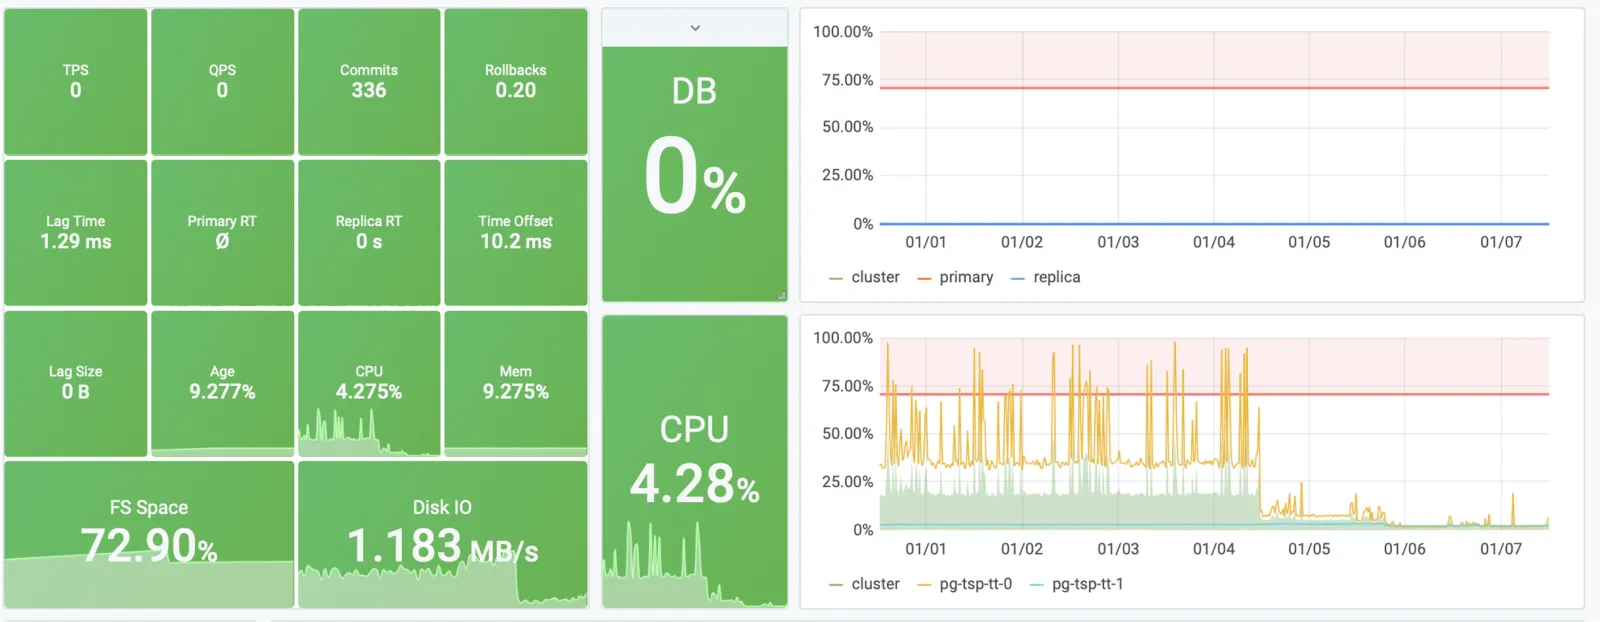
本例中,查询优化将 CPU 使用率从约 40% 降至 4%。
收集查询统计与日志
pg_stat_statements 扩展汇总相似语句的调用次数、执行时间、读取或影响的行数与 I/O 统计。按以下步骤启用:
- 将
pg_stat_statements加入shared_preload_libraries。 - 重启 PostgreSQL。
- 在需要读取统计信息的数据库中执行
CREATE EXTENSION pg_stat_statements。
查询 ID 标识归一化后的语句,不代表一次执行,也不保证使用同一个执行计划。统计列名会随 PostgreSQL 版本变化,使用时查阅对应版本的 pg_stat_statements 参考。
用 log_min_duration_statement 记录执行时间达到阈值的语句。日志适合分析某次慢执行。根据业务设置阈值:记录全部语句会增加日志量与采集开销。
累计平均值可能掩盖近期性能变化。通过连续采样,可以比较故障期间的响应时间、调用速率与 I/O。慢查询阈值应来自业务延迟要求;频繁点查与偶发批处理需要不同的阈值。
在沙箱中复现问题
本实验会主动删除索引,请使用可丢弃的 pgbench 测试数据库。
当时的 Pigsty 沙箱通过 make ri、make ro 和 make rw 初始化并运行 pg-test 集群上的负载。以下命令通过服务端口施加读写负载:
在不同终端运行两组负载,然后在主库上删除主键:
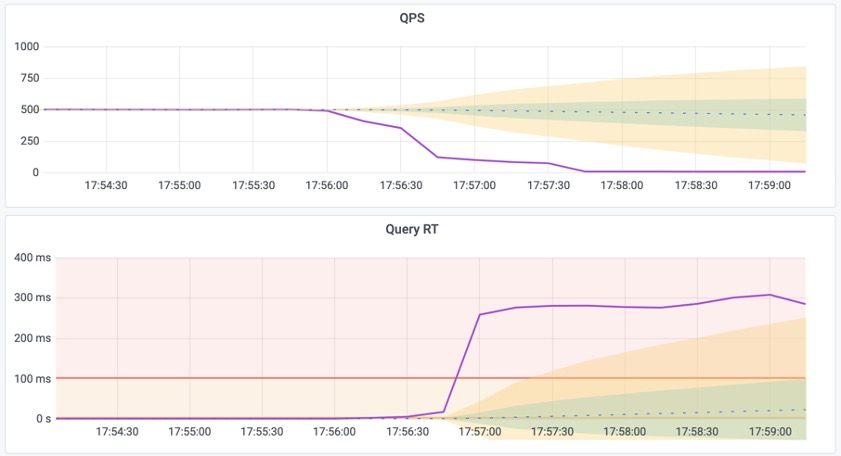
点查失去了索引。本次测试中,平均响应时间从约 1 ms 增至 300 ms,一个备库的 QPS 从 500 降至 7。
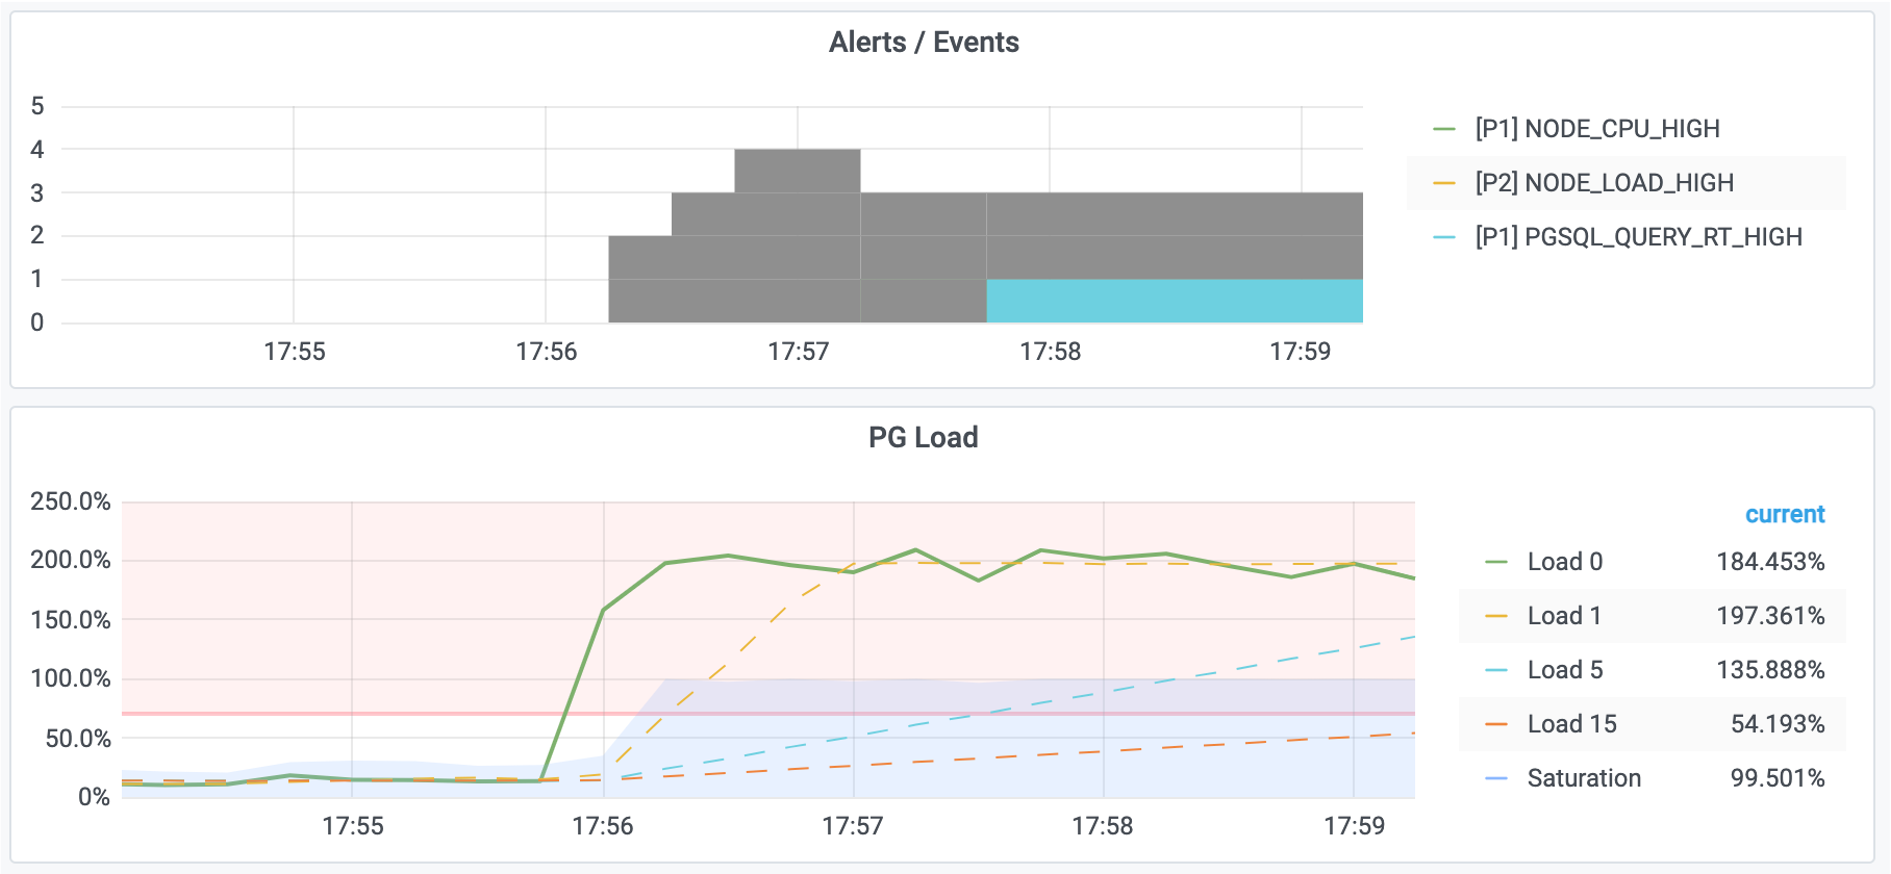
集群负载也随之上升,并触发告警。
定位查询
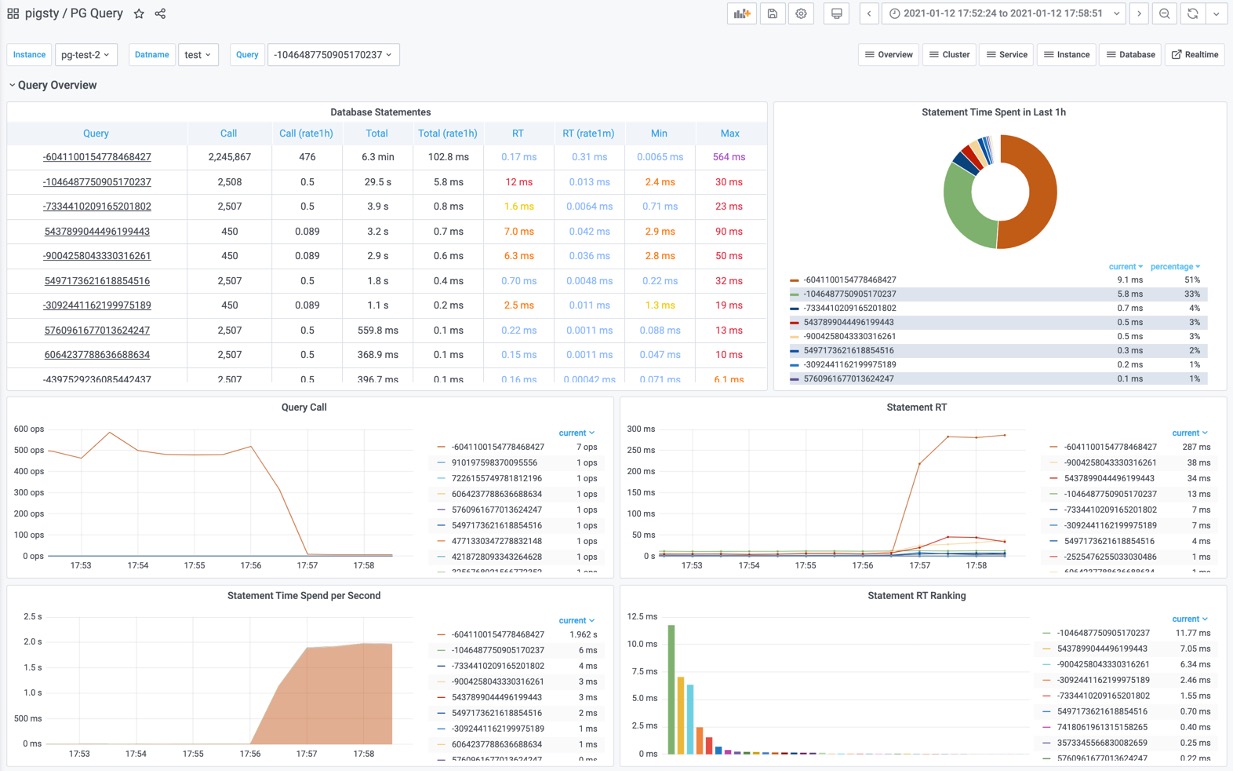
打开 PG Cluster 面板,找到受影响的实例。再打开 PG Query,定位响应时间和执行时间占比上升的语句。
本例中,查询 ID -6041100154778468427 的响应时间从约 17 μs 增至 280 ms,QPS 从 500 降至 7。
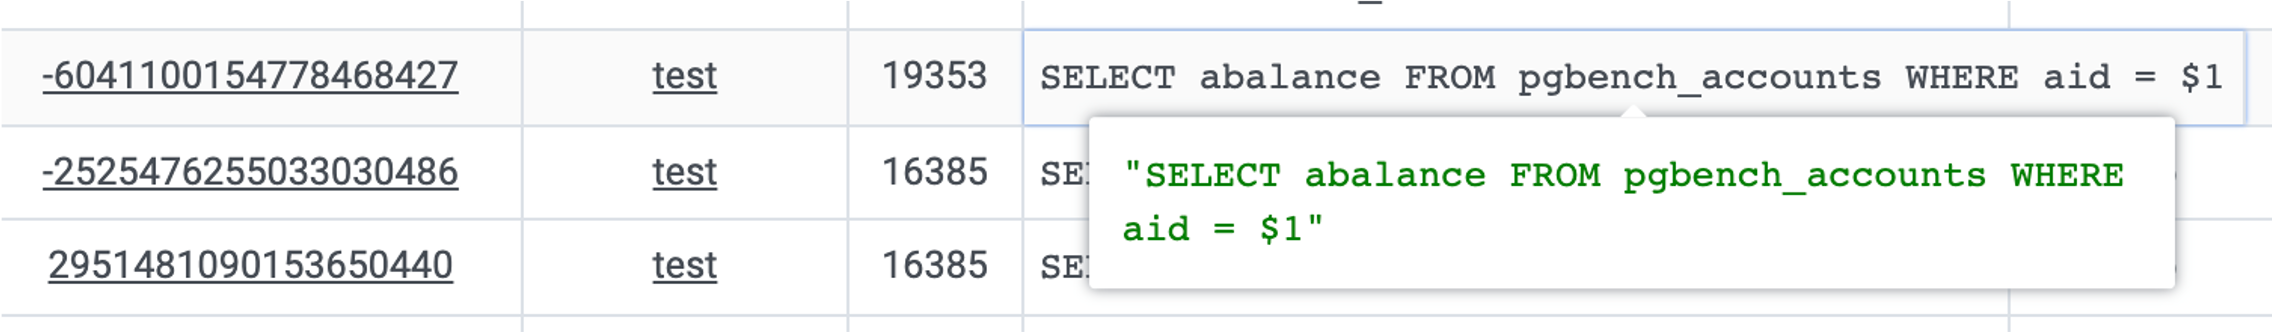
按查询 ID 打开 PG Query Detail,找到对应 SQL:
验证原因
这条语句按 aid 读取一个账户。在 PG Table Catalog 中检查该列是否有索引,再到 PG Table Detail 比较 pgbench_accounts 的索引扫描与顺序扫描次数。
本实验中,删除主键后索引扫描降至零,顺序扫描随之增加,与索引缺失的判断一致。
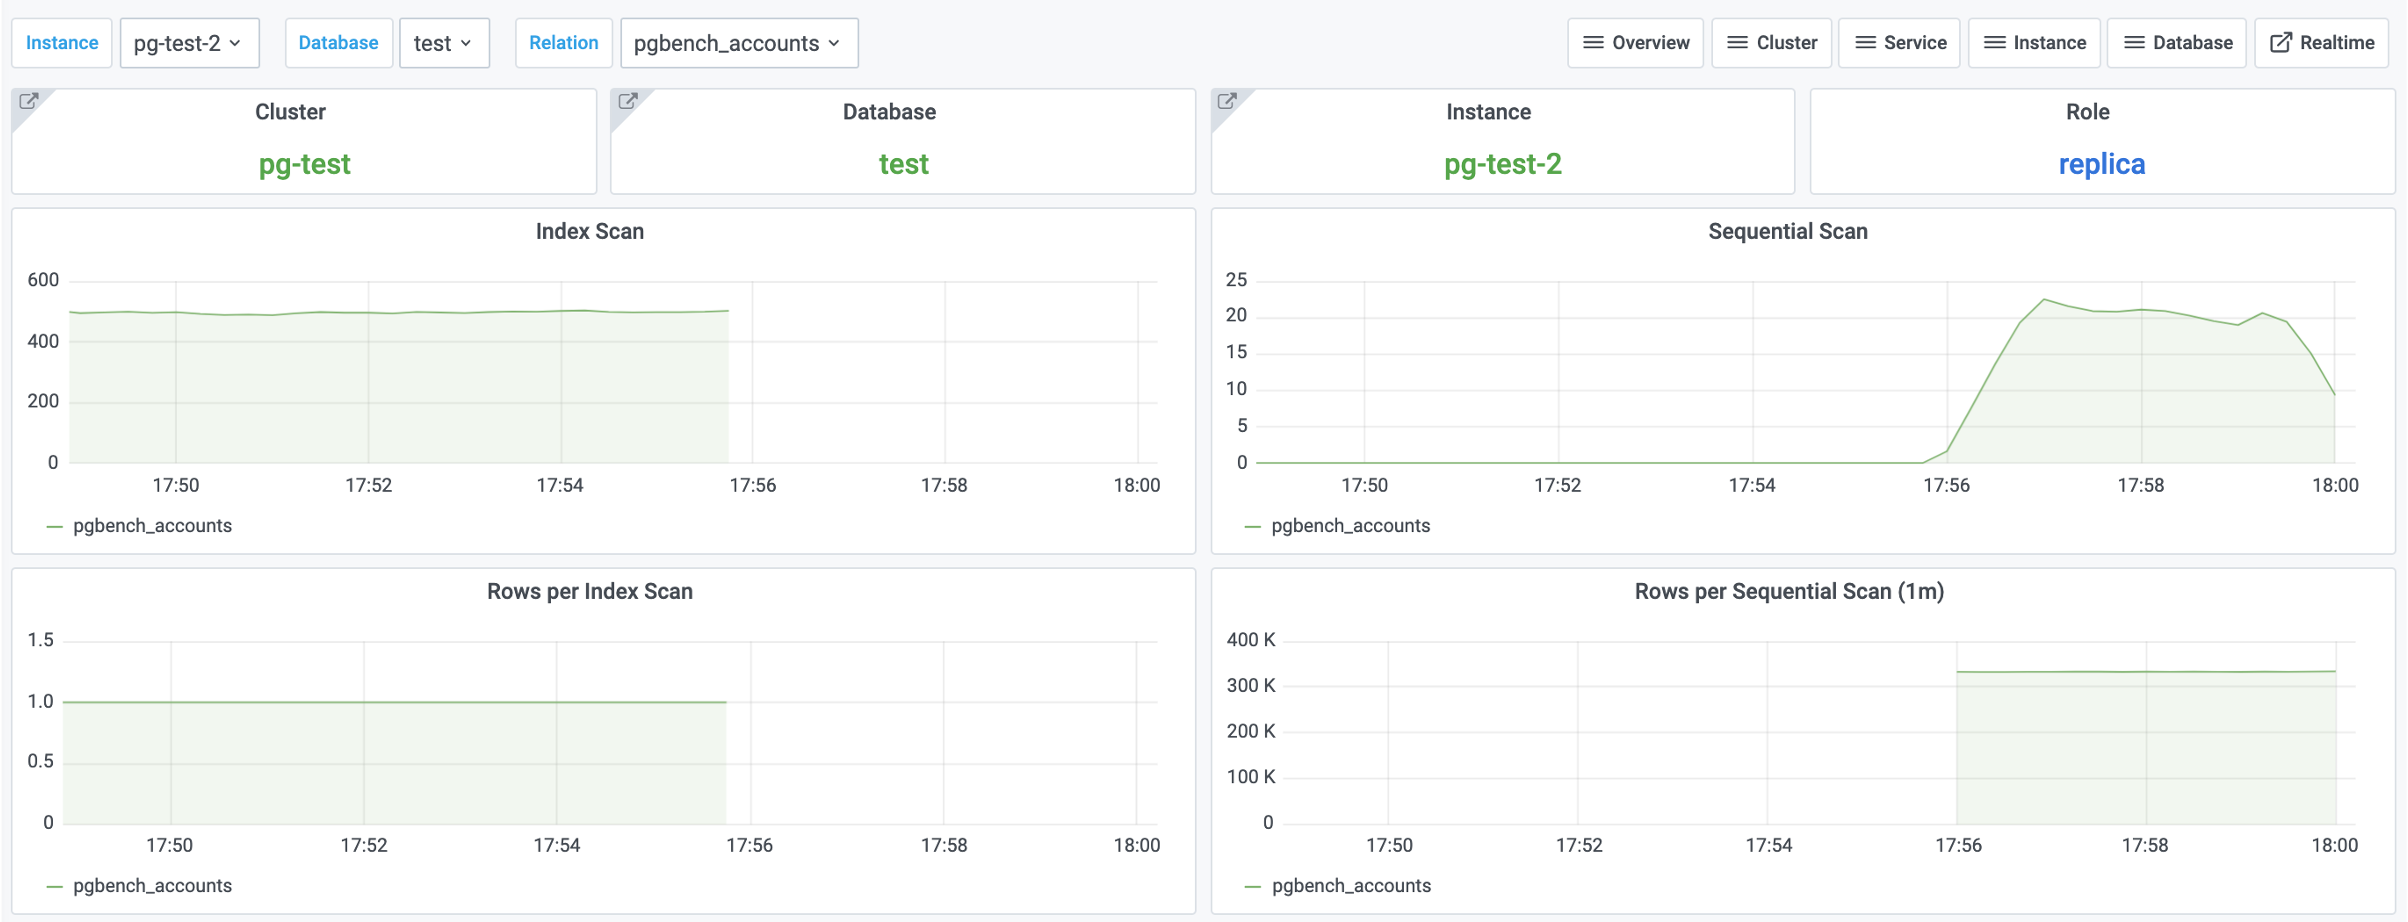
修复并检查结果
在沙箱中为 aid 恢复索引:
这会恢复索引访问路径,但不会重建此前删除的主键约束。
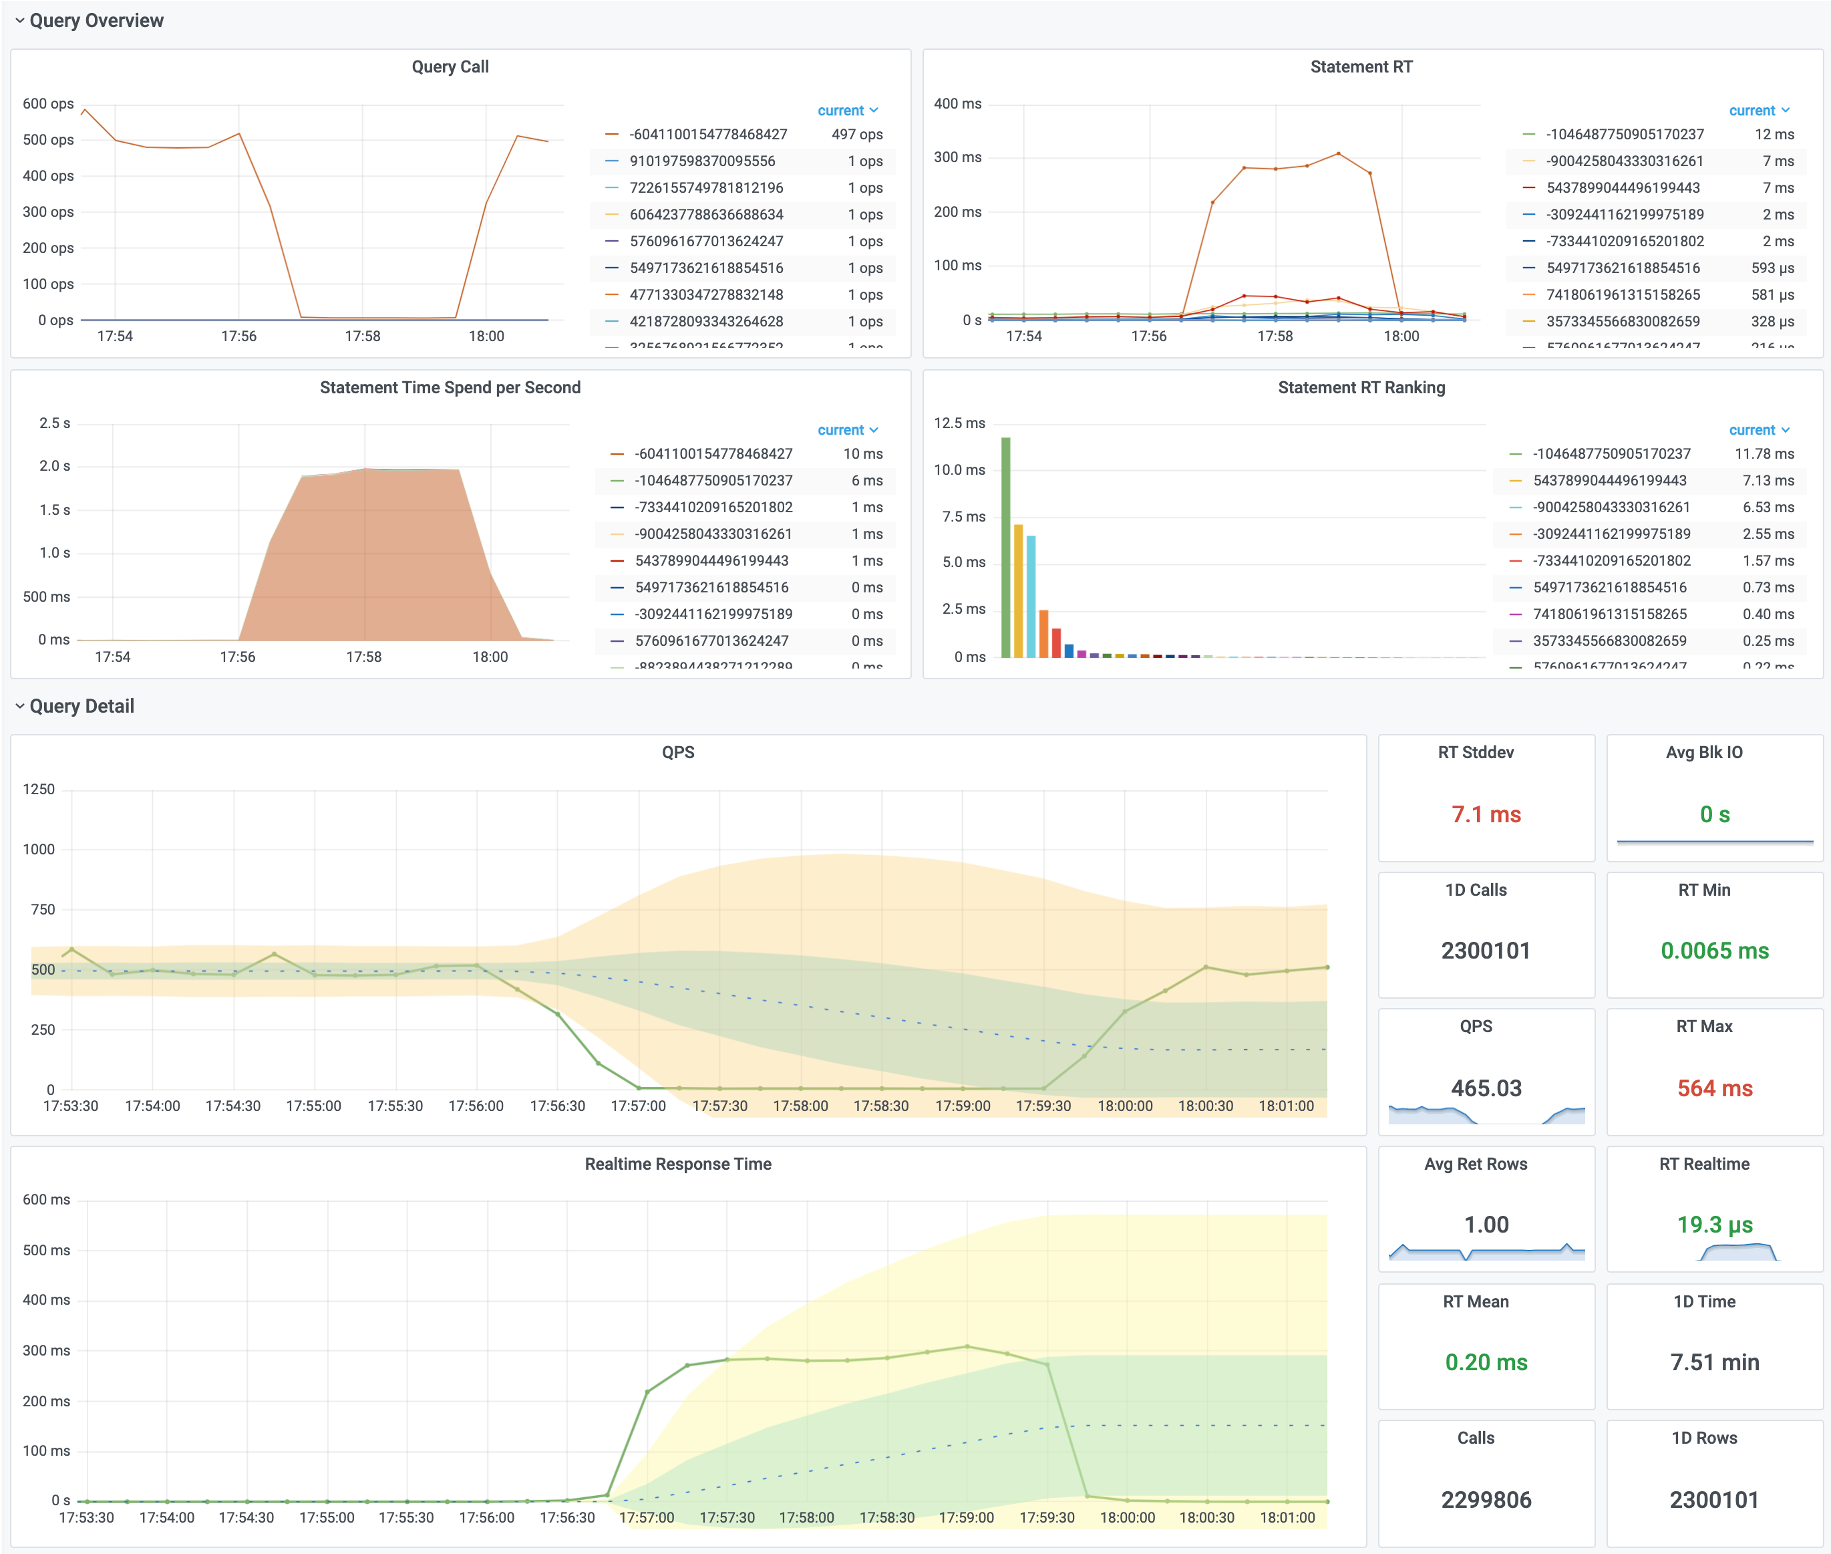
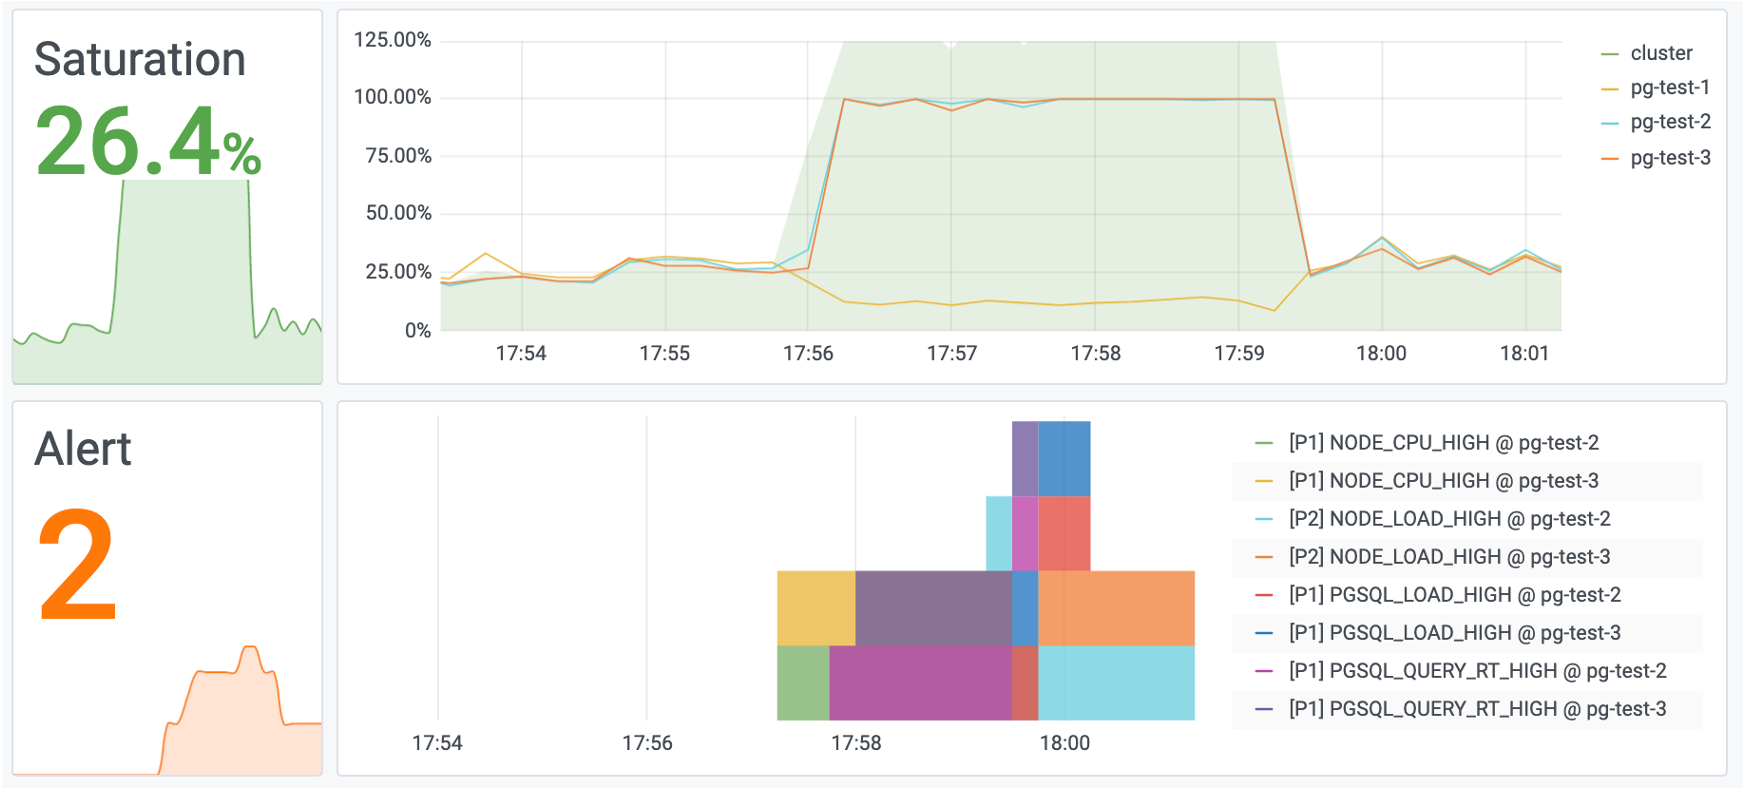
用相同负载与时间区间比较变更前后的结果,记录查询延迟、吞吐量和资源使用情况。完成实验后停止测试负载。
6 - Pigsty 首次发布
本文介绍 2021 年 1 月 Pigsty 首次发布时的产品状态。
今天,我发布了 Pigsty。
官方网站:pigsty.cc
Pigsty 是什么?
Pigsty 用于监控大规模 PostgreSQL 集群,也提供高可用集群的自动部署方案。它基于开源组件构建,是免费的开源软件。
我希望通过统一的监控界面与部署流程,减少管理 PostgreSQL 集群所需的手工操作。
监控系统
我需要管理一个大规模 PostgreSQL 集群。在尝试一些开源与商业监控产品后,没有找到满足需求的方案,于是开始开发 Pigsty。
Pigsty 的界面基于 Grafana。首次发布时,它包含 30 多个监控看板、上千个图表面板,约 18 万行 JSON 配置,覆盖数据库与基础设施。
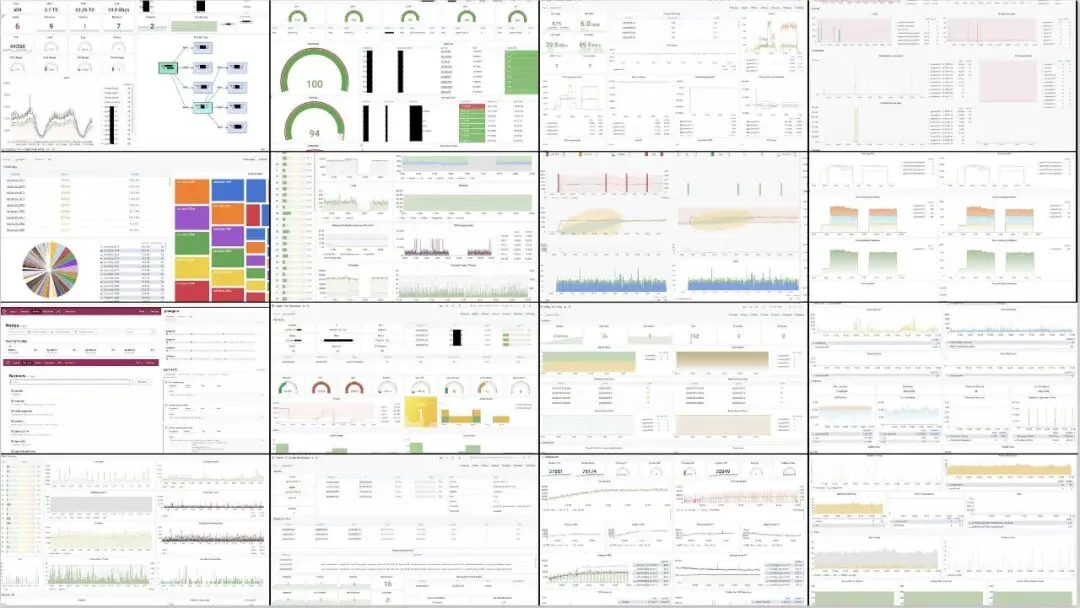
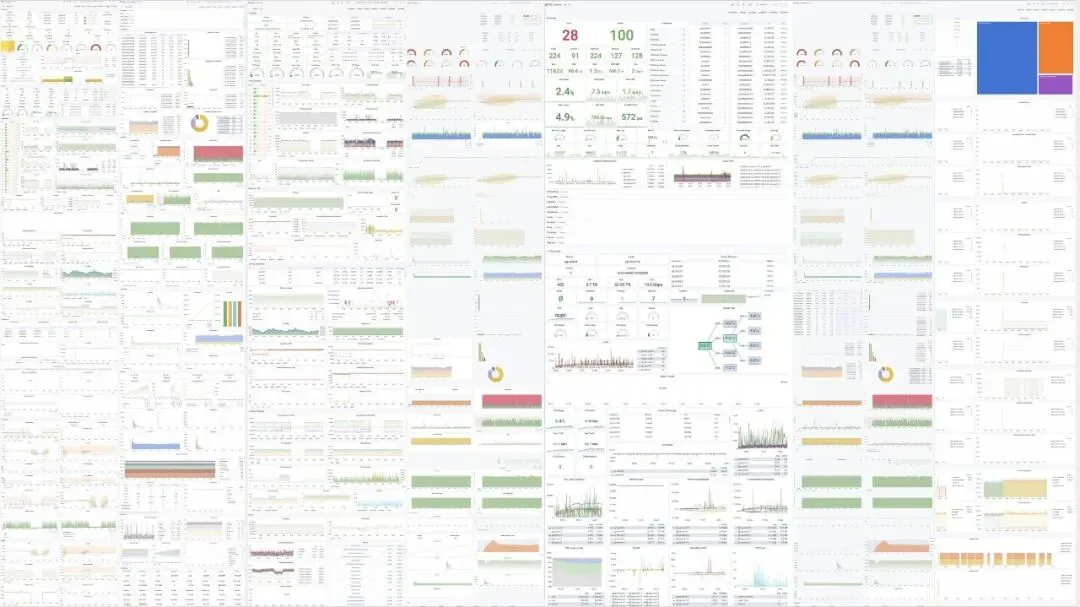
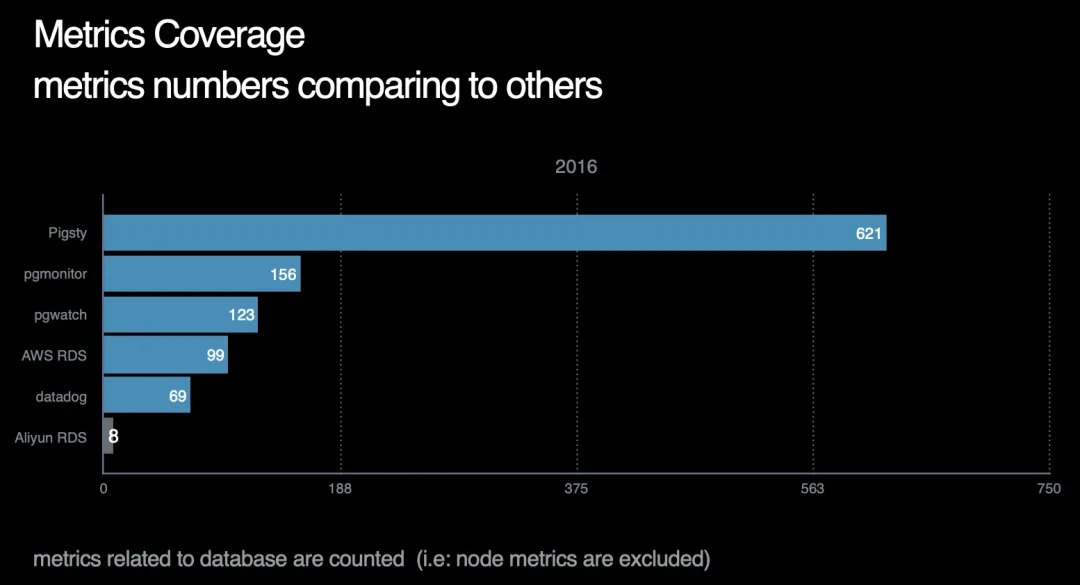
这个版本提供近 1200 个监控指标,可以查看整个集群的汇总数据,也可以继续查看单个数据库对象的读写活动。
集群供给方案
发布和演示监控系统需要可用的数据库环境。已有数据库的部署方式各不相同,因此我把数据库供给方案也纳入了 Pigsty。
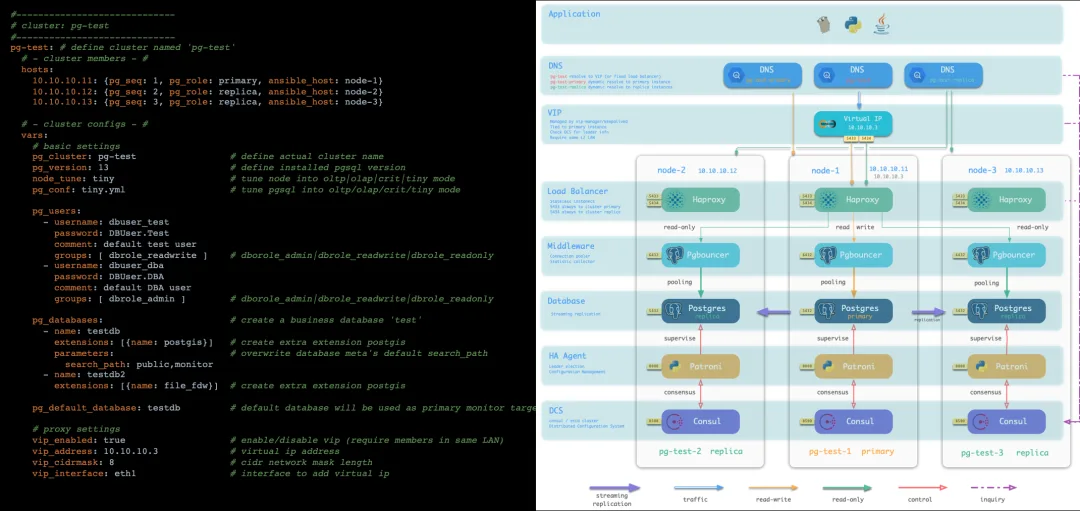
这套方案组合了主从复制、故障切换、流量代理、连接池、服务发现与基本权限配置,减少逐个配置组件的工作。
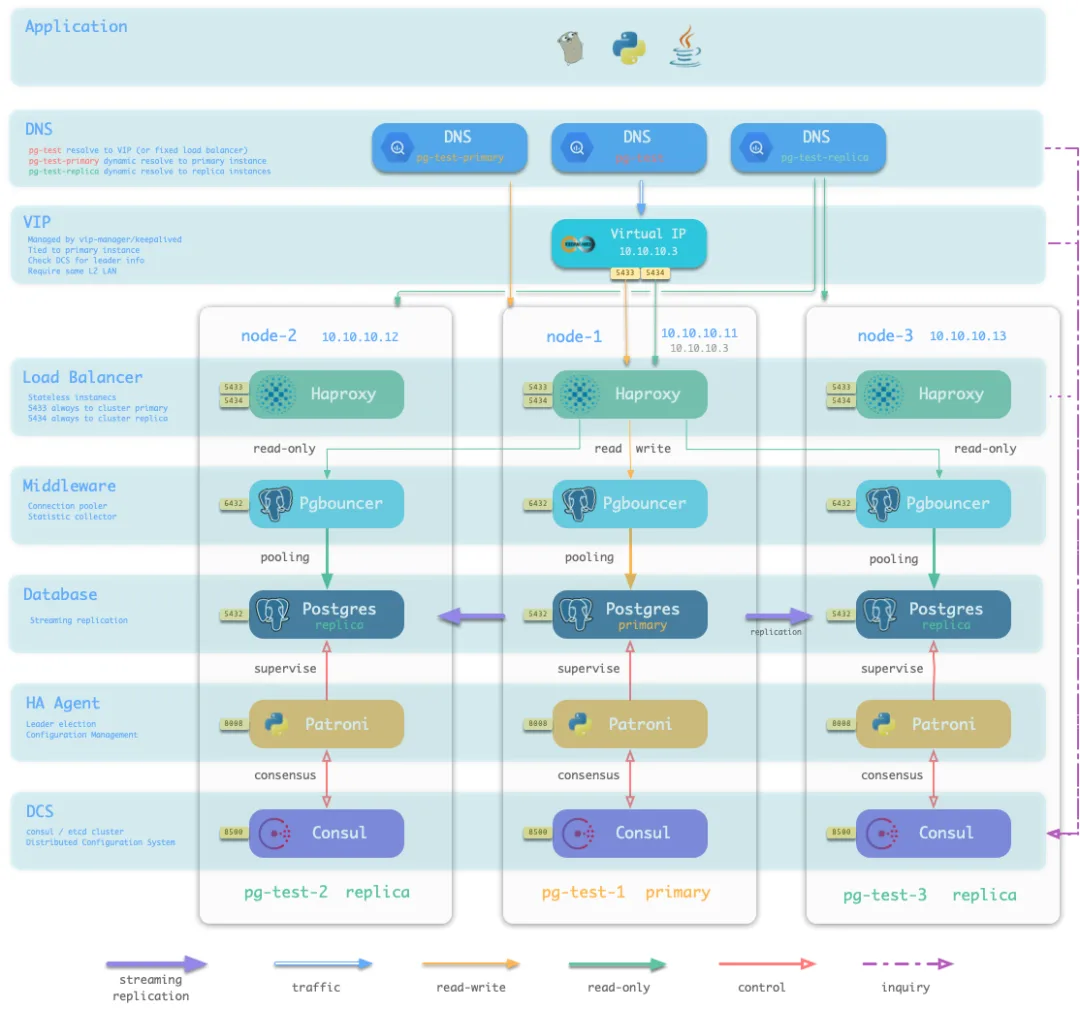
填写配置文件后,Pigsty 会按配置创建数据库集群。
130 多个配置项用于定义数据库与基础设施。部署使用声明式配置和幂等执行机制,在物理机与虚拟机上通过代码管理基础设施,工作方式类似 Kubernetes。
开源组件与许可
此版本的 Pigsty 使用 Apache 2.0 许可证,同时提供专业版与可选的商业支持。欢迎提交 Issue、PR,或通过捐赠与赞助支持项目。
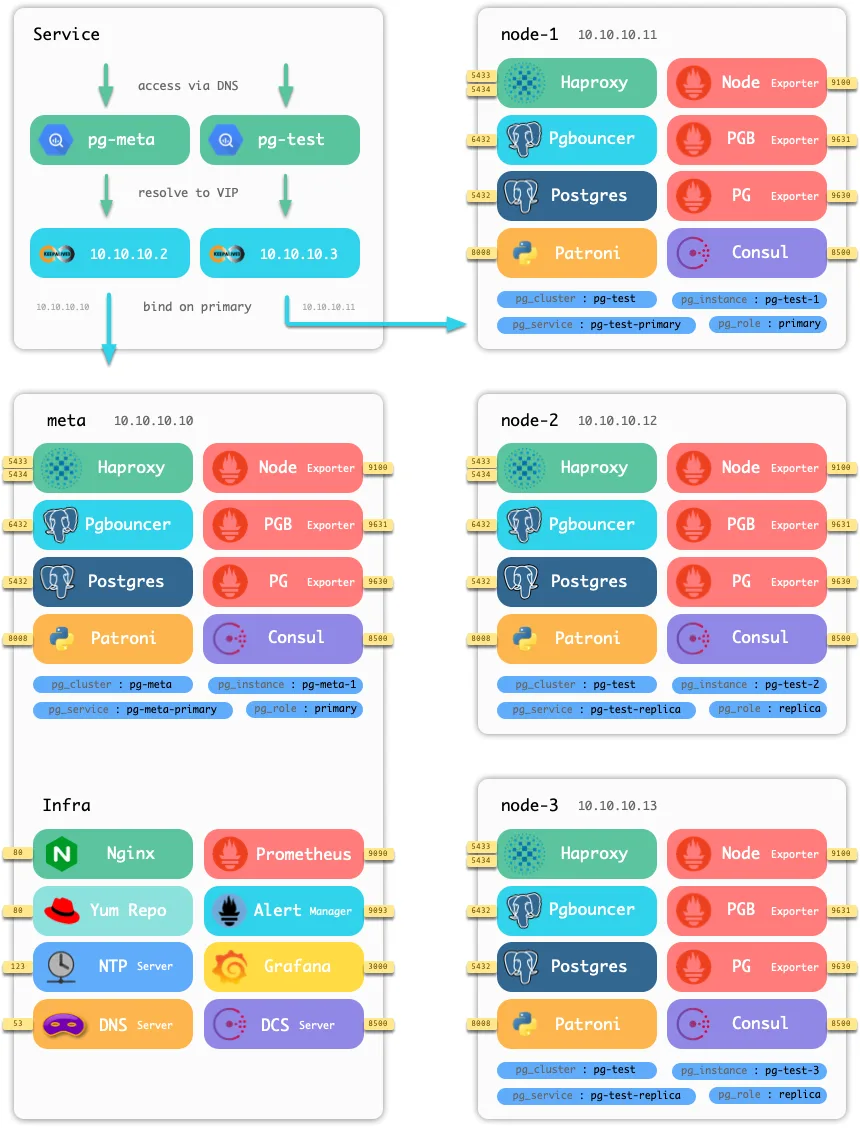
监控系统使用 Prometheus、Grafana、Alertmanager 与 Exporter,并包含 Nginx、Dnsmasq/CoreDNS、NTP/Chrony、Consul/etcd 等基础设施组件。这些组件可以与已有监控系统集成。
供给方案通过 Ansible 部署 PostgreSQL、PgBouncer、Patroni、HAProxy 与 Keepalived。部署逻辑写成 Ansible Role,便于集成和定制。
试用 Pigsty
Pigsty 提供中英文文档、公开演示站点与基于 Vagrant 的本地沙箱。首次发布时,以下命令可以在笔记本上创建包含数据库集群与监控基础设施的沙箱:
生产环境也使用这套部署流程,需要按实际主机、网络与数据库要求调整配置。
项目链接
7 - 黄金监控指标:错误延迟吞吐饱和
本文写于 2020 年,指标数量与示例对应当时的部署。
前言
玩数据库和玩车有一个共通之处,就是都需要经常看仪表盘。
仪表盘上的指标显示当前运行状态,帮助我们决定何时采取行动。
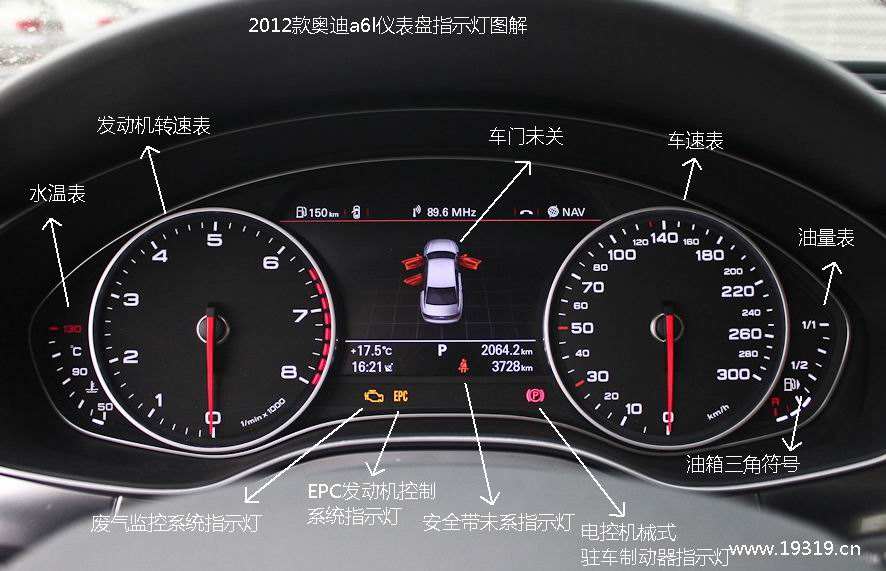
车有很多指标:车速,胎压,扭矩,刹车片磨损,各种温度,等等等等,各式各样。
但人的注意力有限,仪表盘空间也有限。
所以,指标可以分两类:
- 你会去看的:黄金指标 / 关键指标 / 核心指标
- 你不会看的:黑匣子指标 / 冷指标。
黄金指标就是那几个关键性的核心数据,需要时刻保持关注(或者让自动驾驶系统/报警系统替你时刻保持关注),而冷指标通常只有故障排查时才会去看,故障排查与验尸要求尽可能还原现场,黑匣子指标多多益善。需要时没有记录,就很难还原问题。
今天我们来说说PostgreSQL的核心指标,数据库的核心指标是什么?
数据库的指标
在讲数据库的核心指标之前,我们先来瞄一眼有哪些指标。
在本文使用的部署中,这两条查询显示:每个实例有 1,000 多条 PostgreSQL 序列和 2,000 多条主机序列。
这些序列可用于排查问题和可视化分析。
但对于日常管理,只需要少数几个核心指标就可以了。
可用指标千千万,哪些才是核心指标?
核心指标
根据经验和使用频度,不断地做减法,可以筛选出一些核心指标:
| 指标 | 缩写 | 层次 | 来源 | 种类 |
|---|---|---|---|---|
| 错误日志条数 | Error Count | SYS/DB/APP | 日志系统 | 错误 |
| 连接池排队数 | Queue Clients | DB | 连接池 | 错误 |
| 数据库负载 | PG Load | DB | 连接池 | 饱和度 |
| 数据库饱和度 | PG Saturation | DB | 连接池&节点 | 饱和度 |
| 主从复制延迟 | Repl Lag | DB | 数据库 | 延迟 |
| 平均查询响应时间 | Query RT | DB | 连接池 | 延迟 |
| 活跃后端进程数 | Backends | DB | 数据库 | 饱和度 |
| 数据库年龄 | Age | DB | 数据库 | 饱和度 |
| 每秒查询数 | QPS | APP | 连接池 | 流量 |
| CPU使用率 | CPU Usage | SYS | 机器节点 | 饱和度 |
事故发生时,我优先看错误指标。
日常应用监控重点看 QPS 与响应时间。
容量管理重点看数据库饱和度。
为什么是它们?
错误指标
我通常先检查 错误,因为它们往往直接影响用户。
如果只能选一个指标进行监控,那么选 错误指标,比如应用,系统,DB层的每秒错误日志条数可能最合适。
错误次数和错误率可以反映故障,用于告警和诊断,但不能单独说明还有多少可用容量。
连接池队列增长,说明可用连接出现竞争。但单看队列长度,无法确定瓶颈或衡量剩余容量。
要在用户看到错误之前发现压力,还应监控延迟、资源使用和队列。
指标用于衡量系统运行状态。我们还会关注系统其他方面的能力:吞吐量/流量,响应时间/延迟,饱和度/利用率/水位线。这三者分别代表系统的能力,服务质量,负载水平。
关注点不同,后端(数据库用户)关注系统能力与服务质量,DBA(数据库管理者)更关注系统的负载水平。
流量指标
流量类的指标很有潜力,特别是QPS,TPS这样的指标相当具有代表性。
流量指标衡量当前完成的工作量,例如每秒处理的订单数或请求数,不能直接表示容量上限。
车速计显示当前速度,但不表示还能加速多少。吞吐量也有同样的区别。
QPS 和 TPS 衡量完成的工作量,不衡量每次调用的成本。耗时 10 微秒和 10 秒的查询都只算一次调用。应结合查询类型、延迟和资源使用情况比较吞吐量,并通过压测为已知工作负载建立基线。
延迟指标
延迟适合衡量系统的服务质量。
RT(响应时间)衡量服务质量。应按工作负载设置目标,例如某类 OLTP 服务可能要求 1 ms 的响应时间。延迟上升可能表示资源争用,但不能单独用于测量饱和度。平均值也可能掩盖慢请求;有耗时分布数据时,可结合 P99、P99.9 分析。
饱和度指标
饱和度指标类似汽车的发动机转速表,油量表,水温表。
饱和度指标适合衡量系统的负载
饱和度描述受限资源承受的压力。利用率和队列长度有助于识别饱和,但衡量的是不同现象。应根据工作负载基线和响应时间目标设定告警阈值。压力长期偏高时,需要评估容量、查询成本和资源限制。
| 其他可选指标 | ||||
|---|---|---|---|---|
| 每秒事务数 | TPS | APP | 连接池 | 流量 |
| 磁盘IO使用率 | Disk Usage | SYS | 机器节点 | 饱和度 |
| 内存使用率 | Mem Usage | SYS | 机器节点 | 饱和度 |
| 网卡带宽使用率 | Net Usage | SYS | 机器节点 | 饱和度 |
| TCP错误:溢出重传等 | TCP ERROR | SYS | 机器节点 | 错误 |
8 - Pigsty PostgreSQL 监控系统介绍
本文介绍 2020 年 5 月的 Pigsty,指标数量与面板名称均对应当时的系统。
我最近开发了一套数据库监控系统,名为 Pigsty。下面介绍它的架构、面板与指标。
Pigsty 使用 Grafana、Prometheus 与 Consul。PIGSTY /pɪɡ staɪ/ 是 “Postgres in Grafana Style” 的缩写。
整体架构
Node、PostgreSQL 与 PgBouncer Exporter 采集指标,Consul 提供服务发现,Prometheus 保存和计算指标,Grafana 展示数据。
服务发现还提供身份标签,用于组织监控目标。Prometheus 的记录规则计算衍生指标,供 Grafana 查询。下面主要介绍 Grafana 面板。
监控层次
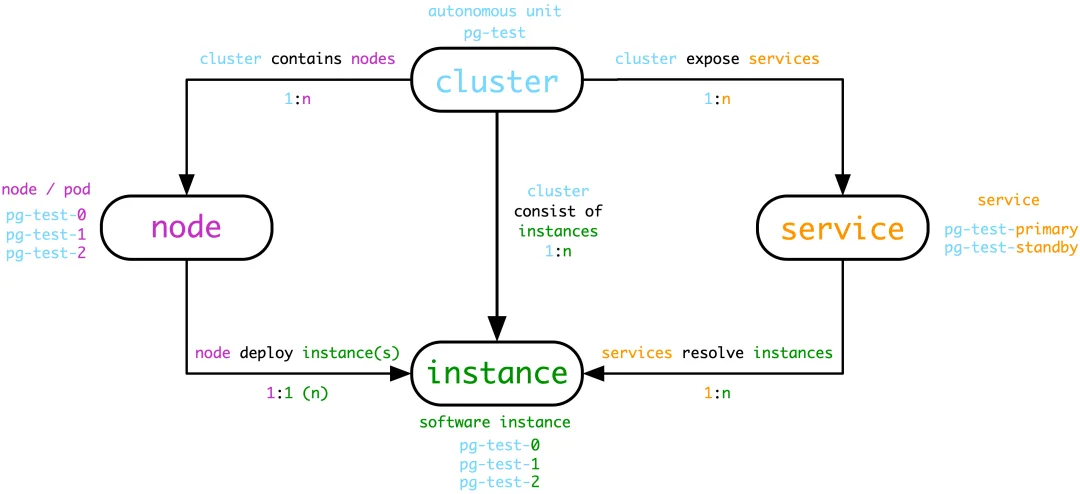
监控模型分为集群、服务、实例、数据库与节点五层。此版本把服务指标纳入集群面板,把数据库指标纳入实例面板,因此主要视图是集群、实例与节点。
cls标识集群,例如pg-test-tt。ins标识实例,例如pg-test-tt-0,由集群名和实例序号组成。在本部署中,序号为 0 的实例通常是主库。ip标识节点。
此外还有全局概览、分片集群、单个数据库、连接池、单条查询与 PgBouncer 专用面板。本文主要介绍核心视图。
功能
系统用于日常巡检、故障诊断与性能优化,包含以下面板:
- PostgreSQL 全局概览。
- PostgreSQL 分片集群监控。
- PostgreSQL 集群监控。
- PostgreSQL 实例监控。
- PostgreSQL 实例故障排查视图。
- PostgreSQL 主机监控。
- 慢查询分析。
- Redis 全局概览。
- Redis 集群监控。
- Redis 实例监控。
- PostgreSQL 集群健康评估。
首页与导航
首页包含 PostgreSQL 和 Redis 两部分。左侧显示全局指标,右侧提供集群导航,中间显示告警与事件。点击导航链接,或分片名、集群名、实例名、IP 地址,可以打开对应面板。
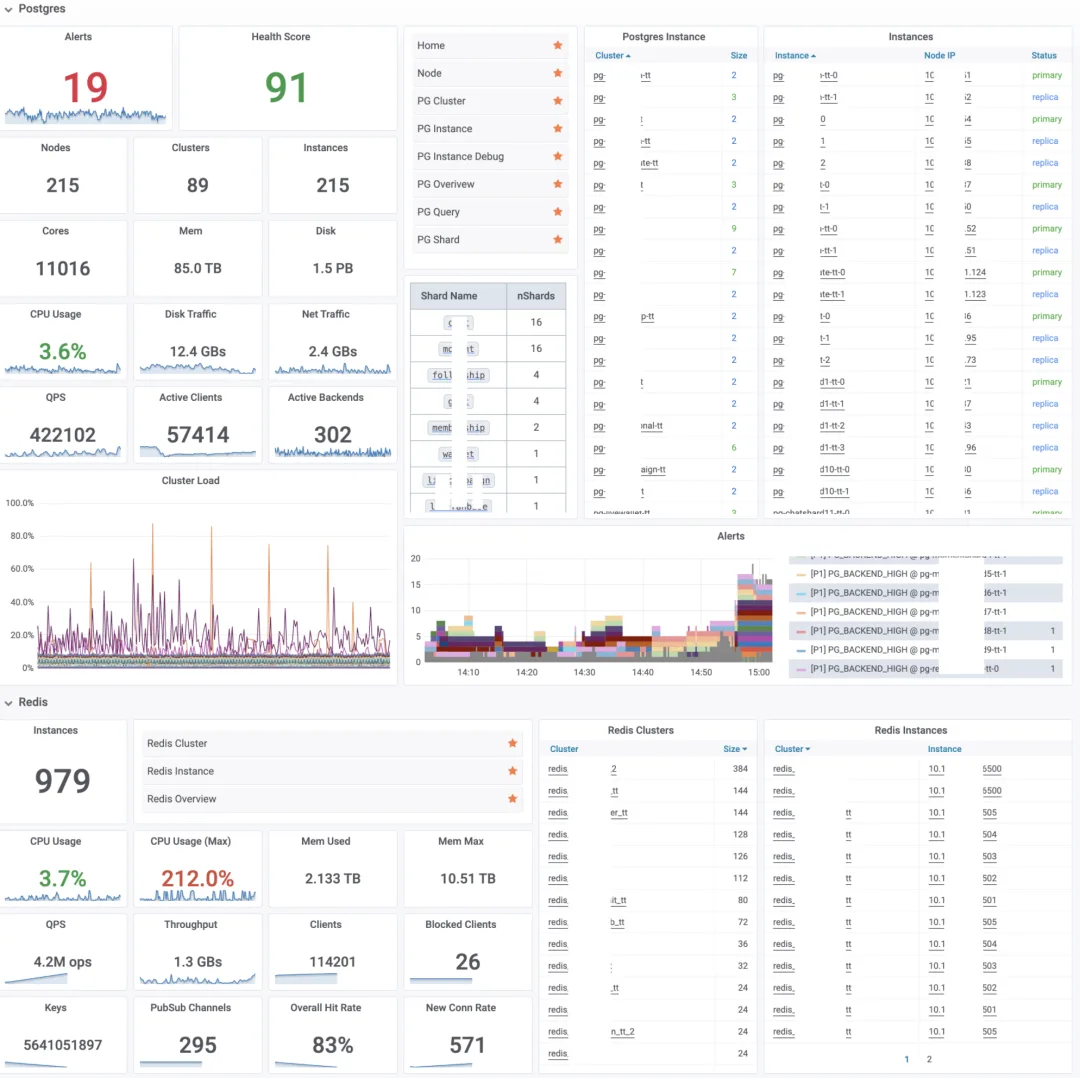
数据库指标
指标覆盖范围
当时每个实例约有 3300 个指标,其中包括:
- 约 1000 个数据库与连接池指标,其中 250 个由记录规则计算。
- 约 2000 个节点指标,其中 700 个由记录规则计算。
例如,QPS 按不同维度聚合后,产生近 30 个相关指标:
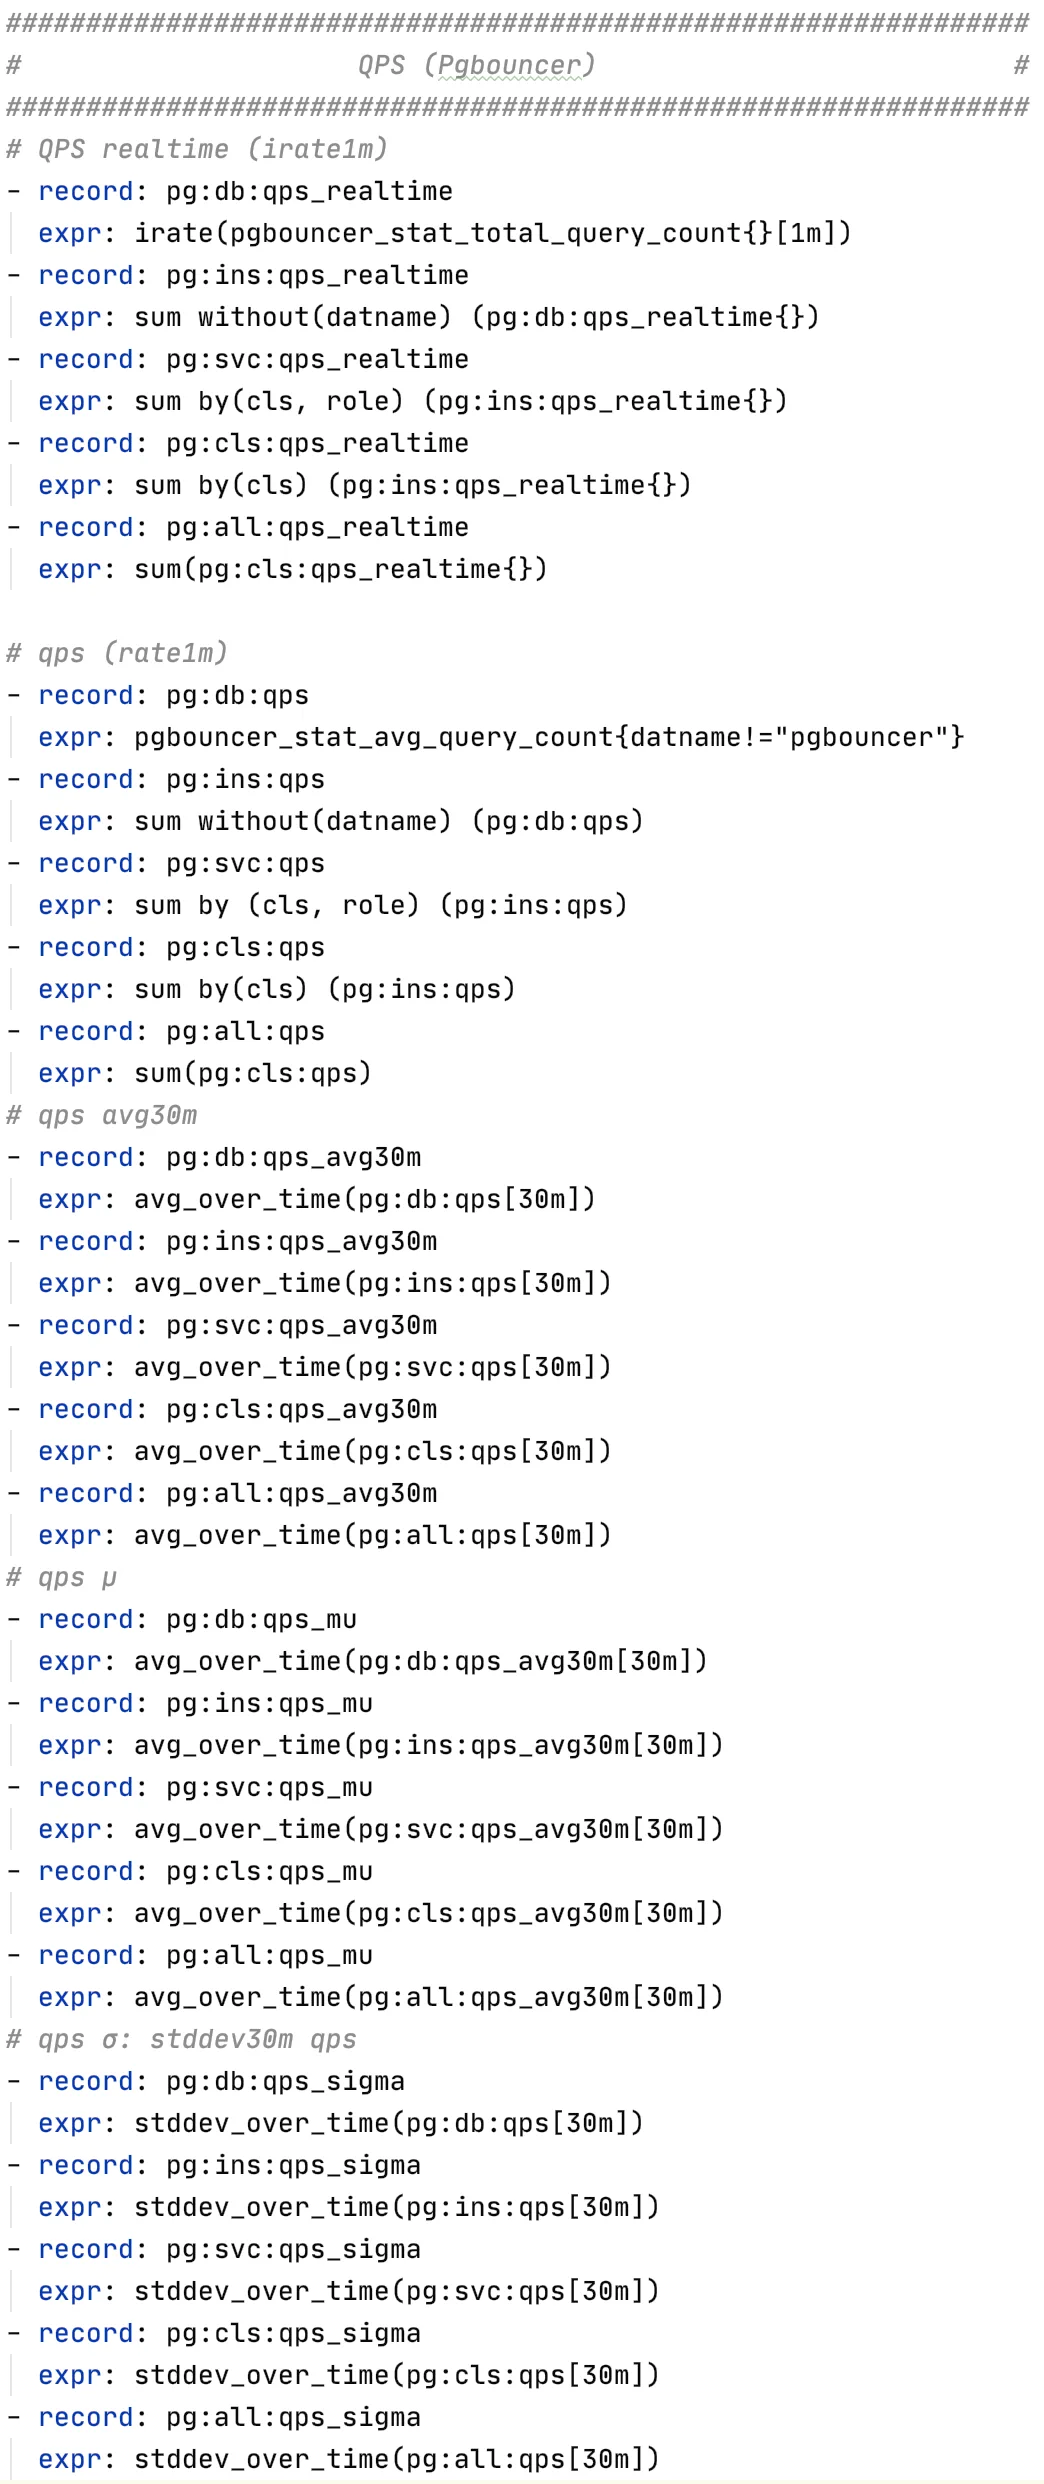
下面介绍一些常用指标。
四类黄金指标
按 Google SRE 的四类黄金指标组织如下。
错误
- 配置检查:数据校验和、NUMA、透明大页、同步提交等设置。
- 内存错误、TCP 错误与时钟偏移。
- 主机、数据库、连接池或监控组件不可用。
- 客户端排队、
idle in transaction连接、长事务、死锁、复制中断、大量回滚与监控错误。
饱和度
- PostgreSQL 负载与主机负载。
- CPU、内存、磁盘与网络利用率,缓存命中率,后端连接与连接池使用率。
流量
- QPS、TPS 与按语句类别统计的 QPS。
- 连接池流量、WAL 生成量、行读写量、块访问量与缓冲区访问量。
- 主机磁盘与网络 I/O,以及内存页面换入换出量。
延迟
- 事务平均响应时间(Xact RT)。
- 查询平均响应时间(Query RT)。
- 按语句统计的平均响应时间。
- 磁盘读写平均延迟。
- 以秒和字节衡量的复制延迟。
- 监控查询耗时。
PostgreSQL 实例监控
实例概览
- 实例身份:集群名、ID、主机、软件版本与其他集群成员。
- 关键配置:目录、端口与配置文件路径。
- 健康状态与角色,例如主库或从库。
- 核心指标:PostgreSQL 负载、复制延迟、活跃后端数、排队连接数、查询延迟、TPS 与数据库年龄。
- 实时负载,以及 1、5、15 分钟平均负载。
- 数据库告警与事件。
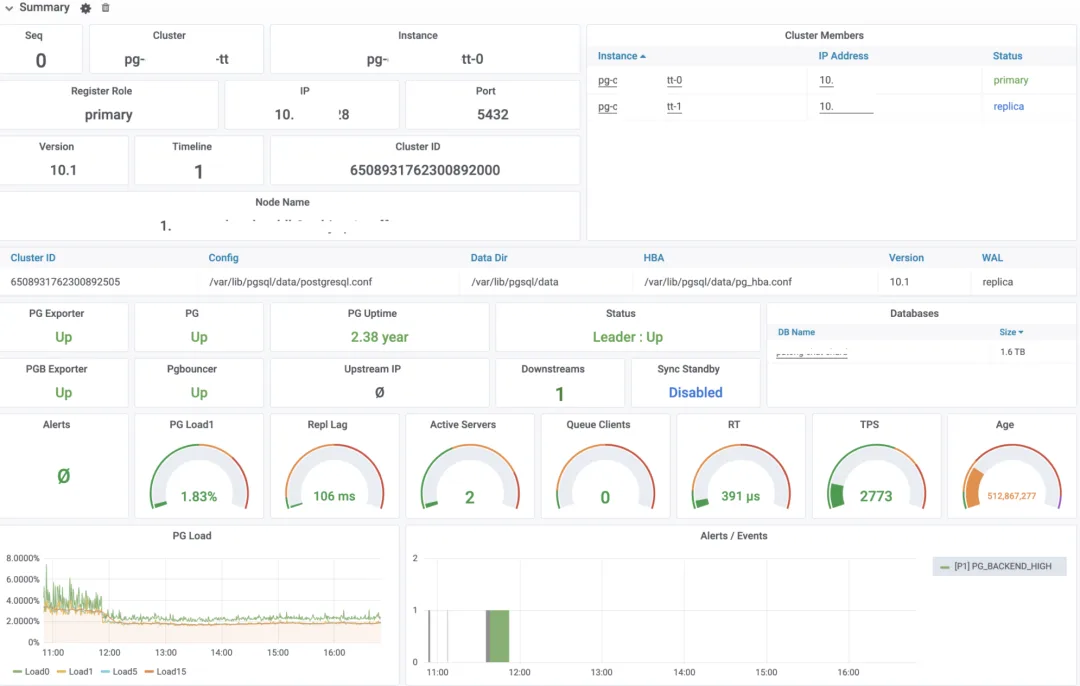
PG Load 的定义见我之前的文章《如何给 PostgreSQL 定 KPI》。
节点概览
节点概览显示 CPU、内存、磁盘与网卡的规格、关键设置和主要指标,右侧列出磁盘与网卡详情。
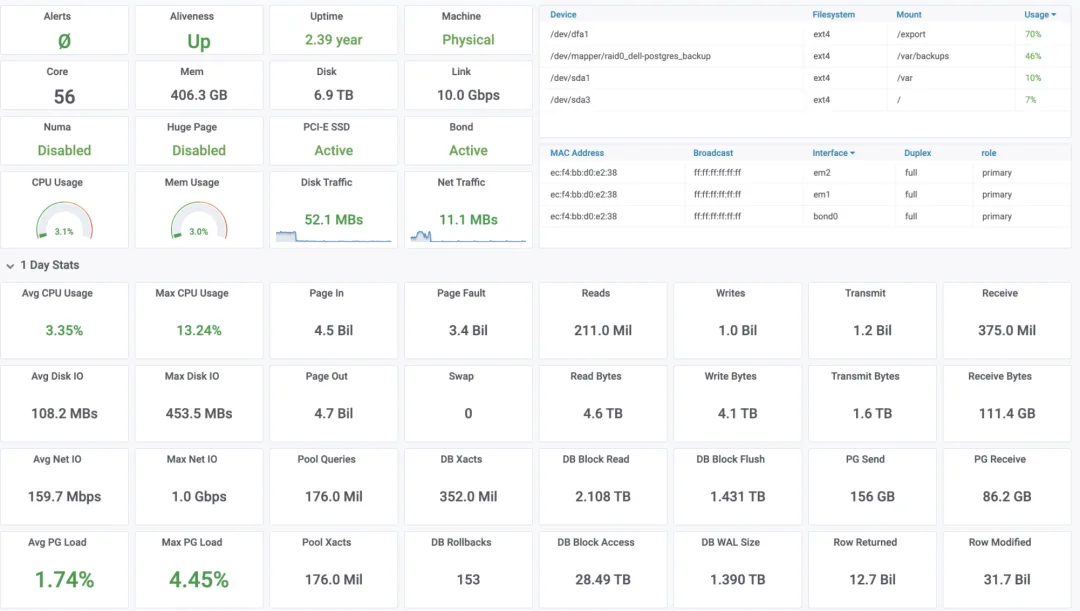
单日统计
这一部分汇总过去 24 小时的查询数、返回行数等。上面两行是节点统计,下面两行主要是 PostgreSQL 统计,可用于用量计量和容量评估。
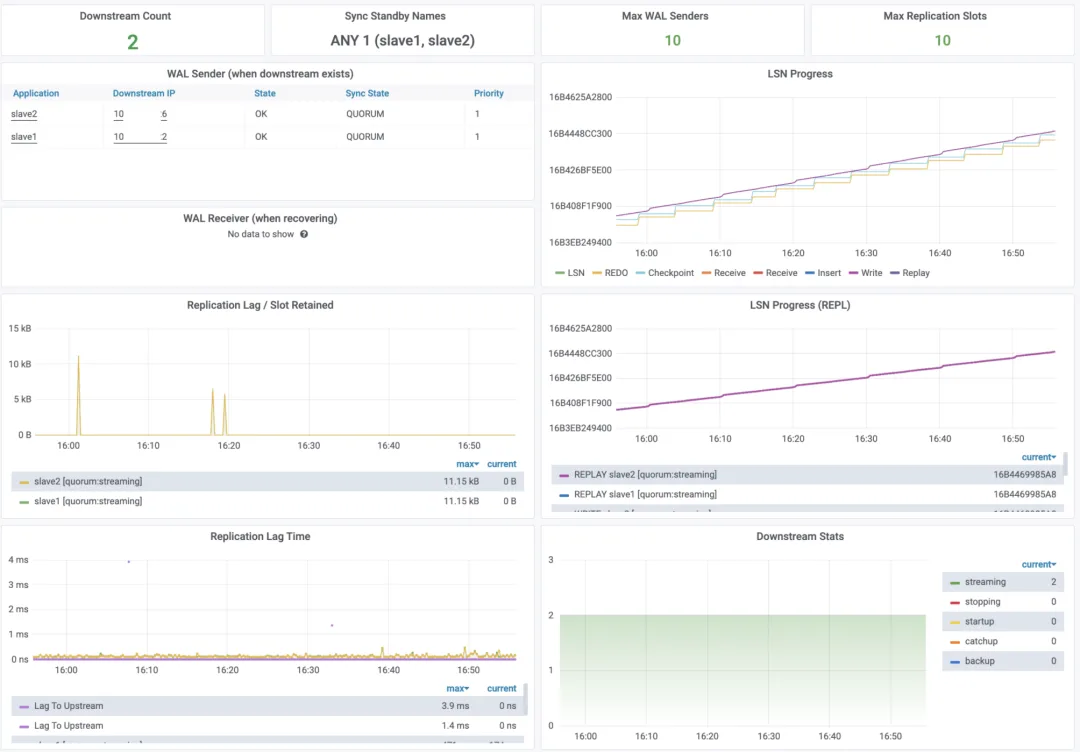
复制
复制区域显示:
- 当前节点的复制配置。
- 以秒和字节衡量的复制延迟,以及复制槽保留的 WAL 量。
- 下游节点对应的 WAL sender 统计。
- 各阶段的 LSN,反映复制进度与持久化状态。
- 下游节点数量,用于发现复制连接中断。
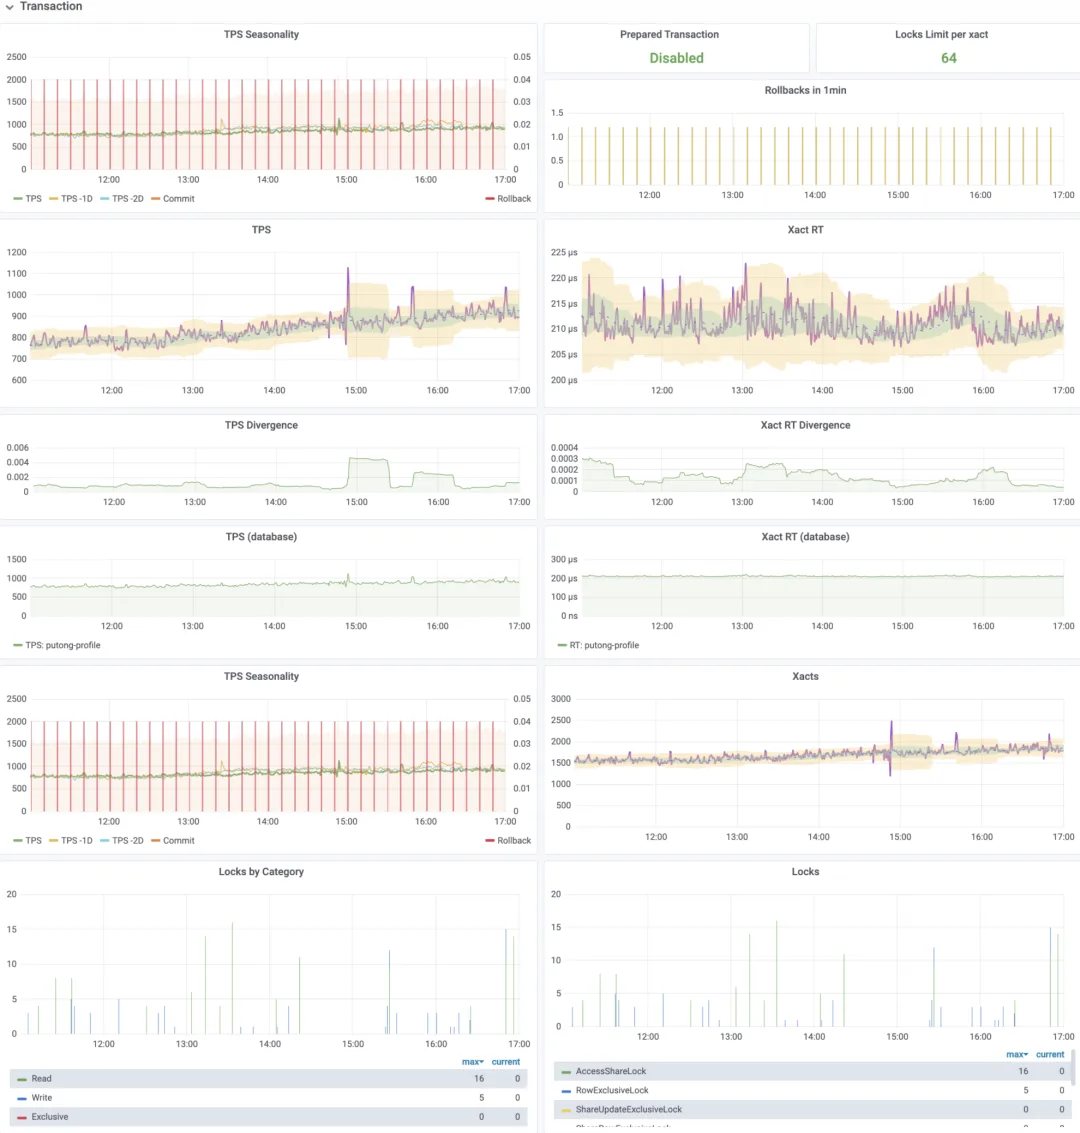
事务
事务区域通过 TPS、响应时间与锁展示实例活动:
- TPS、与前两天的同期比较,以及事务数与回滚数。
- 回滚数量与回滚率。
- TPS 详情:绿色条带为均值上下 1 个标准差,黄色为上下 3 个标准差,使用前 30 分钟的数据计算。超出黄色条带表示相对这段时间出现了较大波动。
- 从连接池采集的事务平均响应时间,使用同样的条带。
- TPS 与响应时间的相对波动,可用无量纲指标
(σ/μ)²衡量;值越大,表示相对均值的波动越大。 - 按数据库统计的 TPS 与事务响应时间。本部署中多数实例只有一个数据库,少量实例有多个。
- 直接从 PostgreSQL 采集的事务与回滚计数,用于配合连接池提供的 TPS。
- 按八种表锁模式,以及读、写、排他等大类聚合的锁数量。
查询
查询区域的指标与事务区域类似,但统计单位是语句。它用于分析慢查询和定位性能瓶颈。
- QPS、查询平均响应时间、两者的波动程度,以及与历史同期的比较。
- 本文以查询平均响应时间 1 毫秒作为警戒线、100 毫秒作为重点排查值的示例。实际阈值按工作负载设置。
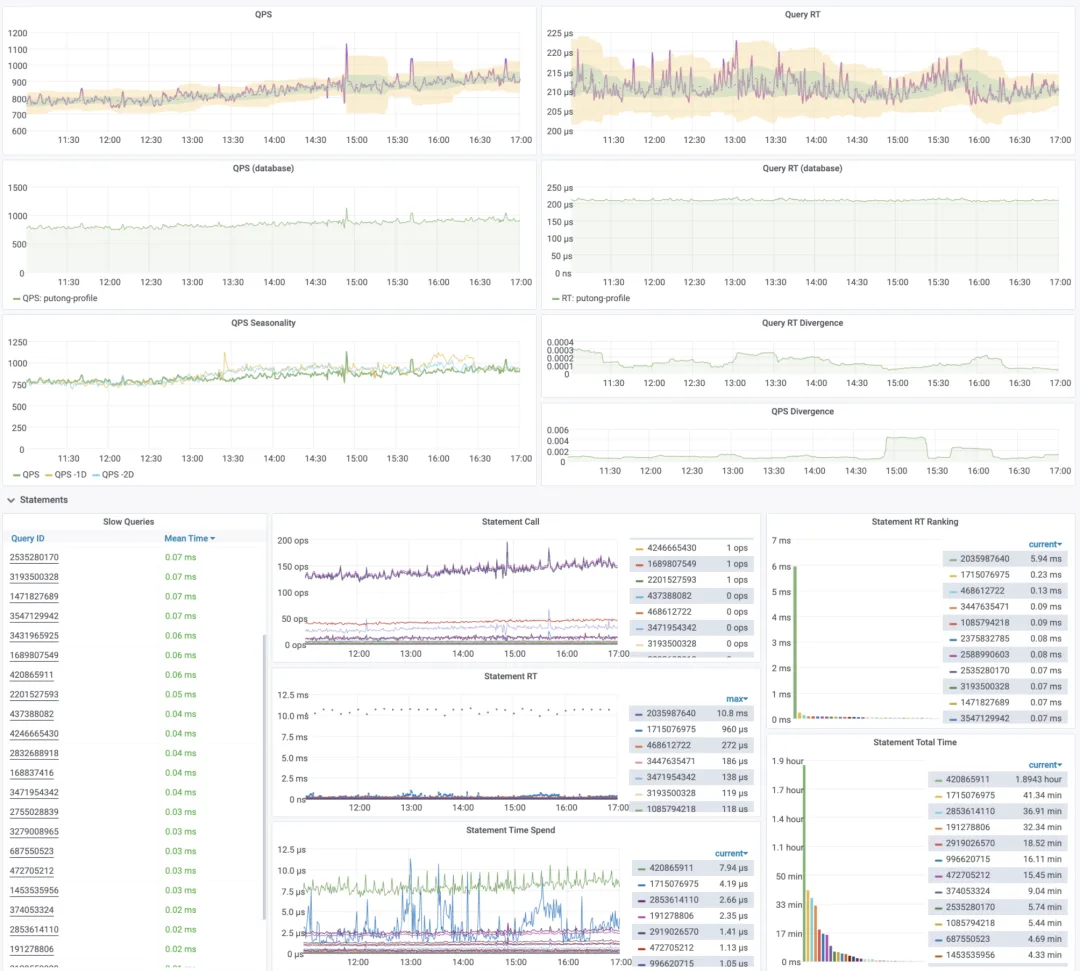
语句
语句区域按归一化查询展示指标。去除常量后具有相同解析结构的语句归入同一类查询,并以查询 ID 标识。慢查询视图提供对应的 SQL 和统计数据。
- 左侧列表按
pg_stat_statements的平均响应时间降序排列。点击查询 ID 打开详情。 - 候选列表选取累计执行时间最长的 32 条查询,排除监控查询和只有零星调用的长查询。
- 右侧显示各查询的实时 QPS、平均响应时间,以及按响应时间和累计耗时的排名。
后端进程
后端指标描述 PostgreSQL 连接。按不同维度分组,有助于排查连接突增、慢查询与等待问题。
- 按后端类型、状态、数据库与等待事件类型统计数量。
- 活跃连接、
idle in transaction连接与长事务。
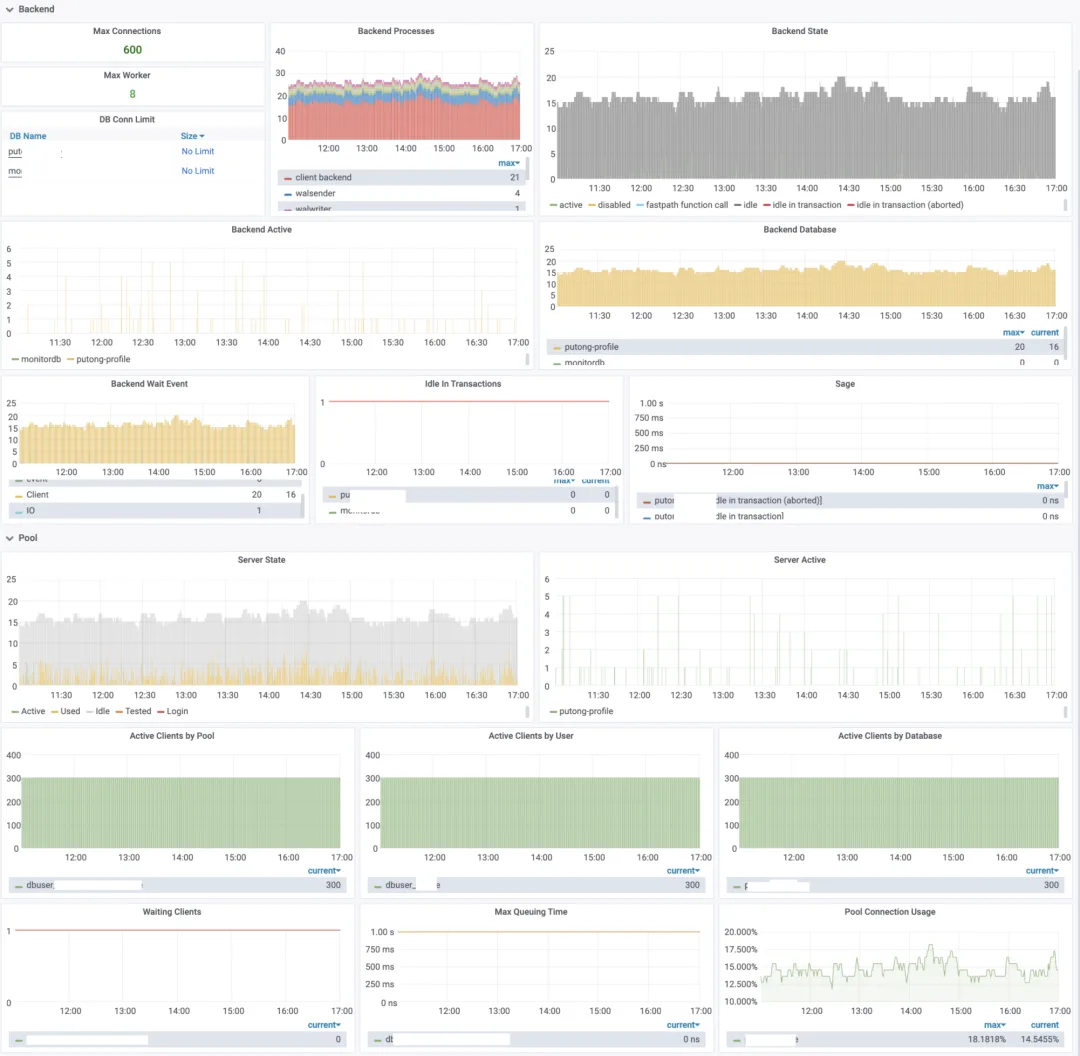
连接池
这一部分的指标来自 PgBouncer:
- 后端连接状态:活跃、刚用过、空闲、已测试、登录中。
- 按用户、数据库与连接池(
user:database)统计的前端连接数。 - 等待客户端数量与队首客户端的等待时间,用于判断连接是否积压。
- 可用池连接的使用比例。
数据库概览
这一部分主要使用 pg_stat_database 与 pg_database,并展示 WAL 指标:
- 每秒生成的 WAL 字节数,反映写入活动。
- shared buffers 命中率。未命中的请求可能由操作系统文件缓存或存储设备处理。
- 每秒读取、插入、更新与删除的行数。
- 临时文件数量与大小,用于分析大查询的影响。
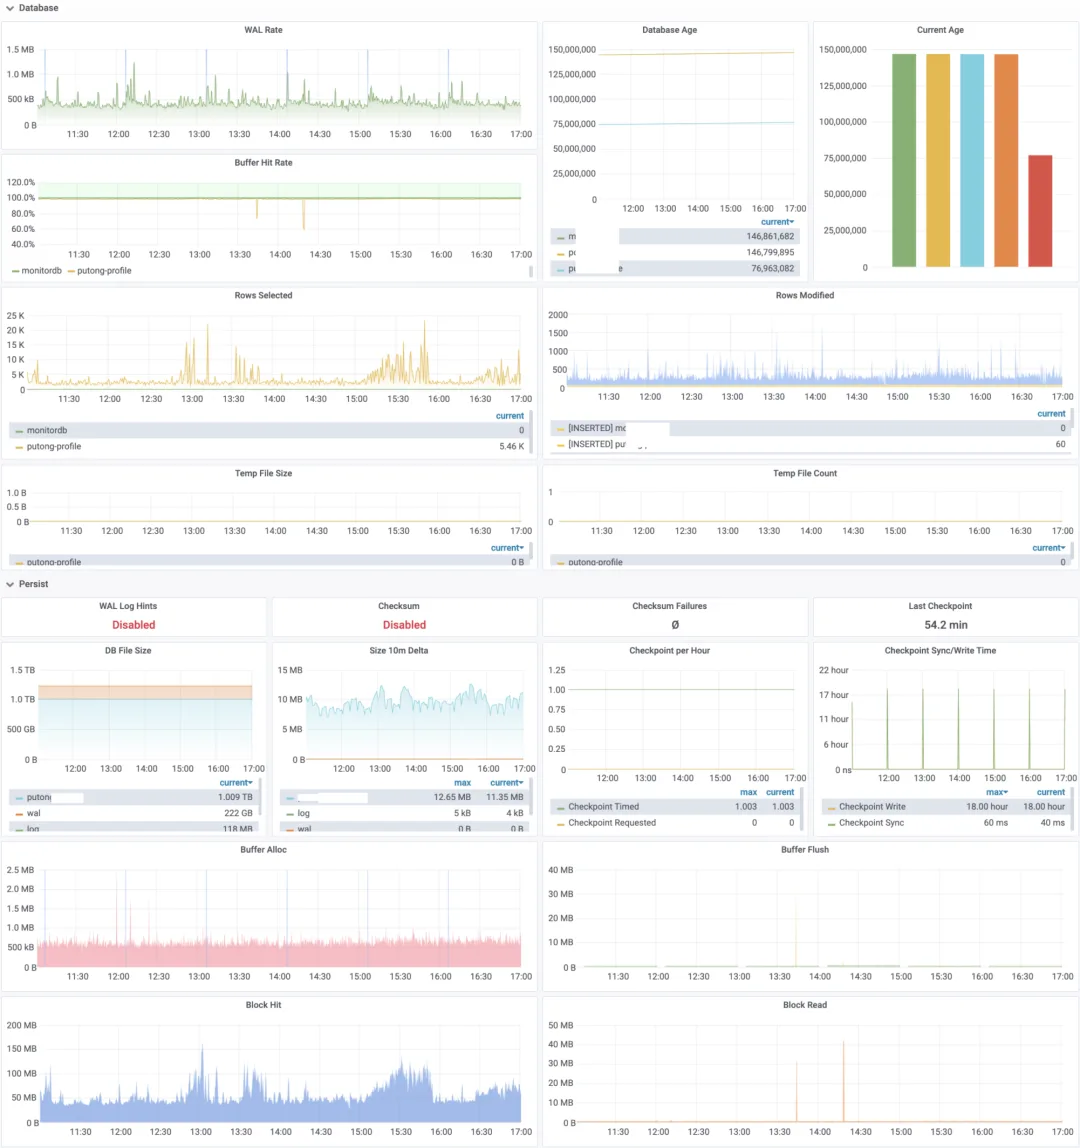
持久化
持久化指标包括写入、检查点与块访问:
- 关键持久化配置,以及启用数据校验和后的校验失败情况。
- 数据库文件、WAL 与日志的大小及增速。
- 检查点次数与耗时。
- 每秒分配、写出、访问和从存储读取的块数,以及对应字节量。本部署的 PostgreSQL 页面为 8192 字节,文件系统块为 4096 字节。
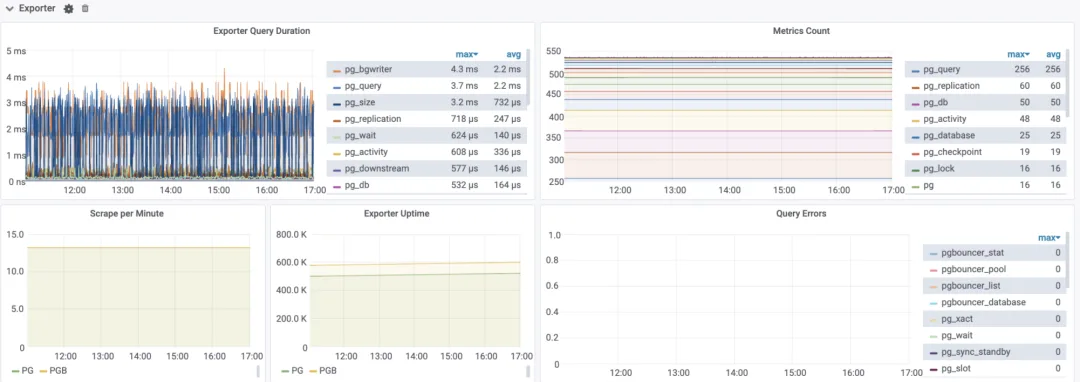
Exporter
这一部分监控 Exporter 自身:
- 存活状态、运行时长与每分钟被抓取的次数。
- 每条监控查询的耗时、输出指标数与错误数。
PostgreSQL 集群监控
我最常使用集群面板。这套部署以集群为单位提供数据库服务,因此把各实例和服务的指标放在一起,更方便检查服务状态。
多数图表沿用实例面板的指标,增加实例间的对比,以及集群和服务层面的汇总。
集群概览
相对实例概览,集群概览增加了:
- 时间线与主库身份。故障切换或主动切换会更换主库,并推进时间线。
- 复制拓扑,以及同步或异步复制方式。
- 集群实时负载与 1、5、15 分钟平均负载,以及各节点的 1 分钟平均负载。
- 集群告警与事件。
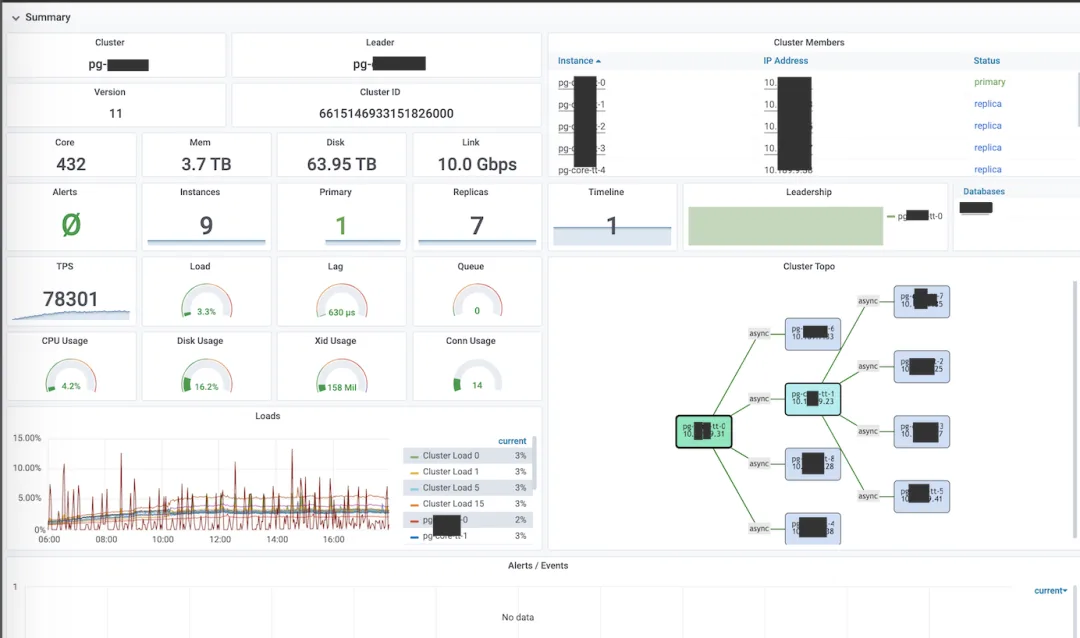
集群复制
集群面板汇总了整个复制拓扑,包括:
- 主库与级联复制节点、同步提交配置、同步从库名称、下游节点数量与从库数量上限配置。
- 每条复制链路成对出现的 WAL sender 与 WAL receiver。
- 以秒和字节衡量的复制延迟,以及复制槽保留的 WAL 量。例如,WAL 写入速率为 10–100 MB/s 时,1 秒延迟约对应 10–100 MB WAL。
- 从库视角的复制延迟。
- 从库数量,用于检查备份或初始化从库时的拓扑变化。
- 全集群的 LSN,反映复制进度与持久化状态。
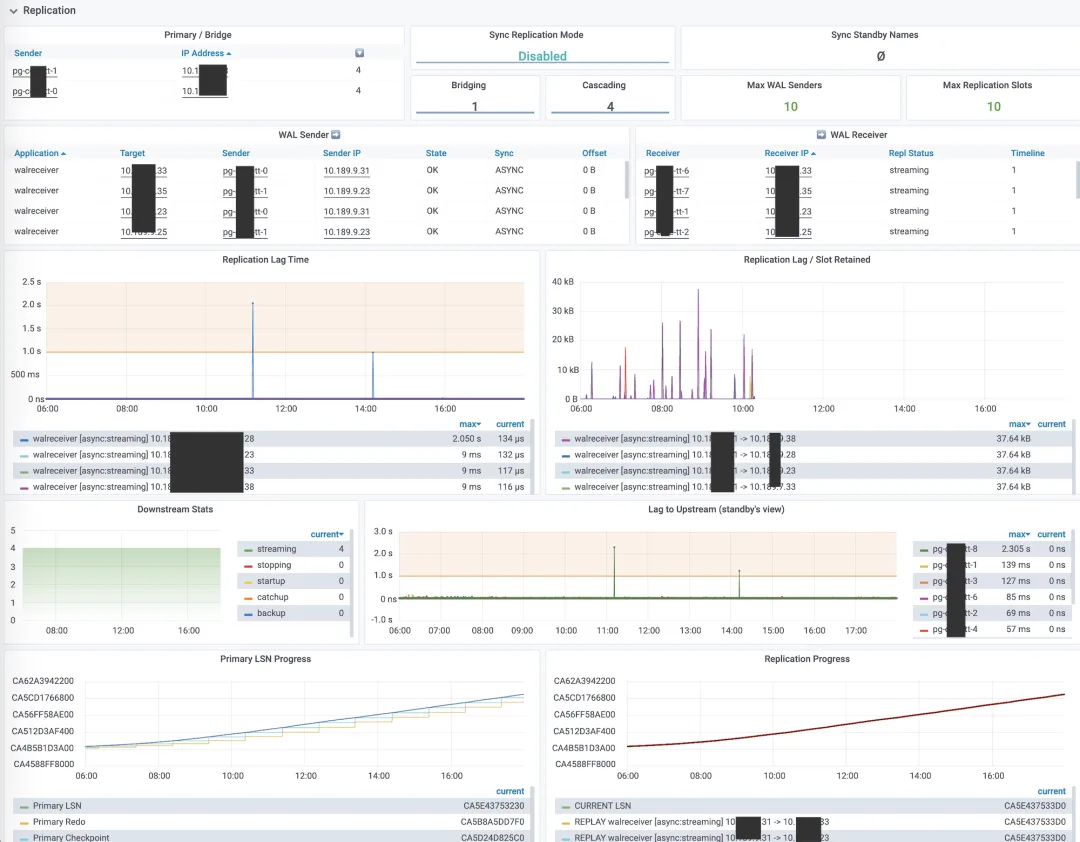
节点指标
主机指标按 PostgreSQL 集群组织。
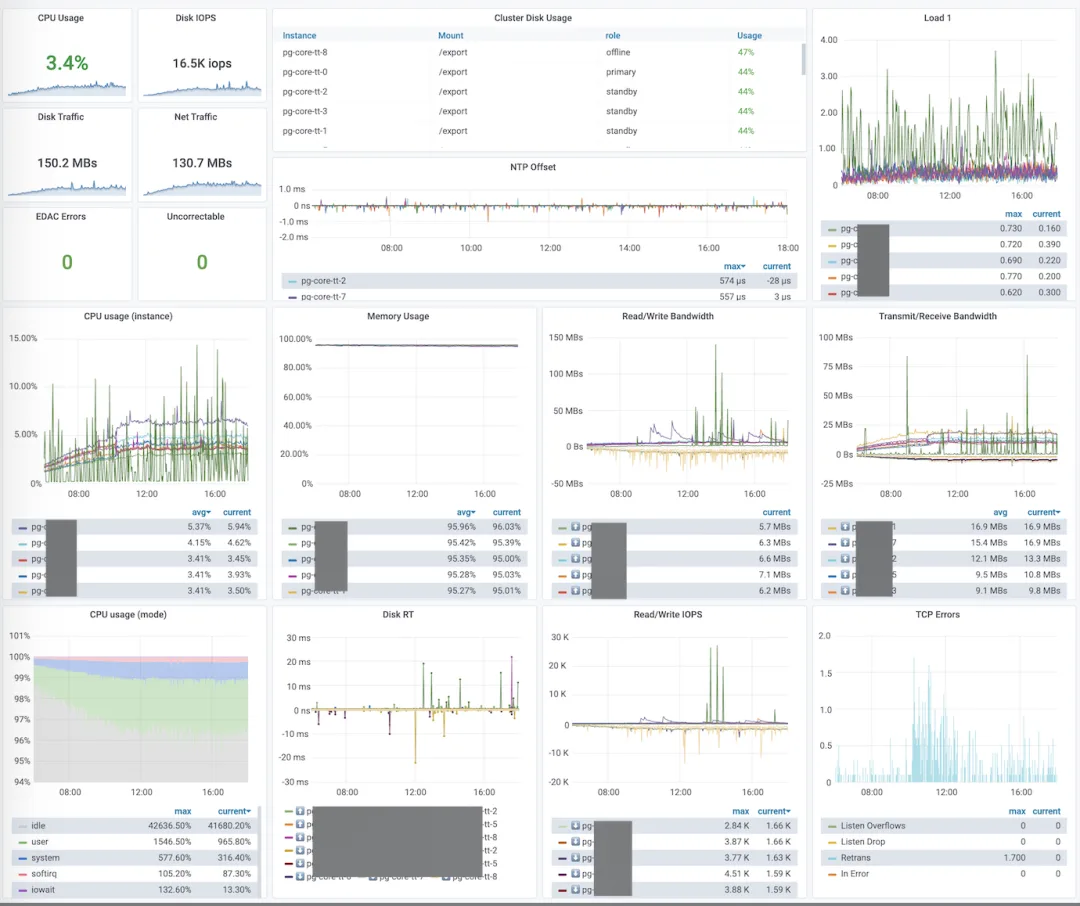
事务与查询
图表与实例视图相似,增加了服务层面的汇总。本部署通常为每个集群提供 primary 与 standby 两种服务。
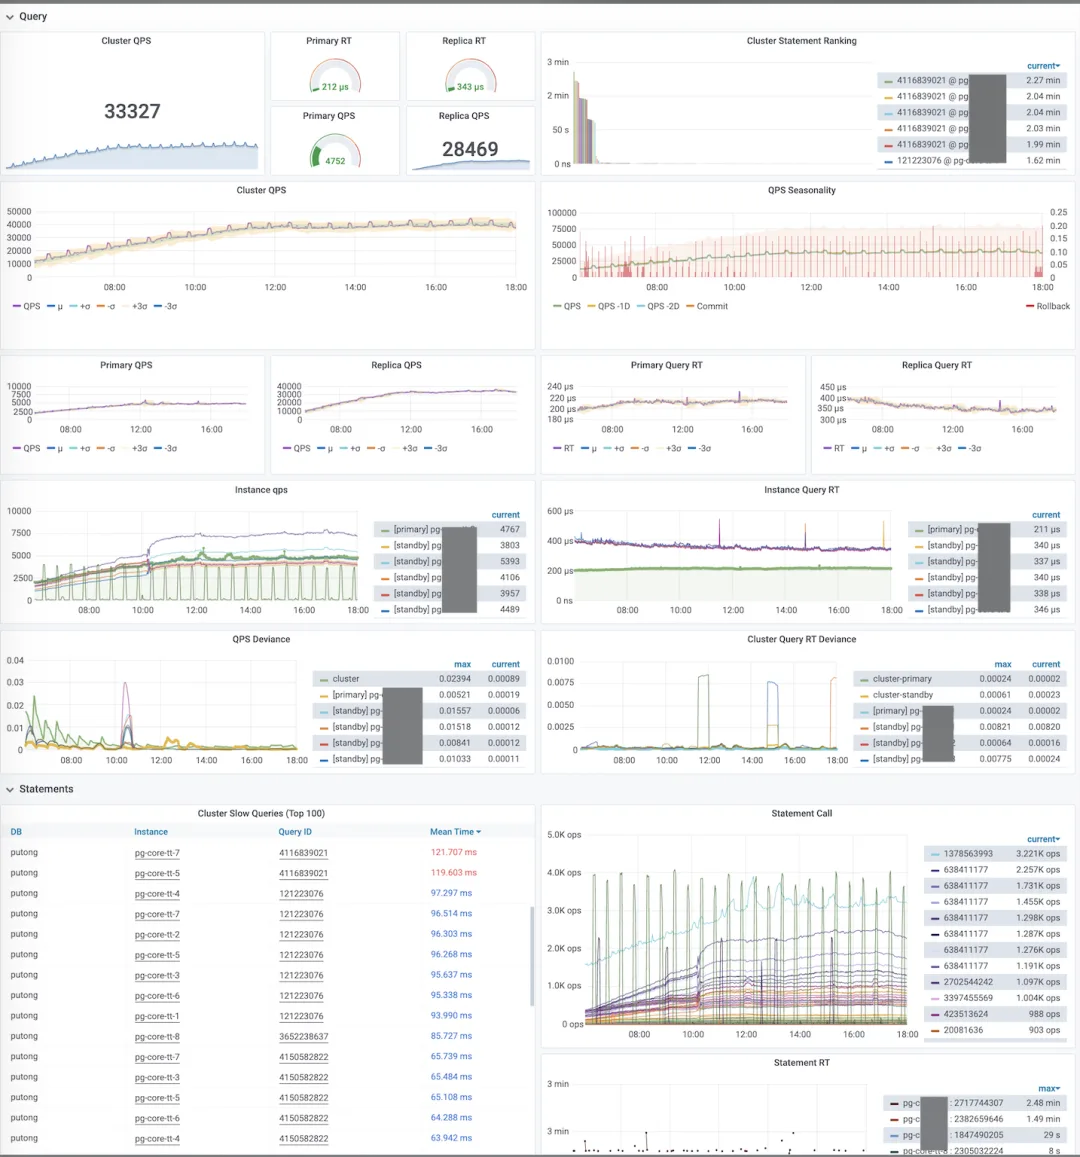
其他指标与实例面板相近。
慢查询分析
慢查询视图上方显示实例的查询概览。将鼠标移到查询 ID 上可以查看 SQL,点击 ID 打开 Query Detail。
详情左侧是格式化的 SQL,右侧显示:
- 每秒查询数。
- 当前平均响应时间。
- 每次调用平均返回的行数。
- 每次调用平均块 I/O 耗时。
- 统计周期内响应时间的均值、标准差、最小值与最大值。
- 过去一天的调用次数、返回行数与执行时间,以及自统计重置以来的总调用次数。
下方图表显示所选时间范围内的指标变化。
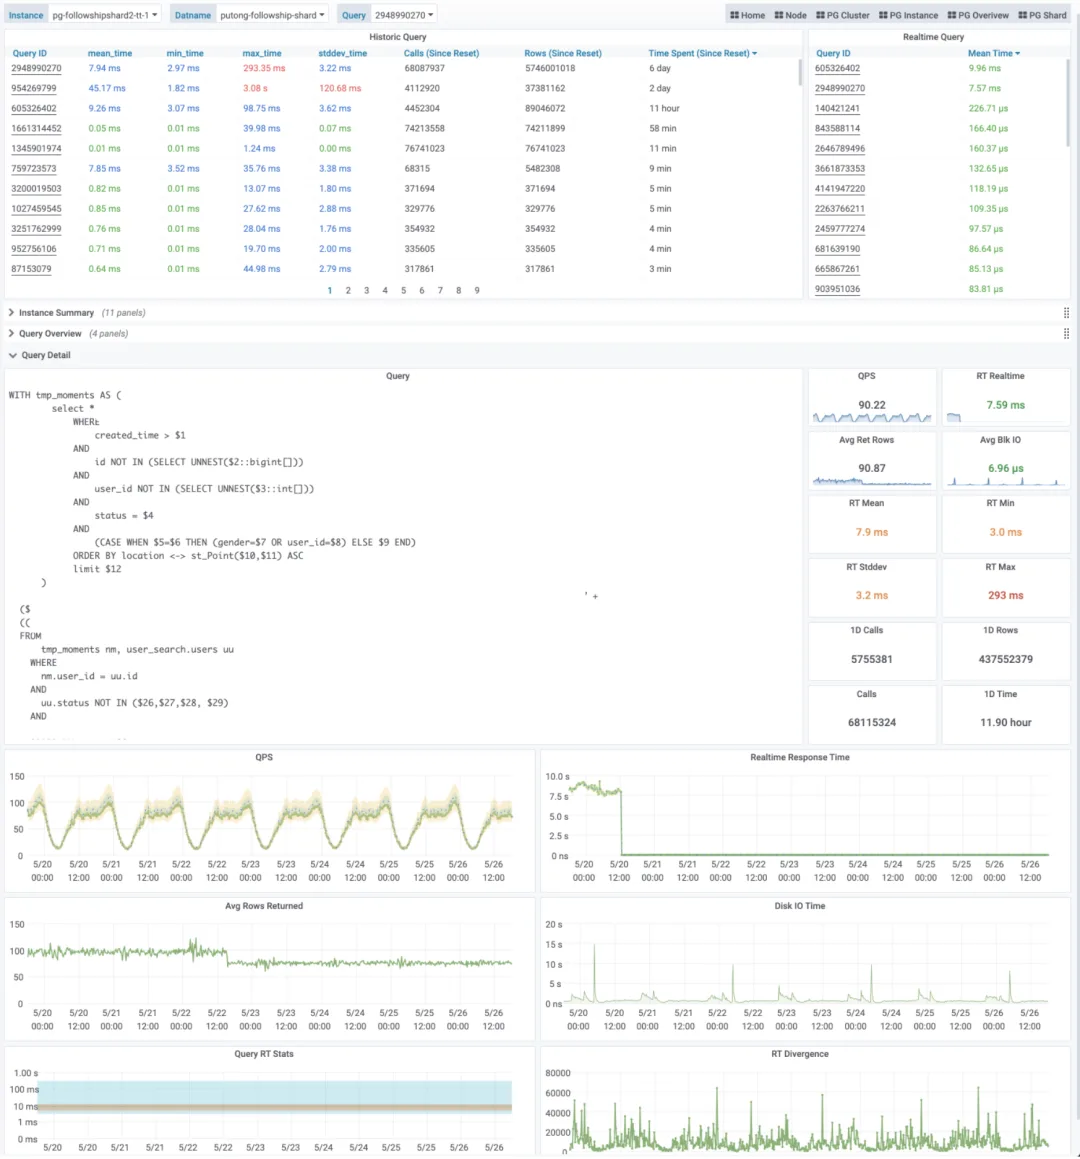
9 - PostgreSQL的KPI
本文写于 2020 年,从 PgBouncer 事务耗时推导负载指标。
PG Load(PG 负载) 将每秒累积的事务耗时除以选定的并发数,同时考虑数据库处理的工作量与耗时。我用它观察负载变化,识别需要排查问题或重新评估容量的实例。
现有指标能说明什么
评估数据库负载,通常需要观察几类指标:
- 流量:每秒查询数(QPS)和每秒事务数(TPS)。
- 延迟:查询响应时间(Query RT)和事务响应时间(Xact RT)。
- 资源使用:机器负载、CPU 利用率、磁盘 I/O 和网络 I/O。
- 故障与争用:错误,以及等待数据库连接的客户端。
每类指标回答的问题不同。错误反映故障,连接池队列增长反映连接争用,但两者都不能单独衡量剩余容量。队列较短时仍可能存在资源瓶颈;队列较长也可能是连接池上限过小。
CPU 和 I/O 指标反映主机压力。当这些资源成为瓶颈时,它们有助于解释数据库性能。但锁或被占用的连接也可能限制数据库工作,此时 CPU 利用率未必很高。因此,还需要数据库自身的指标,与主机指标对照。
QPS 和 TPS 衡量完成的工作量,不衡量每次调用的成本。耗时 10 微秒和 10 秒的查询都只算一次调用。应结合查询类型、延迟和资源使用情况比较吞吐量,并通过压测为已知工作负载建立基线。
RT 衡量服务质量。例如,某类 OLTP 服务可能要求 1 ms 的响应时间。延迟上升可能表示资源争用,但不能单独用于测量饱和度。平均值也可能掩盖慢请求;有耗时分布数据时,P99、P99.9 有助于观察尾部延迟。
PG Load 将事务数量与耗时结合起来,衡量并发工作量。它的推导可以从两个熟悉的主机指标开始:平均负载和 CPU 利用率。
推导 PG Load
Linux 平均负载
top 的第一行显示最近 1、5、15 分钟的平均负载:
Linux 平均负载统计可运行任务和不可中断睡眠任务,后者常在等待 I/O。对单核 CPU 密集型负载,接近 1 表示 CPU 需求接近满载,大于 1 意味着排队。在 n 核上,对应的参考值是 n。除以核数,就能得到用于比较的归一化值。
对于 CPU 密集型负载,可将每核 0.7 和 1.0 作为预警与调查阈值的参考,再根据工作负载调整。不可中断等待也会抬高负载,因此需要结合 CPU 和 I/O 指标判断;它不是 CPU 利用率百分比。
CPU 利用率
单个 CPU 核的利用率可以通过累积空闲时间计算:
node_cpu_seconds_total{mode="idle"} 统计累积空闲秒数。irate 用最近两个采样点计算每秒空闲时长,用 1 减去这个比例,就得到 CPU 核处于忙碌状态的时间占比。对于多核 CPU,对各核利用率求平均即可。
可以用类似的方式衡量 PostgreSQL 后端:计算它处于活跃状态的时间占比。平均负载则给出了扩展到多个后端的思路:累加它们的活跃时长,再按并发数归一化。
从后端时间到数据库负载
先以 1 秒为统计窗口,按可用后端数归一化:
| 场景 | 计算 | 结果 |
|---|---|---|
| 一个后端执行查询 0.6 秒 | 0.6 / 1 / 1 |
60% |
| 两个可用后端分别执行 0.6 秒、0.8 秒 | (0.6 + 0.8) / 1 / 2 |
70% |
| 一个后端执行查询 0.6 秒,事务内空闲 0.2 秒,按事务时间统计 | (0.6 + 0.2) / 1 / 1 |
80% |
第三个例子涉及一个选择:只统计查询执行,还是统计整个事务,包括语句之间的空闲时间?本文采用事务耗时,下文会解释原因。客户端等待后端的时间另行统计,不计入这里的事务耗时。
统计窗口更长或后端更多时,计算方式不变:
pg_load = pg_active_seconds / time_period / parallel
pg_active_seconds是统计窗口内,所观测后端的活跃秒数之和。time_period是统计窗口的秒数。parallel是用于归一化的并发数。
0 表示没有观测到活动;100% 表示每单位选定并发能力,在每秒内累计了一秒活跃时间。这个值本身并不表示容量上限。
如果活跃秒数以累积计数器提供,就使用它的增长速率:
rate(pg_active_seconds[time_period]) / parallel
接下来需要确定如何统计活跃时间,以及用什么并发数归一化。
计算 PG Load
统计查询时间还是事务时间?
对于自动提交事务中的单条查询,查询耗时和事务耗时接近。对于包含多条语句的事务,两者可能相差很大。上面的例子有 0.6 秒查询执行和 0.2 秒 idle in transaction:按查询时间统计得到 60%,按事务时间统计得到 80%。
查询时间衡量执行过程,事务时间衡量后端被事务占用多久。空闲事务可能很少消耗 CPU,但仍占用连接,也可能保留锁或快照。这里采用事务时间,将这种占用也计入负载。
获取累积事务耗时
pg_stat_activity 显示 PostgreSQL 后端的当前状态。反复采样可以估算一段时间内有多少后端活跃,但这个视图本身是状态快照,不是累积耗时计数器。
PgBouncer 提供了计算所需的计数器。它的 SHOW STATS 命令按数据库返回统计信息,包括:
total_xact_count:完成的事务数。total_query_count:执行的查询数。total_xact_time:累积事务耗时。total_query_time:累积查询耗时。
原始时间计数器使用微秒。下文使用的导出序列 pgbouncer_stat_total_xact_time 已经转换为秒。参见 PgBouncer 统计说明。
对该计数器应用 rate,得到最近 1、5、15 分钟内的每秒事务耗时。irate 则使用最近两个采样点,反映最近一个采样间隔的情况。再用 sum without (datname) 对各数据库求和,得到实例级指标:
结果估算了并发事务工作量。一个后端持续被事务占用,每秒就贡献一秒事务时间;64 个这样的后端,每秒贡献 64 秒。这个值可以用于比较同一实例的不同时段,比较不同规格的实例则还需要归一化。
按 CPU 核数归一化
这种方法使用 CPU 核数作为并发参考,适合 CPU 密集型负载,但不是 PostgreSQL 并发能力的实测上限。连接限制、并行工作进程、锁等待和 I/O 也会影响实例能承受的工作量。
在 64 核主机上,64 个后端持续被事务占用,负载为 64 / 64 = 100%;128 个这样的后端,负载为 128 / 64 = 200%。
将每秒事务耗时除以 CPU 核数,就得到 PG Load 序列:
与吞吐量、延迟的关系
每秒活跃时长也可以近似表示为 TPS × 平均事务 RT,或 QPS × 平均查询 RT。两者应使用相同的统计窗口,RT 的单位为秒。例如,每秒 1,000 次查询,每次耗时 1 ms,累积查询时间就是每秒 1000 × 0.001 = 1 秒。
采用事务时间并按 CPU 核数归一化后,得到:
tps * xact_rt / cpu_count
TPS 不包含每个事务的成本,RT 不包含事务数量,两者相乘则同时考虑了这两点。上面的记录规则直接从耗时计数器获取这种累积工作量。
使用 PG Load
告警:慢查询占满连接池
下图是一次生产事故。某次应用变更引入了慢查询,慢查询占用了连接池,请求随之堆积。PG Load 和 RT 都明显上升,TPS 的下降则不太显眼。这次事故后,我们将 PG Load1 和 PG Load0 纳入了告警规则。
本文以 50% 预警线和 70% 告警线为例,具体阈值应根据工作负载基线和响应时间目标设定。达到 500% 意味着累积事务耗时是按 CPU 核数归一化后参考值的五倍;延迟、队列长度和等待指标有助于定位原因。
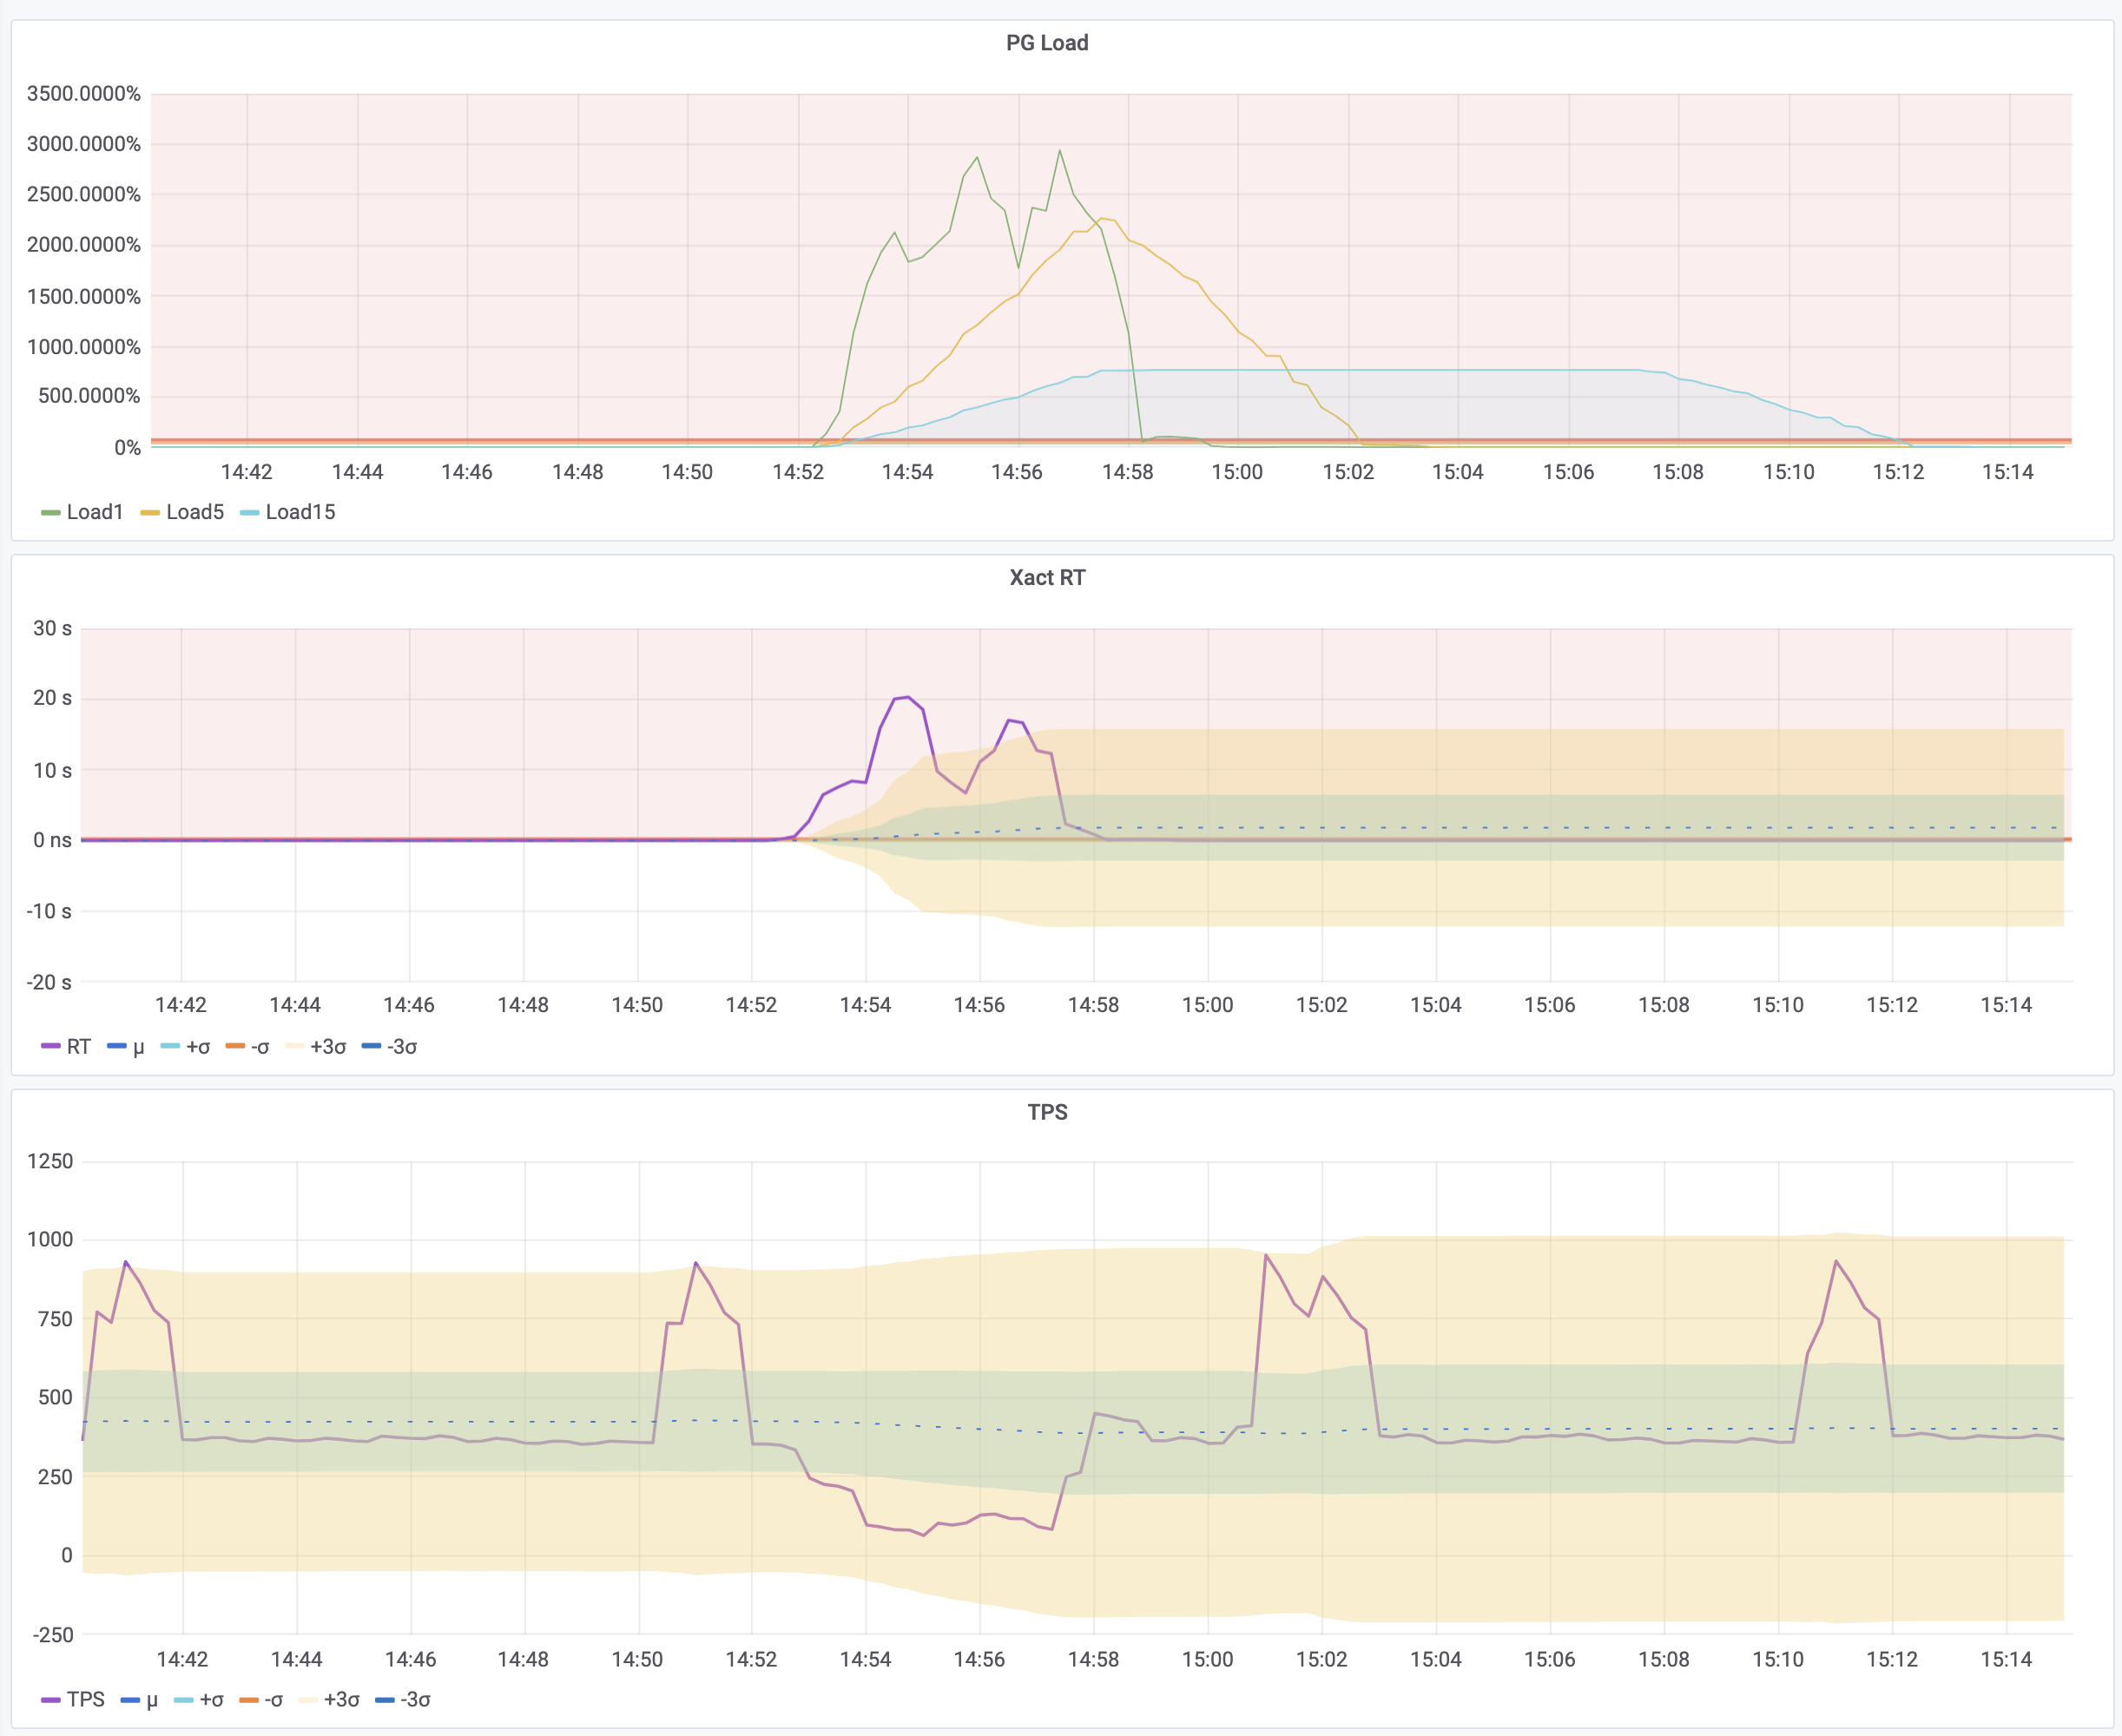
容量评估
规划容量时,将集群 15 分钟 PG Load 的均值与峰值,同历史基线、响应时间目标和预期增长比较。由此识别需要进一步评估容量、查询成本或资源限制的集群。
同时对照 CPU 利用率。事务计数器不直接包含主机其他任务消耗的 CPU 时间,但备份和维护仍可能通过资源争用增加事务耗时,其影响也就会反映在 PG Load 上。
可将长期处于 30%~50% 作为评估容量的参考起点。是否扩容,还取决于峰值需求和该工作负载所需的余量。
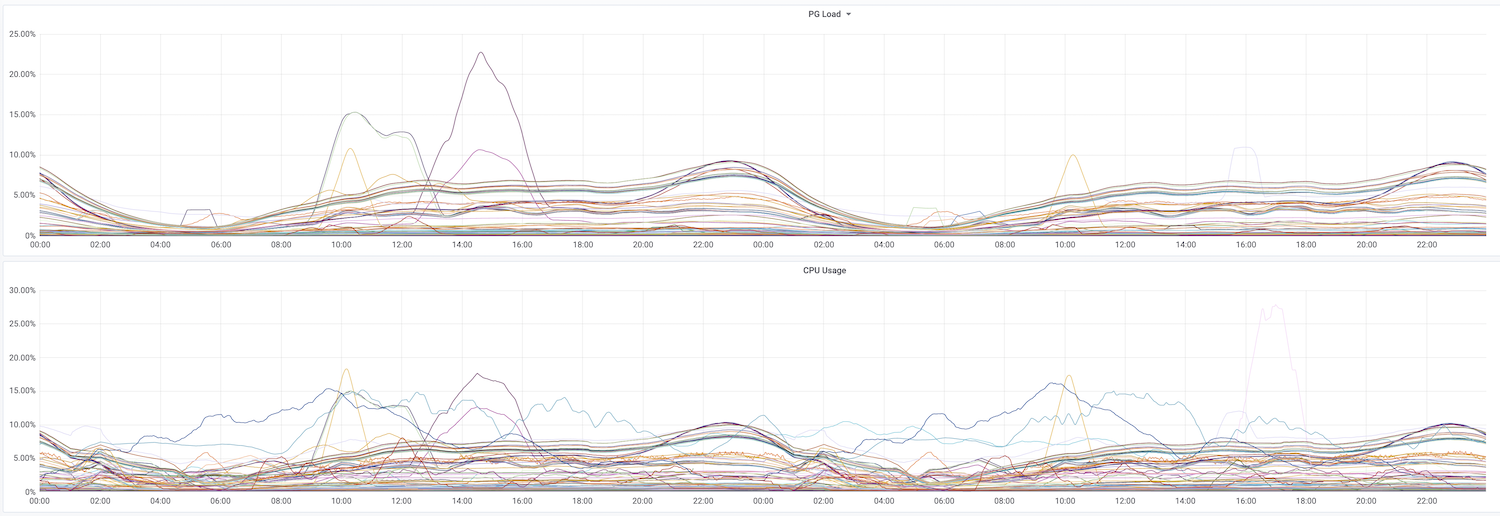
10 - PostgreSQL 监控系统概览
本文记录 2018 年 12 月的监控系统,面板与统计收集器机制对应当时版本。
用监控管理 PostgreSQL
管理 PostgreSQL 需要了解数据库的运行状态。监控系统集中展示这些信息,为日常检查、故障诊断与性能优化提供依据。我计划通过一系列文章,介绍这套监控系统的设计、实施与使用。
PostgreSQL 监控面板
下面是我在实际环境中使用的监控面板。最常用的单实例面板分为七个区域:概览、操作系统、数据库活动与会话、复制、检查点与 WAL、数据库冲突、数据库对象统计。
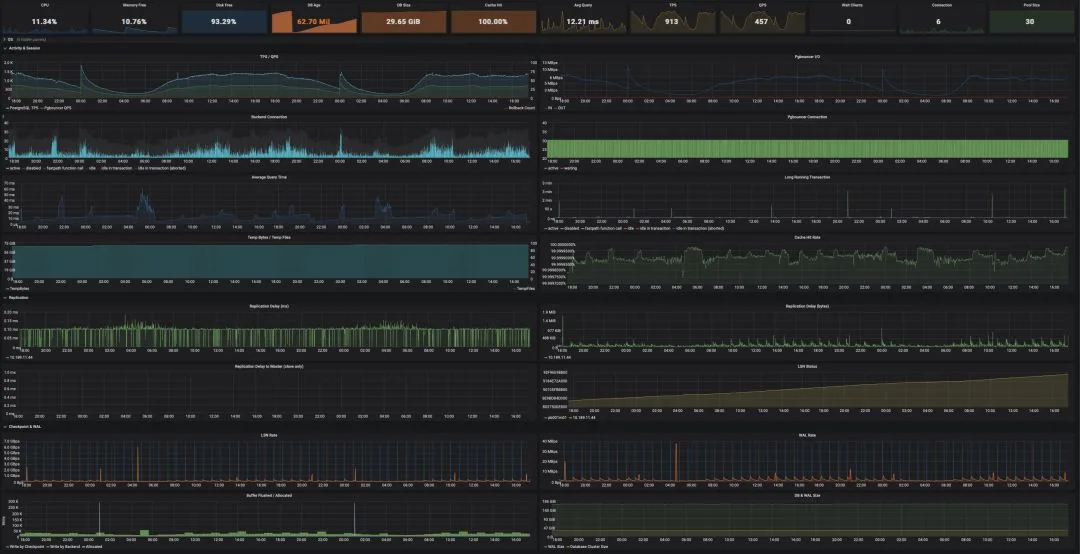
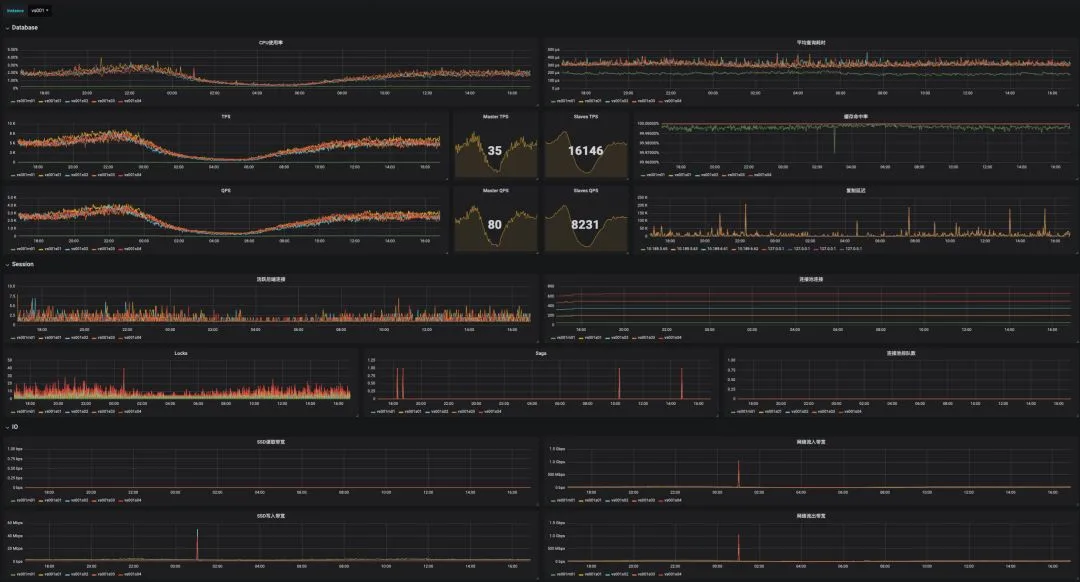
系统架构
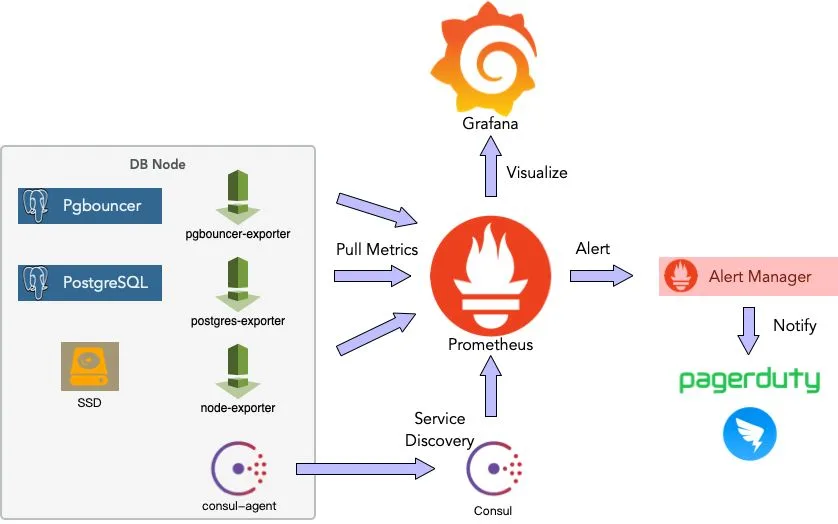
这套系统使用 Prometheus、Grafana、Consul 与各类 Exporter。
Exporter 从数据库、连接池与主机获取指标。Prometheus 通过 Consul 发现 Exporter,再抓取并保存指标。Grafana 展示数据,Alertmanager 处理告警通知。
监控指标
选择指标时,需要明确它回答什么问题、数据来自哪里、数值变化意味着什么。这些信息决定了如何解读图表,也可以指导命令行排查。下面按单实例面板的区域介绍主要指标。
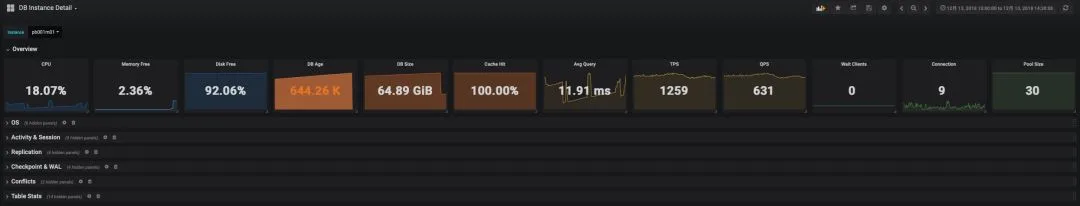
概览
概览用于缩小排查范围,包含以下指标:
- CPU 使用率、平均查询时间、TPS、QPS、连接池排队数与活跃连接数:了解负载水平。
- 内存空闲率:识别可能导致进程被终止的内存压力。
- 磁盘空闲率:检查存储空间是否接近用尽。
- 数据库年龄:评估距离事务 ID 回卷限制还有多远。
- 数据库大小与缓存命中率:观察数据规模和访问模式的变化。
操作系统
操作系统指标包括:
- CPU 使用率与系统负载。
- 内存使用量,特别是操作系统缓存的变化。
- 网络与磁盘吞吐量,以及磁盘 IOPS。
将这些指标与数据库活动放在一起,可以判断资源压力来自哪里,并为硬件故障排查提供线索。
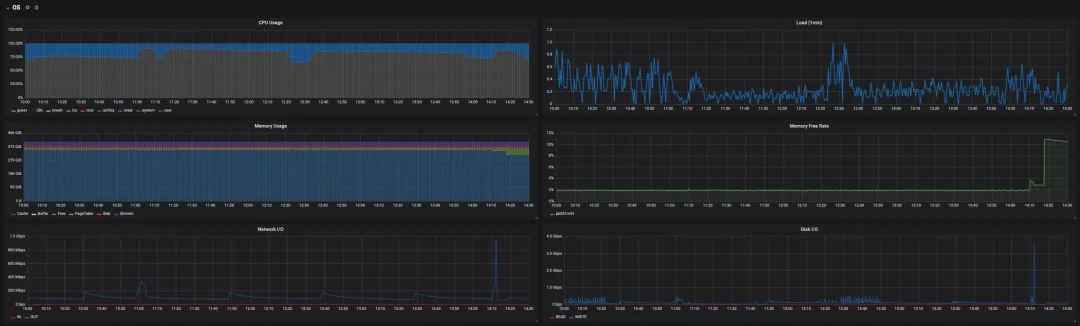
数据库活动与会话
这些指标描述数据库当前的工作负载:
- TPS、QPS 与平均响应时间:请求量和延迟。
- 缓存命中率:这里只统计 PostgreSQL 的 shared buffers,不包含操作系统文件缓存。
- 各状态的连接数:
active连接反映执行中的工作;idle in transaction连接则需要检查事务为何未结束。 - 临时文件数量与大小:复杂查询或大查询可能产生临时文件,大量临时文件 I/O 会影响性能。
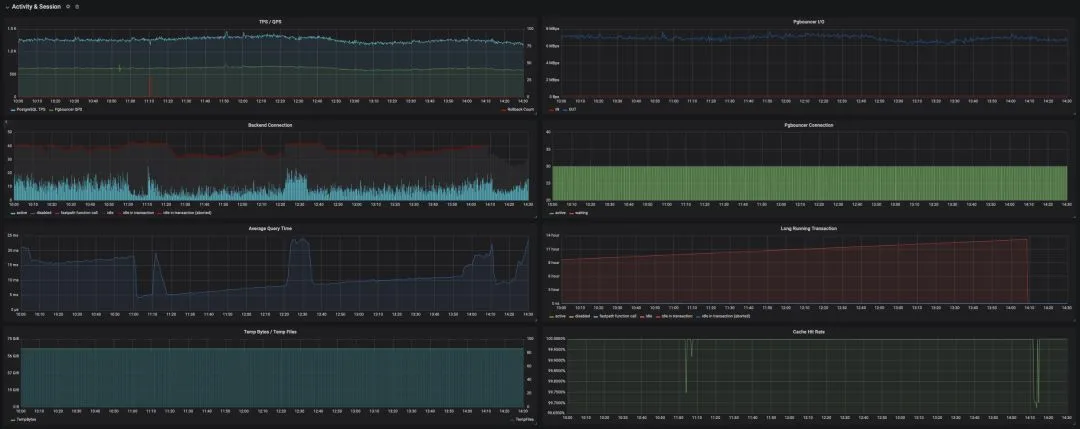
复制
复制延迟有助于判断从库的数据新鲜度,也为复制故障排查提供线索。
主库可以报告从库落后的 WAL 字节数;从 PostgreSQL 10 起,还提供复制延迟时间。从库上可以用最后重放事务的时间估算滞后,但主库空闲时该值也会增长,不能直接等同于实际复制延迟。
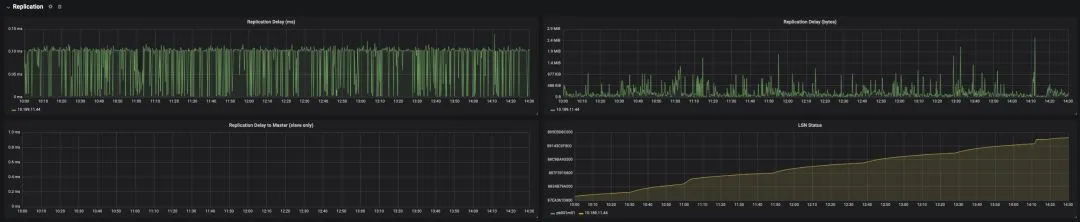
检查点与 WAL
检查点写出脏页,会消耗磁盘 I/O。启用 full_page_writes 后,检查点之后对页面的首次修改还会把完整页面映像写入 WAL,增加磁盘与网络流量。排查写入压力时,可以观察:
- WAL 生成速率。
- LSN 增长速度。
- 检查点与后端进程写出的缓冲区数量。如果后端进程承担大量写出工作,需要检查检查点和后台写入相关配置。
- 数据库与 WAL 的大小。
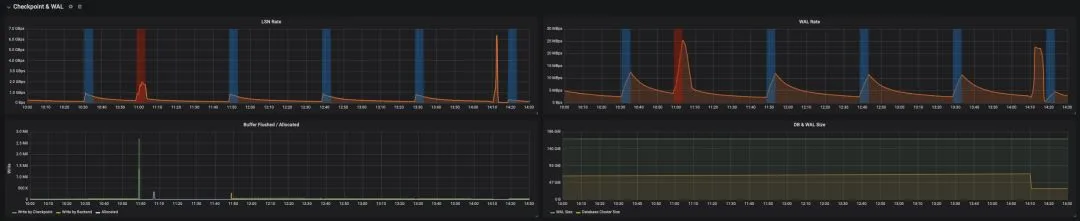
锁与数据库冲突
按类型统计锁,可以了解数据库正在进行的操作,并为锁冲突排查提供线索。
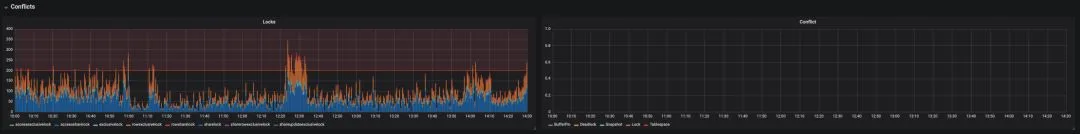
对象级统计
对象级统计用于进一步定位问题:
- 每张表的索引扫描与顺序扫描次数。大表上频繁出现顺序扫描时,结合查询计划检查索引是否适用。
- 元组读写数量、表大小与表年龄。
- 死元组比例:反映清理需求,可辅助排查膨胀,但不等于物理膨胀率。也可以使用统计数据估算表膨胀率。
- 函数调用次数与执行时间。
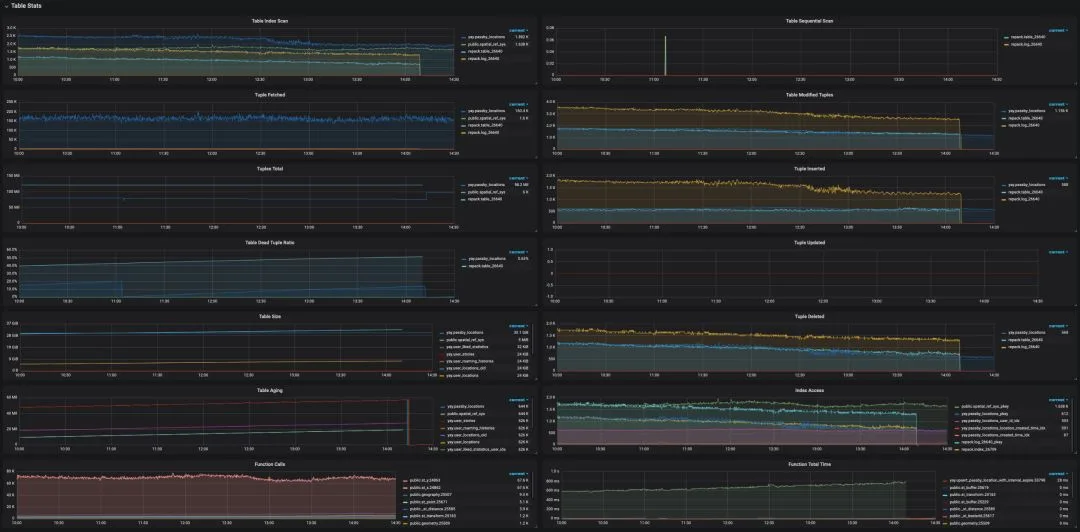
指标来源
统计收集器
本文涉及的 PostgreSQL 版本通过内置统计收集器提供许多监控指标。系统视图以 SQL 接口暴露这些数据,具体定义见 PostgreSQL 文档。下面列出了一些常用视图。
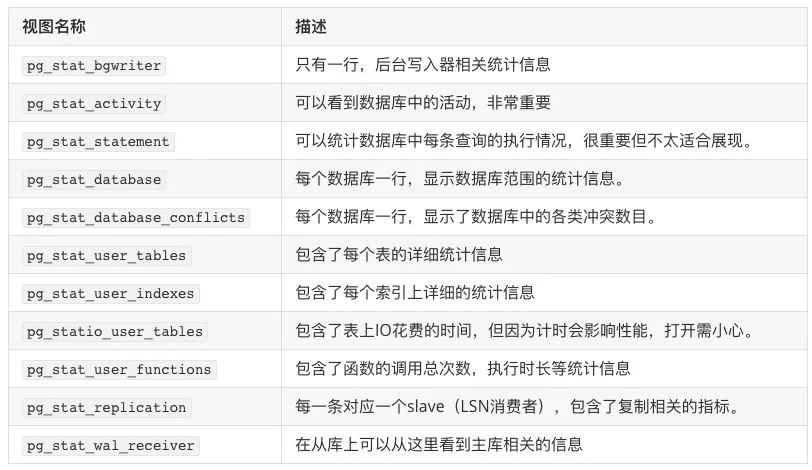
PostgreSQL 11 统计文档说明了统计数据的更新与快照机制:
- 后端进程在进入空闲前报告累计计数,仍在执行的工作尚未完整反映在累计统计中。
- 收集器生成新报告的间隔至少为
PGSTAT_STAT_INTERVAL,默认 500 毫秒。由track_activities控制的当前活动使用另一套机制。 - 同一事务中的统计查询会复用快照。调用
pg_stat_clear_snapshot()清除快照后,下次查询可以取得新快照。 - 在
postgresql.conf中启用所需的track_*选项。
这些规则属于旧版统计收集进程。PostgreSQL 15 改用共享内存保存累计统计;解释更新与快照行为时,使用对应服务器版本的文档。
系统目录与其他视图
其他系统目录和视图也提供监控数据。例如,pg_database 包含计算数据库年龄所需的元数据,pg_locks 提供锁和锁等待信息。数据库大小等指标则由内置函数提供。
后续内容
本文介绍了监控系统的架构和主要指标。后续文章将继续说明具体实现,以及如何用这些指标排查问题。
11 - 关系膨胀的监控与治理
本文写于 2018 年,介绍当时基于统计信息估算膨胀及安排维护的方法。
PostgreSQL 使用 MVCC,让事务读取不同的行版本。旧版本可能使表和索引占用的空间超过活数据所需。日常清理让空间可以复用,重写关系则能将多余空间归还文件系统。本文介绍如何衡量膨胀,并选择重整时机。
关系膨胀概述
若一个关系占用 100 GB,压实后的副本只需 60 GB,则估算膨胀率为 (100 - 60) / 100 = 40%。
普通 VACUUM 会回收死元组占用的空间,让表内后续写入复用,也可能截断文件末尾的空页。它不会跨整张表压紧活元组,因此活页之间的空闲空间通常仍留在关系文件中。
VACUUM FULL 将活元组复制到新文件中,把表压实。操作期间持有 AccessExclusiveLock,阻塞读写。pg_repack 允许大部分读写继续进行,但在初始化和最终切换时仍需短暂获取排他锁。
先测量膨胀程度,再选择需要重写的关系。根据负载、可用磁盘和维护窗口设定处理阈值与时间。
关系膨胀的度量
用 1 - 紧实大小 / 实际大小 估算膨胀率。紧实大小包括活元组,以及必需的页面、元组和对齐开销。
PostgreSQL 可以提供关系的实际大小。下一步是测量或估算活元组所需的空间。
测量元组与空闲空间
pgstattuple 扫描关系,报告活元组、死元组和空闲空间。tuple_percent 的范围是 0–100,所以 1 - tuple_percent / 100 才是活元组以外空间的比例,其中还包含必需的存储开销。下方样例将其命名为 bloat,但它不等于重写后能回收的精确比例。
字段定义见 PostgreSQL 10 的 pgstattuple 文档。B-tree 索引还可以使用该扩展中的 pgstatindex 函数。
另外两个随 PostgreSQL 提供的扩展可用于检查关系存储:
- pg_freespacemap:查看各页记录的空闲空间。
- pageinspect:读取单个页面的内容。
日常监控通常用估算值筛选需要进一步检查的关系。精确测量活元组需要扫描整个关系,对大量表重复扫描会增加 I/O 开销。
PostgreSQL 9.5 在 pgstattuple 扩展中加入了 pgstattuple_approx 函数,通过估算部分数值减少扫描量。实际开销取决于需要读取多少页面。
频繁监控大量表时,使用基于统计信息的估算;需要精确测量时,再扫描选定的关系。
膨胀率的估算
估算使用表和列统计中的三个值:
- 元组的平均宽度
avgwidth:从列级统计数据计算而来,用于估计紧实状态占用的空间。 - 元组数:
pg_class.reltuples:用于估计紧实状态占用的空间 - 页面数:
pg_class.relpages:用于测算实际使用的空间
估算公式为:
这里 block_size 是页面大小,默认为8192,pageheader 是首部占用的大小,默认为24字节。页面大小减去首部大小就是可以用于元组存储的实际空间,因此 (reltuples * avgwidth) 给出了元组的估计总大小,而除以前者后,就可以得到预计需要多少个页面才能紧实地存下所有的元组。最后,期待使用的页面数量,除以实际使用的页面数量,就是 利用率,而1减去利用率,就是膨胀率。
难点
估算元组平均长度时,需要考虑:
- 当元组中存在空值时,首部会带有空值位图。
- 首部与数据部分存在Padding,需要考虑边界对齐。
- 一些字段类型也存在对齐要求
计算元组的平均长度
下图展示 PostgreSQL 的元组布局,用于估算元组的平均长度。
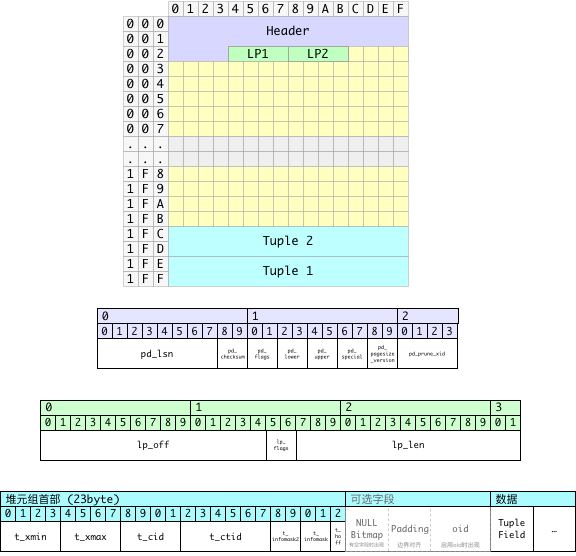
一条元组占用的空间可以分为三个部分:
- 定长的行指针(4字节,严格来说这不算元组的一部分,但它与元组一一对应)
- 变长的首部
- 固定长度部分23字节
- 当元组中存在空值时,会出现空值位图,每个字段占一位,故其字节数为字段数除以 8 后向上取整。
- 在空值位图后需要填充至
MAXALIGN,通常为8。 - 如果表启用了
WITH OIDS选项,元组还会有一个4字节的OID,但这里我们不考虑该情况。
- 数据部分
因此,一条元组(包括相应的行指针)的平均长度可以这样计算:
关键在于求出 首部的平均长度 与 数据部分的平均长度。
计算首部的平均长度
首部平均长度主要的变数在于 空值位图 与 填充对齐。为了估算元组首部的平均长度,我们需要知道几个参数:
- 不带空值位图的首部平均长度(带有填充):
normhdr - 带有空值位图的首部平均长度(带有填充):
nullhdr - 带有空值的元组比例:
nullfrac
首部平均长度的估算公式为:
因为不带空值位图的首部,其长度是23字节,对齐至8字节的边界,长度为24字节,上式可以改为:
将长度向上取整至 8 字节的倍数,可用:
计算数据部分的平均长度
数据部分的平均长度主要取决于每个字段的平均宽度与空值率,加上末尾的对齐。
以下SQL可以利用统计信息算出所有表的平均元组数据部分宽度。
例如,以下SQL能够从 pg_stats 系统统计视图中获取 app.apple 表上一条元组的平均长度。
max(null_frac) 只是“行内存在 NULL 的比例”的近似值。各列统计并不描述 NULL 在不同列之间的重叠关系。
整合
以下函数组合上述估算,假定按 8 字节对齐,并使用服务器实际块大小。缺少统计时返回 NULL。函数只估算堆表;TOAST、fillfactor 和列对齐都会影响结果。
批量计算
对全库监控,可将基于目录统计的批量估算定义为视图。下面是独立的 B-tree 索引膨胀估算示例:
在原来的 3 TB 数据库中,这个视图查询约需 50 ms。它读取目录统计,而非扫描每个索引页;目录访问和关系大小查询仍有开销,过期或不完整的统计也会影响结果。此估算适合筛选需要进一步检查的索引。
表膨胀的处理
维护窗口允许独占表时,可以使用 VACUUM FULL。需要在线重整时,pg_repack 可以缩短持有排他锁的时间。
原 PostgreSQL 10 环境使用下面的 PGDG 软件包。实际安装时选择与 PostgreSQL 大版本对应的软件包:
pg_repack 的使用
pg_repack 使用常见的 PostgreSQL 客户端连接参数。
在使用 pg_repack 之前,需要在待重整的数据库中创建 pg_repack 扩展
命令示例:
-T 控制等锁时间,不限制整个任务的执行时间。未加 --no-kill-backend 时,pg_repack 可能取消冲突查询,随后终止仍有冲突的会话。完整重整表还需要主键,或全部列均为 NOT NULL 的适用唯一索引。详见参数说明。
pg_repack 的策略
将 pg_repack 安排在业务低峰期。它会消耗 CPU、磁盘 I/O 和额外存储,也可能增加查询延迟与复制延迟。
例如,可以在低峰期选择待处理表。下面的视图提供调度示例所需的列,total_mb 是表当前占用的磁盘空间,含索引和 TOAST,单位为 MiB:
以下 shell 函数按行返回表名,并将每个带引号的参数视为一个完整表名:
以下大小门槛均指当前磁盘用量,包含表、索引和 TOAST:
- 从小于 256 MiB,且膨胀率超过40%的小表中,选出TOP64
- 从 256 MiB 到 1 GiB 之间,且膨胀率超过 30% 的中表中,选出TOP16
- 从 1 GiB 到 4 GiB 之间,且膨胀率超过20%的大表中,选出TOP4
此示例在凌晨业务低峰期自动重整选定的表,总磁盘用量超过 4 GiB 的表手工处理。请按实际负载调整执行时间。
pg_repack 的原理
pg_repack 创建紧实副本,并用触发器记录并发变更。重放变更后,通过系统目录交换存储。只重整索引时,先并发创建替代索引,再交换并删除旧索引。
重整表
- 创建一张与原表模式相同,但不带索引的空表。
- 创建一张与原始表对应的日志表,用于记录
pg_repack工作期间该表上发生的变更。 - 为原始表添加一个行触发器,在相应日志表中记录所有
INSERT,DELETE,UPDATE操作。 - 将老表中的数据复制到新的空表中。
- 在新表上创建同样的索引
- 将日志表中的增量变更应用到新表上
- 通过系统目录交换表、索引和 TOAST 存储
- 删除旧存储。
重整索引
- 使用
CREATE INDEX CONCURRENTLY在原表上创建新索引,保持与旧索引相同的定义。 - 在系统目录中交换新旧索引。
- 删除旧索引。
pg_repack 的运行检查
- 避开长事务和冲突的维护任务。先检查等锁情况,再决定是否取消会话。
- 为替代表、索引和变更日志预留磁盘。项目文档建议,完整重整时可用空间约为原表及其索引大小的两倍。
- 在复制和建索引的整个过程中监控 WAL、复制延迟和磁盘余量。WAL 并非只在最终切换时产生。
- 中断后,先按已安装版本的清理说明检查残留对象,再重试。临时对象名称和清理行为因版本而异。
安排维护前请查阅 pg_repack 前置条件与实现说明。
12 - 监控 PostgreSQL 表大小
本文写于 2018 年,介绍 PostgreSQL 普通表的物理存储。
表的空间布局
普通表包含自身存储,也可能有一张 TOAST 表:
- 本体表:存储行数据,
relkind='r'。 - TOAST 表:按需存储行外数据,
relkind='t'。部分表没有 TOAST 表。
表本身和它的每个索引都是独立的 关系(Relation):
- 主体关系:存储元组。
- 索引关系:存储索引元组。
每个 关系 又可能会有 四种分支:
-
main: 关系的主文件,编号为0
-
fsm:保存关于main分支中空闲空间的信息,编号为1
-
vm:保存关于main分支中可见性的信息,编号为2
-
init:用于不写 WAL 的 unlogged 表和索引,编号为3
每个分支存储在一个或多个文件中。默认每段最大 1 GiB,编译 PostgreSQL 时可以修改此值。
统计一张表的存储,需要计入以下关系:
- 本体表的主体关系(单个)
- 本体表的索引(多个)
- TOAST表的主体关系(单个)
- TOAST表的索引(单个)
对每个关系,应计入实际存在的 main、fsm、vm 和 init 分支。init 用于 unlogged 关系。
获取表的附属关系
以下查询列出关系 OID。分支共享所属关系的 OID,没有独立 OID。左连接会保留没有 TOAST 表的普通表:
统计函数
PostgreSQL 提供了对应的大小统计函数:
| 函数 | 统计口径 |
|---|---|
pg_total_relation_size(oid) |
整个关系,包括表,索引,TOAST等。 |
pg_indexes_size(oid) |
关系索引部分所占空间 |
pg_table_size(oid) |
表的各个分支和 TOAST(含 TOAST 索引),不含主表索引 |
pg_relation_size(oid) |
获取一个关系主文件部分的大小(main分支) |
pg_relation_size(oid, 'main') |
获取关系 main 分支大小 |
pg_relation_size(oid, 'fsm') |
获取关系 fsm 分支大小 |
pg_relation_size(oid, 'vm') |
获取关系 vm 分支大小 |
pg_relation_size(oid, 'init') |
获取关系 init 分支大小 |
日常监控可将存储分为表与索引两部分。对普通表,pg_table_size 与 pg_indexes_size 之和等于 pg_total_relation_size。
各部分满足以下关系。这是计算公式,不是完整的 SQL 查询:
TOAST 表有一个索引。使用 pg_total_relation_size(reltoastrelid) 可计算 TOAST 表及其索引的总大小。
例:统计表及其附属关系大小
可将查询包装为返回表的函数,方便复用。请将示例 OID 替换为实际数据库中的表:
每行 size 都包含该关系的附属存储。主表行已经包含索引和 TOAST,不能再将这一列求和。tuples 和 pages 来自规划器统计,可能落后于实际数据。
原环境中的返回结果:
例:关系大小详情汇总
13 - PostgreSQL 服务器日志配置
本文写于 2018 年。下方表结构对应 PostgreSQL 10 的 23 列 CSV 格式,Filebeat 示例使用当时的 prospectors 配置。
CSV 日志可以导入 PostgreSQL 表,也可以通过 file_fdw 直接查询。
日志配置
最后三项用于运行统计,不控制日志输出。logging_collector 和 track_activity_query_size 需要重启服务器生效。按星期命名的文件每周会重用同一名称,应按所需保留时间设置轮转和清理规则。
日志收集
原方案使用 Filebeat 将本地日志转发到 Kafka。请替换文件路径和 Kafka 地址。这个旧版示例从已有文件末尾开始读取,按时间戳模式合并行,最多合并 20 行;它不能完整识别任意多行消息的 CSV 记录边界。
CSV 日志格式
将日志映射为表后,就能用 SQL 分析。下列表结构与 PostgreSQL 10 的 CSV 字段 一致。后续版本增加了列,导入时应使用产生日志的服务器版本对应的表结构:
导入日志
用 COPY 导入已经关闭的 CSV 日志文件,服务器需要有文件读取权限。文件在客户端机器上时,改用 psql 的 \copy。日志轮转后再导入完整文件,每个文件只导入一次。
映射日志
file_fdw 可以直接查询本地 CSV 文件,无需先复制到表中。用具备扩展和服务器文件访问权限的角色执行以下设置。示例假定文件位于 /pg/data/log,且星期名为英文缩写,请按实际输出调整路径。部分星期文件尚不存在时,先查询已有文件对应的子表。
提取日志字段
这些函数从英文日志消息中提取耗时、语句文本和形似 IPv4 的文本。耗时单位为毫秒。函数仅处理示例中的消息格式,不覆盖所有扩展查询协议或本地化消息: