这是本节的多页打印视图。 .
PG Exporter 博客
-
1: 文章
- 1.1: 在 Pigsty 中采用 Victoria 可观测性组件
- 1.2: 暂停代码提交的一周:PGCon.Dev 2024 参会记
- 1.3: PostgreSQL 宏观查询优化之 pg_stat_statements
- 1.4: 使用 Pigsty 监控现有 PostgreSQL:RDS、PolarDB 与自建数据库
- 1.5: PostgreSQL 慢查询诊断方法
- 1.6: Pigsty 首次发布
- 1.7: 黄金监控指标:错误延迟吞吐饱和
- 1.8: Pigsty PostgreSQL 监控系统介绍
- 1.9: PostgreSQL的KPI
- 1.10: PostgreSQL 监控系统概览
- 1.11: 关系膨胀的监控与治理
- 1.12: 监控 PostgreSQL 表大小
- 1.13: PostgreSQL 服务器日志配置
-
2: 设计归档
- 2.1: 目标身份与一致的健康检查响应
- 2.2: 复制采集器的身份、状态与权限修正
- 2.3: 把 PostgreSQL CSV 日志转成持久指标
- 2.4: 把 pgBackRest 指标移出抓取路径
- 2.5: 我们最终没有做的 PostgreSQL 可观测性产品
- 2.6: 一个端点,多种来源:Composite Exporter 契约
- 2.7: 快照直方图是 Gauge,不是 Counter
-
3: 发布注记
- 3.1: PG Exporter v1.5.0
- 3.2: PG Exporter v1.4.1
- 3.3: PG Exporter v1.4.0
- 3.4: PG Exporter v1.3.0
- 3.5: PG Exporter v1.2.2
- 3.6: PG Exporter v1.2.1
- 3.7: PG Exporter v1.2.0
- 3.8: PG Exporter v1.1.2
- 3.9: PG Exporter v1.1.1
- 3.10: PG Exporter v1.1.0
- 3.11: PG Exporter v1.0.3
- 3.12: PG Exporter v1.0.2
- 3.13: PG Exporter v1.0.1
- 3.14: PG Exporter v1.0.0
- 3.15: PG Exporter v0.9.0
- 3.16: PG Exporter v0.8.1
- 3.17: PG Exporter v0.8.0
- 3.18: PG Exporter v0.7.1
- 3.19: PG Exporter v0.7.0
- 3.20: PG Exporter v0.6.1
- 3.21: PG Exporter v0.6.0
- 3.22: PG Exporter v0.5.0
- 3.23: PG Exporter v0.4.1
- 3.24: PG Exporter v0.4.0
- 3.25: PG Exporter v0.3.2
- 3.26: PG Exporter v0.3.1
- 3.27: PG Exporter v0.3.0
- 3.28: PG Exporter v0.2.0
- 3.29: PG Exporter v0.1.2
- 3.30: PG Exporter v0.1.1
- 3.31: PG Exporter v0.1.0
- 3.32: PG Exporter v0.0.5
- 3.33: PG Exporter v0.0.4
- 3.34: PG Exporter v0.0.3
- 3.35: PG Exporter v0.0.2
- 3.36: PG Exporter v0.0.1
1 - 文章
最初发表于 vonng.com 的 PostgreSQL 监控、诊断、容量与日志文章。各篇保留原发布日期、署名、插图与历史背景,并配有英文译文。
当前版本的安装与操作方法见 PG Exporter 使用手册。
1.1 - 在 Pigsty 中采用 Victoria 可观测性组件
本文记录 2025 年 12 月的 Pigsty v4 测试版。
准备 Pigsty v4.0 时,我将默认的 Prometheus 和 Loki 服务替换为 VictoriaMetrics 与 VictoriaLogs,并加入 VictoriaTraces。目标是降低存储与内存消耗,改善仪表盘和日志查询的响应时间。
之前的使用经验
在探探时,我们用十二台 64 核、256 GB 内存的 Prometheus 节点监控约五千万个时间序列。我的测试中,三节点 VictoriaMetrics 集群可以处理这些负载,一台配置更高的服务器也能承载。内存和磁盘用量约为原方案的四分之一,查询速度约快四倍。
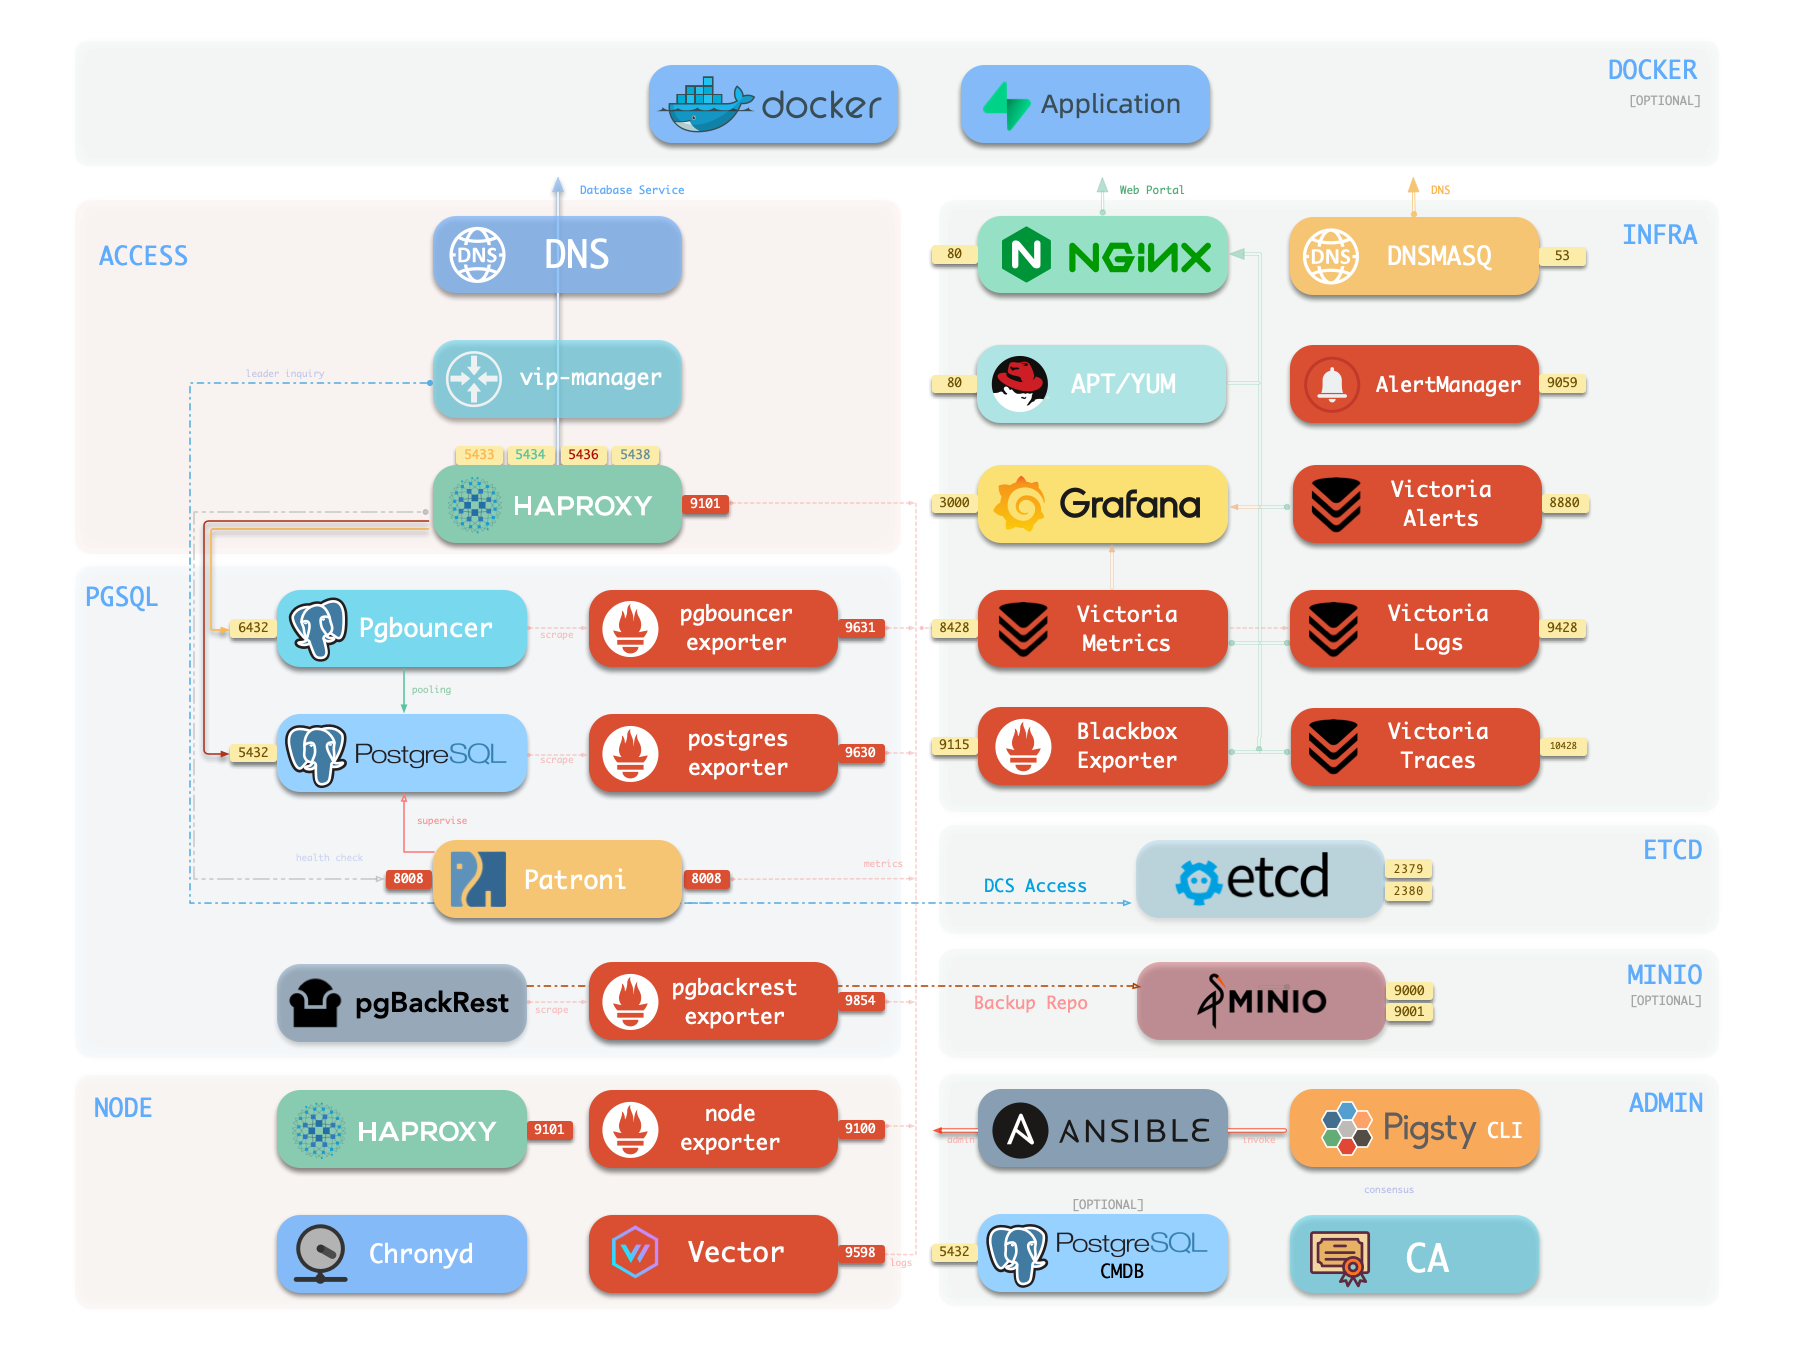
Pigsty 起初将 VictoriaMetrics 作为可选模块。为影视飓风部署监控系统,加上 Promtail 计划停止维护,促成了这次基础设施更新。Promtail 是日志采集代理,Loki 本身并未停止维护。
Aliaksandr Valialkin 在内存分配控制和存储效率上的工作,也是我测试这套系统的原因。
十节点测试
在 v4 测试版中,我收集了十个节点的指标与日志。运行一天后的结果如下:
| 项目 | 观测值 |
|---|---|
| 时间序列 | 约 12 万 |
| VictoriaMetrics 内存 | 约 600 MB |
| 已存储指标样本 | 约 11 亿 |
| 指标存储 | 约 440 MB |
| 日志记录 | 约 50 万行 |
| 日志存储 | 不到 6 MB |
| 整套监控服务,含 Grafana 与 Alertmanager | 约 0.2 vCPU、1 GB 内存 |
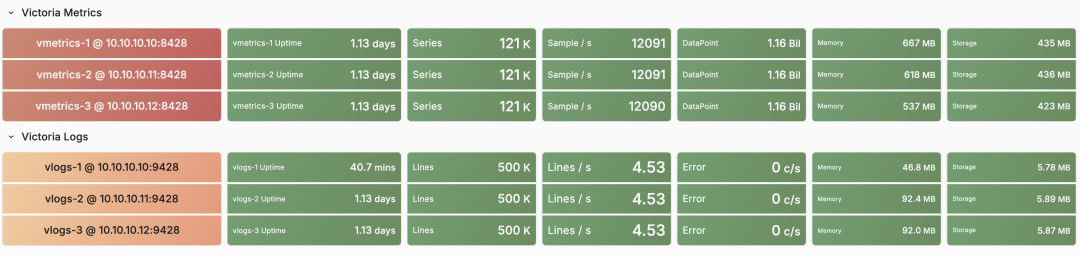
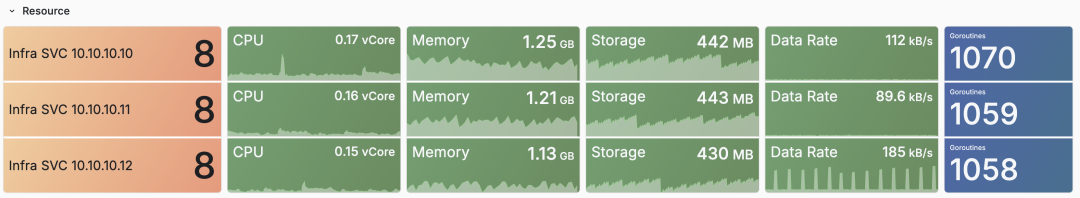
我还在十节点环境运行了 Pigsty v3.7 的 Prometheus 与 Loki 方案。十小时后,其资源使用已接近或超过 Victoria 方案。两组读数的采集时长不同:Prometheus 与 Loki 为十小时,Victoria 为一天。
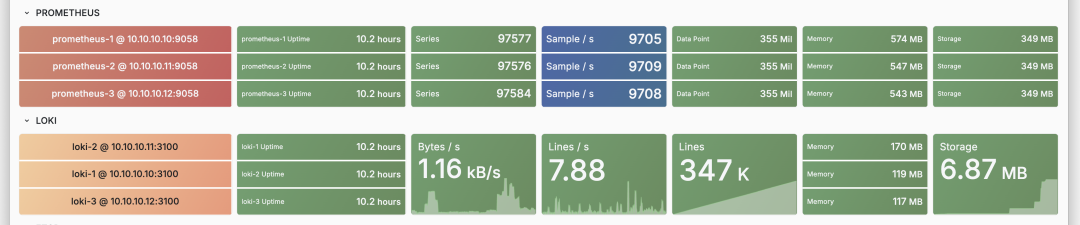
对日常使用更直接的改善,是这套环境中的仪表盘加载和日志查询变快了。
指标、日志与追踪
VictoriaMetrics 接收 Prometheus 指标,并提供兼容的查询 API。PG Exporter 继续暴露同一个 /metrics 端点。已有仪表盘可以改用 VictoriaMetrics 数据源;迁移时需核对查询结果,因为 MetricsQL 与 PromQL 存在差异。记录规则与告警规则由独立的 vmalert 服务计算。
VictoriaMetrics 支持单机与集群部署。
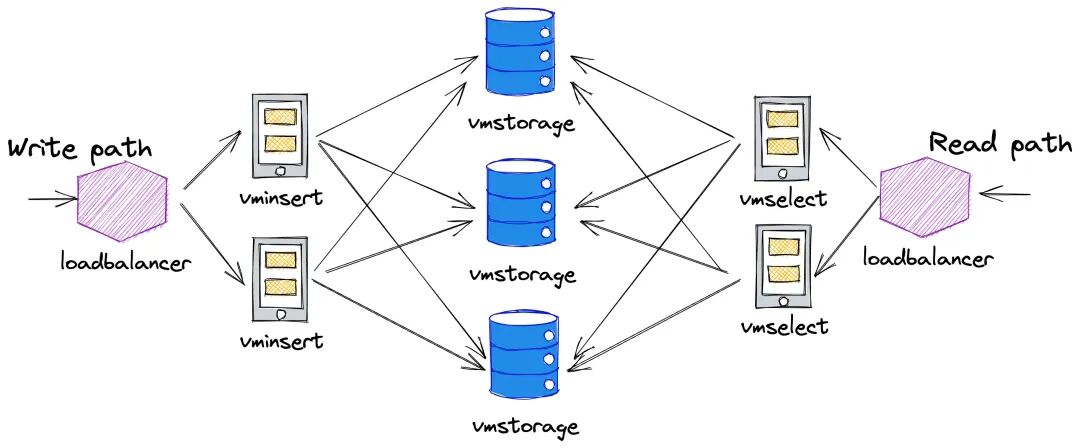
单台服务器足以处理本次负载,因此我采用独立的单机副本提供冗余,省去了分布式存储的管理。每个副本分别采集、存储指标。
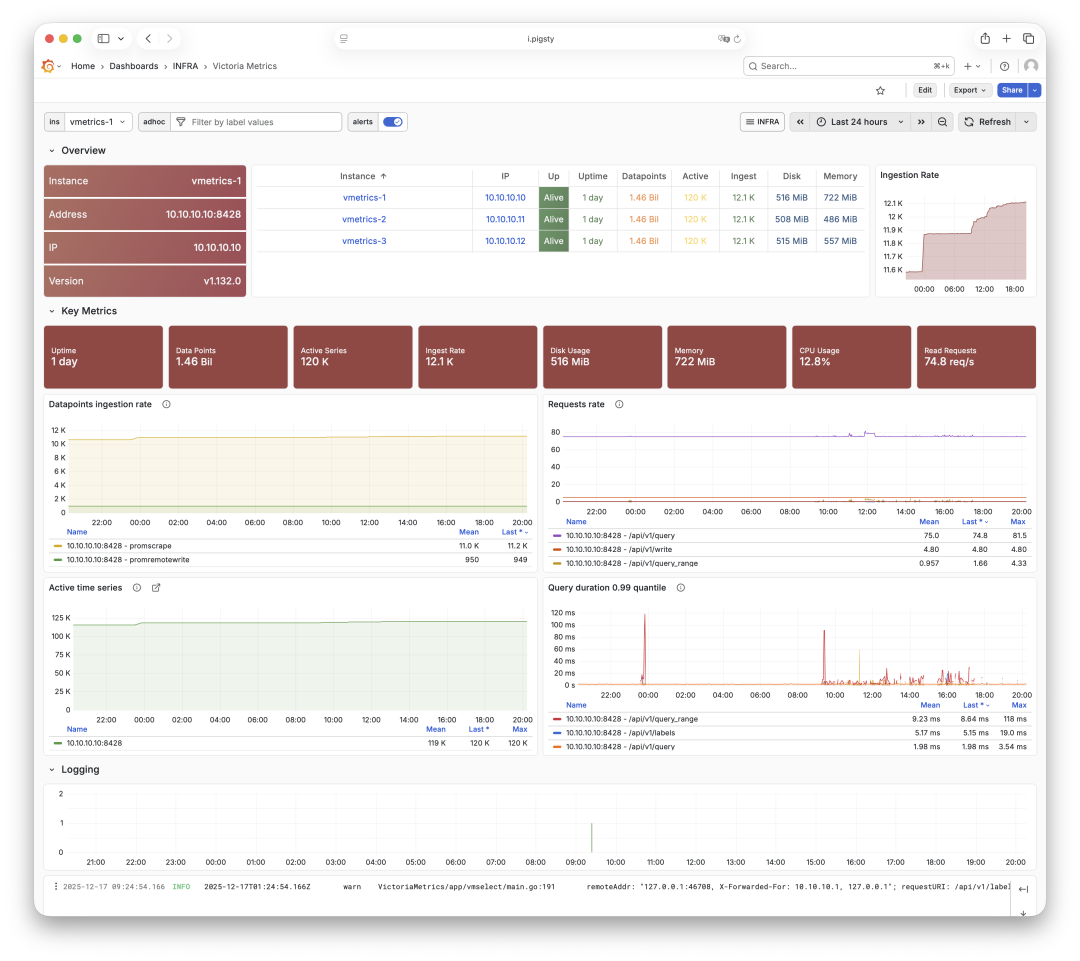
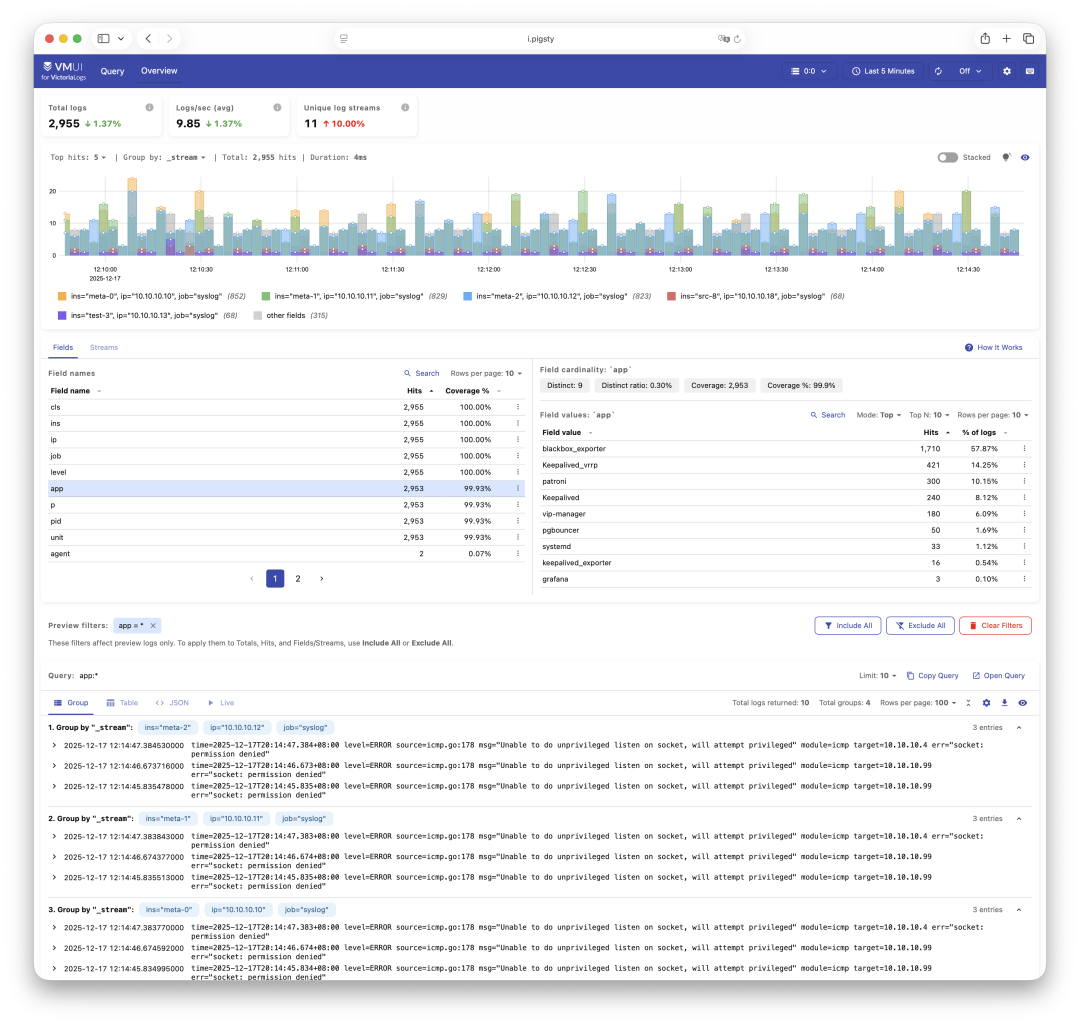
在原有部署中,扩大日志查询的时间范围,有时会使 Loki 查询超时。改善日志查询速度是此次采用 VictoriaLogs 的主要原因之一。
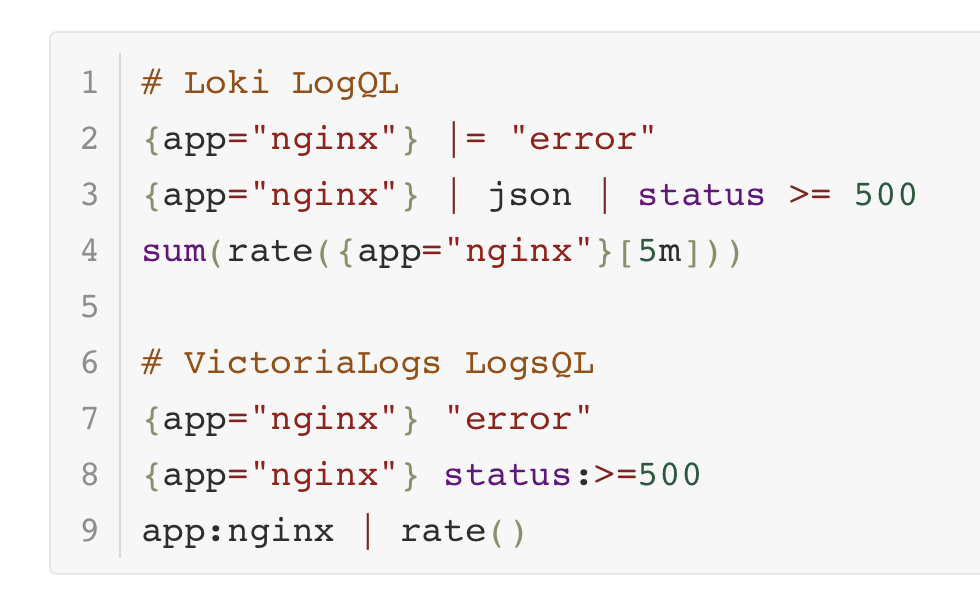
VictoriaLogs 存储日志,使用 LogsQL。由 Loki 迁移时,需要修改 LogQL 查询和日志采集配置。本次部署使用 Vector 替代 Promtail。
LogsQL 允许不指定流选择器就进行搜索。例如,"error" "timeout" 可以查找同时包含两个词的日志。这适合尚不清楚哪个服务出错的排查场景,语法见 VictoriaLogs 文档。
VictoriaTraces 提供追踪数据存储。本次 Beta 测试覆盖指标与日志。
Pigsty 集成
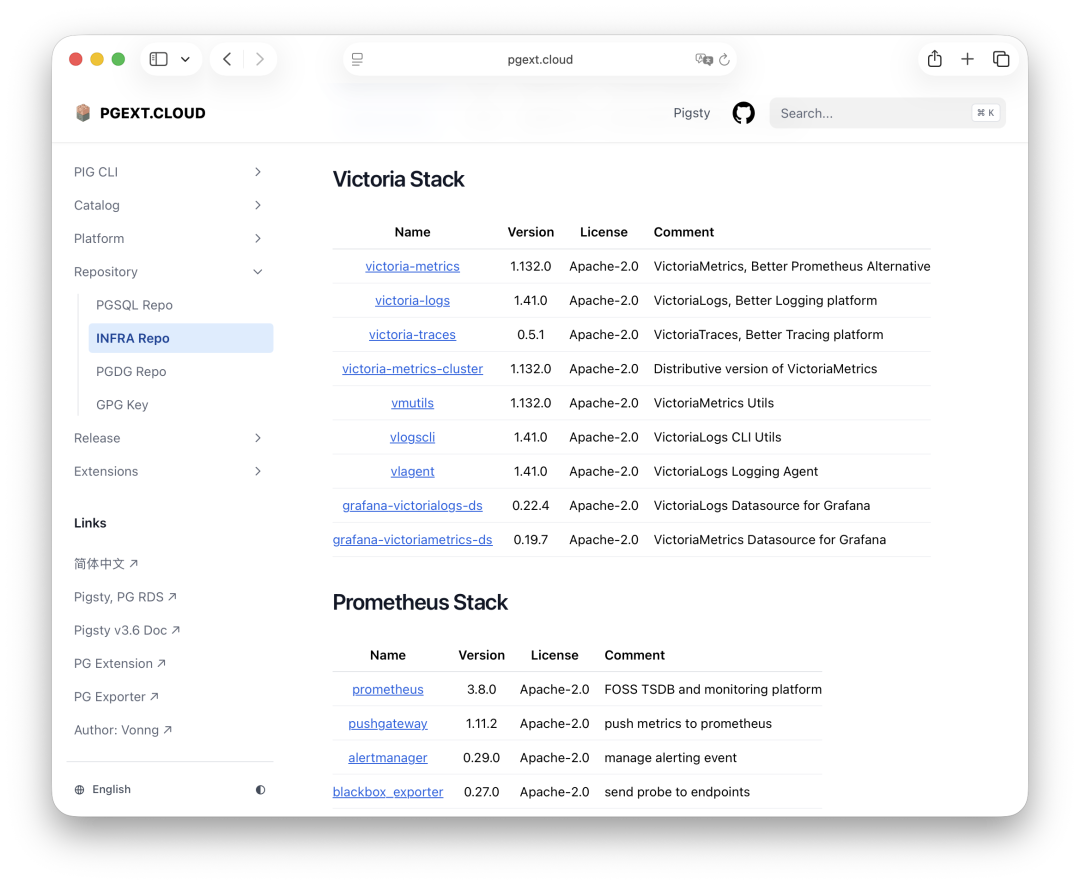
Pigsty 基础设施仓库提供 Victoria 组件、工具和 Grafana 插件的 RPM 与 DEB 软件包。infra 部署负责配置存储目录、服务、Grafana 数据源、仪表盘与 Nginx 路由。
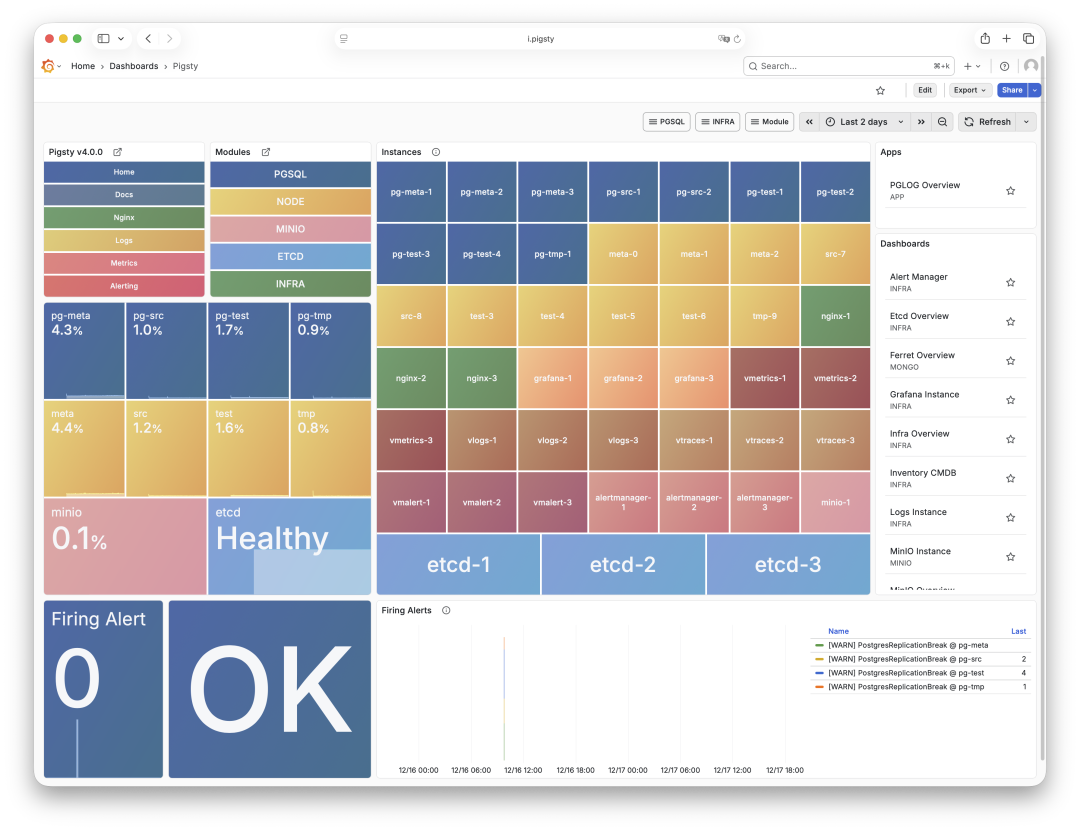
Nginx 通过配置的基础设施域名暴露服务。监控栈包括 VictoriaMetrics、VictoriaLogs、VictoriaTraces、Grafana、vmalert 与 Alertmanager。
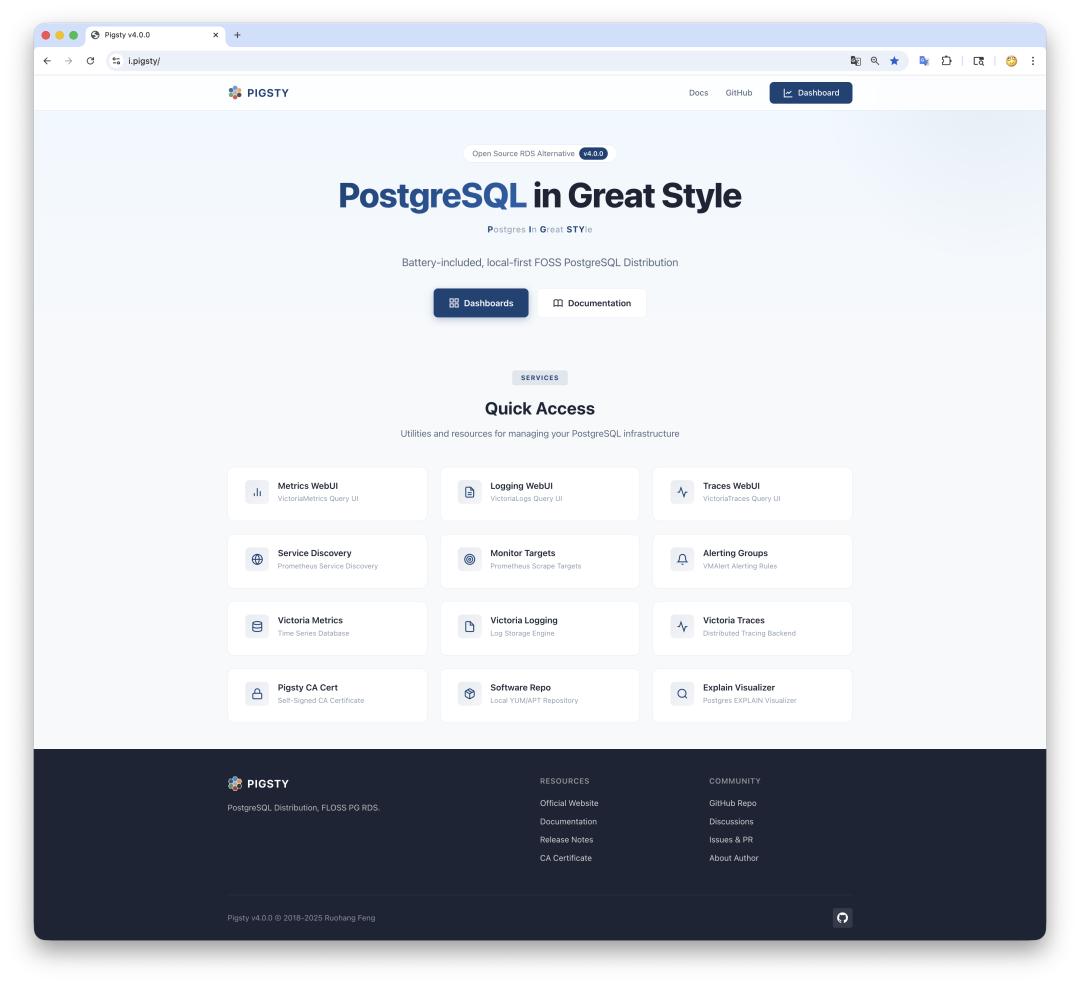
部署也配置了这些服务的自监控。新增应用目标可通过抓取配置接入。
当时的测试版部署
2025 年 12 月的测试版使用 infra 配置模板,仅安装监控服务,不安装 PostgreSQL 或 etcd。下方命令展示当时的流程。在新主机上部署,请使用当前 Pigsty 基础设施指南。
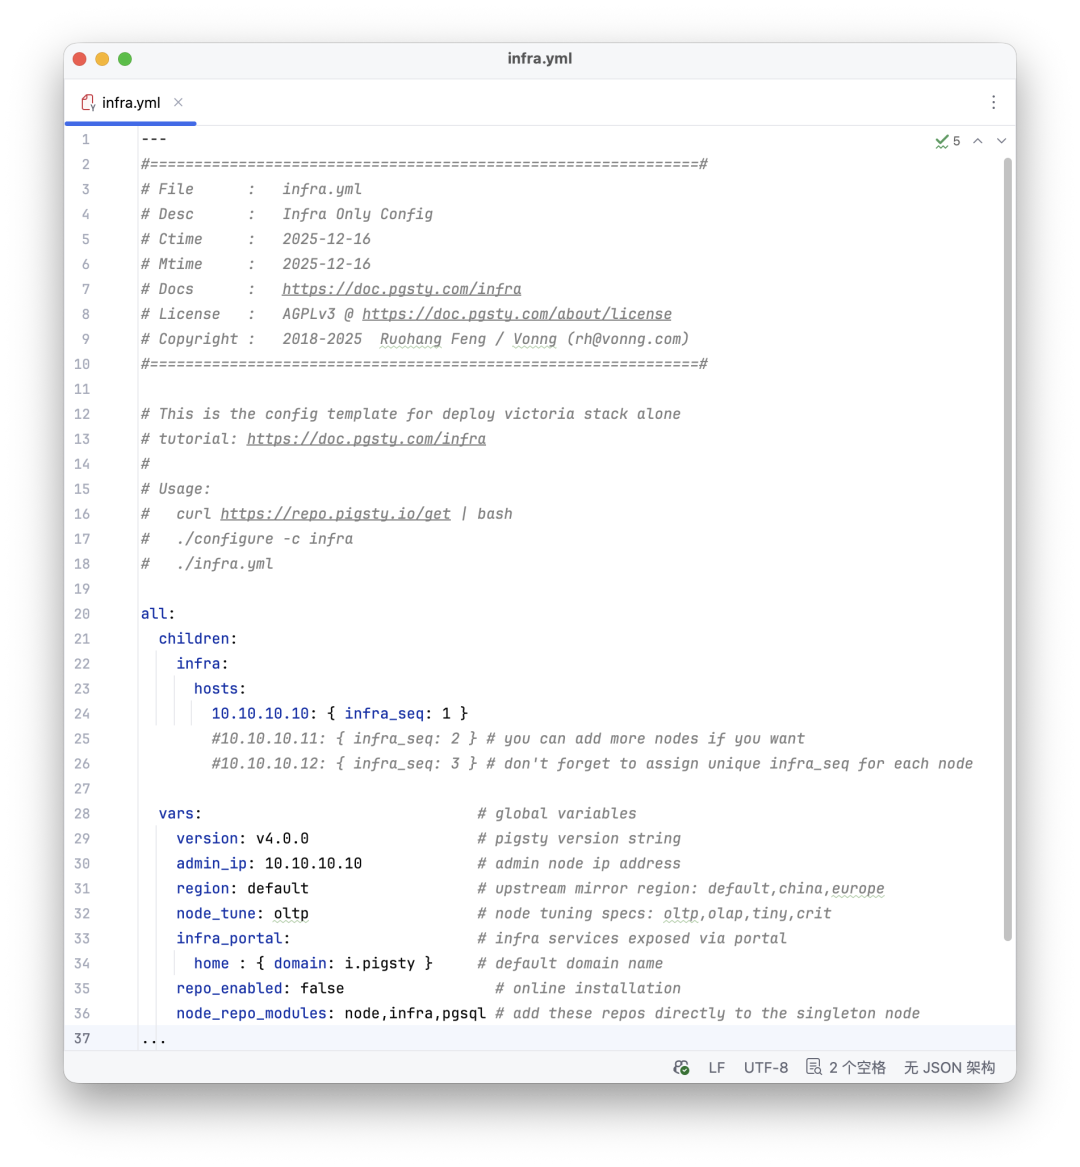
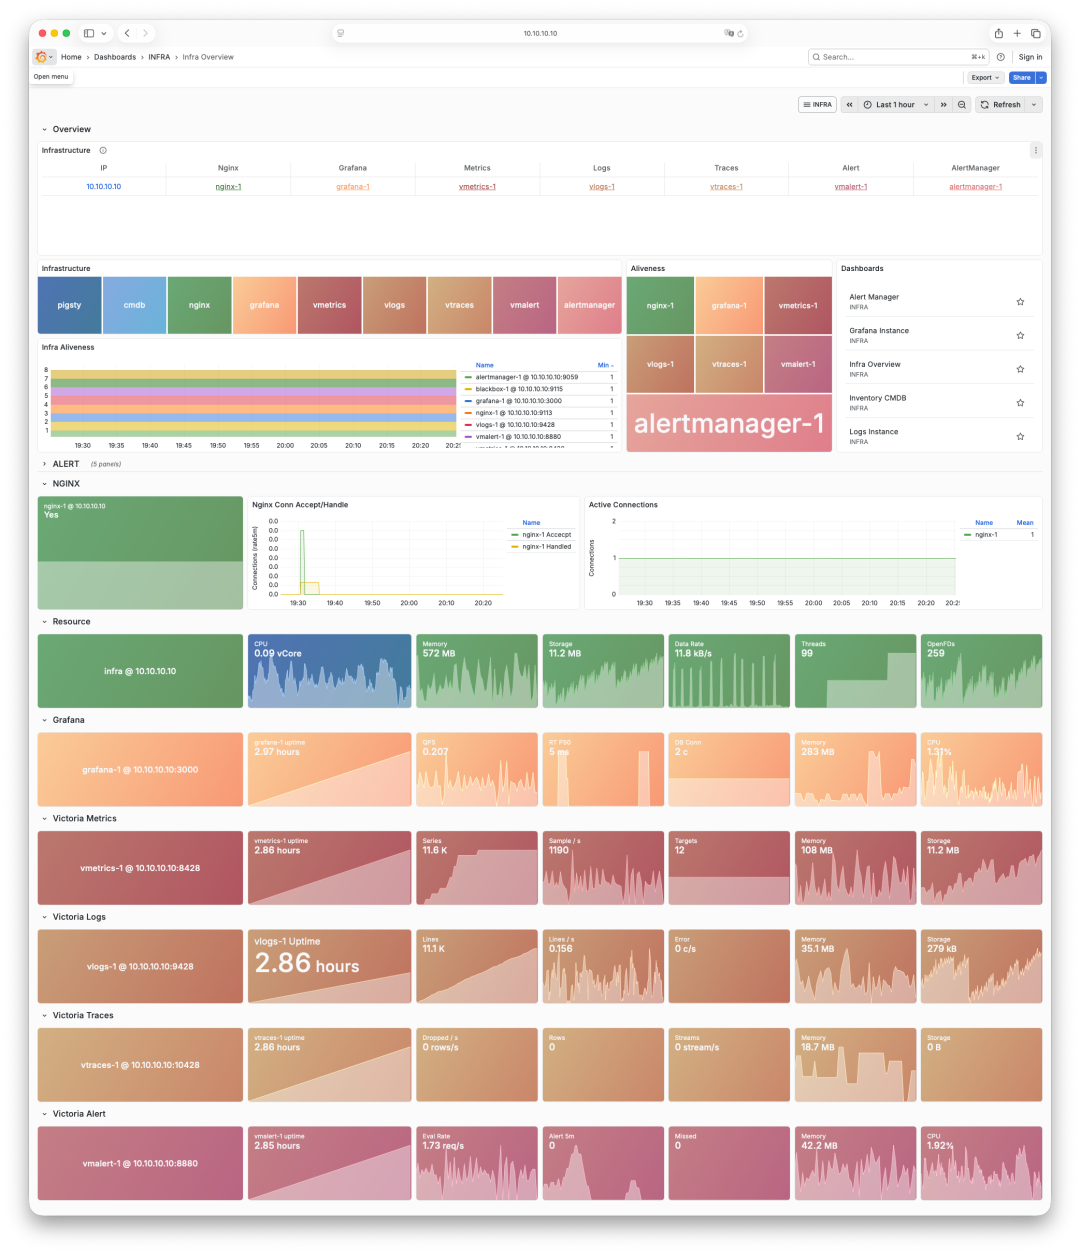
配置三个基础设施节点时,模板会部署三个相互独立的副本。
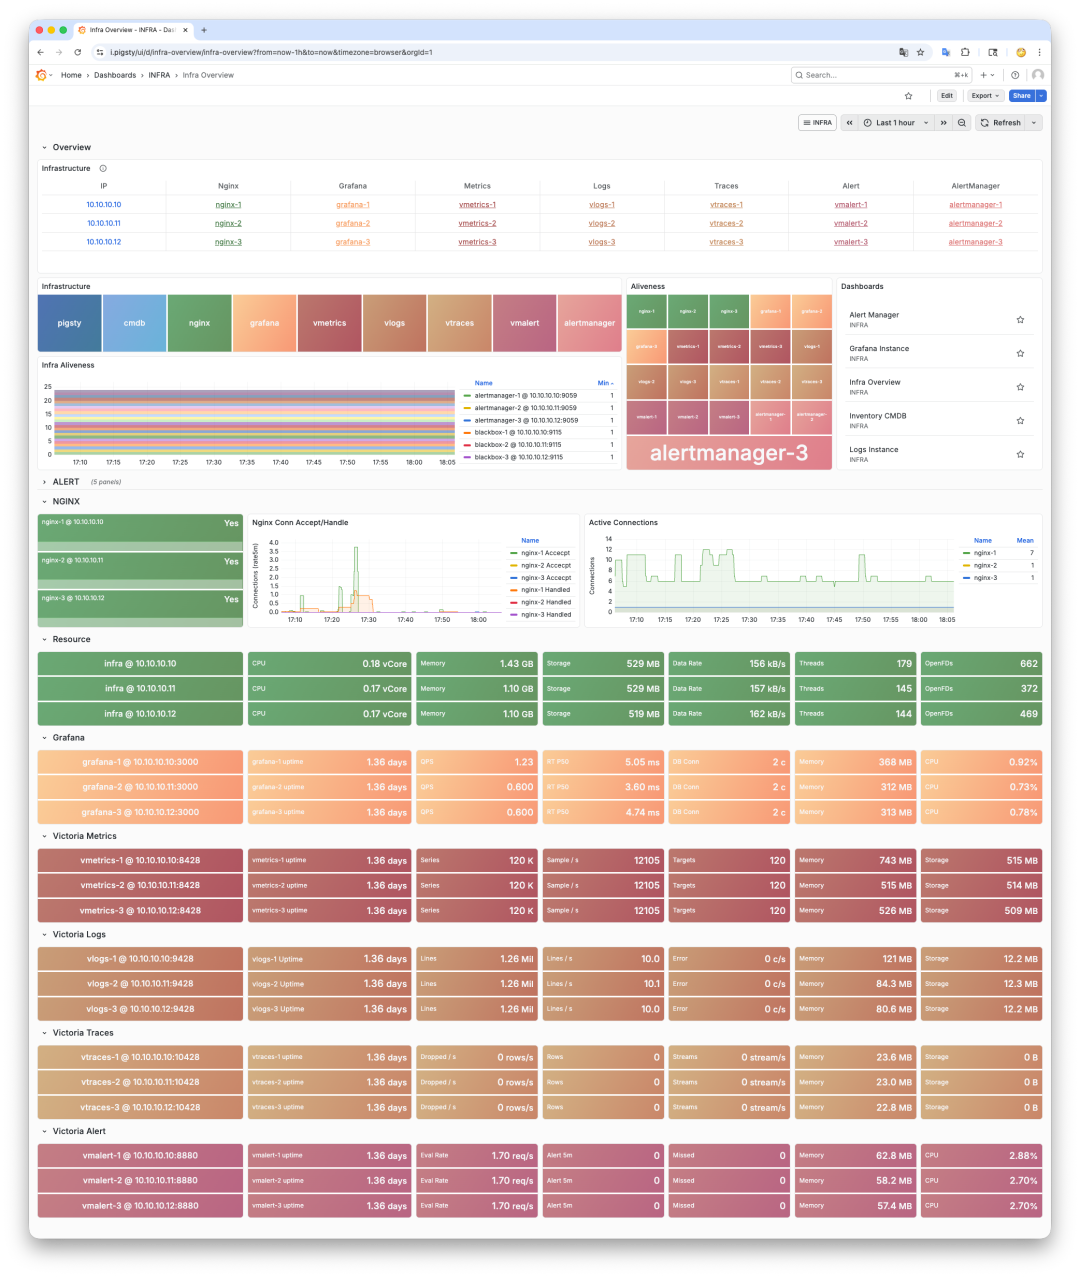
文章写作时,v4.0 剩余工作包括仪表盘和文档,正式版计划在 2026 年 1 月发布。Victoria 原生分布式部署属于后续任务。
这次迁移降低了我们负载下的资源消耗,并改善了查询响应。这是我选择将其作为 Pigsty 默认监控栈的原因。
1.2 - 暂停代码提交的一周:PGCon.Dev 2024 参会记
本文是 2024 年 6 月的参会记录,职务、软件包数量和技术提案均按当时情况叙述。
PGCon.Dev 的前身 PGCon 从 2007 年至 2023 年在加拿大渥太华举办,是 PostgreSQL 开发者讨论项目方向的年度聚会。2024 年,新的组织团队接替 Dan Langille,将会场移至温哥华的 SFU 港区活动中心。
全都来参会了,谁还在写代码?
Peter Eisentraut 在会后统计发现,大会前后相邻的两次 PostgreSQL 代码提交间隔六天十二小时四十九分钟,是二十多年来最长的一次提交间隔。开发者们在线下也有许多事情可聊。
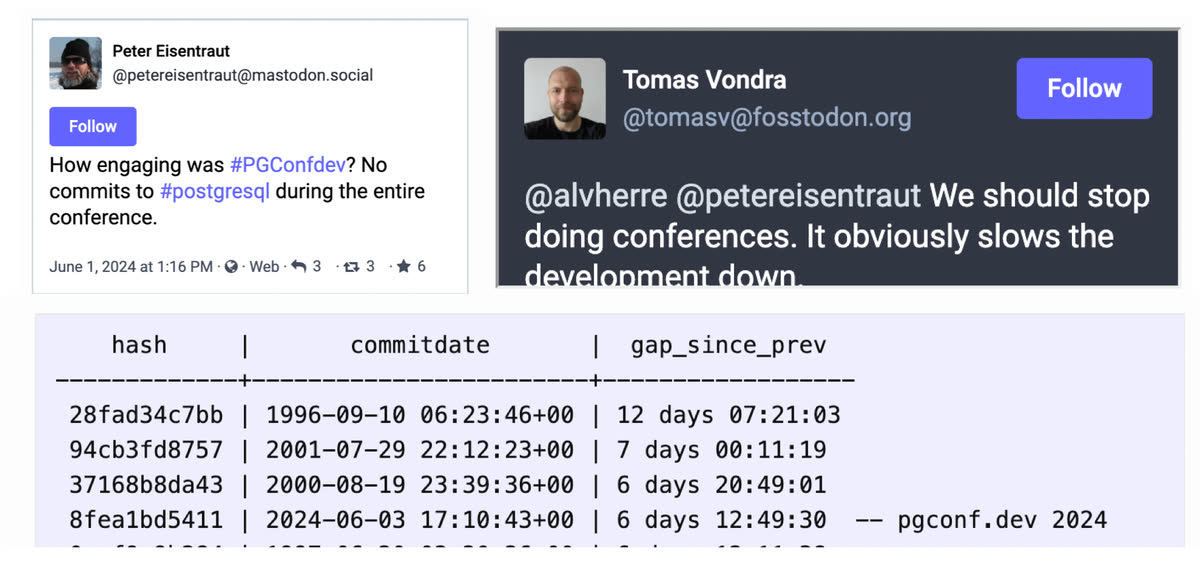
考虑到前几次中断都发生在二十年前的项目早期……
虽然我已经拥抱 PostgreSQL 十年了,但线下现场参加全球 PG Hacker 们的会议还是第一次,所以我非常感谢组织团队为组织这次活动所做的工作。
PGCon.Dev 2024 于 5 月 31 日闭幕。这篇文章本该当时写完,却被紧接着的温哥华和班夫国家公园之行耽搁了。今天补上参会的见闻与记录。
第零天:扩展生态峰会
大会的第零天是领导层会议,我注册了下午的 Extension Ecosystem Summit 扩展生态峰会。
说起来,这个扩展生态峰会也许跟我还有点关系。两个月前我写了一篇文章《PostgreSQL正在吞噬数据库世界》,主题是 PostgreSQL 的繁荣扩展生态是它的重要特点。 写完后将其翻译成了英文《Postgres is eating the database world》发到了 Medium 与 Hacker News 上,总共有几十万的阅览量,基本应该覆盖了整个 PG 社区。
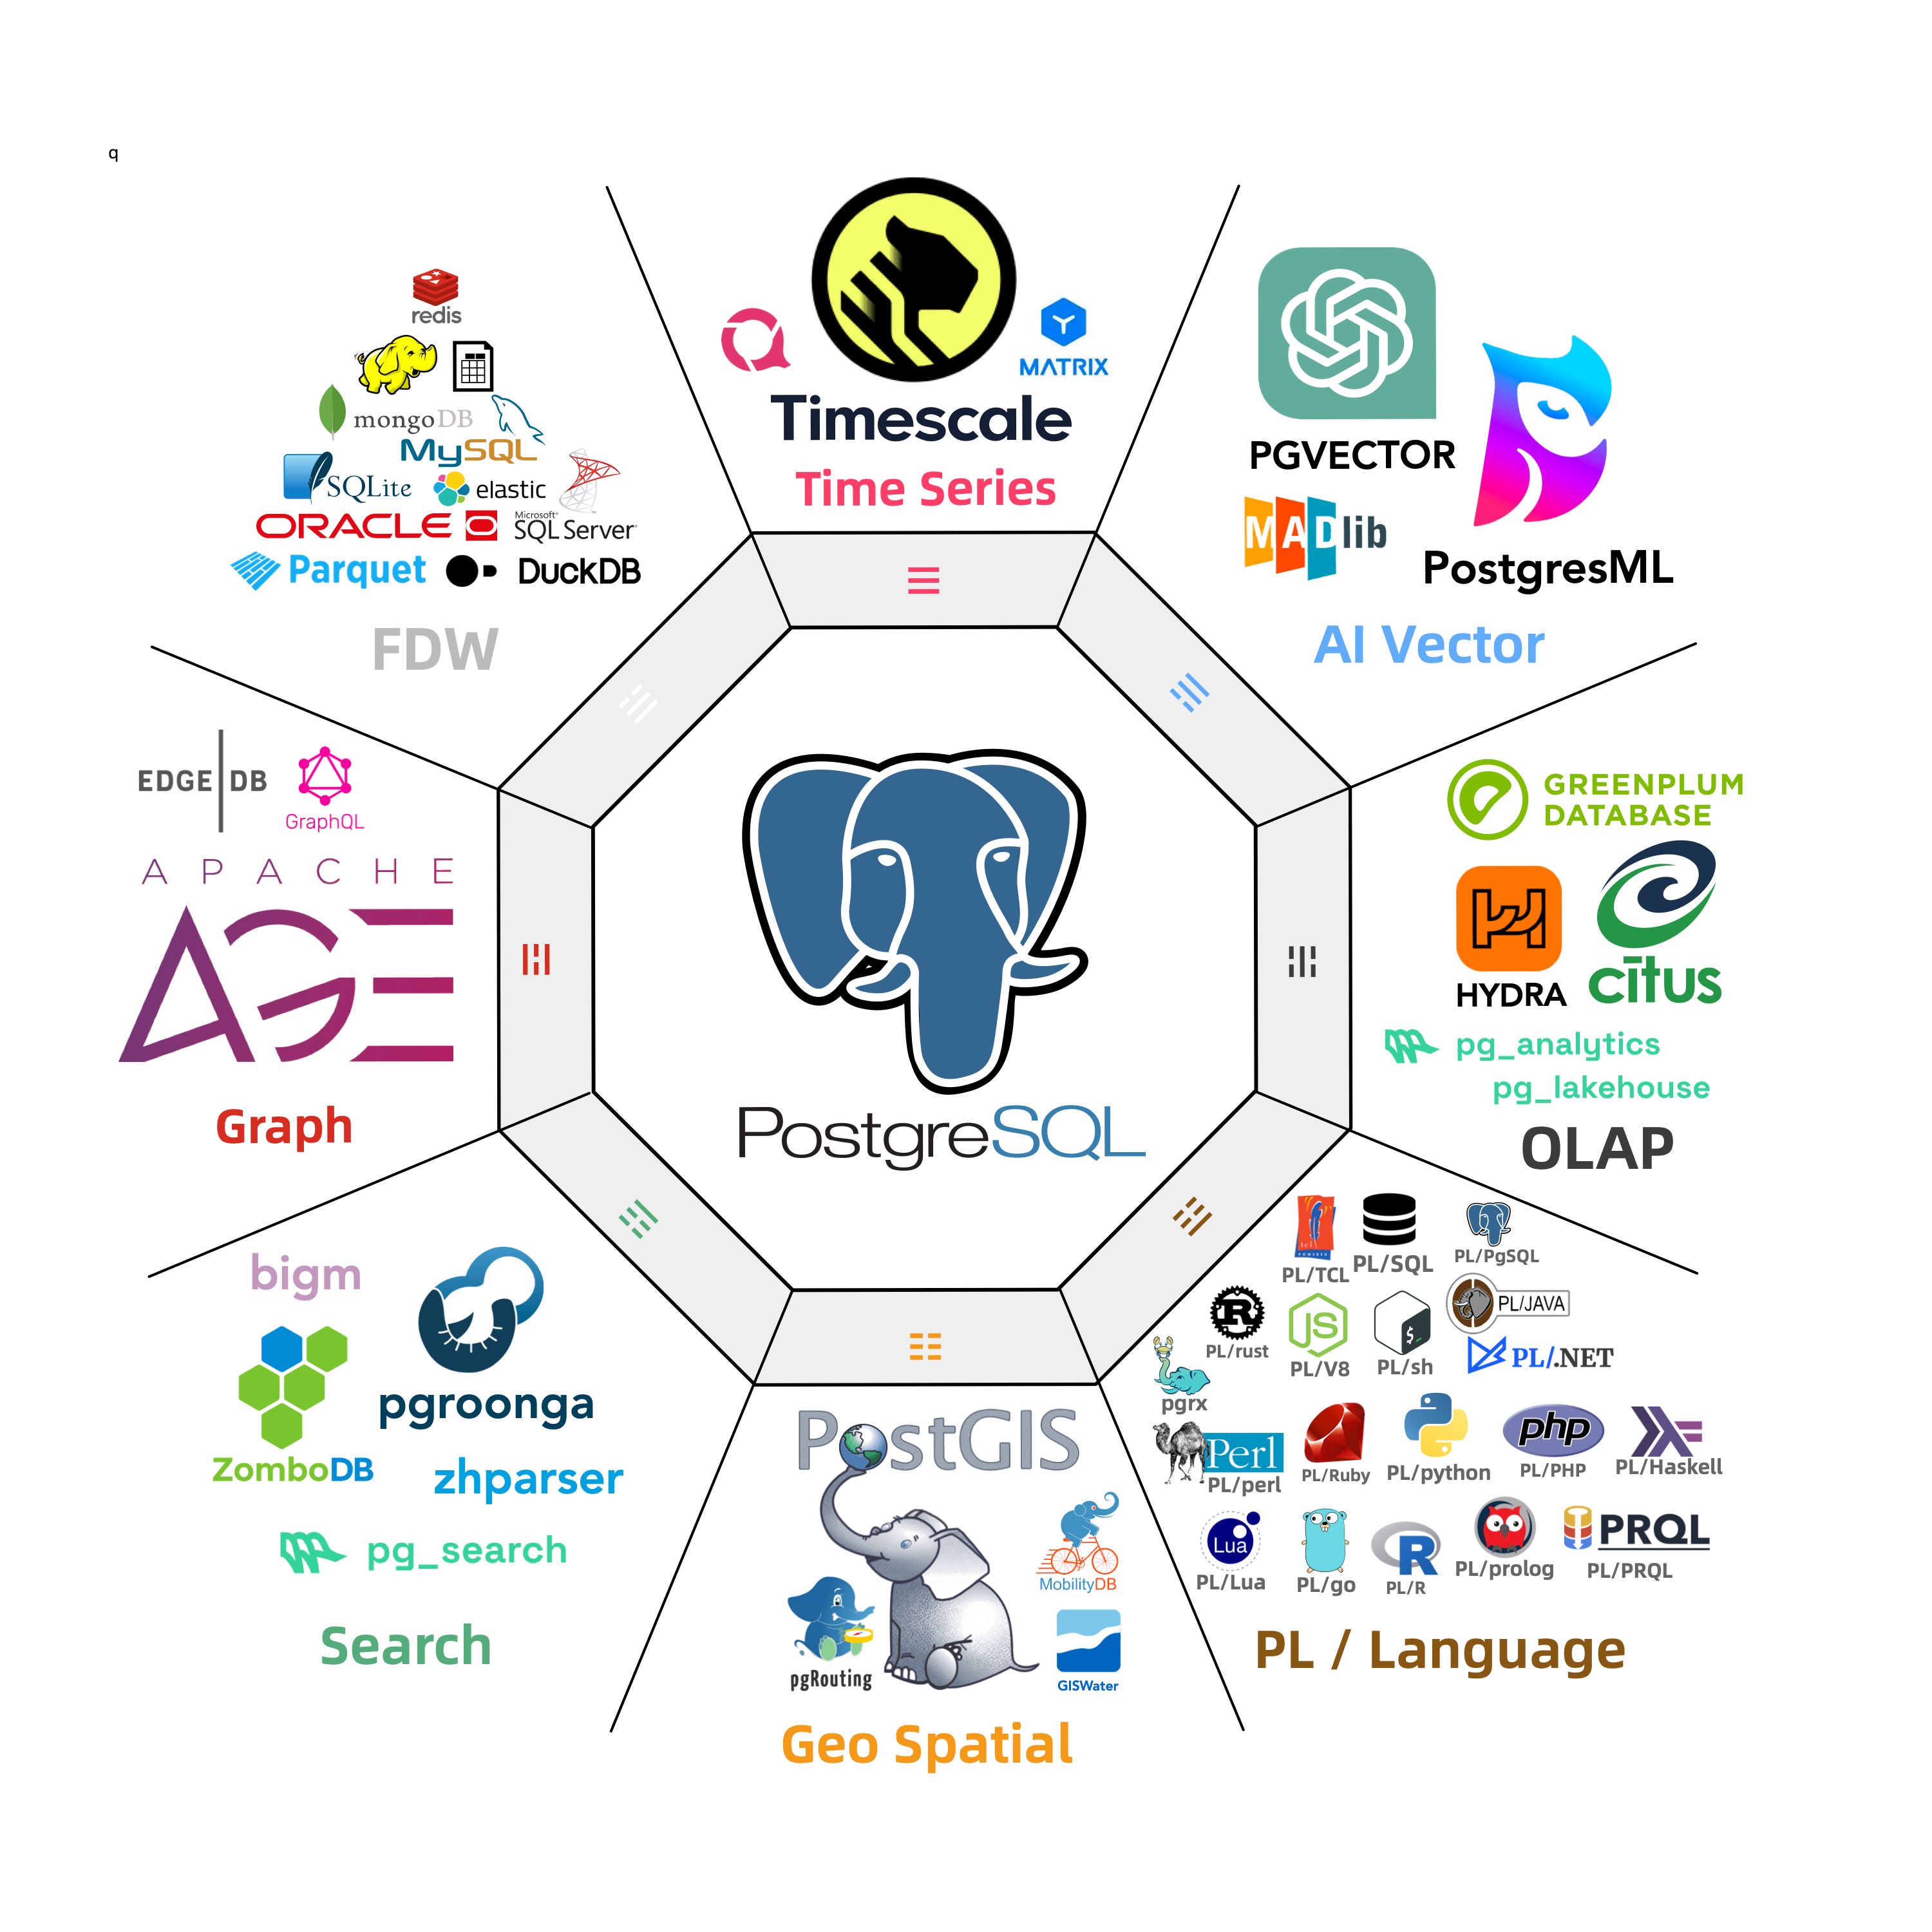
此前,扩展机制的重要性并没有达成共识,即使在 PG 社区与一些资深成员的眼中,关于扩展他们只是觉得 PostGIS 和 PGVector 好像很不错 —— 前者是地理空间数据库的事实标准,后者是AI领域当红炸子鸡 —— 向量数据库的砸盘掀桌者。 但 PG 生态中强大的扩展绝不仅仅只有这两个,在抛出了这个极为繁荣的 PG 扩展生态 Landscape 后,立即引起了社区成员的极大兴趣与关注,很快关于PG扩展的讨论发酵了起来。
在这次扩展峰会之前,PG 社区已经举办了六次迷你扩展峰会对此事进行了密集的讨论,六位主讲嘉宾兼主持人在最近两个月中,从不同的角度介绍了关于扩展生态的建设工作,并阐述了对 PG 扩展生态发展的愿景,会议的视频回放可以在 YouTube 上看到。
在这次大会中,有许多与扩展生态,可扩展性有关的议题,甚至还有一个专门的扩展峰会,也许确实是有点关系的。这场扩展峰会分了上下两场,每场都有几个 Topic,大家挑选感兴趣的主题参与。 我挑了 David Wheeler 的 Binary Packaging 主题分会参与讨论,其他参与者包括 PGDG Yum 仓库维护者 Devrim,Debian 仓库维护者大法师 Tomasz Rybak,以及 Neon 的 PG 主要贡献者 Andreas Scherbaum。都是些老前辈,好在我也算是 YUM/APT 仓库的建设者/维护者,能实质参与到讨论中。
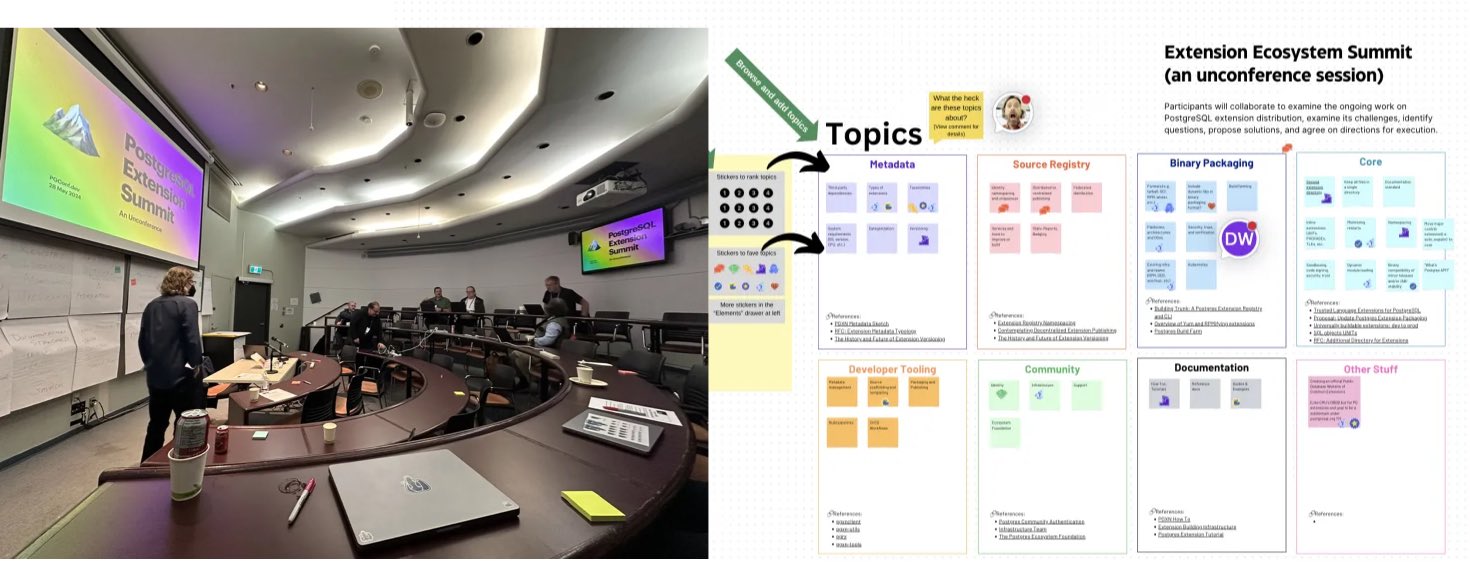
在上半场,来自 Tembo 的 David 一直想做一个 PGXN v2,作为 PG 生态扩展分发的标准,搞一些 OCI 构建扩展的花活。当然,现有事实标准的维护者 Devrim 和 Tomasz 肯定是不乐意的。我支持这两位老爷子,毕竟我做的是 PG 发行版,内核组的活儿跟我直接关系不大,但 YUM/APT 仓库的负责人跟我的关系最紧密,RPM / Deb 包分发扩展已经是一种相当成熟可靠的方式了,整 OCI 这些我个人觉得意义不大。
下半场,我参加了 Omnigres 创始人 Yurii Rashkovskii 主持的 Extension in Core 分会场,讨论了关于扩展目录结构,元数据,命名冲突,版本控制,二进制分发的一些想法。并且和负责 PG RPM 仓库的 Devrim 老爷子聊了很多关于扩展的问题。
在扩展峰会后,Devrim 打出 “Keith粉丝团” 的 Slogan
第一天:主题分享与酒吧社交
PGCon.Dev 最核心的部分当然是大会议题,在 PG大会2024开幕 中我已经选定了感兴趣的主题,绝大多数分享都没有让我失望 —— 比起国内各种 XX 大会无聊的产品宣介,无关痛痒的技术细节与架构分享,PGConf.Dev 的分享要有趣且扎实得太多了。
5月28号 / 周二举行了 PostgreSQL 开发者与领导层闭门会议,以及 PGCon.Dev 扩展生态峰会。大会正式的议程在周三,也就是 29 号开始。
开场由 Jonathan Katz 与 Melanie Plageman 主持,前者是 PG 核心组七人之一,AWS RDS 的首席产品经理;后者是新近成为 PG 提交者,来自微软的 PostgreSQL 开发者。当然,开幕式上最精彩的一幕,就是发现了著名 xz 后门的 “英雄开发者” Andres Freund 被拉上了台,披上了超级英雄的披风。
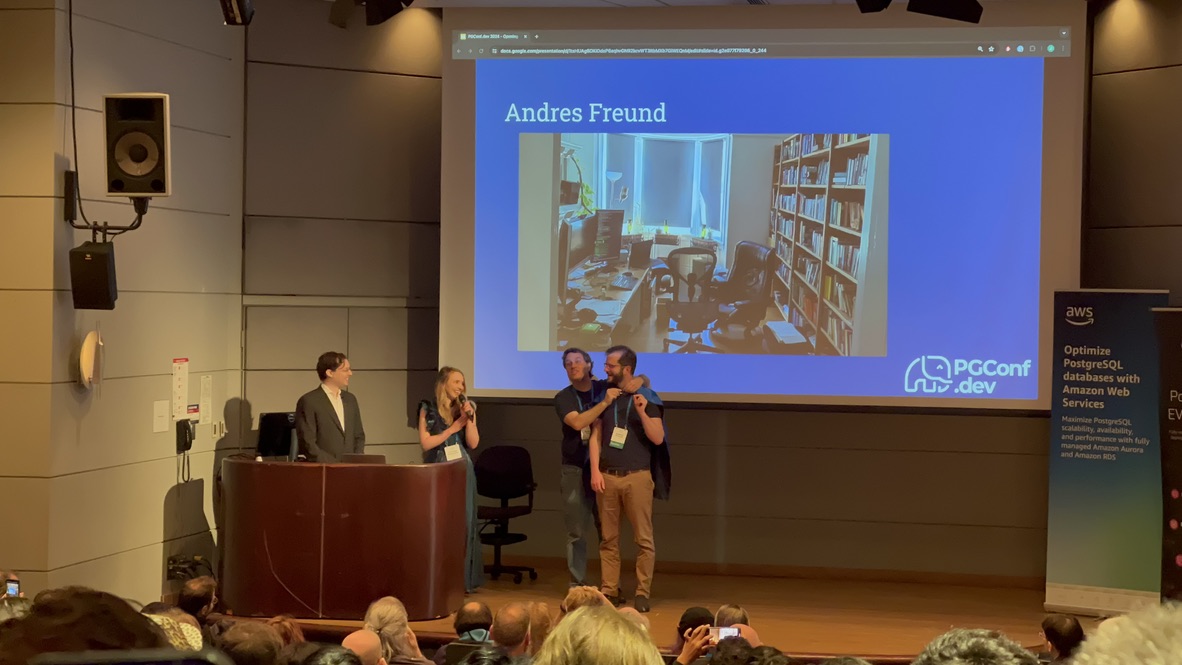
开幕式之后就开始了常规 Session Track,目前还没有会议的视频放出,但我相信以加拿大的办事效率,“用不了多久” 就能在 YouTube 上看到了。大部分的 Session 都是三选一的。我选了几个场次,下面是摘要:
将扩展的边界推向新边疆
第一场来自 Yurii , “将 PG 扩展的边界推向新边疆”。讨论的内容其实是 PostgreSQL 应该提供什么样的扩展 API ? PostgreSQL 有着极佳的可扩展性,但这一套 API 已经是十几年前 9.x 留下的了。尤里的提议旨在解决现有扩展机制的一些问题。比如:如何同时安装两个不同版本的扩展插件?如何避免一部分扩展插件安装后需要重启数据库的问题?如何让PG像管理数据一样管理扩展?如何处理扩展的依赖关系?
Yurii 和 Viggy 创办了 Omnigres ,旨在让 PostgreSQL 直接成为一个应用开发平台(比如直接在数据库里跑 HTTP 服务器等任务)。为了做到这一点,他们为 PostgreSQL 设计的一套新的扩展 API 与管理机制。我认为一些改进很有创新性,是 PG 内核扩展机制的前沿探索实践。PDF地址
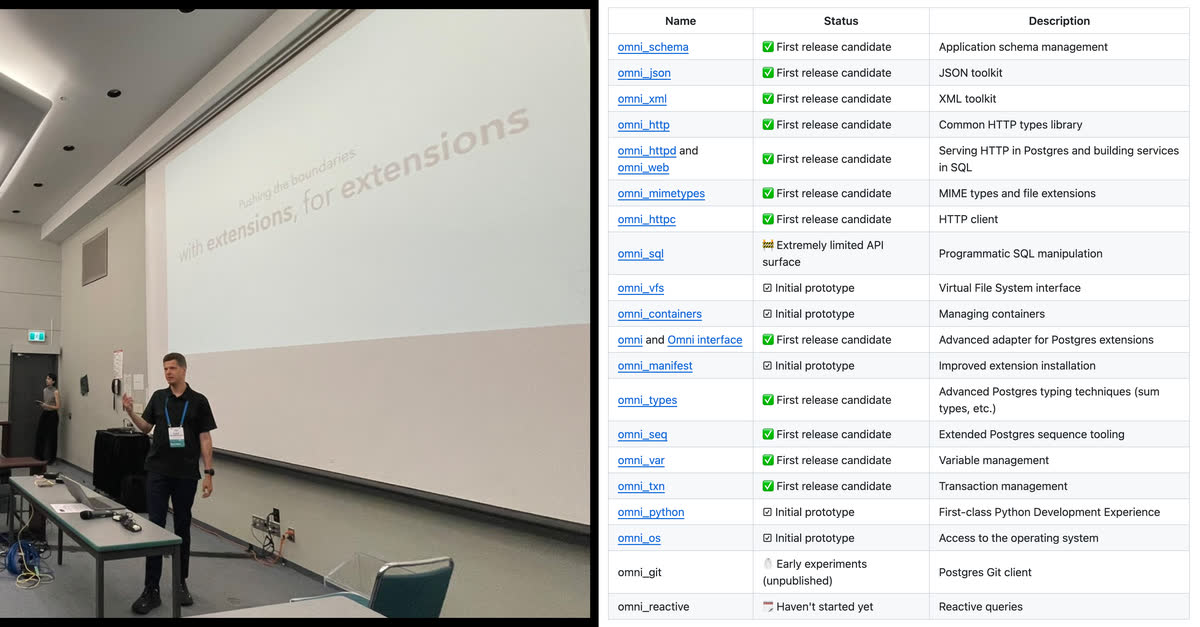
我和 Viggy 与 Yurii 聊的非常愉快,Yurii 手把手带我编译安装试用了一把 Omni。而我也准备在下一个 Pigsty 的版本中,就加入对 Omni 系列扩展的支持,让这个强大的应用开发框架开箱即用。
数据库中的无政府状态
第二场分享来自学术界(CMU),师从网红教授 Andy Pavlo 的阿比盖尔·金,主题为:数据库中的无政府状态 —— 数据库管理系统可扩展性的调查与评估。我对这个主题非常感兴趣,因为 Pigsty 将 PG可扩展性为首要价值主张,收录了 255 个扩展插件,而 Kim 的这个研究带来了一些有趣的发现。
在 Kim 比较的系统中,PostgreSQL 支持所研究的十类扩展点中的九类,覆盖范围最广。她的调查列出了 375 个以上的 PostgreSQL 扩展。
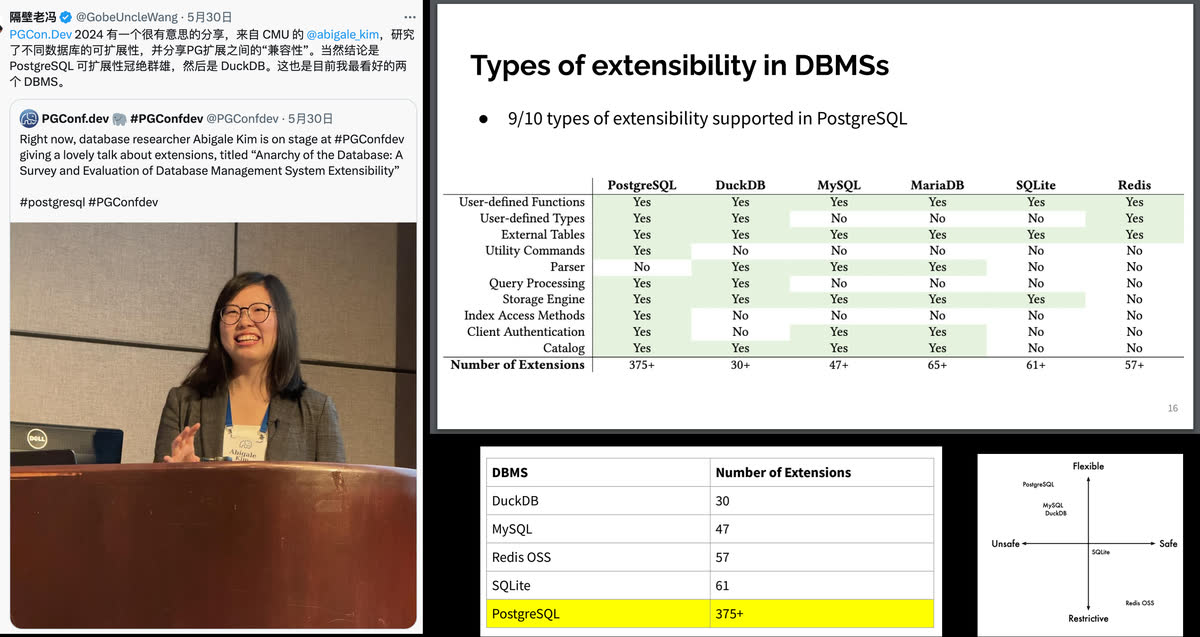
更有价值的是,Kim 定量分析了这些扩展之间的兼容性水平,得到了一个兼容性矩阵,并有一些有趣的发现 —— 例如,最为强大的 TimescaleDB 和 Citus 最容易与其他扩展发生冲突。而这样的信息对于用户与发行版维护者来说是非常有价值的。
我跟 Kim 聊天时说,这项研究为比较数据库可扩展性提供了具体数据。演讲幻灯片
PostgreSQL是如何被误用与滥用的
下午第一场,Crunchy Data 的 Karen Jex 从用户角度介绍了 PostgreSQL 初学者常犯的错误。这些例子对我来说很熟悉,但可以帮助开发者了解新用户如何使用数据库。
PostgreSQL与人工智能生态
下午的第二场,Bruce Momjian 分享了这个主题。Bruce 是 PGDG 发起人,从一开始到现在一直都是 PG 核心委员,也是中国各种 PG 会议的老熟人与常客了。
我本来以为分享的内容会是介绍一下PG生态的向量数据库扩展,或者类似 PGML,PG4ML 这样的机器学习扩展插件,结果竟然是如何利用 PostgreSQL 的多维数组与查询,实现神经网络的推理与训练。这样的把戏很好玩儿,但我很早也折腾过,没啥实用价值。
和 Bruce 吃饭聊天的时候也提到这个话题,Bruce 解释说,Jonathan Katz 为了介绍PG生态的向量数据库扩展 PGVector,需要一个话题来作为综述引子,于是就把 Bruce 拉壮丁过来灌水了,哈哈… PDF地址
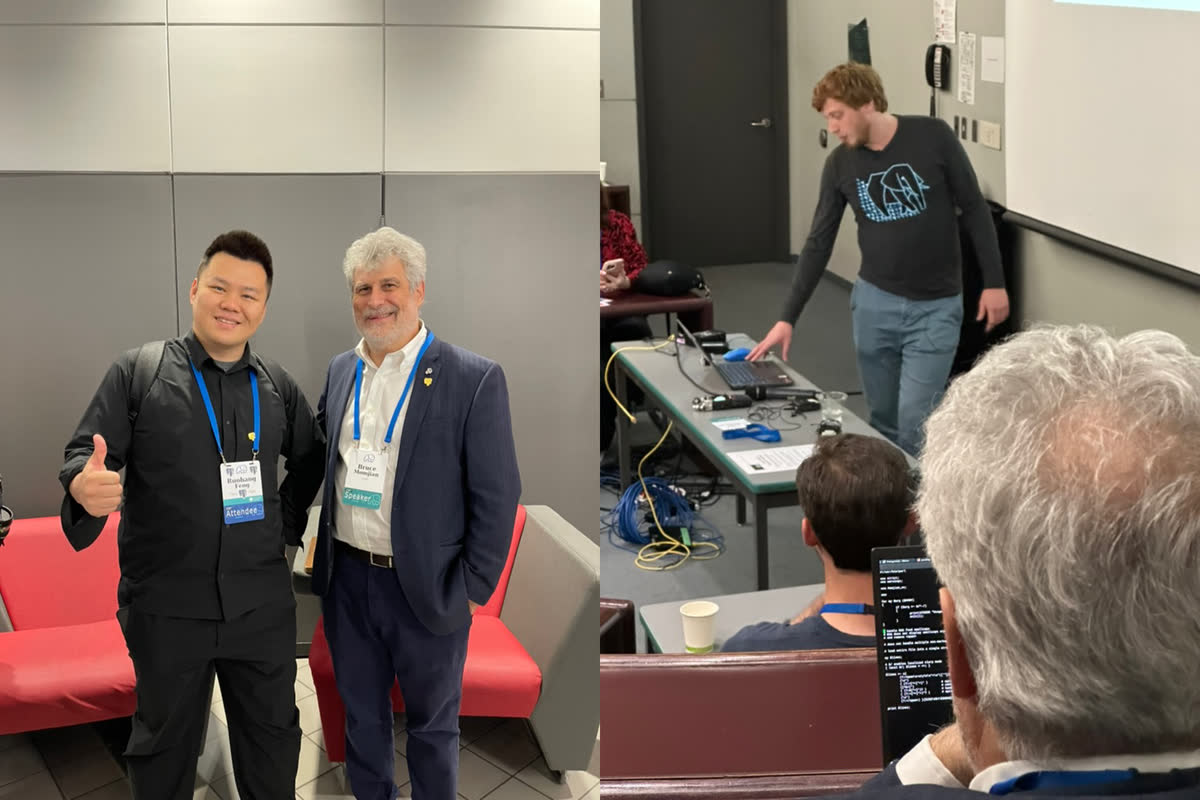
让我看看,Bruce在偷偷写什么代码?竟然是 ArgParser
会后和 Bruce 聊了很多有趣的话题,往年国内 PG 技术大会都喜欢请 Bruce 过来,或者远程做一个开幕分享。Bruce 说他很想再来中国,不过现在国际形势冲突加剧,美国大使馆发布的中国旅游风险等级太高,他也不敢过来了,让人遗憾。
构建PB级别的PostgreSQL部署
下午第三场,Chris Travers 介绍了他们从 Elasticsearch 迁移到分区、分片 PostgreSQL 部署的经历。按他的报告,原系统保留 30 天的数据,规模为 1 PB;迁移后的 PostgreSQL 部署存储了 10 PB 数据。
让我印象深刻的是这套系统在 10 PB 规模下的运维经验。演讲幻灯片介绍了这个具体案例。
临时加场:当数据库遇上新硬件
这是本次大会中我最喜欢的演讲。Margo Seltzer 是 UBC 教授、美国国家工程院院士,曾任教于哈佛,也是 BerkeleyDB 的作者之一。
Margo 的演讲极具激情与感染力,并一针见血地指出了数据库领域面临的几个核心问题。例如,数据库的瓶颈已经不再是磁盘的IO性能,而是主内存的速度瓶颈。而硬件领域的趋势 —— HBM,CXL 也许是解决这些问题的答案,但具体怎么做,那就是在座的各位 PG Hacker 需要面对的挑战了。
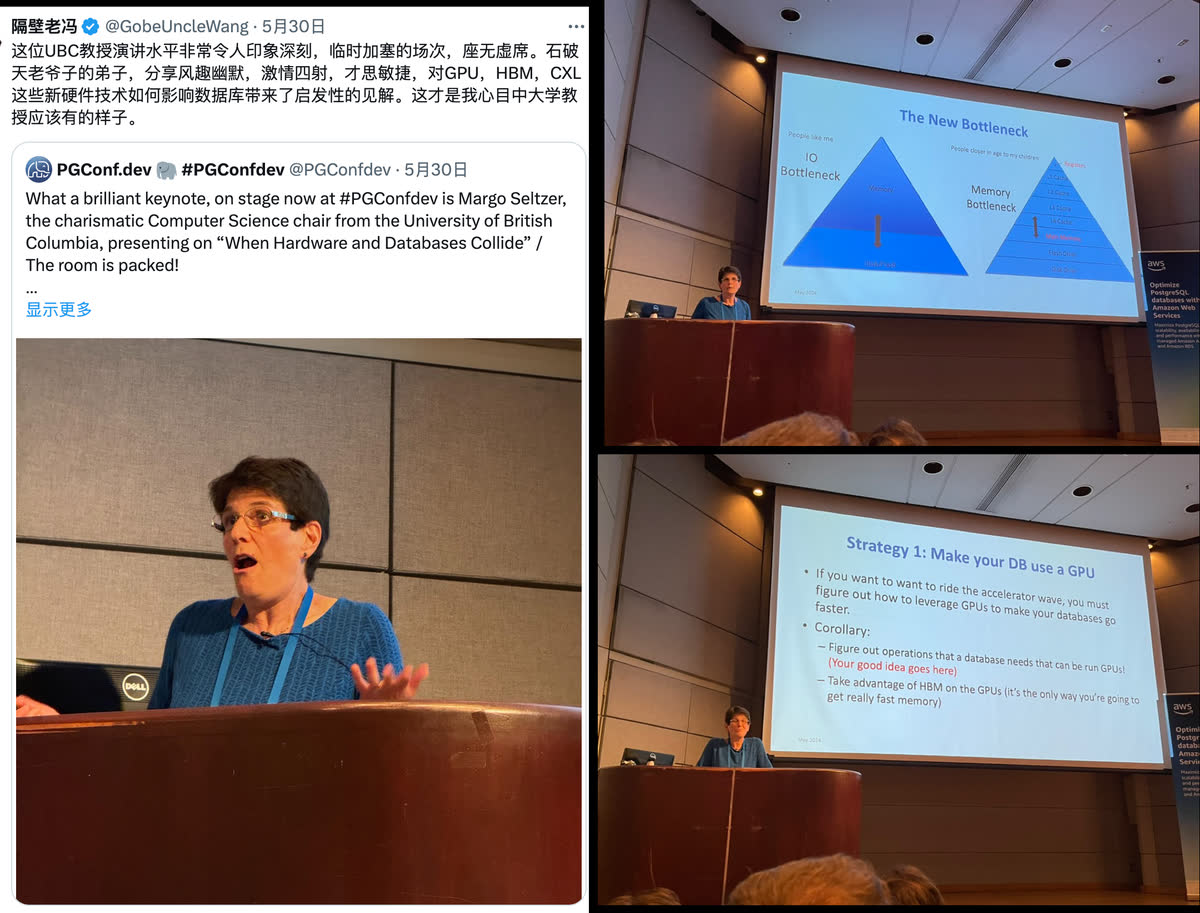
我很喜欢 Margo 直接而有感染力的演讲方式。大会视频发布后,值得再听一遍。
酒吧社交活动
Margo 的分享结束后便是大会的官方 Social Event,在会场一街之隔的 Waterfront 车站里的 Rogue Kitchen & Wetbar, 位置极好 —— 窗外就是温哥华地标,太平洋海景。
大家可以随意交流,结识新老朋友。我和许多人都聊了很多有趣的话题,比如 Devrim,Tomasz,Yurii,Keith 等等等等。同样作为发行版/RPM维护者,我和 Devrim 老爷子尤其详谈甚欢,许多积存已久的问题也得到了想要的答案。
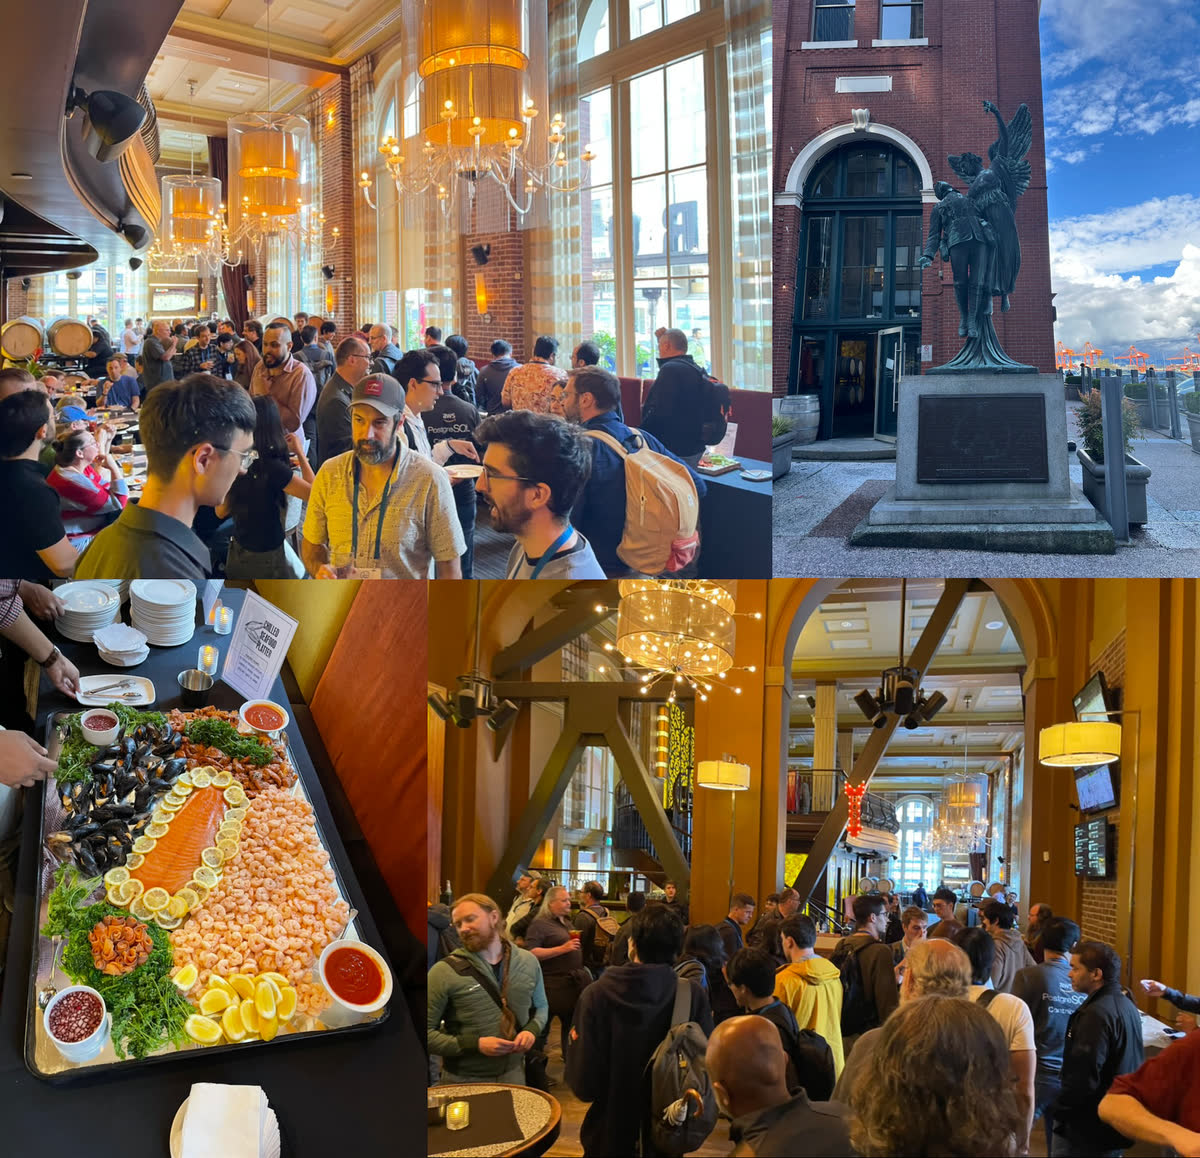
很多人都是老朋友了,难得相见一面,都聚在一起聊天。两杯啤酒下肚,许多人都打开心扉。再加上在场的都是 PG 同好,陌生人只要对个眼神也可以很轻松地聊起来。
于是在三四个小时的觥筹交错中,我和在场的 PG Hacker 基本都混了个熟脸。餐后 Melanie 喊我们去玩桌游,但我的英语做个专业演讲还行,但还没好到和 Native Speaker 玩猜词游戏和狼人杀的程度,甚是遗憾。
第二天的主题与活动
PostgreSQL 线程模型
第一天晚上的社交活动预热完,第二天大家就热情熟络得多了。今天的分享主题比较值得一提的是 “多线程 PostgreSQL”,成功做到了座无虚席。大家都很关注 Heikki 发起的这场讨论。Heikki 介绍了PG进程模型与线程模型的利与弊,详细实现路径与当前进展。
线程模型的收益有不少:更便宜的连接(等于内置连接池),共享的关系缓存,计划缓存,动态调整共享内存区域的能力,修改配置无需重启,Vacuum可以更加激进,运行中的 Explain Analyze,方便地限制每条连接的内存使用。但以 Tom Lane 为首的反对的声音也不小:这样可能会引入大量 Bug,丧失多进程模型隔离性的优势,以及 —— 引入大量的不兼容性,许多扩展都需要针对新的模型重写修改。
Heikki 提出了目标与相当详细周密的计划供在座的 Hacker 们评审 —— 在五到七年内,完成到线程模型的转换,最终目标是没有中间状态。有趣的是,Heikki现场在 PPT 里引用了最大反对者 Tom Lane 的一段评论:“在此说明,我认为这会是一场灾难,导致大量代码悄无声息的崩坏,让事情脱离我们的控制”。
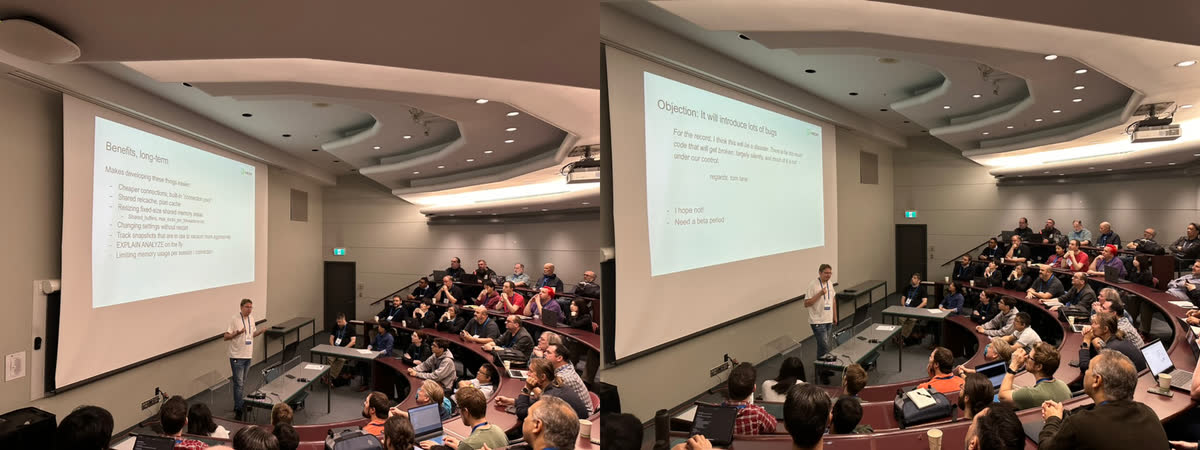
虽然被当场揶揄,但这一次 Tom Lane 现场听着也是慈祥微笑,并没有直接表示反对。而最大的反对声音不是来自 Tom Lane,而是扩展维护者,一位维护了好几个扩展插件的老爷子问到扩展兼容性怎么办?(主要是分配/使用内存的方式)Heikki 表示只能要求这些扩展作者在五年左右的过渡期内重写修改适配新的模型。气得这位老爷子直接愤而离场出去了。
鉴于线程模型对现有扩展生态的巨大冲击,我对这件事并不看好。我也与 Heikki 和 Tom lane 以及其他 Hacker 聊了一下关于线程模型的观点,总的来说,社区持谨慎观望态度。目前的进展也仅仅是在 PG 17 中重构了与 fork exec 有关的调用代码,并标记出使用的全局变量以便后续修改。即使真得发生,那也至少是 PG 2x 的事了。
走廊社交与大厅闲聊
第二天议题场次比第一天稍微水了一点点,所以更多的人参加的是 “Hallway Track”,就是在走廊大厅里和别人聊天。作为一个 i 人,我其实蛮不擅长这种场合的,但现场热烈的氛围很快就感染了我。再加上昨天晚上的酒吧社交环节大家也混了个脸熟,所以也算轻车熟路了。
在这样的场合中,想要开启一场和陌生人的对话,其实非常简单。你也不需要主动搭讪或者咋样,就只要眼神接触一下,对话就自然而然地触发了。给我的感觉和打 RPG 游戏一样,按下空格触发 NPC 对话。然后自我介绍一下,说说自己干嘛的,这不是就顺便把 Pigsty 广告到 PG 社区的每一个角落啦?
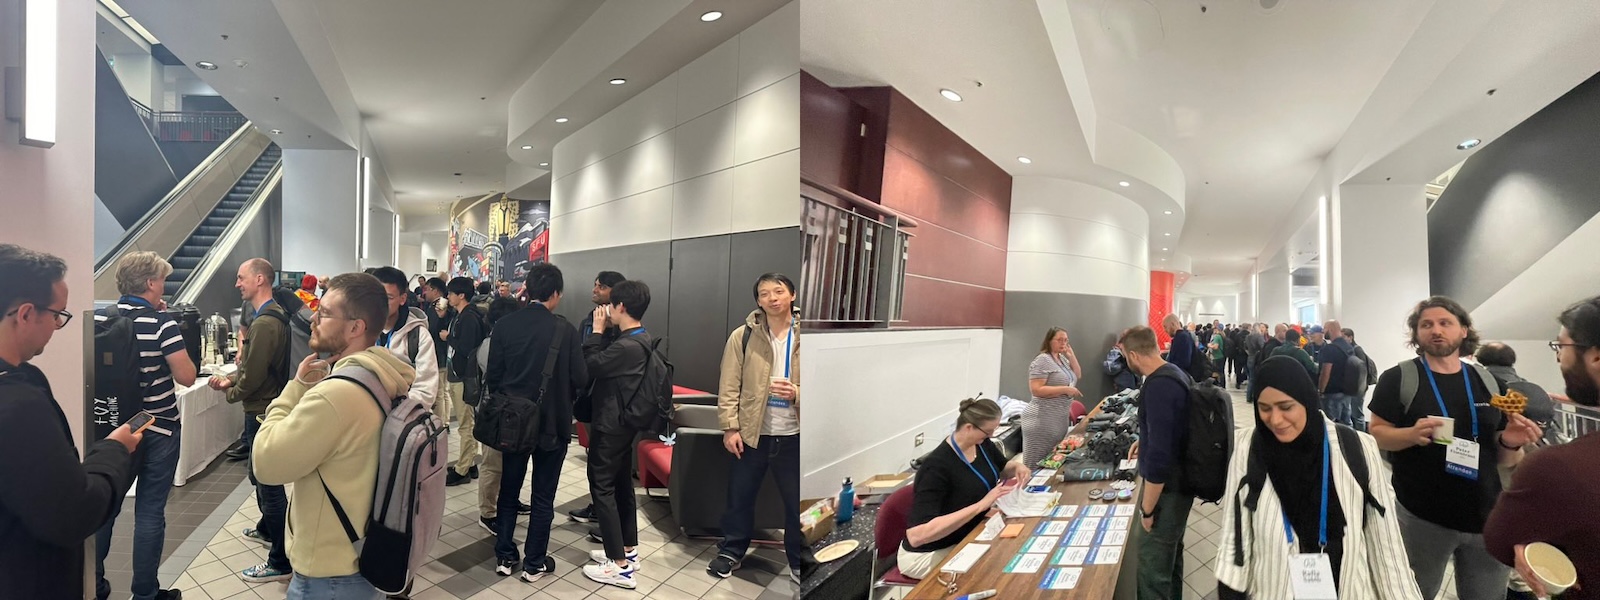
作为第一次现场参加 PGCon.Dev 的人,我很惊讶地发现自己有着与新人不匹配的知名度与关注度。有近半的参会者看到我的胸牌 Vonng / Pigsty 就认识我了 —— 主要还是归功于我之前写的那篇 PG 大爽文《PostgreSQL is eating the Database world》,Jonathan 跟我吐槽到说最近这篇文章天天出现在他的时间线上,整个 PG 社区的人基本上都看过了。
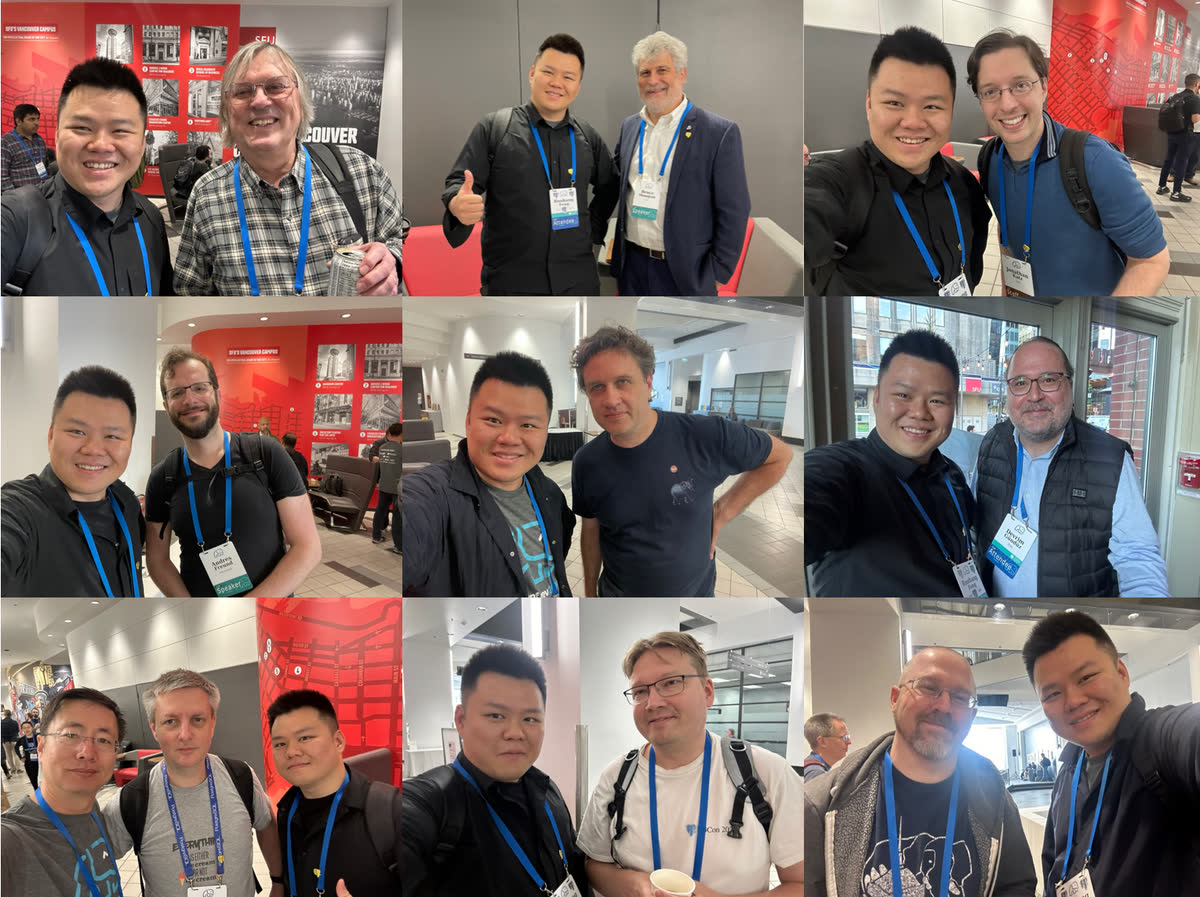
合影:Tom, Bruce, Jonathan, Andres, Robert Haas, Devrim, Scherbaum, Heikki, Keith,…
当然说起社交,最简单粗暴的诀窍就是礼多人不怪 —— 我准备了一盒胸针,PostgreSQL 的吉祥物 Logo Slonik,镀金的,还带个小亚克力盒子。我给每一个和我聊天的 PG Hacker 都送了一个,这个胸针成为了本次大会备受欢迎的抢手货。好多人都在胸前或者会牌上别上了,而没拿到的人就在问:咦你们这个在哪里拿的,是贡献者奖励吗?
Bruce 对这个胸针爱不释手,说:“哎呀这个精巧的徽章真是太可爱了,一看就不是那种便宜货”(但其实镀金其实不贵的),然后我就又送了他一个。总之,礼多人不怪,靠着 Pigsty,PG爽文,和 Slonik 小胸针,也算是在 PG 大会上吃开了。
小聚:多国社区会餐
中午,瀚高做东,把美国PG社区,欧洲PG社区,还有日本PG社区的几位头面参会者拉到一起聚餐,一家温哥华的广东菜馆。图中从左前开始逆时针顺序分别是,瀚高北美研究院的 Grant Zhou,瀚高创始人苗健,欧洲PG用户组/ Neon 的 Andreas Scherbaum,有PG核心组/ 美国EDB 的 Bruce Momjian,荣誉退休的前核心组成员 / pgEdge 的 Jan Wieck,制作各种PG贡献者硬币,社区周边的 Mark Wong,以及日本社区的 Tatsuro Yamada (山田達郎)与 Kyotaro Horiguchi (堀口恭太郎),最后是我。
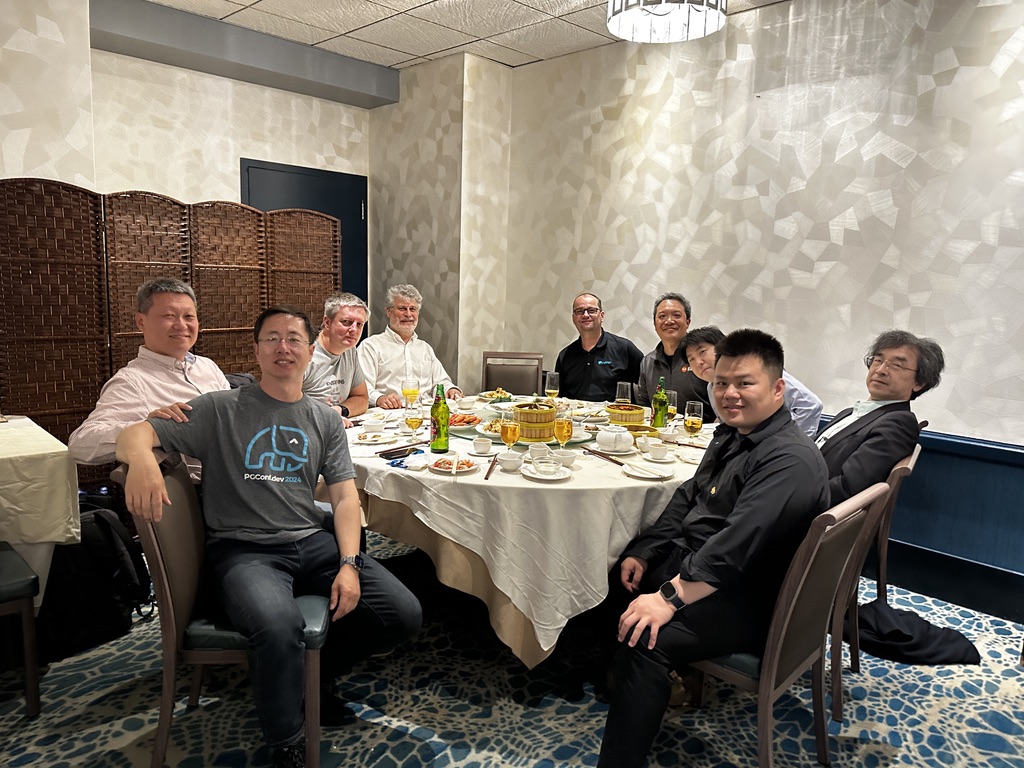
在饭桌上我们聊了各种各样的话题,坐在我边上的两位日本 PG 社区友人很有趣,堀口桑是一位 PG 核心贡献者,在 WAL 复制 / 多字节字符串处理上有很多贡献,还是 pg_hint_plan 的作者。另一位山田桑也是 PG 贡献者,对 Pigsty 很感兴趣,在本次大会上进行了题为 《索引建议不受待见,但很管用》的分享。
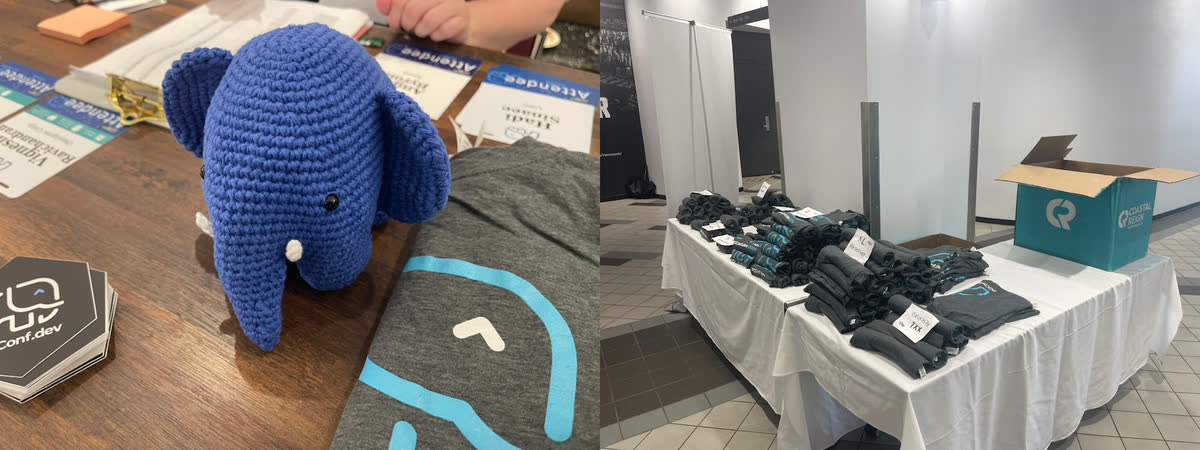
Mark Wong 也是 PG 社区的主要贡献者,PGUS 的组织者,开发了一系列 PG 监控扩展,但更有趣的是他还负责 PG 社区的周边,贡献者硬币,衣服,贴纸,还有这个特别可爱的毛线团小象也是他自己手工缝制的,让人爱不释手。据说他上次做的公仔在 PG Conf US 被人顺走了哈哈,所以这次看得可牢了。
Bruce 是 PG 中文社区的老朋友了,上面介绍过了;来自德国的 Andreas Scherbaum 是欧洲 PG 大会的组织者,我们一起参加了扩展峰会的 Binary Distribution 讨论,也邀请我们到时候去参加;瀚高是唯一一个出现在 PGCon.Dev 的中国数据库厂商,苗总从山东飞过来参加,也跟我们分享了一些国产数据库的故事与密辛。
在回会场的路上,我和 Jan Wieck 聊了很多,他是老一代光荣退休的 PG 核心组成员,也是 PL/pgSQL,PL/TCL,外键,视图,规则系统,TOAST,BGWriter,统计进程这些耳熟能详的PG核心功能的作者,他也是 Slony 的作者。路上我说我也想当一个 Major Contributor,他便与我分享了他参与 PG 贡献的故事:银行职员,工作需要用到数据库,就慢慢开始一步一步变成核心贡献者了 —— 他勉励我更多地参与到 PostgreSQL 贡献来,PG社区的未来就看你们年轻人的了。
让PG社区参与更有包容性
第二天下午与昨天一样,有一个无需三选一的特殊场次,主题是 社区建设,由 Robert Haas 主持。3 位新晋的 PG 提交者轮流分享他们成为提交者的历程,与遇到的挑战和问题,分别是:泽田正彦,阿米特·兰格特,梅兰妮·普拉格曼。总体上社区参与面临的几个主要挑战是:非英语母语者的参与问题,时区差异,带有情绪的电子邮件沟通。
Robert Haas 在会后的博客中提到:他真的很想看到更多来自印度与日本的人参与到 PG 的高级职位中来,因为这两个国家有着庞大的开发者社区,却没有核心组成员,高级职位代表性不足。
这场讨论提到了印度和日本,没有提到中国,让我有些感慨。我希望看到更多中国用户与开发者持续参与 PostgreSQL 上游。拓数派的 Richard Guo 当年刚成为 PostgreSQL committer。
据我了解,本次从中国前来参会的有瀚高的四位和我,共五人。
我希望自己的参与能帮助更多中文社区的用户和开发者建立联系,让他们的工作更容易被全球社区了解,也为后续合作创造机会。
闪电演讲
第二天下午的最后一个议程叫做: 闪电演讲。顾名思义,就是一个人只给5分钟,超时就立刻轰下来。大家都很干练,11 个主题整个才花了 45 分钟。在酒吧相谈甚欢的 Keith 分享了一些关于 PG Monitor 的改进,Peter Eisentraut 分享了关于 SQL 标准的跟进。当然,要说我最喜欢的分享,当属 Devrim Gündüz 关于 PG RPMs 的闪电演讲。昨天酒吧喝酒的时候,他神秘兮兮地说明天要放个大招,震撼全场,果不其然,在5分钟里讲完了 75 页的 PPT,气氛非常欢快~。
许多 PostgreSQL 用户直接安装二进制软件包。当时我为 Pigsty 维护 34 个扩展的软件包,Devrim 则在 PGDG RPM 仓库维护一百多个扩展。这些打包工作让更多用户能够安装和使用扩展。
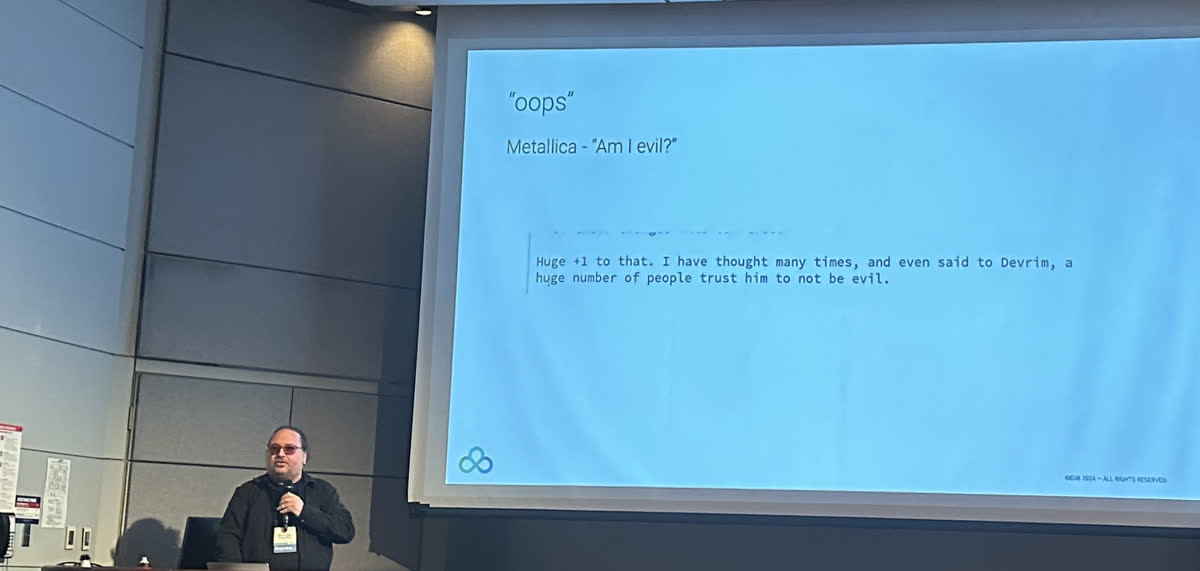
Devrim 要是想干坏事,那破坏力说不定比 xz 要大多了
Devrim 老爷子是一个很有意思的人,土耳其人,现居伦敦,还兼职酒吧 DJ 打碟,身上有一个 PostgreSQL Logo 的纹身,是 PGDG RPM 仓库的维护者。我跟他聊了一个多小时,了解了 PGDG 仓库的方方面面,讨论了许多问题。比如,一个扩展想弄进 PGDG 仓库里,一般需要什么条件,是什么流程。Devrim 说他会去关注 PGXN ,以及社区讨论,像最近大火的 pgvector 向量数据库扩展就是有人推荐给他,然后就收录进去了。我就白了一眼说:你看看推给你的那个人莫不是我…,哈哈哈哈。
说起来很有趣,在最近发布 Pigsty v2.7 中,我发现我维护的34个扩展里有4个 pgsql-http, pgsql-gzip, pg_net, pg_bigm 被纳入了 PGDG 官方仓库。我一和 Devrim 提起这个事,他就笑眯眯地跟说我:我跑到你的 Pigsty 网站扩展列表上扒拉了一圈,发现有几个不错的,就弄进官方仓库了。我就问,我打包的那些不错的 RUST 扩展有没有机会弄进官方仓库里?他马上义正严辞地表态 —— 这些 Go 和 Rust 异端插件想也别想!但反正你不是自己弄了个 YUM / APT 软件仓库专门放这些扩展吗?
我和 Devrim 聊得非常尽兴。最后我答应当一个 PG扩展猎手,发掘新的 PG 插件。如果觉得不错就交给他,收纳进 PG 的官方仓库里。
第三天:Unconference
如果说 PGCon.Dev 最精髓特色的节目是什么,那一定是 Unconference (自组织会议)。Unconference 没有预设的议程,而是由参与者在现场决定讨论的主题。
大会第三天全天的议程都是 Unconference,Joseph Conway 主持了 Unconference Organization 议程,愿意讲的人上去提交自己想介绍的主题,然后大家投票。当然我也上去提交了一个 Built-in Prometheus Metrics Exporter 的主题。
提交完后,每个议题主讲人上台简介自己的 Topic,并尽可能合并同类项,我的话题不出意料地被合入 Jeremy 发起的 Observability 主题里了。接下来就是大家投票选出感兴趣的演讲。排名前三的主题是: 多线程(42票),可观测性(35票),增强社区参与(35票)。 最后选出的主题如下:
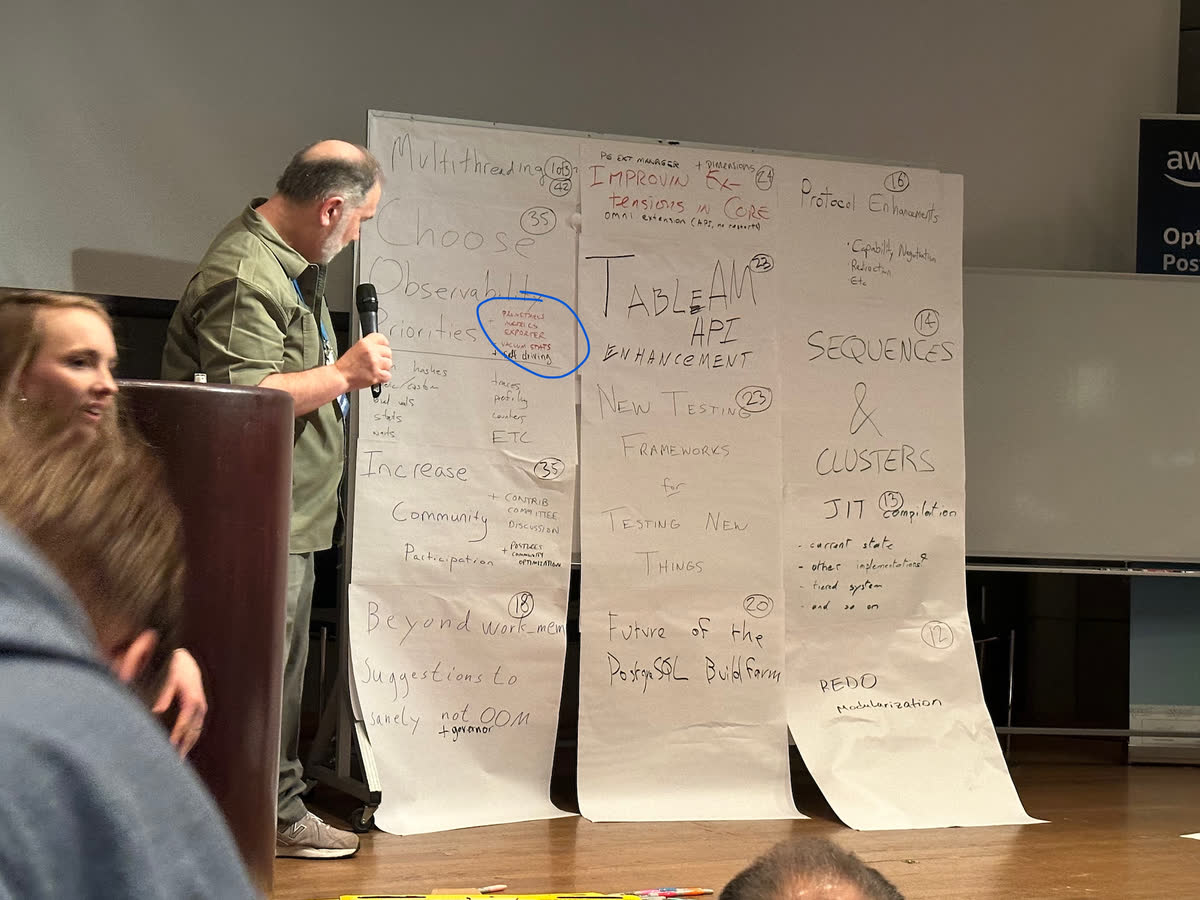
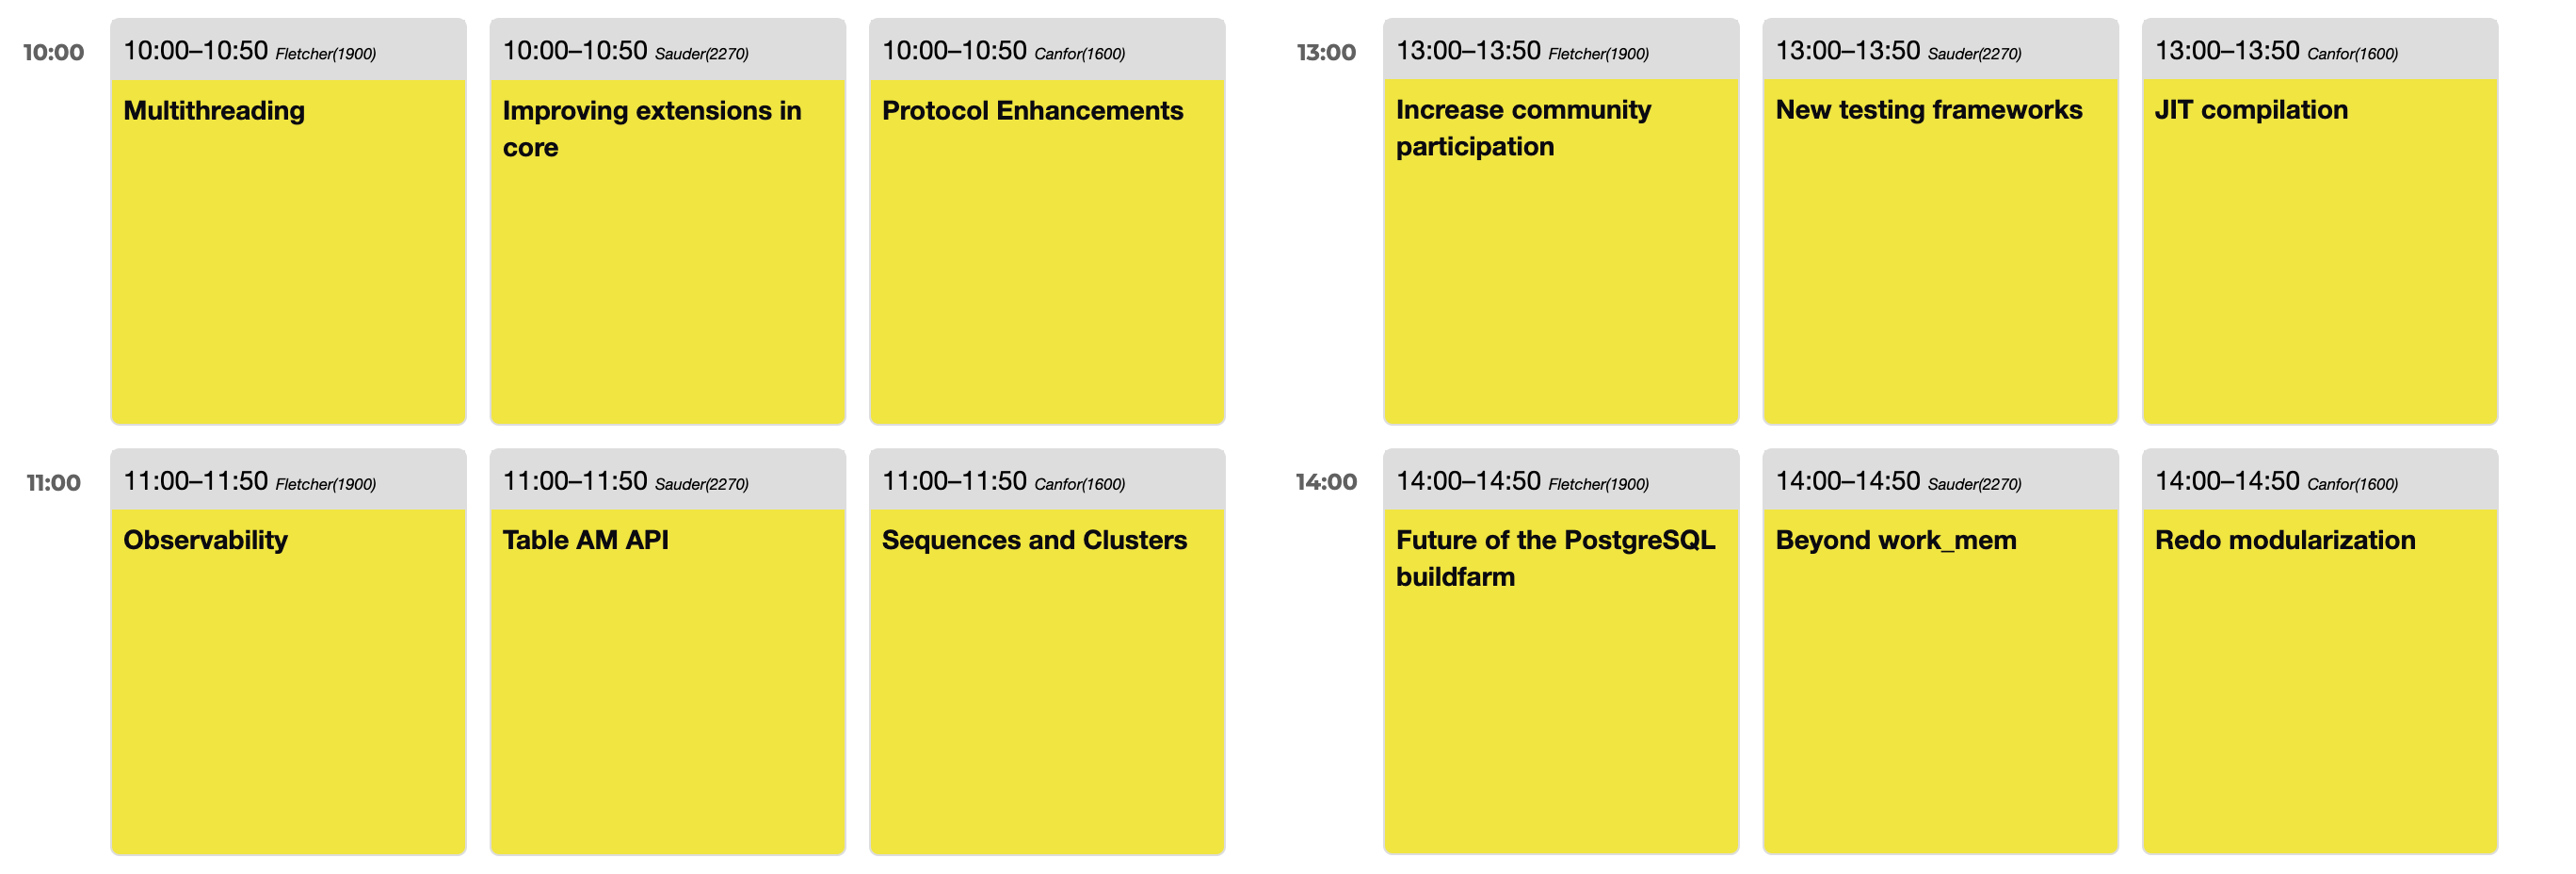
作为 pg_exporter 的作者,我提出为 PostgreSQL 添加第一方监控扩展,内置 Prometheus 端点,通过 HTTP 提供指标。
这个提案希望减少管理独立 Exporter 的工作,并在崩溃恢复等无法接受 SQL 连接的阶段提供内部状态。这些能力仍需要在 PostgreSQL 中实现和验证。
实现的方案是采用类似 bgw_replstatus 扩展使用的后台工作进程,监听一个额外端口,通过 HTTP 对外暴露监控指标。内容上基本上也以我编写的 pg_exporter 作为蓝本,除了少量系统关键指标外,所有指标都通过一张 Collector 配置表进行定义。
这个想法得到了一些在座 PG Hacker 的关注。EDB ,CloudNativePG 的一些开发者也开始评估 pg_exporter 能否直接用在他们的发行版中,作为监控解决方案的一部分。现场所有对可观测性感兴趣的成员成立了一个 Observability SIG,并通过邮件列表进行后续的讨论。
议题:关于对龙芯提供支持
在大会最后两天中,我还与几位 PG Hacker 讨论了一些关于国产芯片,国产操作系统,中文字符集相关的中国特色数据库议题。
在之前发出的问题征集中,PG分会的类总提出了一个很好的建议,能不能让 PGDG 全球仓库支持龙芯 LoongArch 架构?国产芯片和国产操作系统厂商很乐意赞助这样的构建环境。带着这个问题,我询问了 RPM 仓库维护者 Devrim 老爷子;以及 Debian 侧的 Tomasz Rybak (备注:PGDG APT 仓库的维护者是 Christoph Berg,但 Tomasz 维护了 Debian 仓库中许多 PostgreSQL 相关的软件包),看看有没有可行性。
不过可惜的是,目前龙芯架构对于PG社区构建二进制使用的 OS 还没有提供支持 —— 例如 EL 系的 CentOS 7,Rocky 8,Rocky 9 ,以及 Debian 10/11/12 都无法在龙芯上运行。所以 Devrim 老爷子的回答是 No:而且构建的 Pipeline 必须在他们自己的机器和环境上可以跑起来,所以赞助云服务器的方式可能是走不通的。Tomasz 对于这个问题持开放态度,因为据说后面龙芯可能会支持 Debian13 ,那么就可以考虑把一些 PG 包的支持加进来。
总的来说,让 PG 官方 RPMs 支持龙芯架构估计没戏,但 APT 还是有可能的。但要龙芯支持主流开源社区 Linux OS Distro,这个事才有可能;如果是龙芯 + 一堆国产操作系统,那想都不要想,100% 没戏。
议题:关于服务端中文字符集支持
Jeremy Schneider 的分享介绍了排序规则变化带来的问题。他对简单、稳定排序方式的偏好,与我自己的实践相近。演讲幻灯片详细说明了其中的取舍。
会后在大厅里,我和 Jeremy 进一步地讨论了这个问题,核心组的 Peter Eisentraut 也参与了进来。Jeremy 问我中国用户是怎样使用字符集与 Collation 的,我说新应用大体上都用的是 C.UTF8,通常只有一些政企单位和传统行业的老系统才会去折腾服务端中文字符集。
我们还讨论了信息系统对 GB18030 字符输入、输出、处理和编码识别的兼容需求。
PostgreSQL 当时支持 GB18030 客户端编码,也可以通过 convert_to 转换为这种编码的字节串,但不支持将它用作服务端编码。ICU 排序规则也不会增加服务端编码支持。我还向 Peter 提出,convert_to(..., 'gb18030') 对大约 20 个新增汉字可能存在映射问题。Jeremy 和 Peter 都表示会继续调查。
闭幕式
自组织会议聊完后,大会也进入到了最后的尾声。 Jonathan Katz 与 Melanie Plageman 主持了闭幕式。确实是一场非凡的大会,让人意犹未尽。
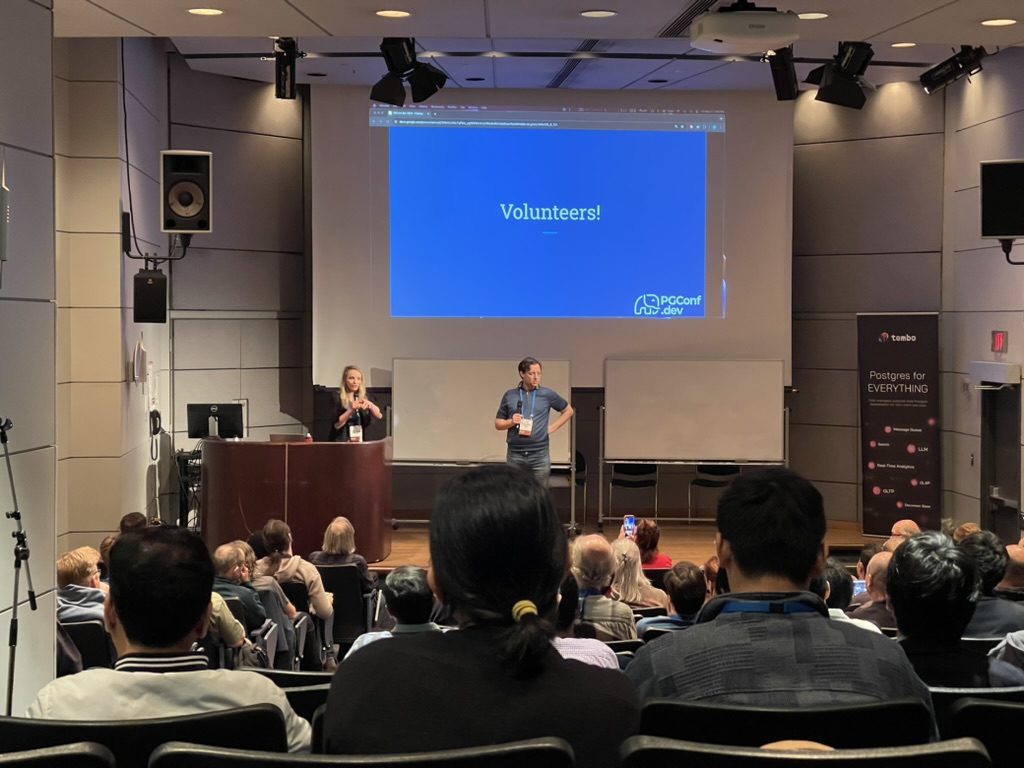
明年的 PGCon.Dev 2025 也会在加拿大举办,可能在温哥华,多伦多,渥太华或蒙特利尔四者之一。今年摸清楚了大会的调性与流程,我想明年可以去上台分享一个关于 Pigsty 或者 PG 可观测性的话题了。
顺带一提,参会的效果确实很明显,参会后,Pigsty 的海外下载 CDN 流量(这还只是一家云上的一部分)出现显著增长,打掉了我接近大几百G 的流量。更多的国际友人了解到了国内的 PostgreSQL 数据库发行版 Pigsty,哈哈。
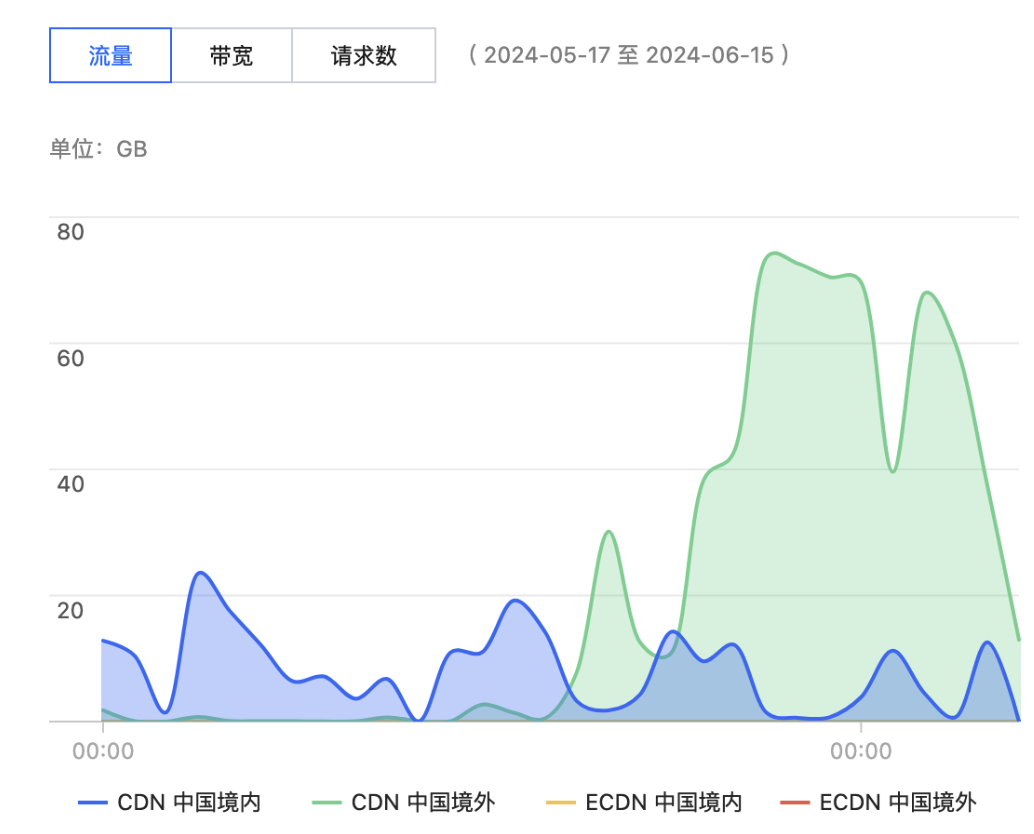
参会后来自海外的 CDN 流量有了一波暴增
大会的 PPT 一部分已经开放下载。当然,对 PostgreSQL 与 Pigsty 感兴趣的朋友也可以微信搜索 pigsty-cc 加群直接下载或参与讨论。以及,下面是一些 PGCon.Dev 相关的博客与文章:
1.3 - PostgreSQL 宏观查询优化之 pg_stat_statements
本文记录 2023 年的监控方法,示例采用 PostgreSQL 15 的字段和当时的监控面板。
参考原文:Nikolay Samokhvalov 的 PostgreSQL HowTO: pg_stat_statements 系列(第一篇、第二篇、第三篇)。
慢查询会增加响应时间和资源消耗,也可能延长锁等待,增加连接压力。因此,查询优化是 DBA 的核心工作之一。
在查询优化这条路上,有两种不同的方法:
宏观优化:整体分析工作负载,对其进行剖分下钻,自上而下地识别并改进其中表现最糟糕的部分。
微观优化:结合执行计划、慢查询日志和等待事件,分析并改进一条具体查询。
今天我们先来说说前者,宏观优化 有三个主要目标与动机:
减少资源消耗:降低资源饱和的风险,优化CPU/内存/IO,通常以查询 总耗时/总IO 作为优化目标。
改善用户体验:最常见的优化目标,在OLTP系统中通常以降低 查询平均响应时间 作为优化目标。
平衡工作负载:确保不同查询组之间的资源使用/性能表现的比例关系得当。
这些目标需要查询级别的数据支撑。pg_stat_statements 就提供了这些数据。
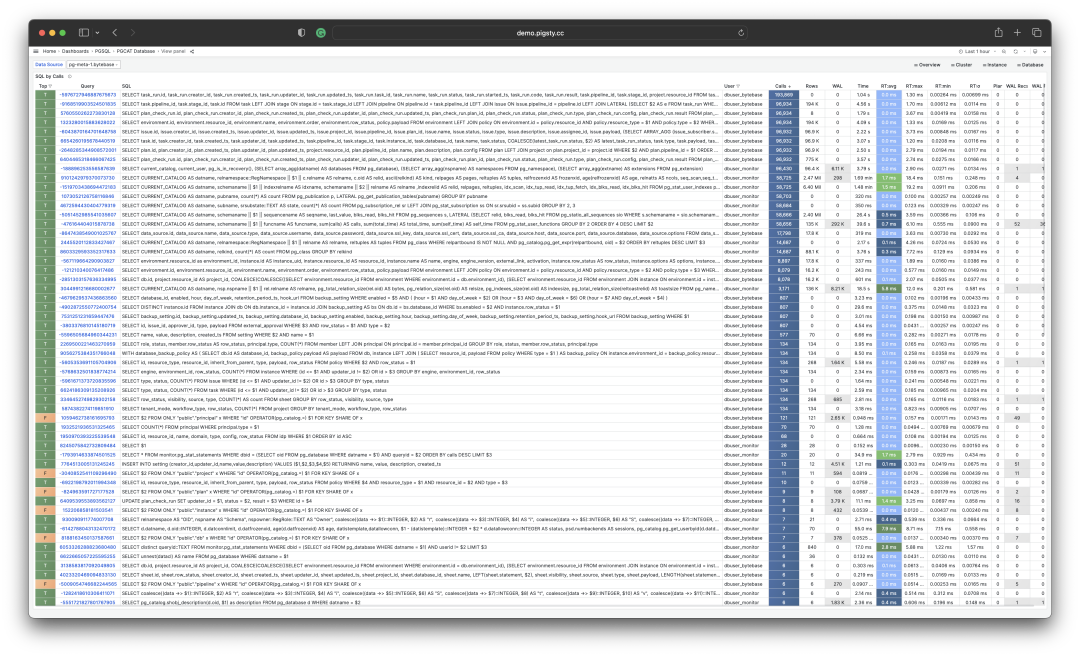
扩展插件:PGSS
pg_stat_statements,以下简称 PGSS ,是践行观宏之道的核心工具。
PGSS 出自 PostgreSQL 全球开发组官方之手,以第一方扩展插件的形式,随数据库内核本体一并发行,提供了跟踪 SQL 查询语句级别指标的方法。
我认为 PGSS 是生产监控的必备扩展。本文写作时,Pigsty 默认加载 PGSS 和 auto_explain,后者用于分析具体查询的执行计划。
将 pg_stat_statements 加入 shared_preload_libraries,重启 PostgreSQL,再在需要访问统计视图的数据库中执行 CREATE EXTENSION pg_stat_statements。PostgreSQL 15 还需要启用查询 ID 计算,默认的 compute_query_id = auto 即可满足要求。
PGSS 按规范化查询结构、数据库、用户和是否为顶层语句分组。同一查询组可以采用不同的执行计划。下面用建表语法展示 PostgreSQL 15 视图的字段;安装时应创建扩展,无需执行这段定义。
PostgreSQL 15 视图字段。所有时间字段的单位均为毫秒。下文的 pg_query_exec_time 指标将执行时间转换为秒。I/O 耗时需要启用 track_io_timing,计划统计需要启用 pg_stat_statements.track_planning。
执行统计在语句成功完成后更新。正在执行的语句看 pg_stat_activity,错误看日志。如果计划阶段成功、执行阶段失败,PGSS 仍可能记录计划统计。
queryid 取决于解析后的查询及其引用的数据库对象。物理副本通常具有相同的 ID。跨 PostgreSQL 大版本、逻辑副本,或删除后重建对象时,不应将它用作永久标识。
原始数据
PGSS 视图中的列可以分为三类:
描述性的标签列(Label):查询ID(queryid)、数据库 ID(dbid)、用户(userid),一个顶层查询标记,和标准化的查询文本(query)。
测量性的指标(Gauge):与最小、最大、均值标准差有关的八列统计量,以 min,max,mean,stddev 作为前缀,以 plan_time 与 exec_time 作为后缀。
累积性的指标(Counter):除了上面八列与标签列的 其他指标,例如 calls、rows 等,最重要、最有用的指标都在这一类里。
首先解释一下 queryid:queryid 是查询语句被解析后,剥离常量后生成规范化查询的哈希值,因此可以用来标识 同一类查询。不同的查询语句可能有着同样的 queryid (规范化后结构一样),同样的查询语句也可能有着不同的 queryid (例如因为 search_path 不同,导致实际查询的表不同)。
同样的查询可能会在不同的数据库中被不同的用户所执行。因此在 PGSS 视图中,queryid,dbid,userid,toplevel 四个标签列,共同组成了唯一标识一条记录的“主键”。
对于指标列而言,测量性质的指标(GAUGE) 主要是执行时间与计划时间相关的八个统计量,然而用户没有办法很好地控制这些统计量的统计范围,所以实用价值并不大。
真正重要的指标是 累积性的指标(Counter),例如:
calls :此查询组发生了多少次调用。
total_exec_time + total_plan_time:查询组累计耗费时间。
rows:查询组累计检索或影响的行数。
shared_blks_hit + shared_blks_read:缓冲池累计命中和读取操作次数。
wal_bytes:此组中的查询累计生成的 WAL 字节数。
blk_read_time 和 blk_write_time:累计花费在块读写IO上的时间
这里,最有意义的指标是 calls 与 total_exec_time,可以用于计算查询组的核心指标 QPS (吞吐量)与 RT(延迟/响应时间),但其他的指标也很有参考价值。
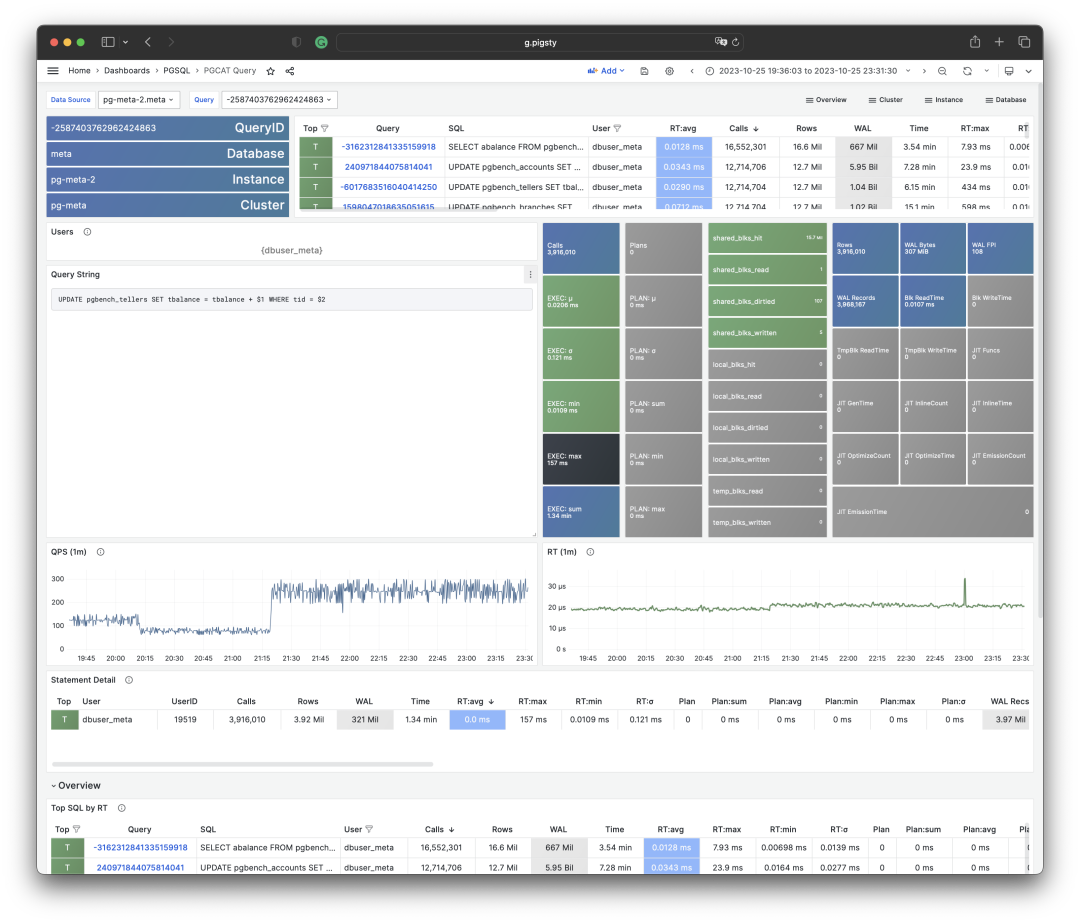
可视化展现 PGSS 视图的某个查询组快照
要衡量一段时间内的活动,至少比较两个快照。先匹配相同的查询组标识,再处理计数器重置或条目淘汰,最后计算差值。
单个快照表示该条目自开始统计以来的累积工作量。分析具体故障时,时间窗口内的增量更有用。
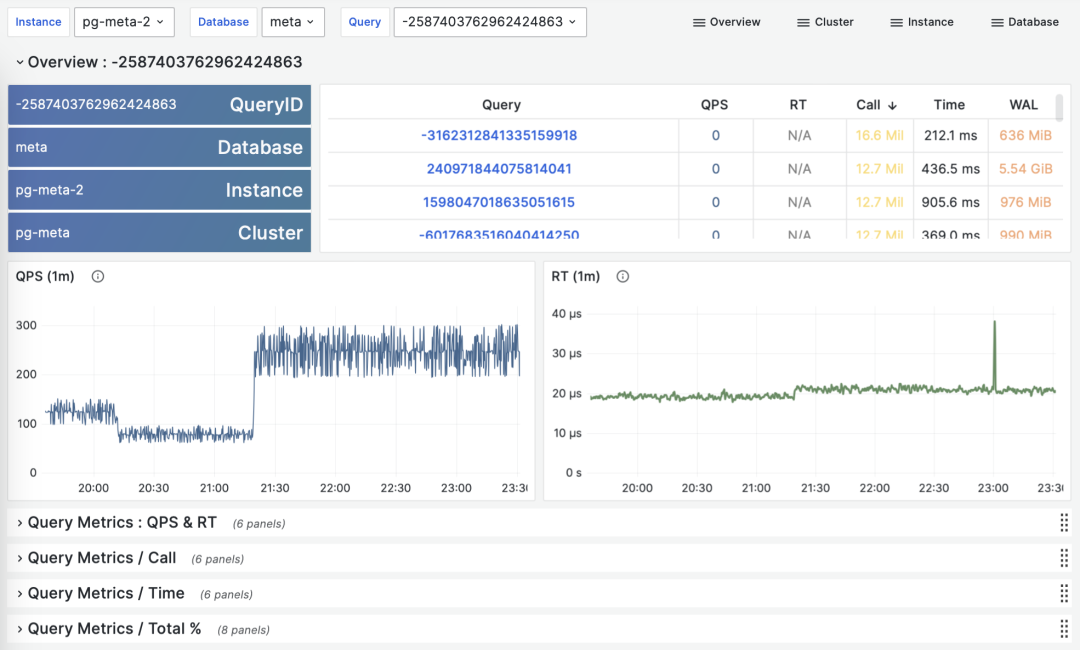
根据多个 PGSS 查询组快照计算历史时序指标
本文所用的 Pigsty 部署每隔 10 秒截取总耗时排名前 256 的查询快照。有了累积指标 M 在不同时刻的采样,就可以计算三类派生指标:
dM/dt :指标 M 基于时间的微分,即每秒的增量。
dM/dc:指标 M 基于调用次数的微分,即每次调用的平均增量。
%M:指标 M 在整个工作负载中所占的百分比。
这三类指标正好与宏观优化的三类目标相对应,对时间的微分 dM/dt 揭示了 每秒资源使用量,通常用于减少资源消耗的优化目标。对调用次数的微分 dM/dc 揭示了 每次调用的资源使用量,通常用于改善用户体验的优化目标。而百分比指标 %M 展示了查询组在整个工作负载中所占的百分比,通常用于平衡工作负载的优化目标。
对时间微分
让我们首先来看第一类指标:对时间的微分。在这里,我们可以使用的指标 M 包括:calls,total_exec_time,rows,wal_bytes,shared_blks_hit + shared_blks_read,以及 blk_read_time + blk_write_time。其他的指标也有参考意义,但让我们从最重要的开始。
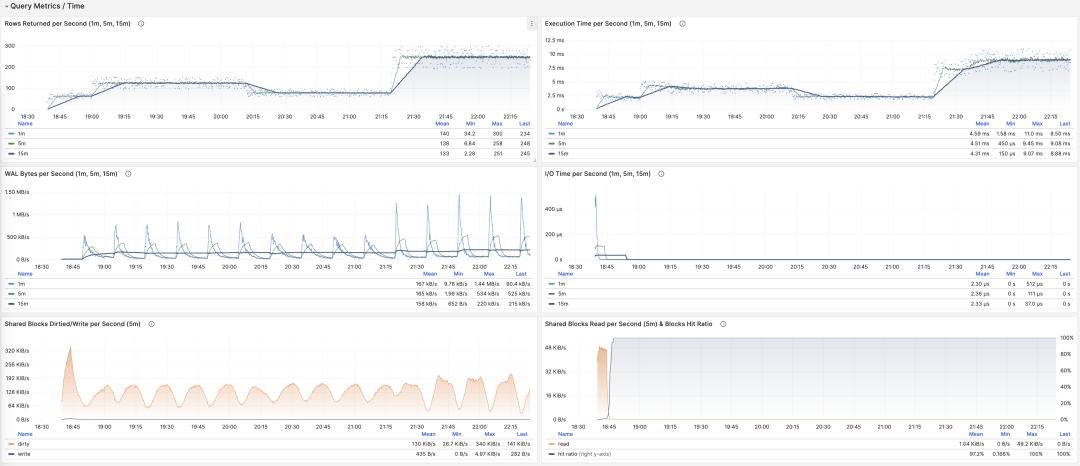
可视化展现对时间的微分指标 dM/dt
计算这些指标的方式其实很简单,我们只需要:
- 首先计算两个快照之间的指标值 M 的差值:M2 - M1
- 然后计算两个快照之间的时间差值:t2 - t1
- 最终计算 (M2 - M1) / (t2 - t1) 即可
生产环境通常会使用 5s,10s,15s,30s,60s 这样的数据采样间隔。对于负载分析通常会使用 1m, 5m,15m 作为常用的分析窗口大小。
例如,当我们计算 QPS 时,就会分别计算最近 1分钟,5分钟,15分钟的 QPS。窗口越长曲线就越平稳,更能反映长期变化趋势;但是会隐藏短期波动细节,不利于发现瞬时异常波动,所以不同粒度的指标需要结合来看。
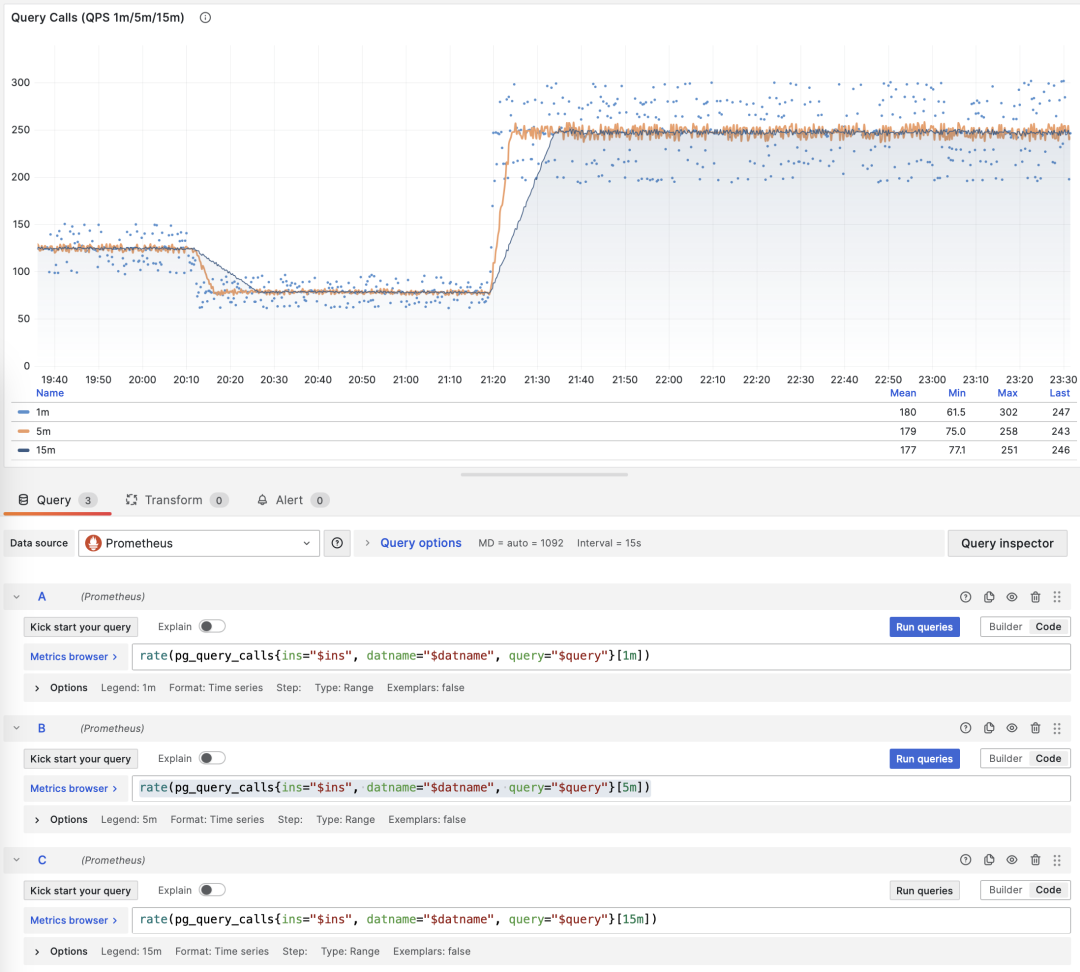
展示特定查询组 1/5/15 分钟窗口下的 QPS
例如,rate(pg_query_calls{}[1m]) 计算每条已采集查询组序列在最近一分钟内的 QPS。计算总量时,先筛选目标实例,再对这些序列求和。
QPS
当 M 是 calls 时,对时间求导的结果是 QPS,它的单位是每秒查询数(req/s),这是一个非常基础的指标。查询 QPS 属于吞吐量指标,直接反应了业务施加的负载状况,如果一个查询的吞吐量过高(例如,10000+)或者过低(例如,1-),有可能是值得关注的。
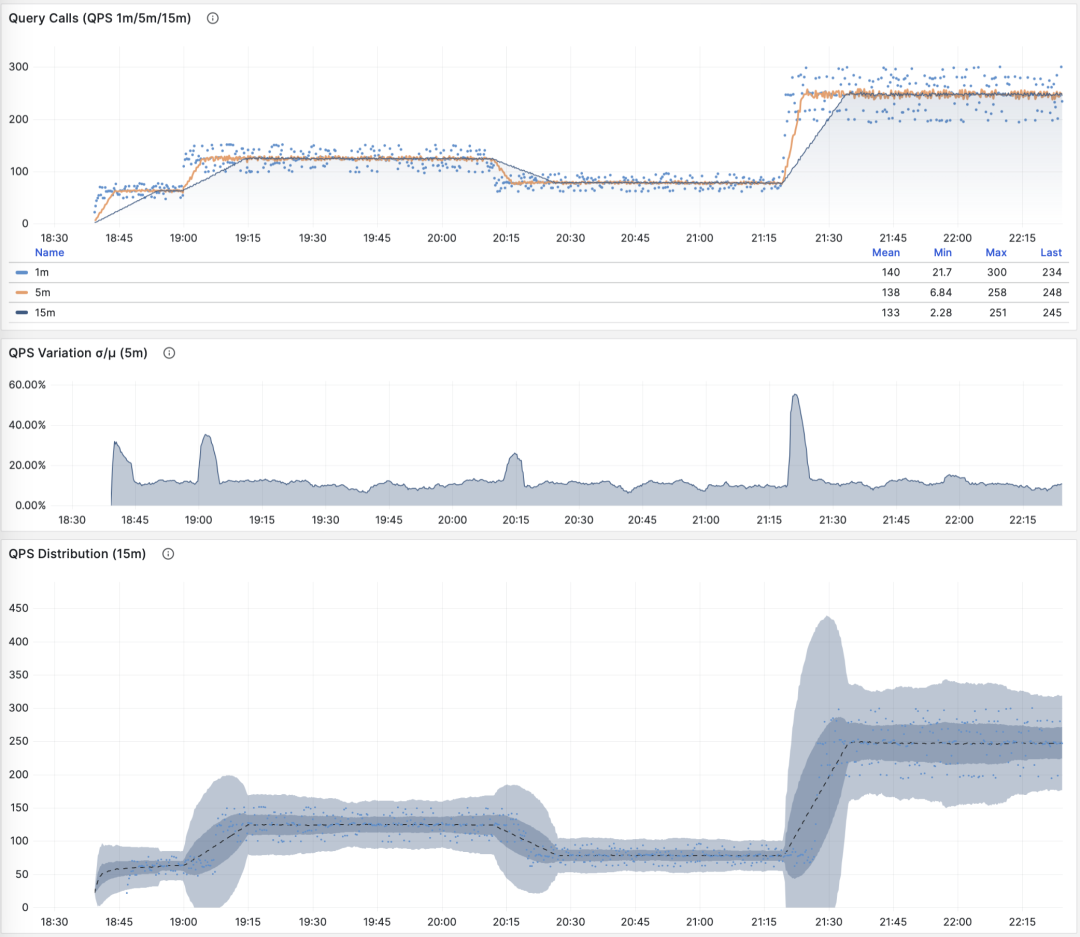
QPS:1/5/15 分钟 µ/CV, ±1/3σ分布
如果我们把所有查询组的 QPS 指标累加起来(且没超过PGSS的收集范围),就会得到所谓的 “全局QPS”。另一种获得全局 QPS 的方式是在客户端打点,在类似 PgBouncer 的连接池中间件上采集,或者使用 ebpf 探测。但都不如 PGSS 方便。
请注意,QPS 指标并不具备负载意义上的 横向可比性。不同查询组可能有着同样的 QPS,而单个查询的耗时却天差地别。甚至同一个查询组在不同时间点上产生的负载水平,也可能因为执行计划不同而发生巨大变化。每秒执行时长是一个更好的衡量负载的指标。
每秒执行时长
当 M 是 total_exec_time (+ total_plan_time,可选 )时,我们就会得到宏观优化中最重要的指标之一:在查询组上耗费的执行时间,有意思的是,这个导数的单位是 秒/每秒,所以分子分母相互约掉了,使得它实际上是一个无量纲的指标。
例如,2 s/s 表示这组查询每秒累积了两秒的服务端执行时间。多个后端并发执行即可产生这个值,即使只有一个 CPU 核也可能出现:执行时间包含等待时间。
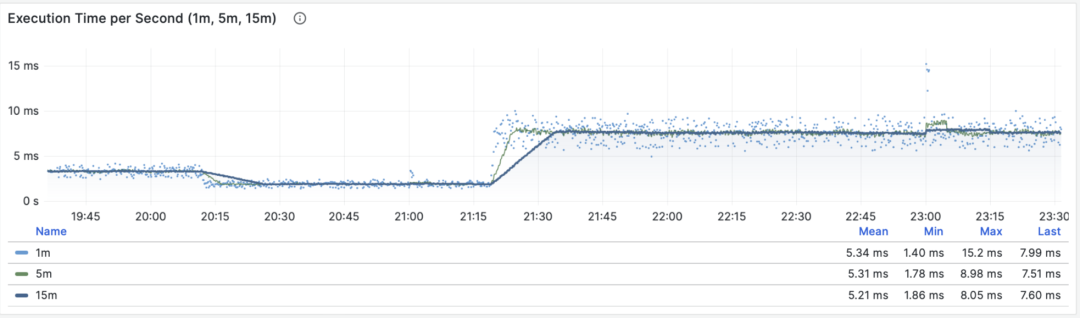
每秒执行时长:1/5/15 分钟均值
因此这里的值也可以理解为一个百分比:可以超过 100%,在这种视角下,它是一个类似于主机 load1, load5, load15 的指标,揭示了该查询组产生的 负载水平。如果除以 CPU 核数,甚至可以得到归一化的查询负载贡献度指标。
但是我们需要注意的是,执行时间中包括了等待锁,等待I/O的时间。所以确实可能出现这样的情况:查询执行时间很长,但却没有对 CPU 负载产生影响。所以如果要精细分析慢查询,我们还要参考 等待事件 来进一步分析才行。
每秒行数
当 M 是 rows 时,得到的是每秒检索或影响的行数。对于 SELECT 查询组,10000 rows/s 表示每秒产生一万行结果;对于 UPDATE 或 DELETE 查询组,它表示影响的行数,而不是发给客户端的数据量。
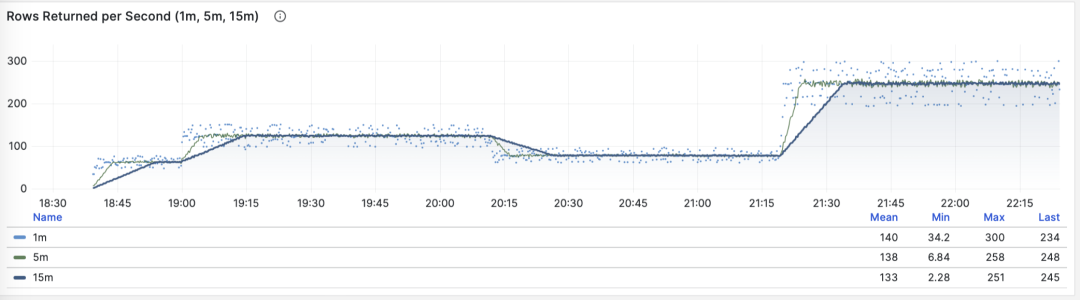
每秒检索或影响的行数:1/5/15 分钟均值
共享缓冲区访问带宽
当 M 是 shared_blks_hit + shared_blks_read 时,我们会得到每秒命中/读取的共享缓冲区块数,如果将其乘以默认块大小 8KiB(极少情况下有可能会是其他的大小,例如32KiB),我们就会得到一类查询“访问”内存磁盘的带宽:单位是字节/秒。
举个例子,如果某一类查询每秒访问50万次共享缓冲区,折合 3.8 GiB/s 的内部访问数据流:那么这就是一个显著负载,也许会是一个很好的优化候选项。也许你应该检查一下这个查询,看看它是否配得上这些“资源消耗”。
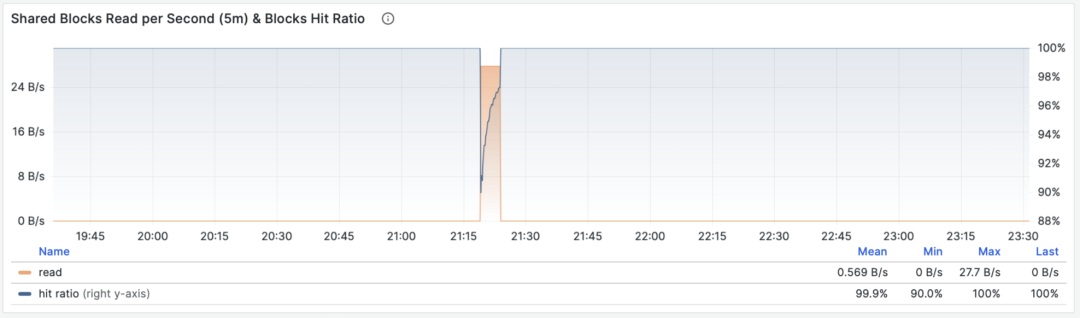
共享缓冲区访问带宽与缓冲区命中率
另一个值得参考的衍生指标是缓冲区命中率:即 hit / (hit + read) ,它可以用于分析性能变化的可能原因 —— 缓存未命中。当然,重复访问同一个共享缓冲池里的块,并不会真的重新读取,即使真的去读取,也不一定是读取磁盘,有可能是读内存中的FS Cache。所以这里只是一个参考值,但它确实是一个非常重要的宏观查询优化参考指标。
WAL日志量
当 M 是 wal_bytes 时,我们得到了该查询生成 WAL 的速率,单位是字节/每秒(B/s)。这个指标是在 PostgreSQL 13 新引入的,可以用来定量揭示查询产生的 WAL 大小:写入的 WAL 越多越快,刷写磁盘、物理复制/逻辑复制、日志归档的压力就会越大。
一个典型的例子是:BEGIN; DELETE FROM xxx; ROLLBACK; 。这样的事务删了很多数据,产生了大量 WAL 却没有执行任何有用的工作,通过这个指标可以将其揪出来。
WAL字节率:1/5/15 分钟均值
DELETE 已经成功执行,之后显式执行的 ROLLBACK 撤销了事务。PGSS 会记录这条成功语句及其生成的 WAL。
SELECT 设置元组的 Hint Bit 时也可能生成 WAL。启用数据校验和或 wal_log_hints 后,检查点之后首次发生的此类页面修改可能需要写入全页镜像。参阅 WAL 配置。
可以检查 wal_fpi,判断读密集负载产生的 WAL 是否来自全页镜像。
共享缓冲区写脏/写回带宽
对于 13 以下的版本,共享缓冲区写脏/写回带宽指标可以作为一个近似下位替代,用于分析查询组的写入负载特征。
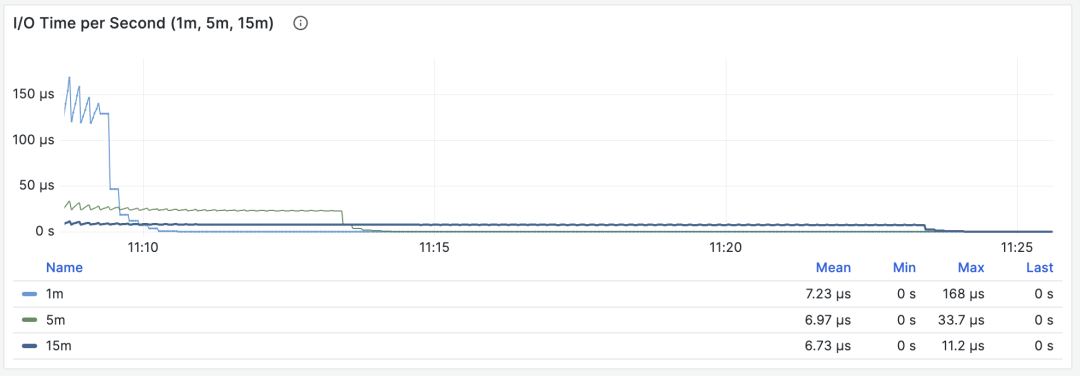
I/O耗时
当 M 是 blk_read_time + blk_write_time 时,先将毫秒转换为秒,再计算速率,得到每秒累积的 I/O 耗时。采集这些字段需要启用 track_io_timing。
I/O 耗时对于分析查询毛刺原因很有帮助
这些耗时包括由操作系统缓存满足的读取。结合主机磁盘指标,区分缓存读取与实际存储 I/O。
对时间微分的指标 dM/dt,可以展现出一个数据库实例/集群内部工作负载的全貌,对于优化资源使用的场景来说尤其有用。但是如果您的优化目标是改善用户体验,那么可能另一组指标 —— 对调用次数的微分 dM/dc,会更有参考意义。
对调用次数微分
计算 dM/dc 时,分母从时间差改为 调用次数的增量,结果表示每次完成的调用平均消耗多少资源。
这类指标重要性相比前者甚至更高,因为它提供了直接关乎用户体验的几个核心指标,比如最重要的 —— 查询响应时间 (RT,Response Time),或曰 延迟(Latency)。
计算这些指标的方式也很简单,我们只需要:
- 计算两个快照之间的指标值 M 的差值:M2 - M1
- 然后计算两个快照之间的 calls 差值:c2 - c1
- 然后计算 (M2 - M1) / (c2 - c1) 即可
对于 PromQL 实现来说,对于 调用次数的微分指标 dM/dc,可以用“对时间的微分指标 dM/dt” 计算得到。例如要计算 RT,就可以使用 每秒执行时长 / 每秒查询数 ,两指标相除即可:
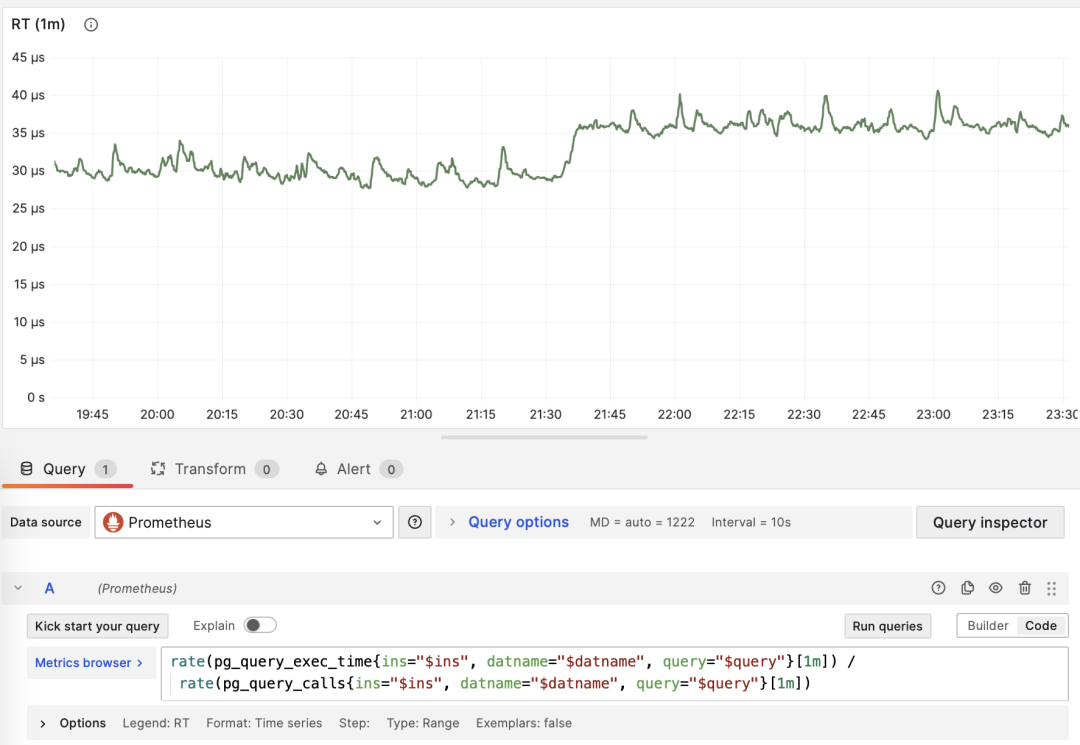
dM/dt 可以用于计算 dM/dc
调用次数
当 M 是 calls 时,对自己微分没有任何意义(结果会恒为 1)。
平均延迟/响应时间/RT
用 total_exec_time 的增量除以 calls 的增量,得到每次调用的平均服务端执行时间。PGSS 原始值算出的单位是毫秒,上面的 PromQL 示例使用秒。这是客户端响应时间的一部分;客户端计时还包含排队、网络和应用处理时间。启用计划统计后,可以另行加上计划耗时。
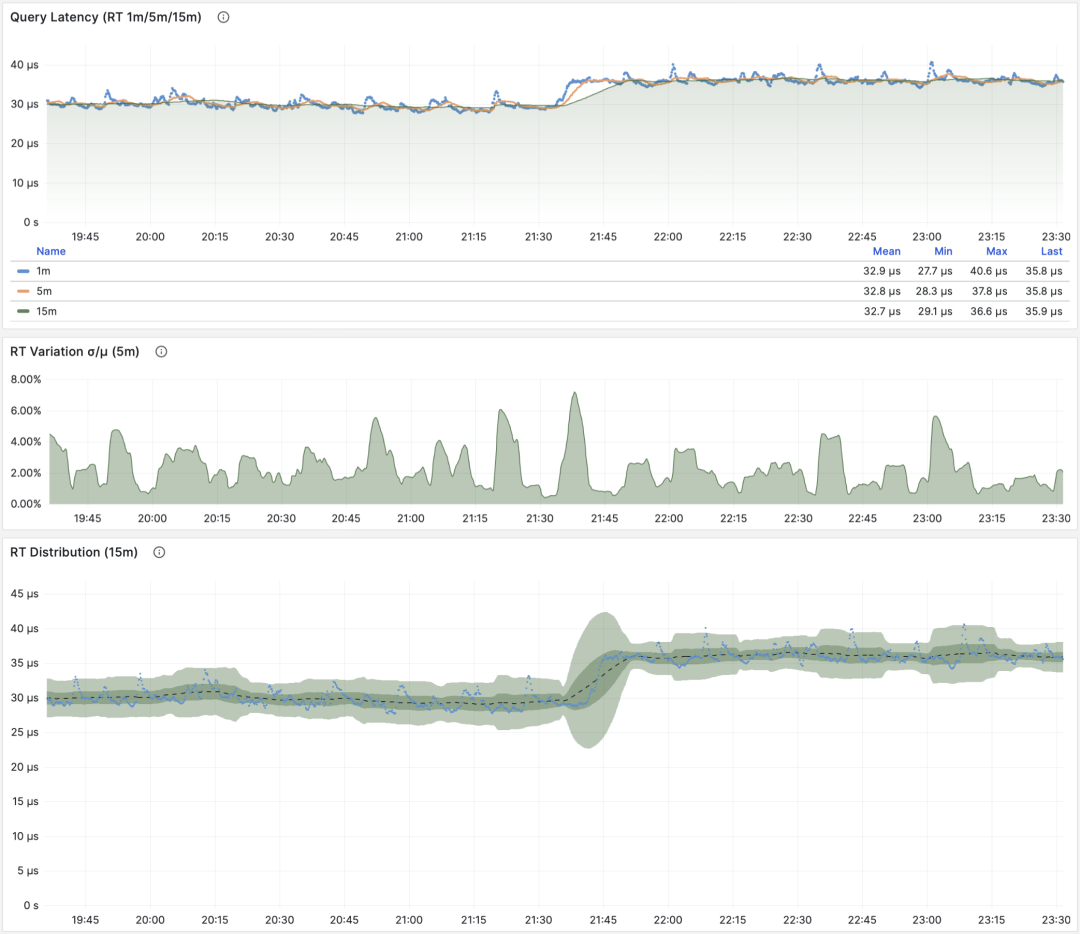
RT:1/5/15 分钟 µ/CV, ±1/3σ分布
这个均值覆盖已采集条目中的成功执行。pg_stat_statements.max 限制了 PGSS 可保留的查询组数量。比较工作负载时,需要确认采集覆盖范围。
客户端打点可以测量应用实际看到的响应时间。PgBouncer 和 PostgreSQL 14+ 还提供数据库级别的耗时汇总,PGSS 则提供查询组级别的细节。
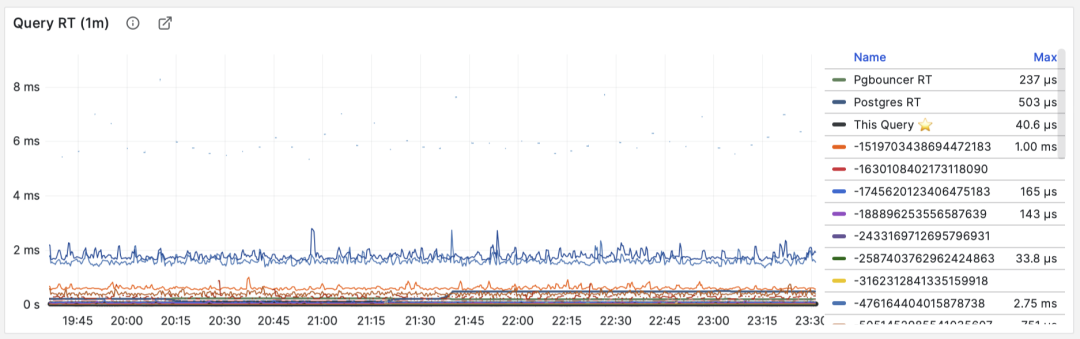
RT:语句级/连接池级/数据库级
在相近条件下比较同一查询组的 RT。如果平时均值低于 1 ms,突然升至 10 ms 以上,就值得调查。
当出现故障时, RT 视图对于定位原因也很有帮助:如果所有查询整体 RT 变慢,那么最有可能与资源不足有关。如果只是特定查询组的 RT 发生变化,那就更有可能是某些慢查询导致了问题,应当进一步调查分析。如果 RT 变化的时间点与应用发布部署吻合,则应当考虑是否要回滚这些部署。
此外,在性能分析,压力测试,基准测试时,RT 也是最重要的指标。你可以通过对比典型查询在不同环境(例如不同PG大版本、不同硬件、不同配置参数)下的延迟表现来评估系统的性能,并以此为依据不断对系统性能进行调整与改进。
对采样得到的 RT 序列计算均值和标准差,可以观察各时间窗口均值的波动。对这些均值计算分位数,得到的并不是单次查询耗时的 P95 或 P99。后者需要逐次观察值或耗时直方图。
评估 OLTP 性能时,应结合 RT、吞吐量和资源使用情况。
每次调用的平均行数
当 M 是 rows 时,得到每次调用平均检索或影响的行数。点查 SELECT 通常只返回少量结果;对于写语句,此值表示影响的行数。
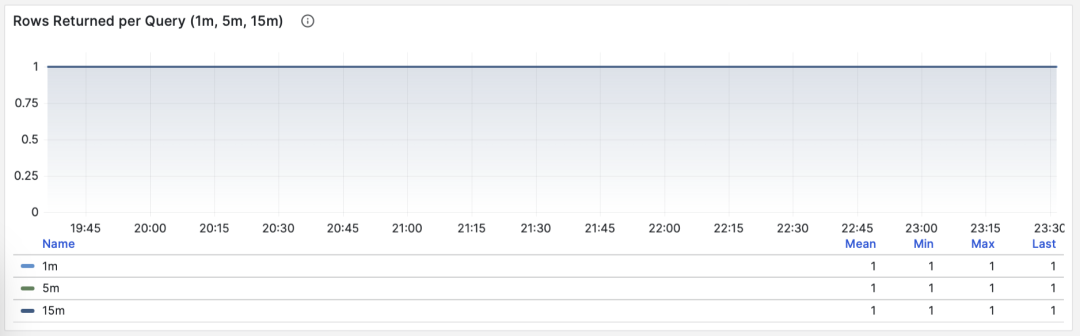
按照主键查询单条记录,平均返回行数稳定为1
如果一个查询组每次查询向客户端吐出几百甚至成千上万行记录,那么应当对其进行审视。如果这是有意而为之的设计,比如批量加载任务/数据转储,那么不需要做什么。如果这是由应用/客户端发起的请求,那么可能存在错误,比如语句缺少 LIMIT 限制,查询缺少分页设计,这样的查询应该进行调整修复。
平均共享缓冲区读取/命中
当 M 是 shared_blks_hit + shared_blks_read 时,dM/dc 表示每条查询平均访问共享缓冲区的次数。乘以块大小(通常为 8 KiB),即可得到每条查询访问的字节数,单位是 B/query。重复访问同一块会重复计数。
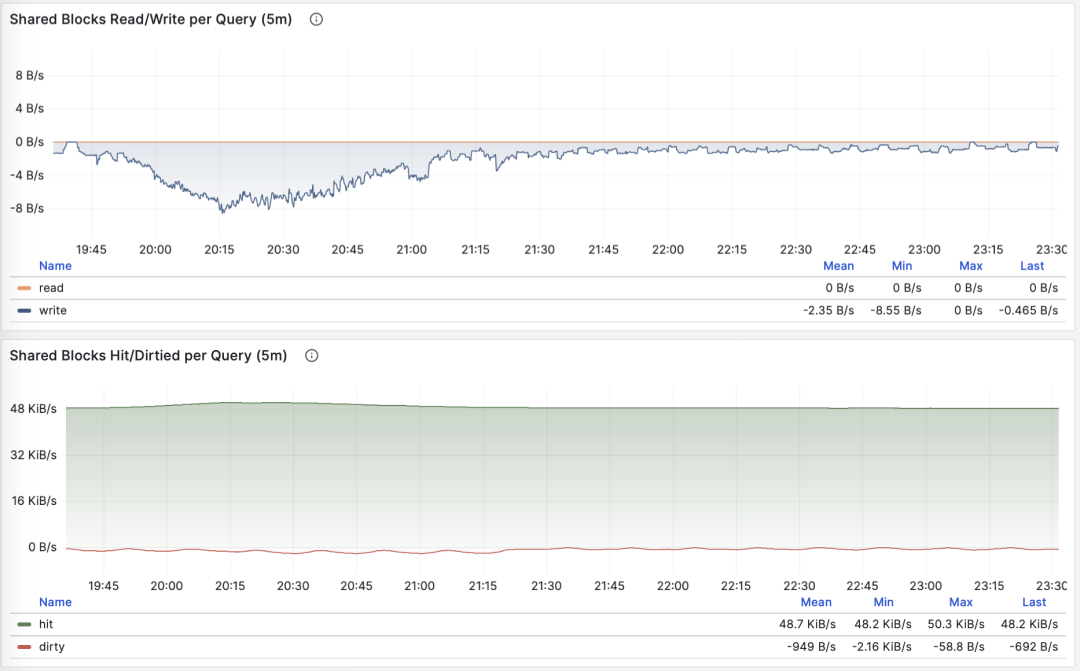
每条查询平均访问的共享缓冲区字节数
查询平均访问的数据量通常与平均返回的行数相匹配,如果你的查询平均只返回了几行,却访问了成M上G的数据块,那你就需要特别注意了:这样的查询对于数据冷热状态非常敏感,如果所有的块都在缓冲区中,它的性能可能还说的过去,但如果从磁盘冷启动,执行时间可能会出现戏剧性的变化。
PostgreSQL 缓冲区未命中时,仍可能从操作系统缓存读取。结合主机指标、pg_stat_kcache 扩展,或 PostgreSQL 16 的 pg_stat_io 视图分析实际 I/O。
另一种值得关注的模式是此指标的突变,这通常意味着该查询组的 执行计划可能出现了翻转/劣化,非常值得关注与进一步研究。
平均WAL日志量
当 M 是 wal_bytes 时,我们得到了每条查询平均生成 WAL 的大小,这是 PostgreSQL 13 新引入的字段。这个指标可以衡量查询的变更足迹大小,并计算读写比例等重要评估参数。
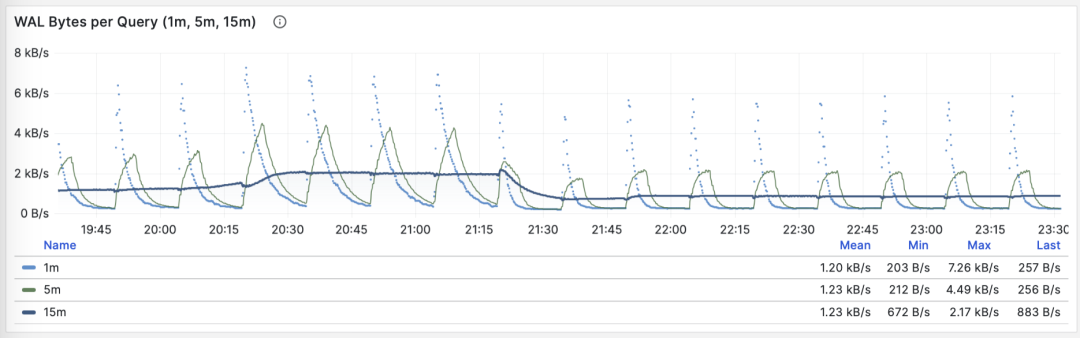
稳定的QPS却有着周期性WAL波动,可推断是 FPI 的影响
另一个用途是优化检查点/Checkpoint:如果你观察到此指标周期性的起伏(周期约等于 checkpoint_timeout),那么可以通过调整检查点间距,来优化查询产生 WAL 的数量。
dM/dc 描述一次调用的平均成本。用它评估查询修改,再检查工作负载总量,确认整体收益。
dM/dc 这样的指标为我们提供类似重要的绝对值指标,但如果想要找出哪些查询的优化潜在收益最大,还需要用到 %M 百分比指标。
百分比指标
现在我们来研究第三类指标,百分比指标。即某个查询组相对于整体工作负载所占的比例。
百分比指标 M% 为我们提供了某个查询组相对于整体工作负载的比例,帮助我们在频次、时间、I/O时间/次数上时识别出“主要参与者”,找出潜在优化收益最大的候选查询组,作为优先级评定的重要依据。
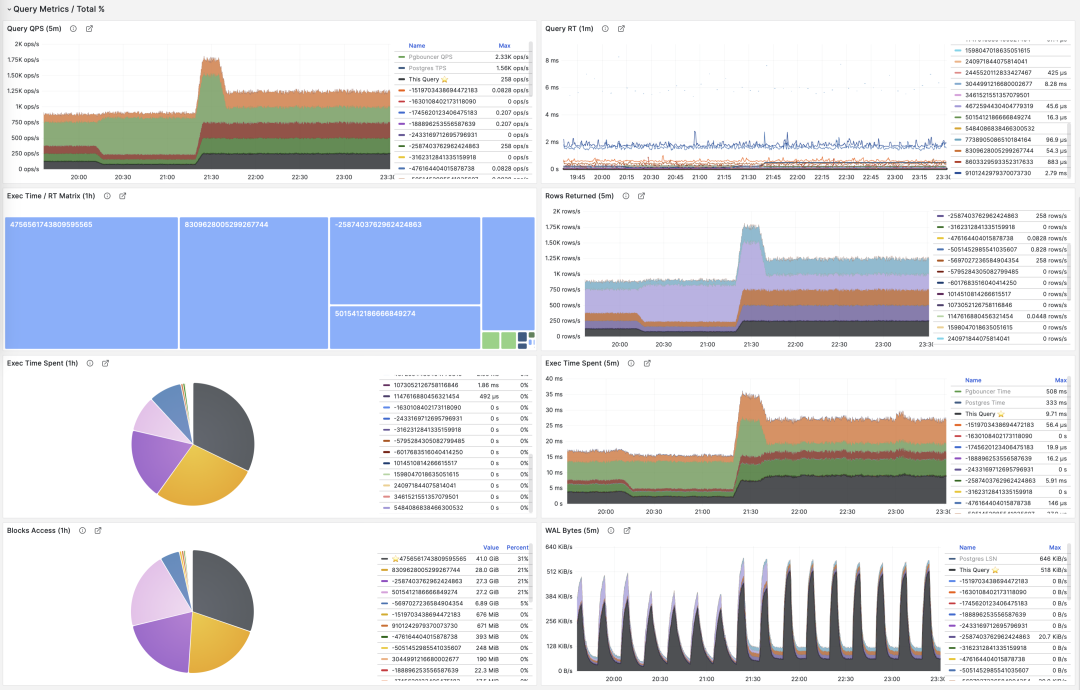
常用百分比指标 %M 一览
同样是 1000 QPS,一个查询组可能只占总调用量的 3%,也可能占 50% 以上。如果其中存在大量冗余调用,消除它们可以减少数据库工作量。对于高成本查询,还应比较它们占执行时间和 I/O 的比例。
常见的优化策略是这样的:首先把所有查询组分别按照上面提到的重要指标:calls,total_exec_time,rows,wal_bytes,shared_blks_hit + shared_blks_read,以及 blk_read_time + blk_write_time 在一段时间内的 dM/dt 值进行排序取 TopN (比如 N=10 或者更多),加入优化候选列表中。
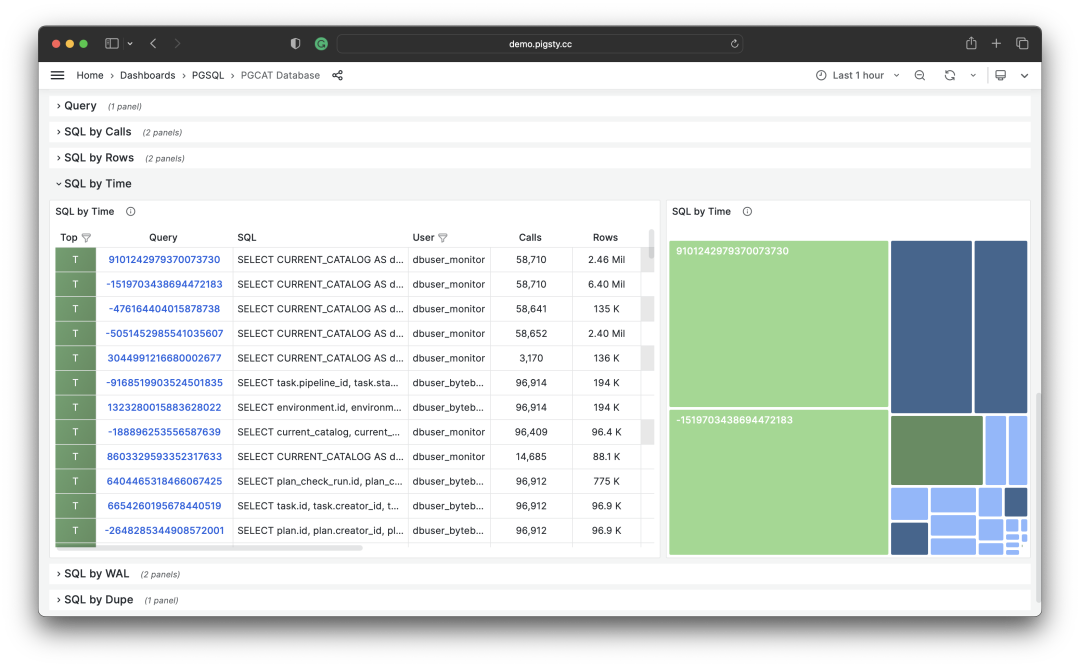
按照特定标准,选取待优化的 TopSQL
然后,对于优化候选列表中的每个查询组,依次分析其 dM/dc 指标,结合具体的查询语句与慢查询日志/等待事件进行分析,决定这是不是一个值得优化的查询。对于决定(Plan)进行优化的查询,就可以使用后续篇 “微观优化” 将要介绍的技巧进行调优(Do),并使用监控系统评估优化的效果(Check),总结分析后进入下一个 PDCA 戴明循环,持续进行管理优化。
除了对指标取 TopN 之外,还可以使用可视化的方式。可视化非常有助于从工作负载中识别 “主要贡献者”,复杂的判断算法可能还远比不上人类DBA对监控图形模式的直觉。想要形成比例感,我们可以借助饼图,树图或者堆叠的时序图。
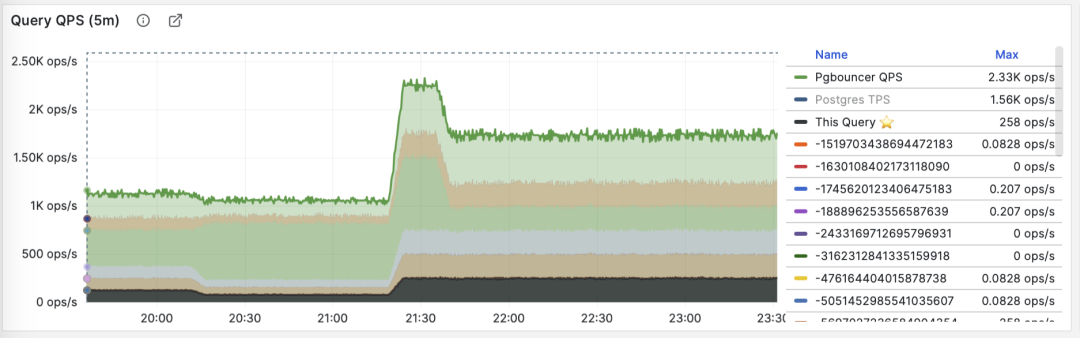
将所有查询组的 QPS 进行堆叠
例如,我们可以使用饼图来标识过去1小时内耗时/IO使用最大的查询,使用二维树图(大小代表总耗时,颜色代表平均RT)来展示一个额外的维度。并用堆叠时序图来展示比例随时间的变化关系。
我们也可以直接分析当下的 PGSS 快照,按照不同的关注点进行排序,按照您自己的标准选择有待优化的查询即可。
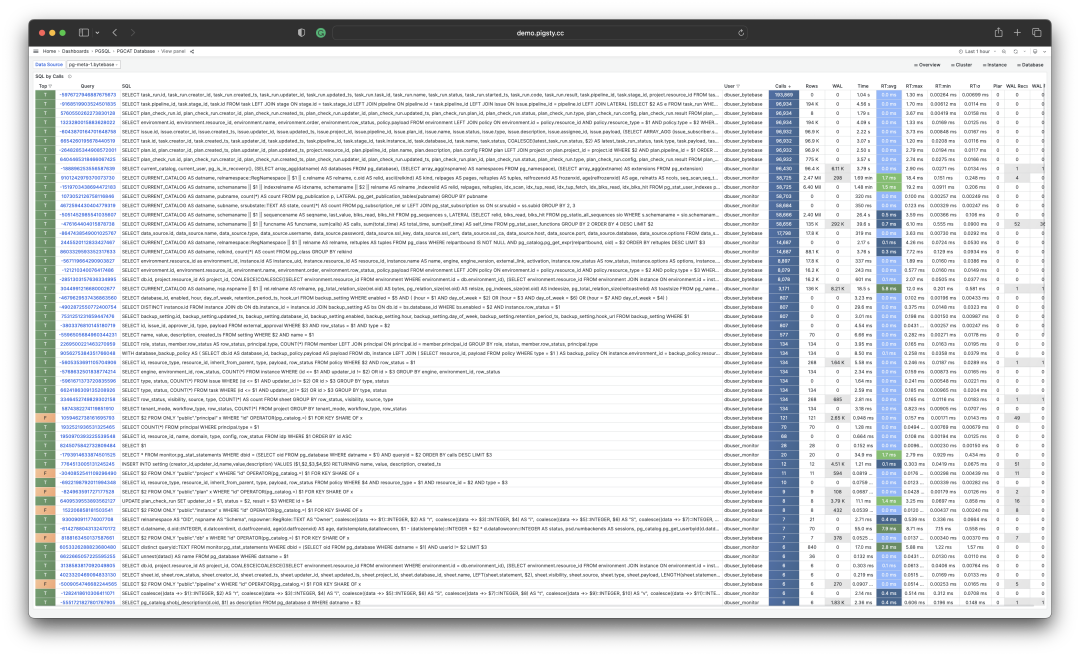
I/O 耗时对于分析查询毛刺原因很有帮助
总结
最后,让我们对上面的内容做一个总结。
PGSS提供了丰富的指标,其中最重要的累积指标可以使用三种方式进行加工处理:
dM/dt :指标 M 基于时间的微分,揭示了 每秒资源使用量,通常用于减少资源消耗的优化目标。
dM/dc:指标 M 基于调用次数的微分,揭示了 每次调用的资源使用量,通常用于改善用户体验的优化目标。
%M :百分比指标展示了查询组在整个工作负载中所占的百分比,通常用于平衡工作负载的优化目标。
通常,我们会根据 %M :百分比指标 Top 查询选择高价值的备选优化查询,并使用 dM/dt、dM/dc 指标进行进一步的评估,确认是否有优化空间和可行性,并评估优化后的效果。如此往复,不断循环。
理解了宏观优化的方法论后,我们就可以用这样的方法去定位优化慢查询了。这里给出了一个具体的 《 利用监控系统诊断PG慢查询》的例子。在下一篇中,我们将介绍关于 PostgreSQL查询 微观优化 的经验技巧。
参考
[1] PostgreSQL HowTO: pg_stat_statements by Nikolay Samokhvalov
[3] 利用监控系统诊断PG慢查询
[4] 如何用Pigsty监控现有PostgreSQL (RDS/PolarDB/自建)?
1.4 - 使用 Pigsty 监控现有 PostgreSQL:RDS、PolarDB 与自建数据库
本文记录 2023 年 9 月的 Pigsty 与阿里云使用流程,命令、价格和界面均对应当时版本。
Pigsty 是一个 PostgreSQL 发行版,也可以单独用于监控 PostgreSQL 与主机。本文以阿里云为例,在一台 ECS 上安装 Pigsty,再接入已有的 PolarDB 与 RDS for PostgreSQL。
操作流程
教程分为四步:
- 创建用于部署 Pigsty 的 ECS 服务器。
- 在 ECS 上完整安装单机版 Pigsty。
- 配置 PolarDB / RDS 的监控用户、模式、视图与访问名单。
- 将数据库实例接入 Pigsty 监控。
当时使用按量付费资源需要阿里云账户余额超过 ¥100,本例资源费用约为 ¥4 / 小时。
为什么增加这套监控?
云服务已经提供 RDS 监控。我在使用时,还需要更多指标来分析慢查询、诊断故障和评估容量,因此增加了这套监控。
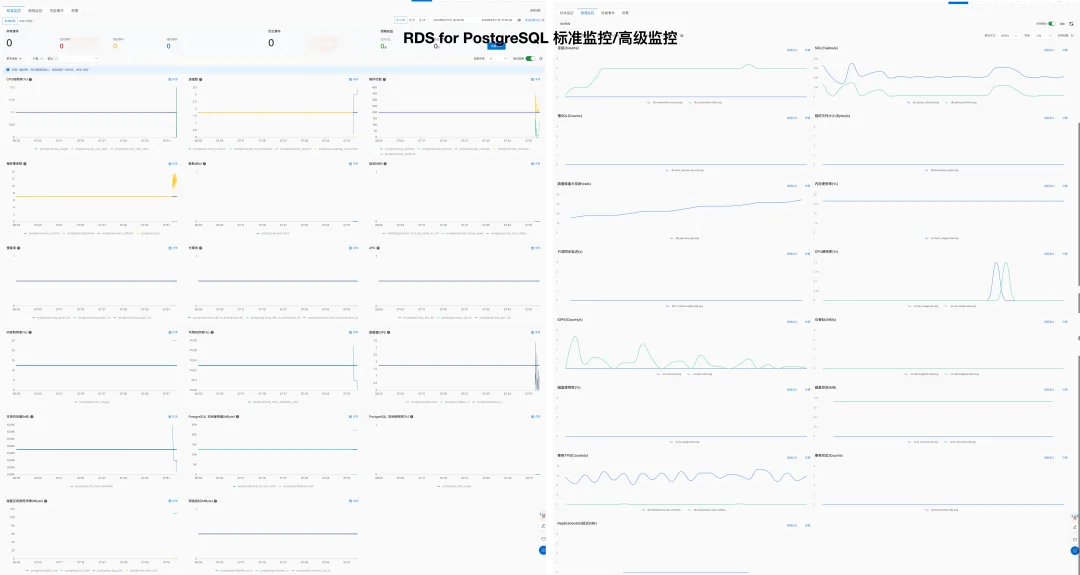
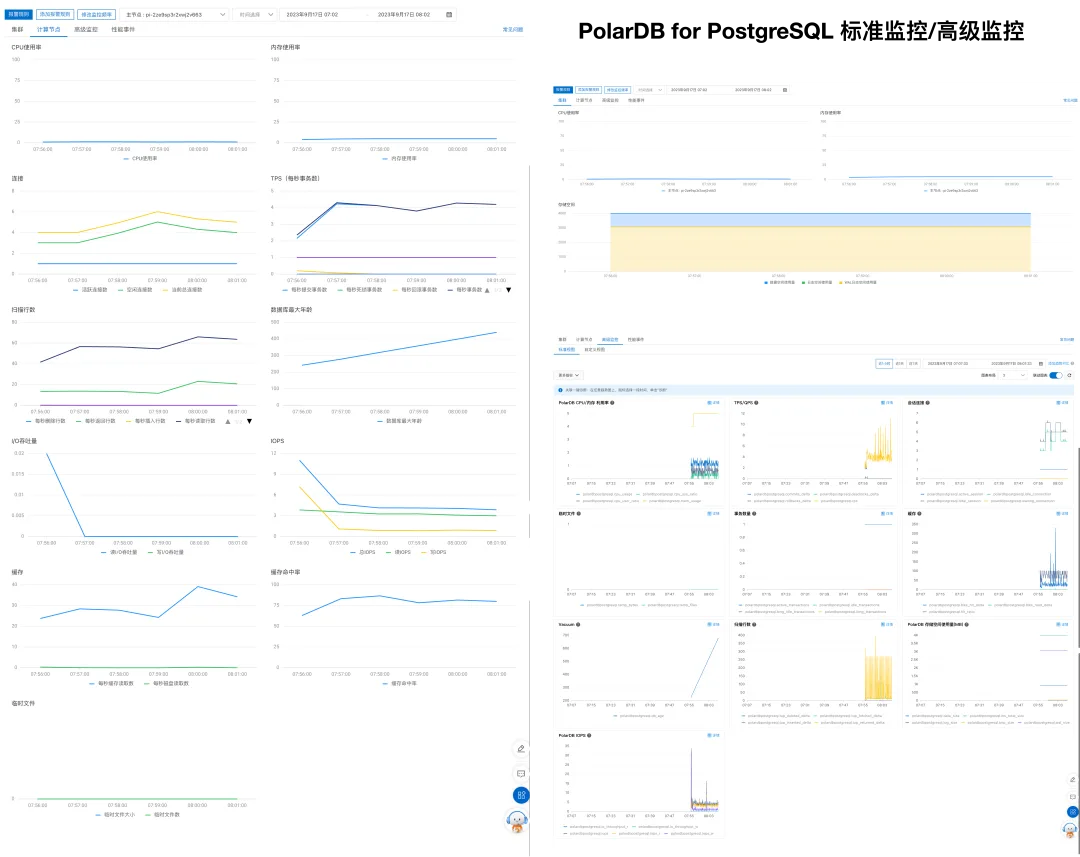
Pigsty 使用 Grafana 与 Prometheus,并将它们打包为可统一安装的 INFRA 模块。Pigsty 管理的主机、HAProxy、PostgreSQL、PgBouncer、etcd、Redis、MinIO,以及监控基础设施本身,都会纳入监控。预置面板和告警规则用于查看运行状态与排查问题。
当时的完整系统使用三千多类指标,覆盖数据库与配套组件。面板按集群、实例和对象组织数据,可以查看表、索引、函数的活动,也可以汇总到集群层面。页面链接用于切换视图,时间范围选择器用于比较当前状态与历史趋势。
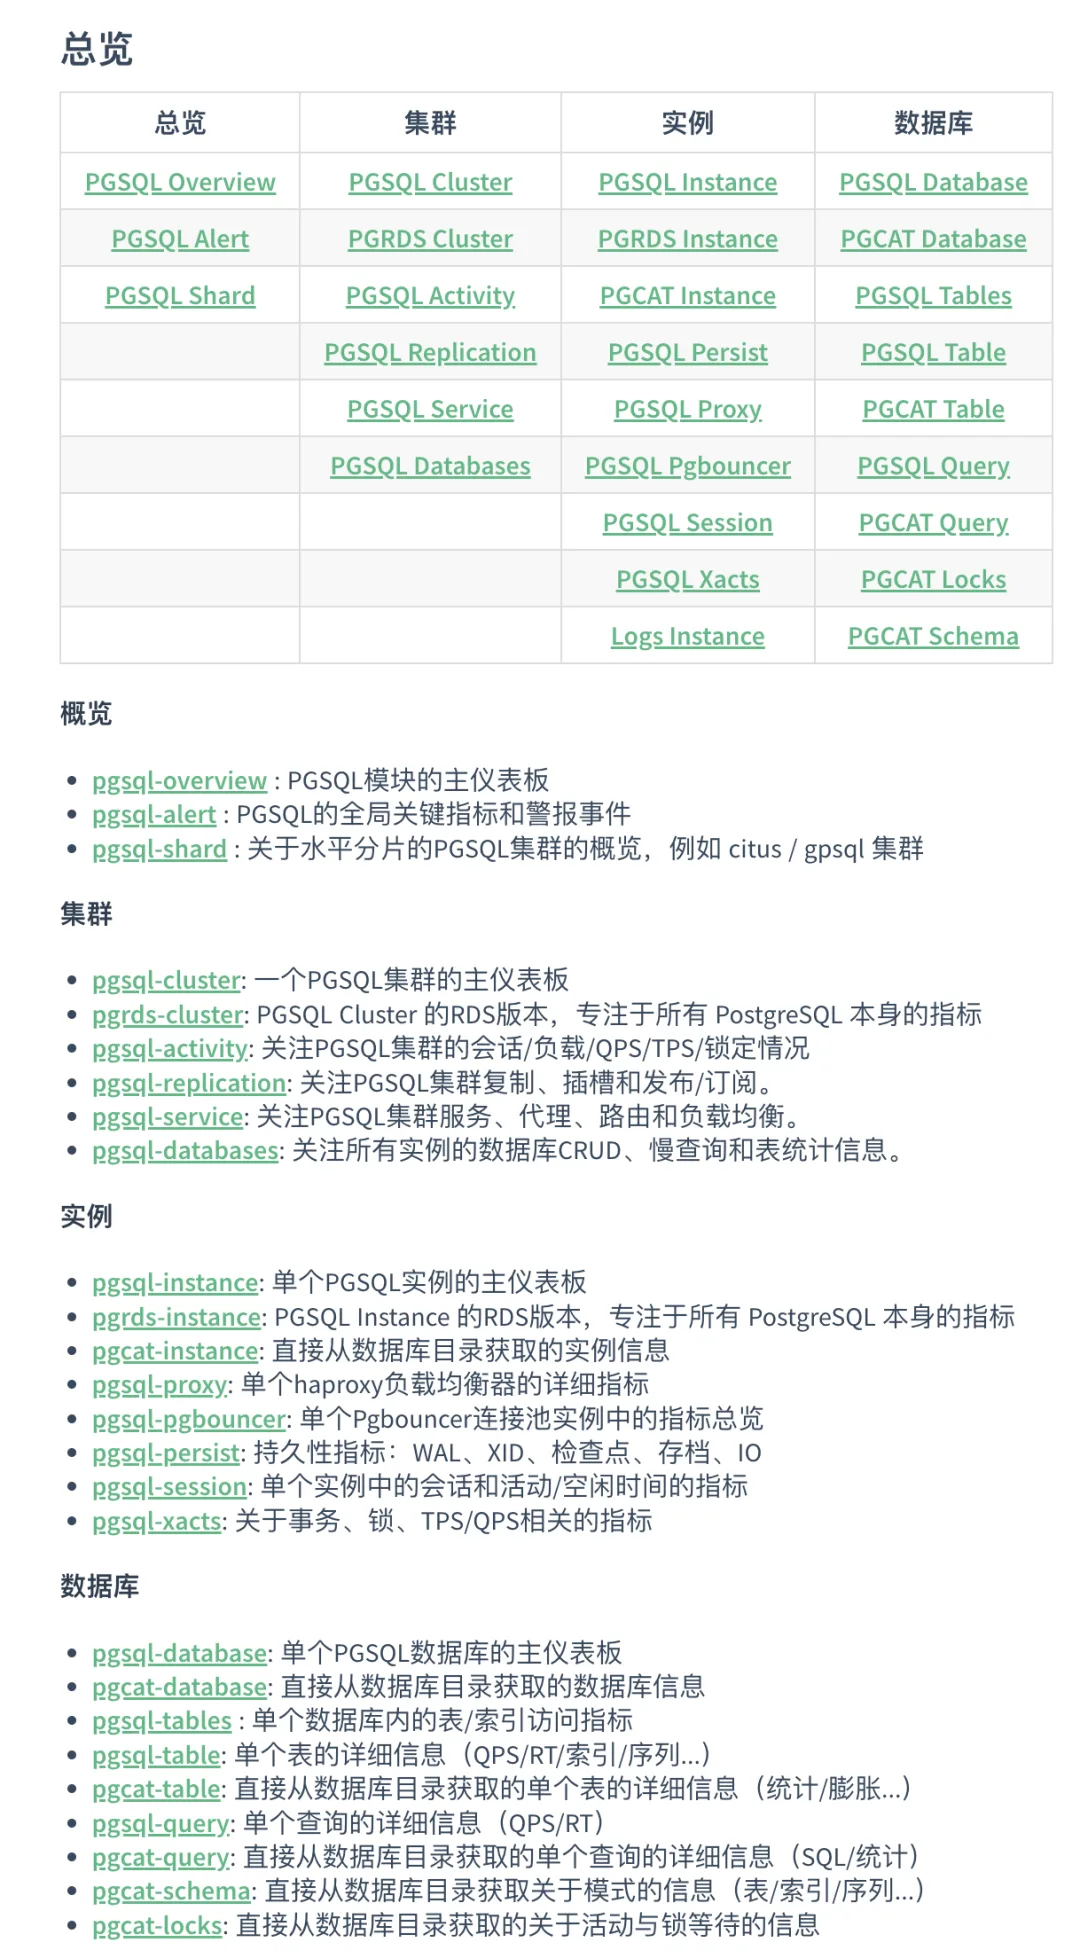
监控现有 PostgreSQL,特别是托管云数据库时,可获得的数据取决于服务提供的访问接口。这种接入方式通常没有主机、高可用组件、连接池和原生数据库日志数据,主要使用 PostgreSQL 自身的指标。
可以通过公开演示查看监控界面。
创建 ECS 服务器
本例使用 x86_64 ECS,操作系统范围为 EL 7–9,当时推荐 Rocky Linux 8.6 或 9.1,最低配置为 1 核 CPU、2 GB 内存。可以在云控制台创建,也可以使用 Pigsty 提供的 Terraform 模板。
演示模板使用内网地址 10.10.10.10 和示例密码 PigstyDemo4,并分配一个公网 IP。
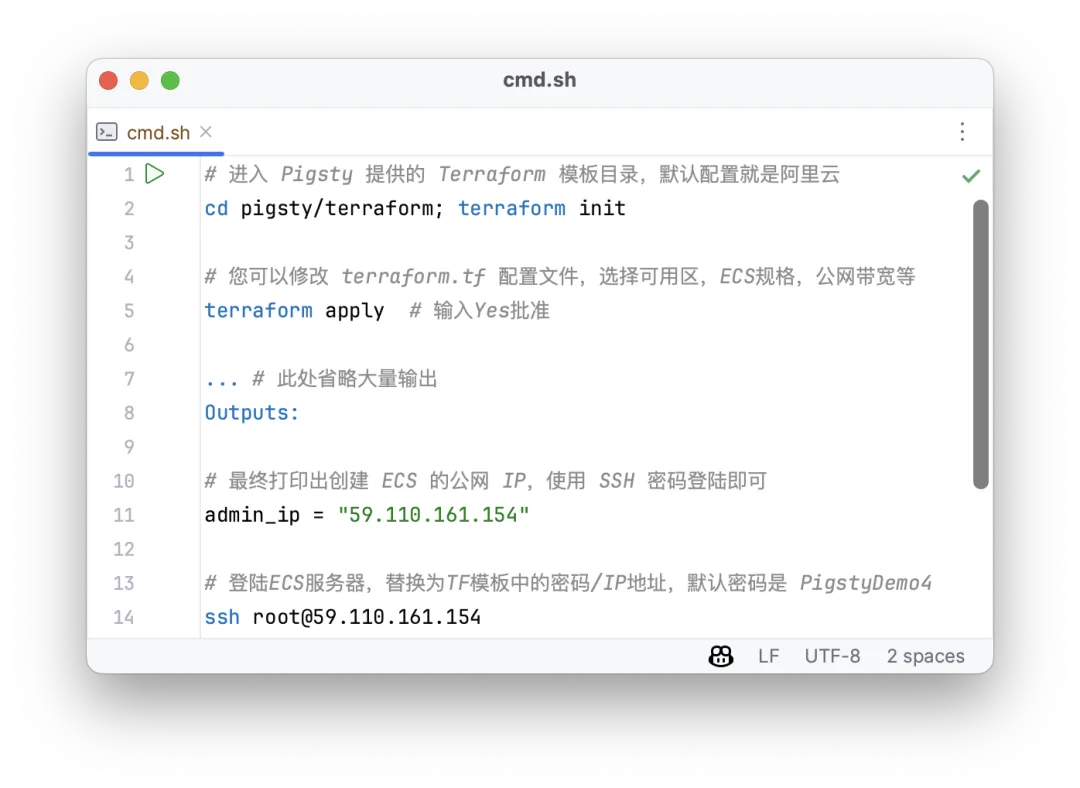
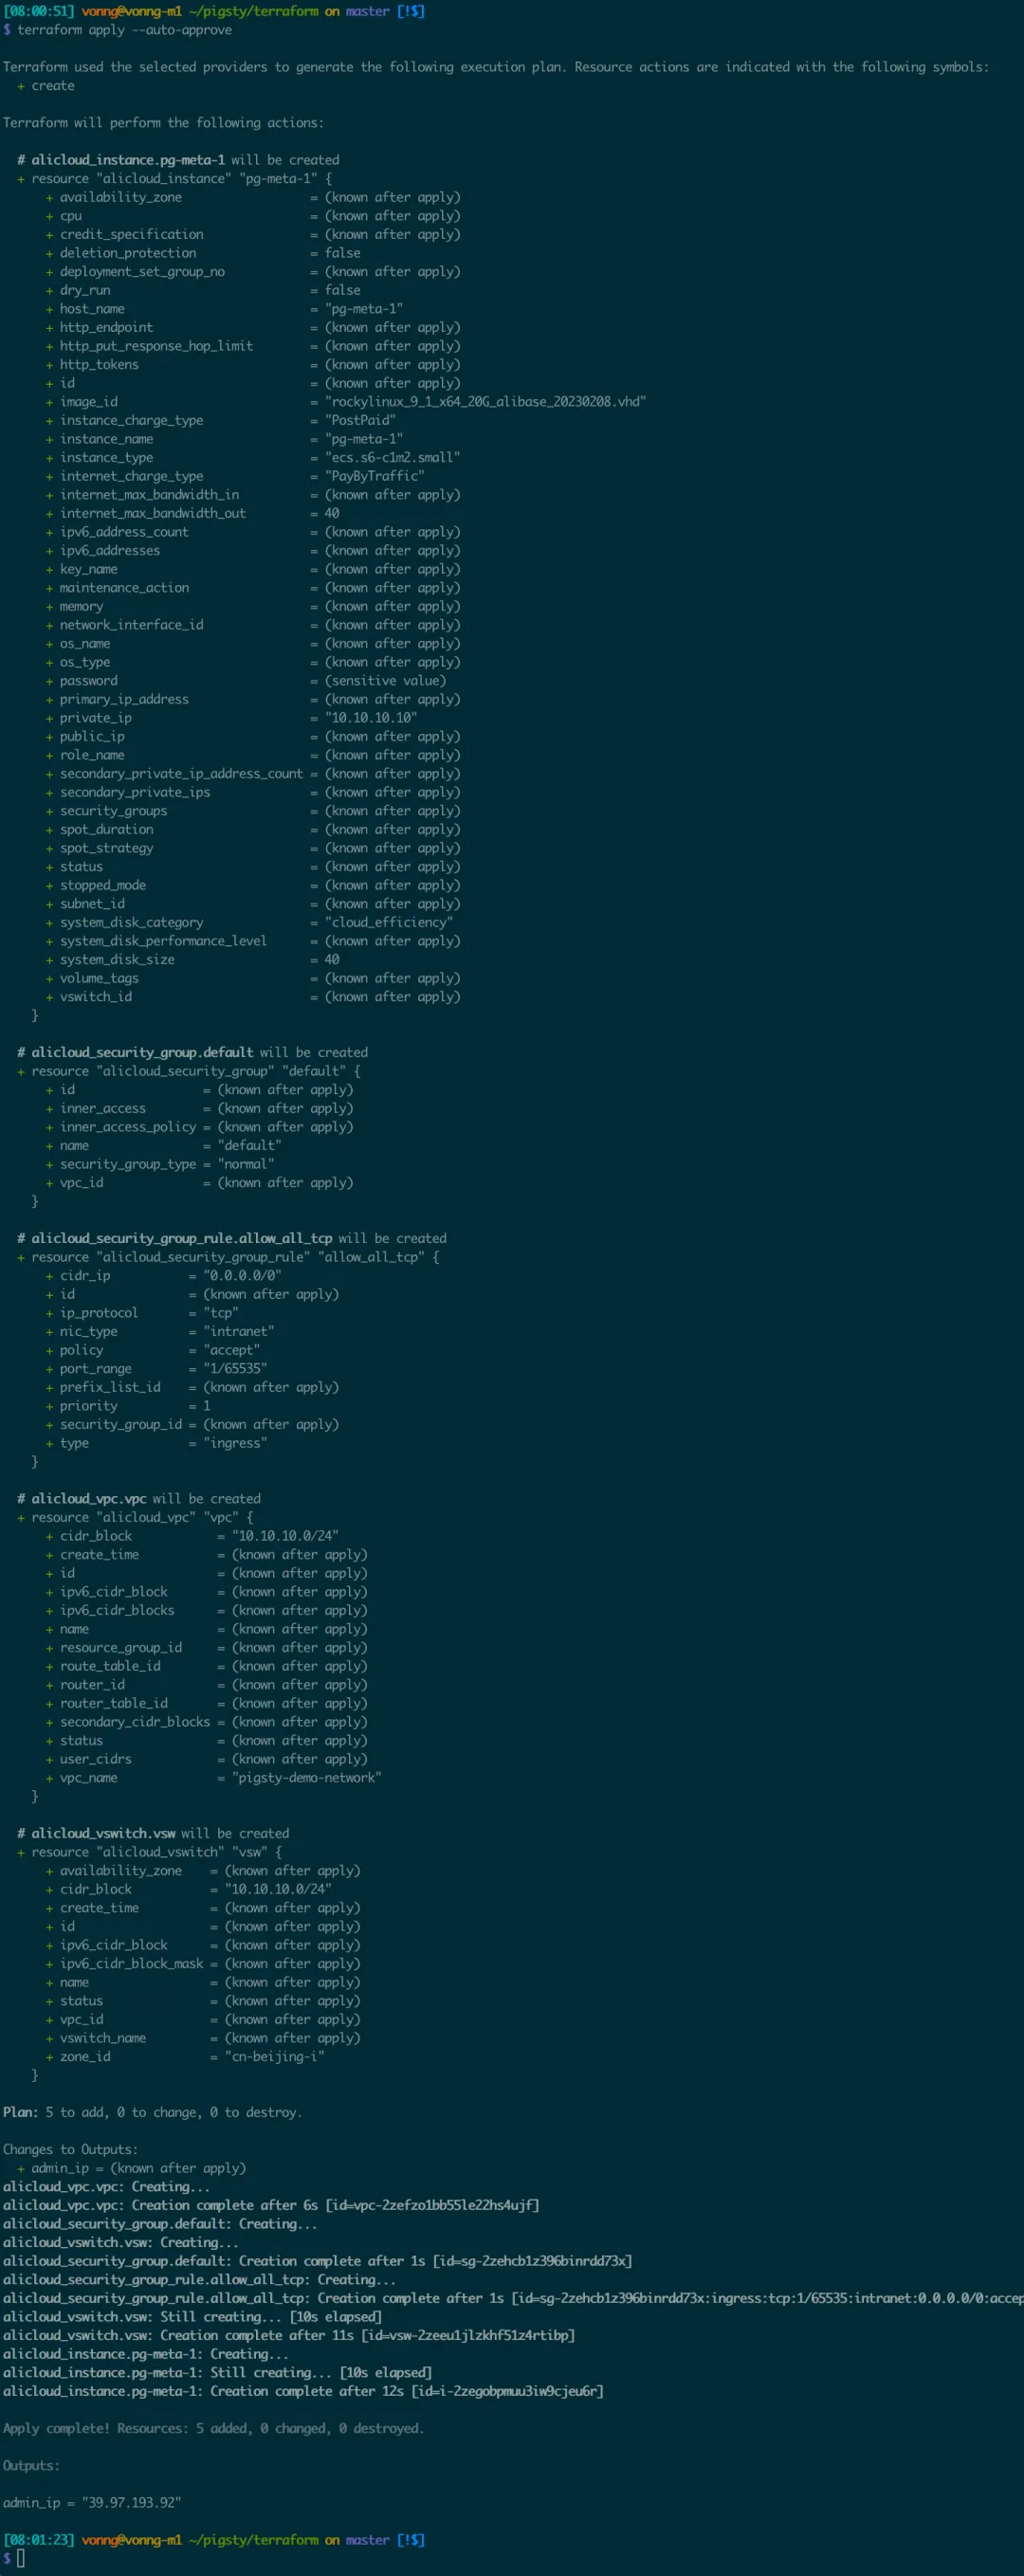
在 ECS 上安装单机版 Pigsty
登录 ECS 后,当时的安装流程如下:
使用离线包时,本例完整安装耗时约十分钟。当前流程见 Pigsty 安装指南。
安装后,通过 ECS 公网地址的 3000 端口访问 Grafana。面板中已经包含新环境自身的监控数据。本例使用默认账号 admin / pigsty。
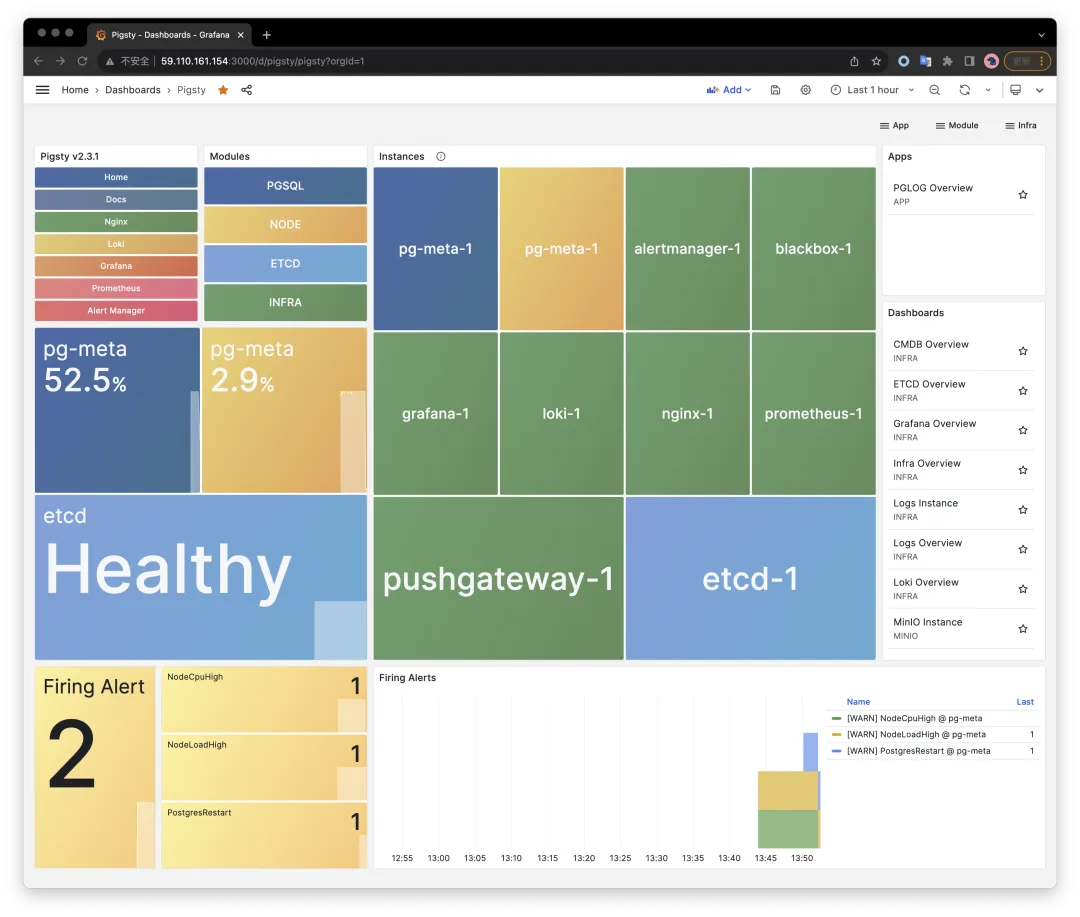
使用域名和 HTTPS 访问 Web 界面。更换示例密码,并限制监控系统的访问来源。
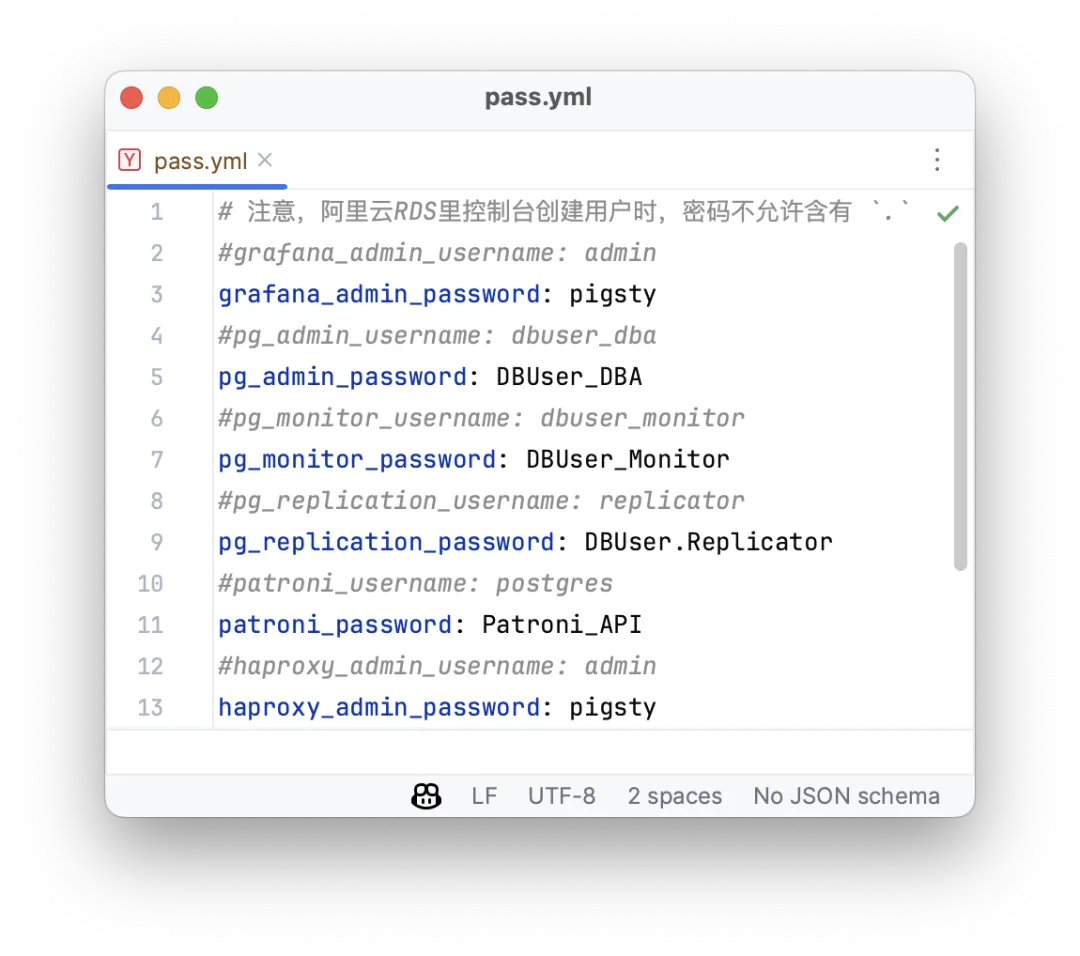
配置 PolarDB / RDS 监控
Exporter 需要一个从 ECS 可访问的数据库连接地址、具有所需读取权限的监控账号,以及所选采集器使用的扩展。
本例的 PolarDB 配置步骤是:
- 创建 ECS 可以访问的集群。本例使用同一可用区和子网。
- 创建管理账号
dbuser_dba,用于初始配置。 - 将 ECS 内网地址
10.10.10.10加入集群访问名单。 - 创建数据库,本例名为
test。
用管理账号连接数据库,将示例主机名替换为实际集群地址,并按提示输入密码:
用此账号创建专用监控用户,也可以通过云控制台创建。
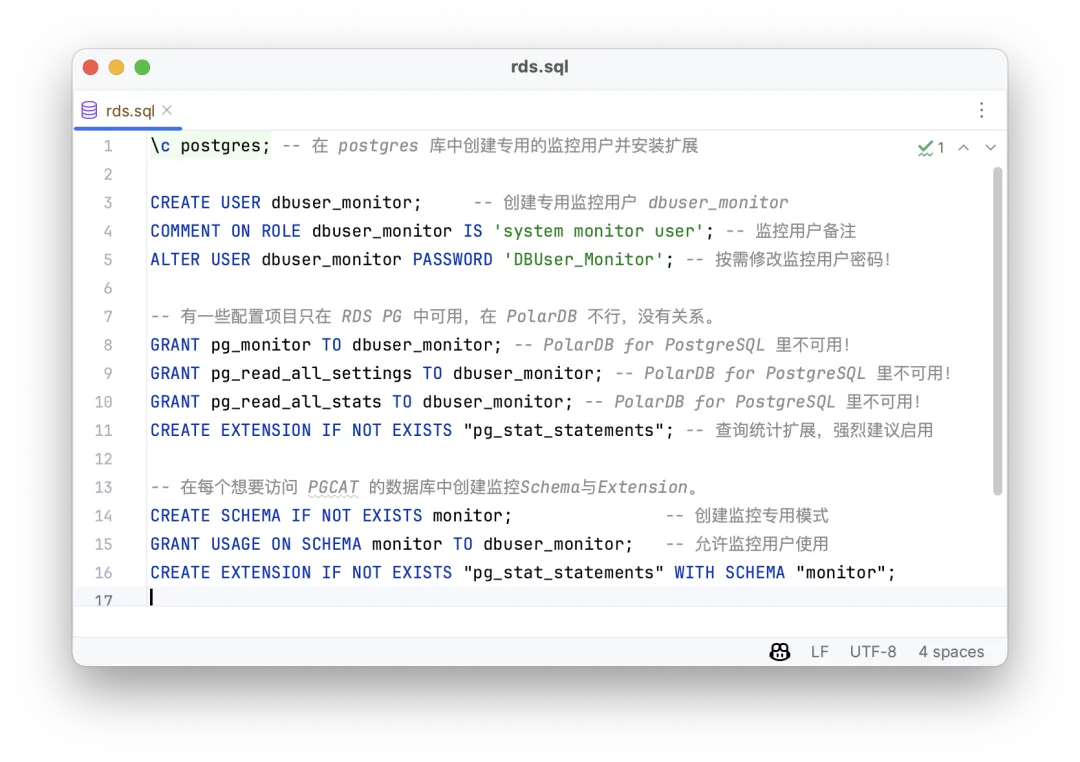
安装 pg_stat_statements,获取查询调用次数与执行耗时等语句级统计。
将现有数据库接入监控
在 pigsty.yml 中填写数据库实例的身份与连接信息。当时的配置位置是 all.children.infra.vars.pg_exporters:字典的键为唯一分配的本地 Exporter 端口,值为目标实例的配置。
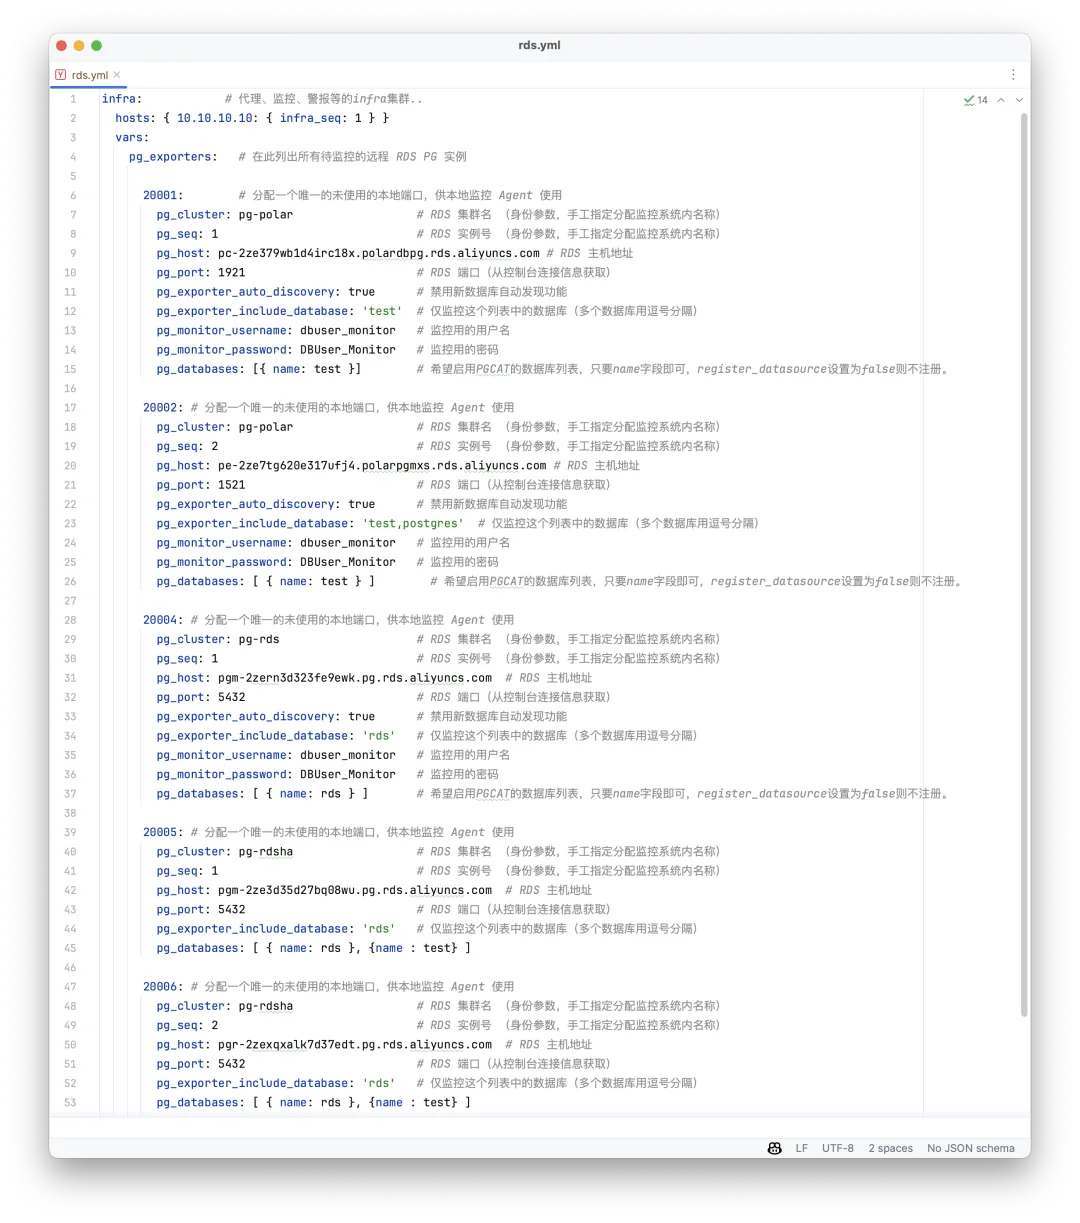
本例接入三个集群:
pg-polar:一主一从的 PolarDB 集群。pg-rds:基础版单节点 RDS for PostgreSQL 实例。pg-rdsha:带有一个只读节点的高可用 RDS 集群。
上图展示了配置。通常需要修改 pg_cluster、pg_seq 与 pg_host;端口不是 5432 时,还需要设置 pg_port。其他参数按需覆盖。
定义目标后,将各集群加入监控:
随后可以在 Pigsty 中看到这三个集群。
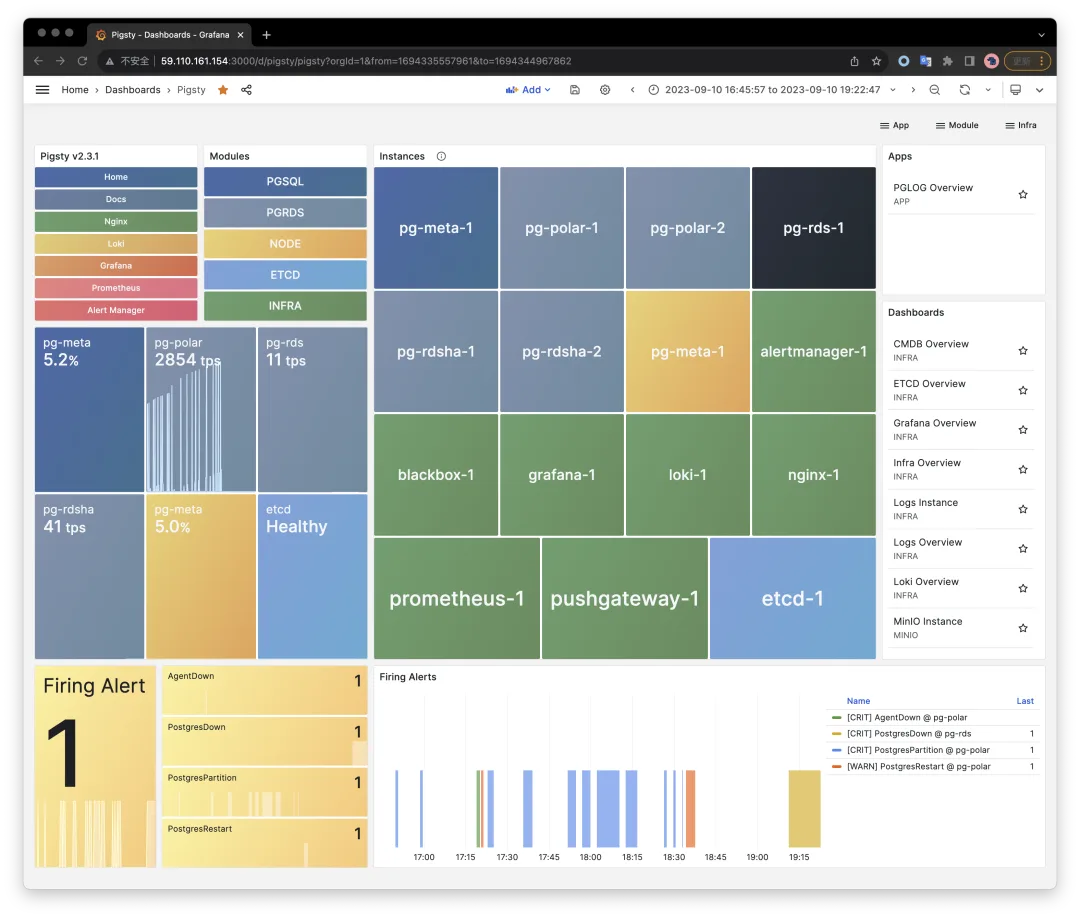
点击浅蓝色的集群名或实例名,打开对应的 PGRDS 面板。
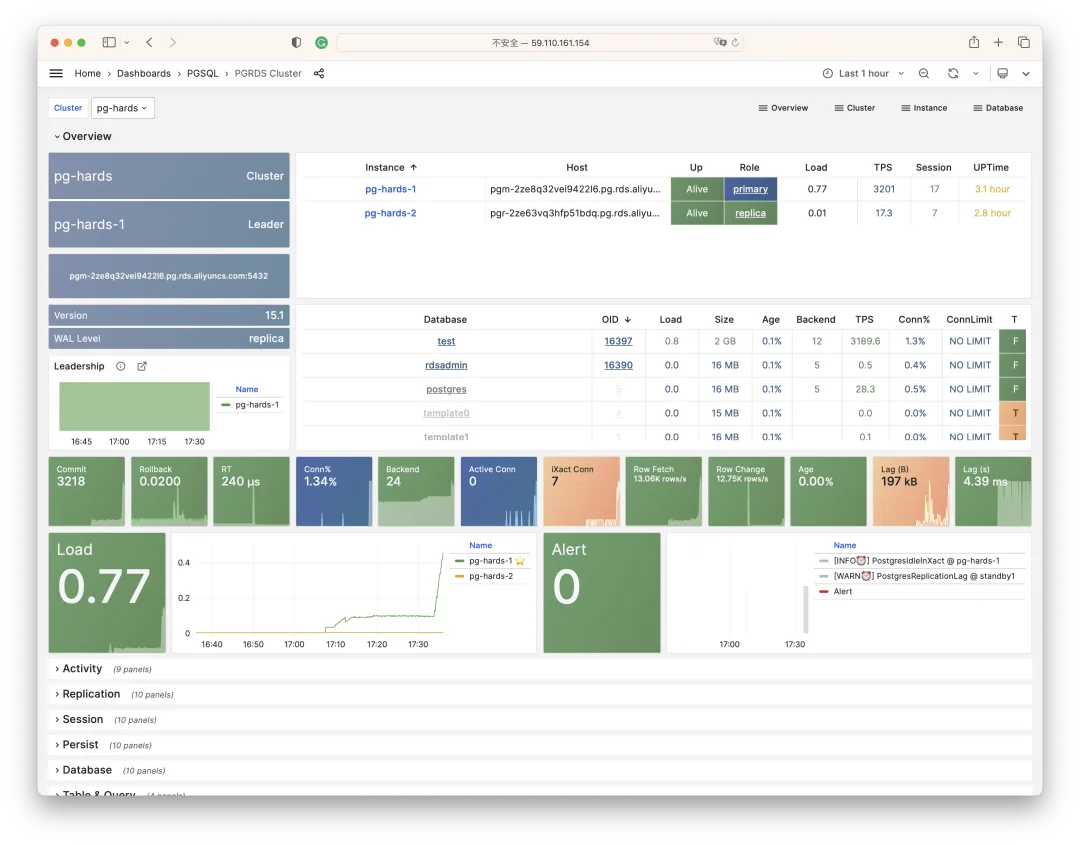
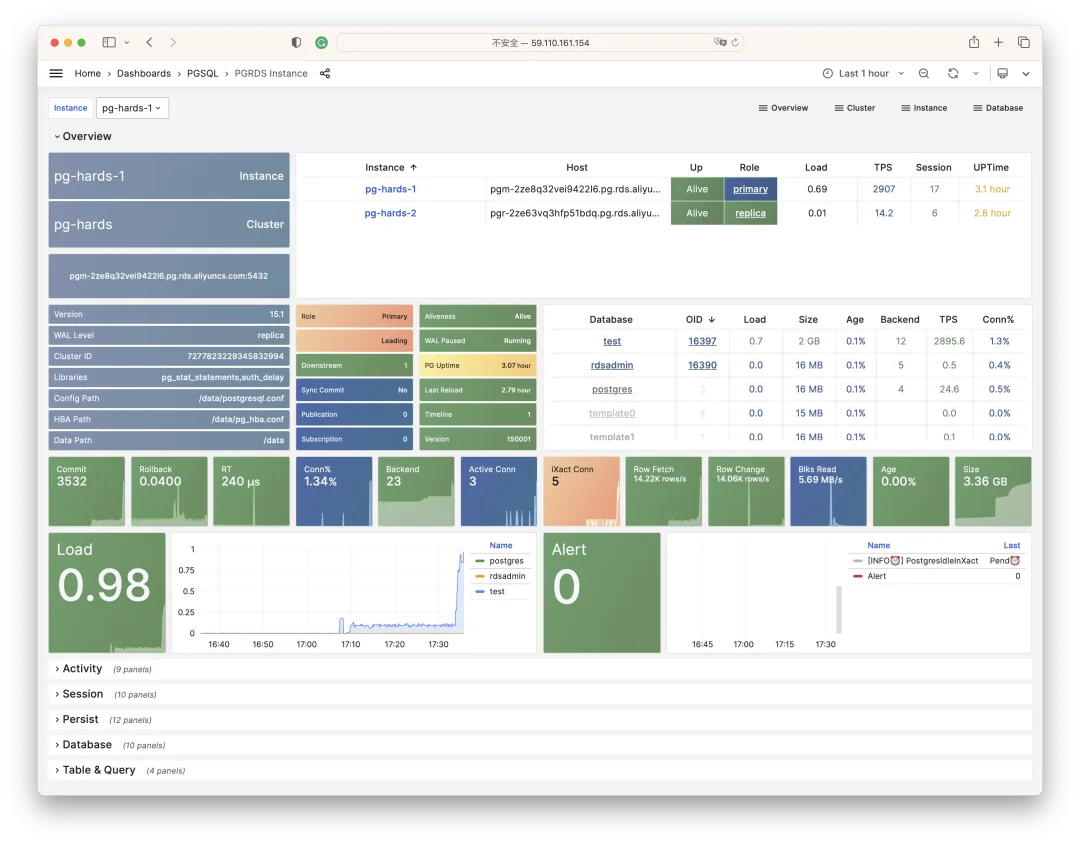
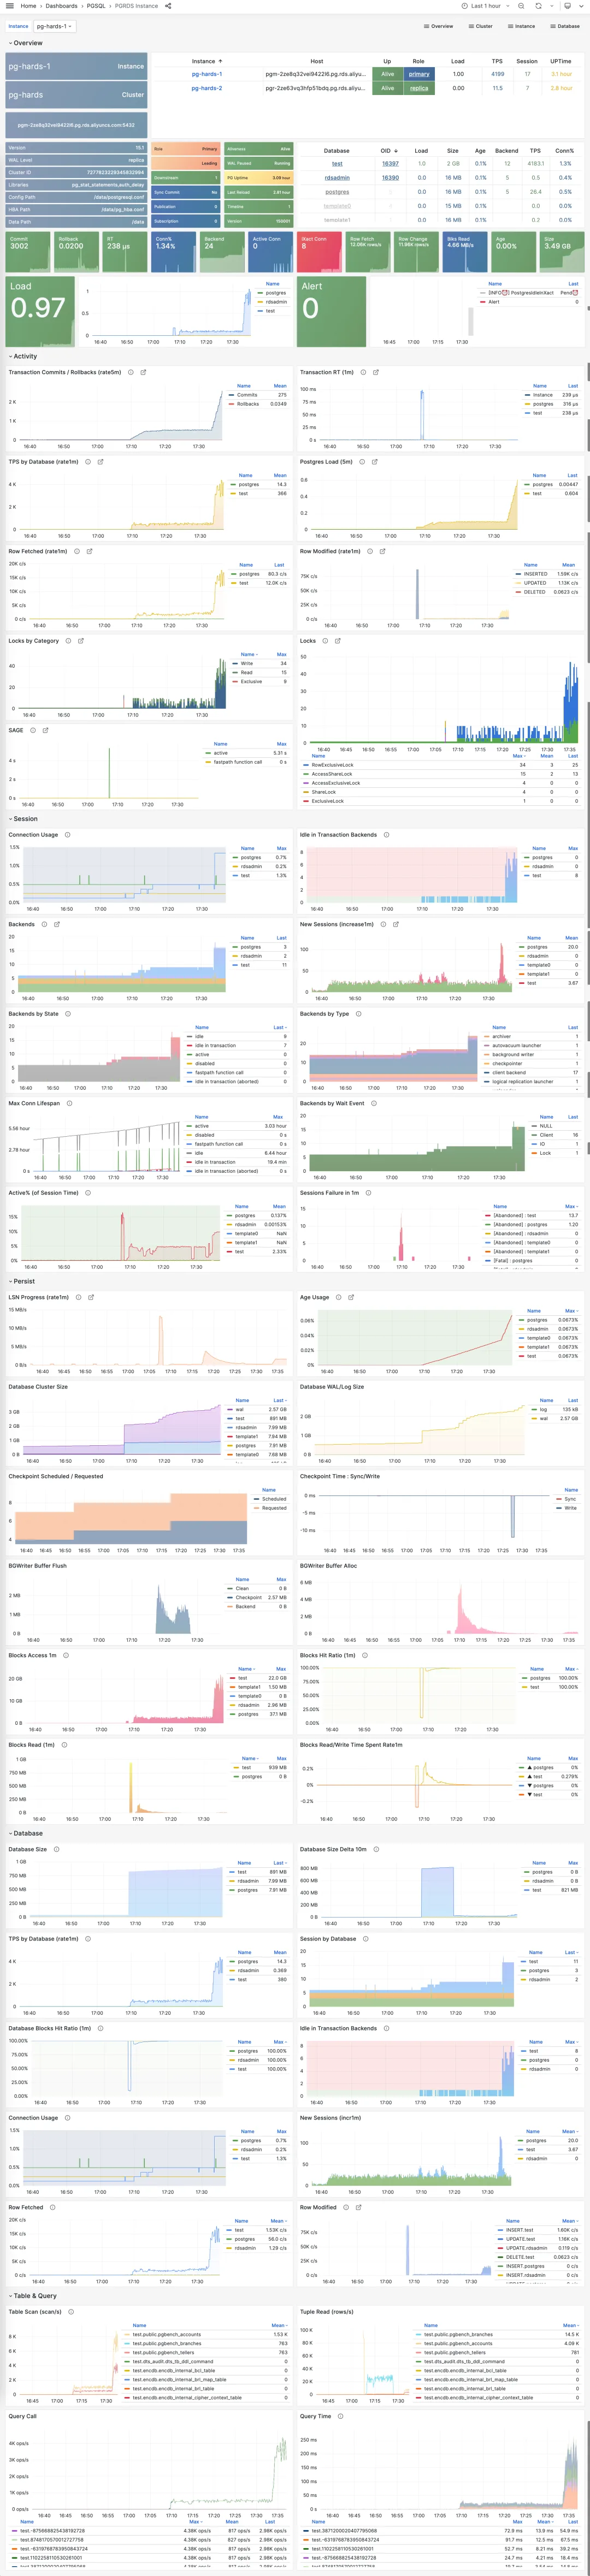
首屏显示集群成员、存活状态、数据库列表与导航,以及 13 个核心指标。点击面板可以查看详情。
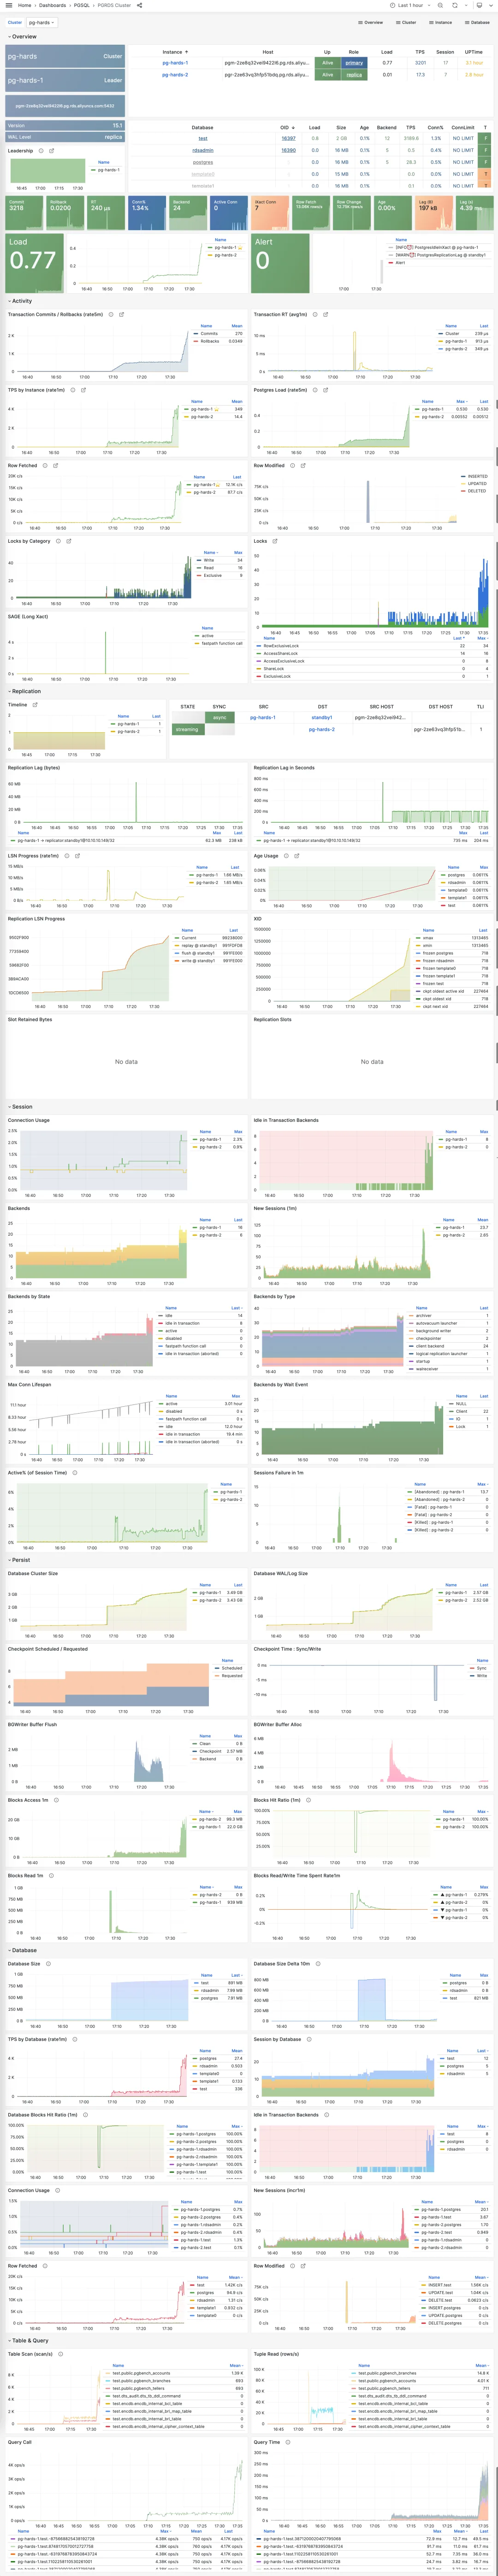
通过图表中的链接,可以在 PGRDS Cluster 与 PGRDS Instance 之间切换,查看集群汇总或单个实例。
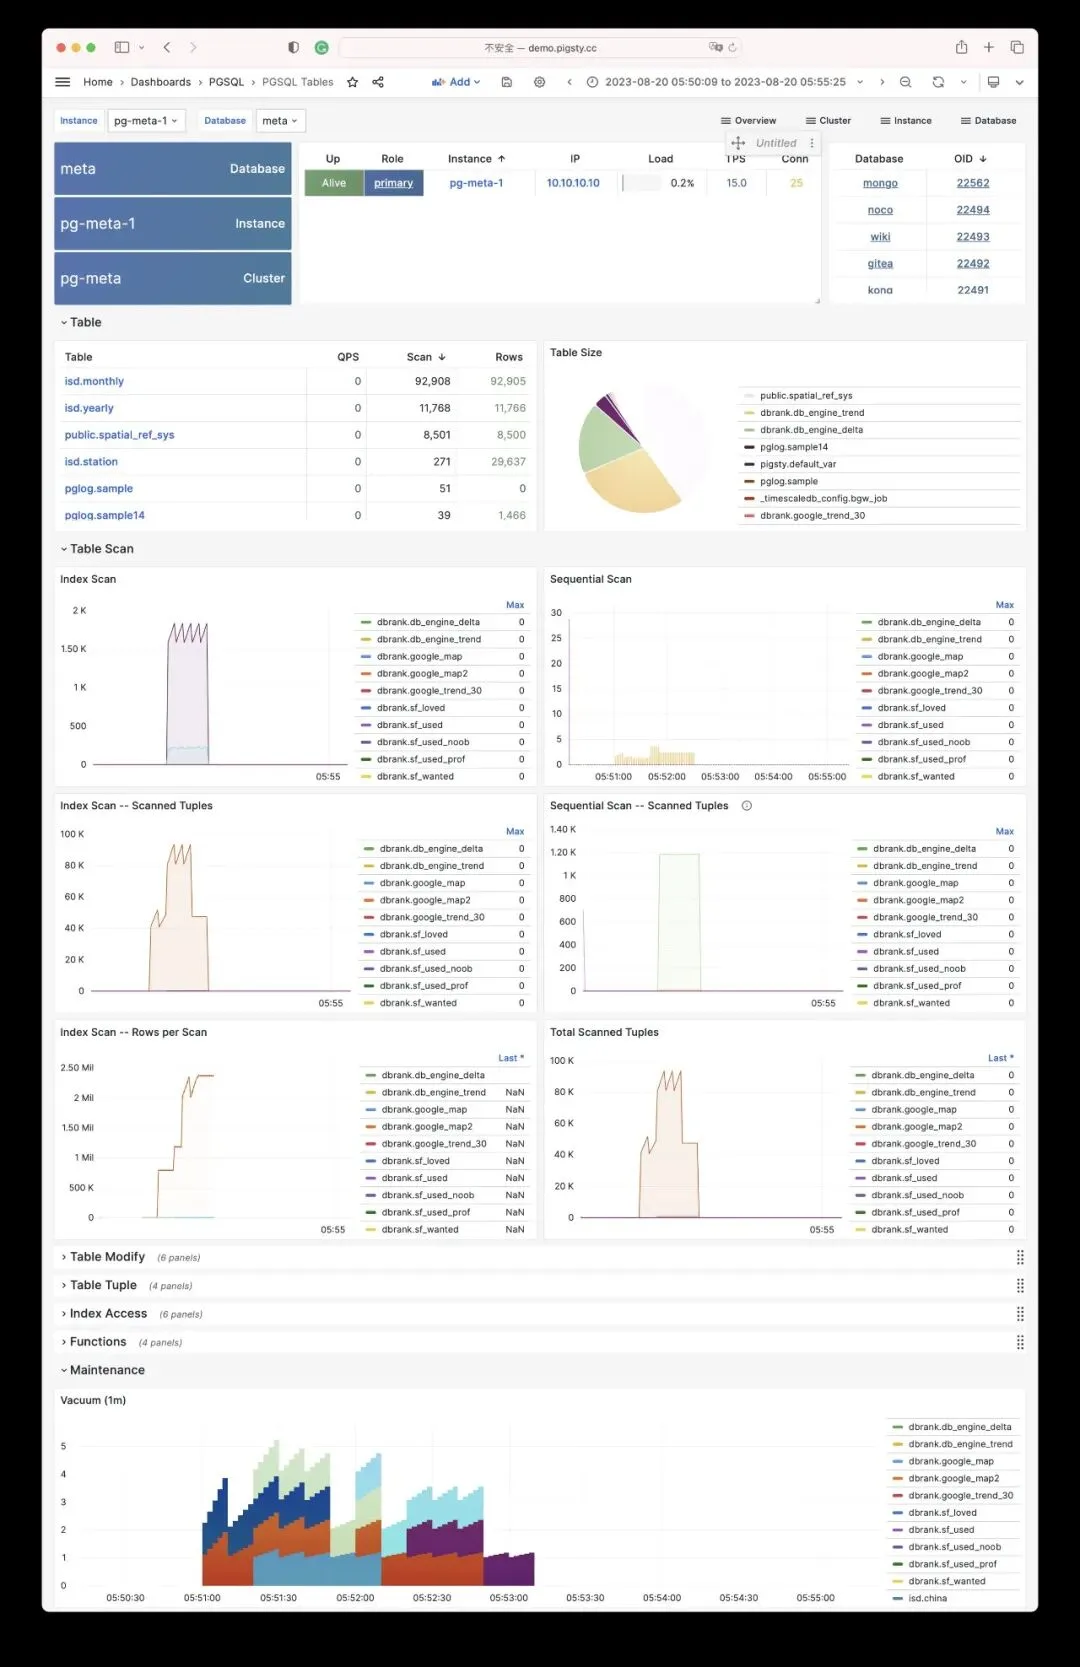
Overview 与 Database 面板也可用于这些实例,展示各类查询的 QPS、响应时间,以及每张表的读写活动。
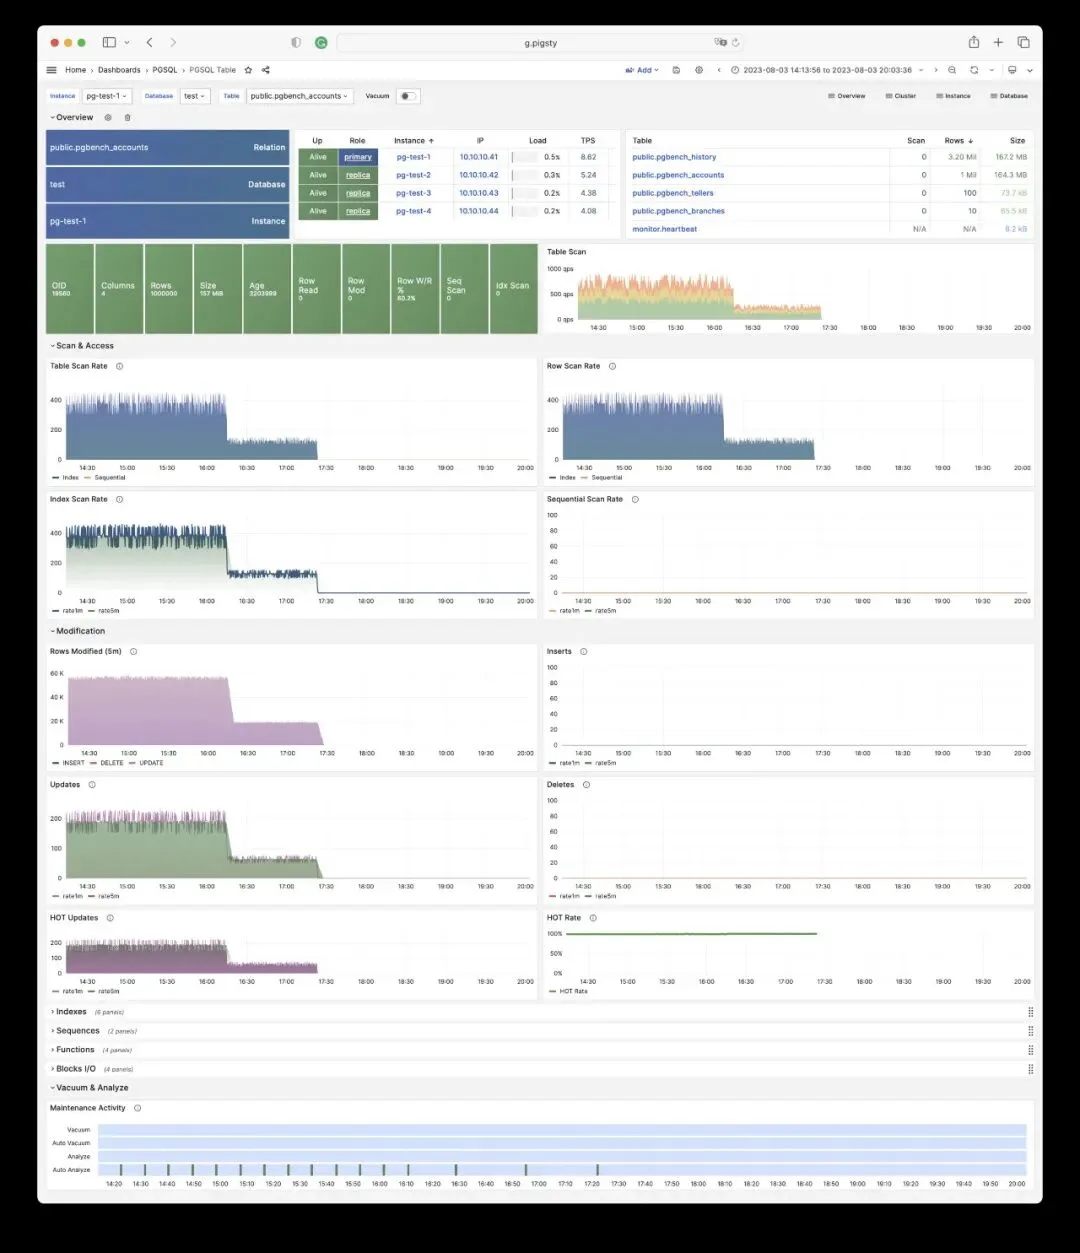
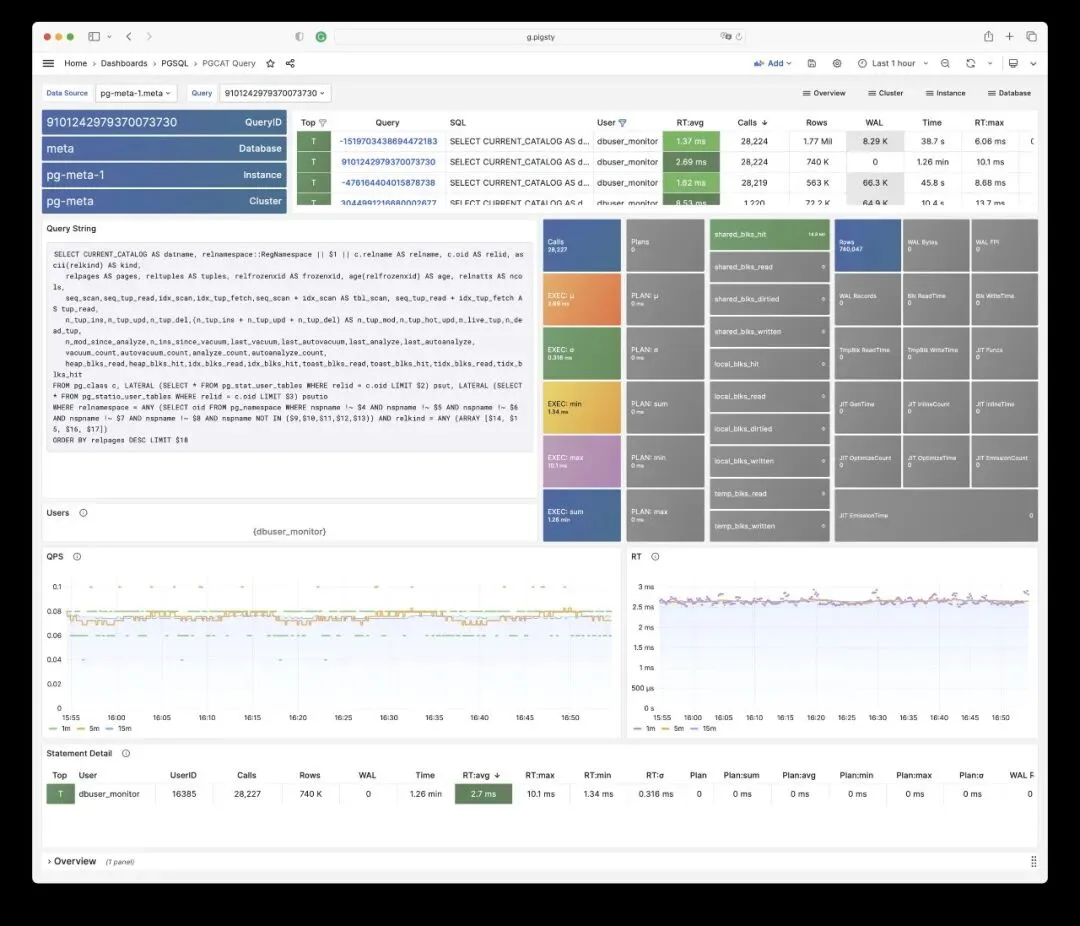
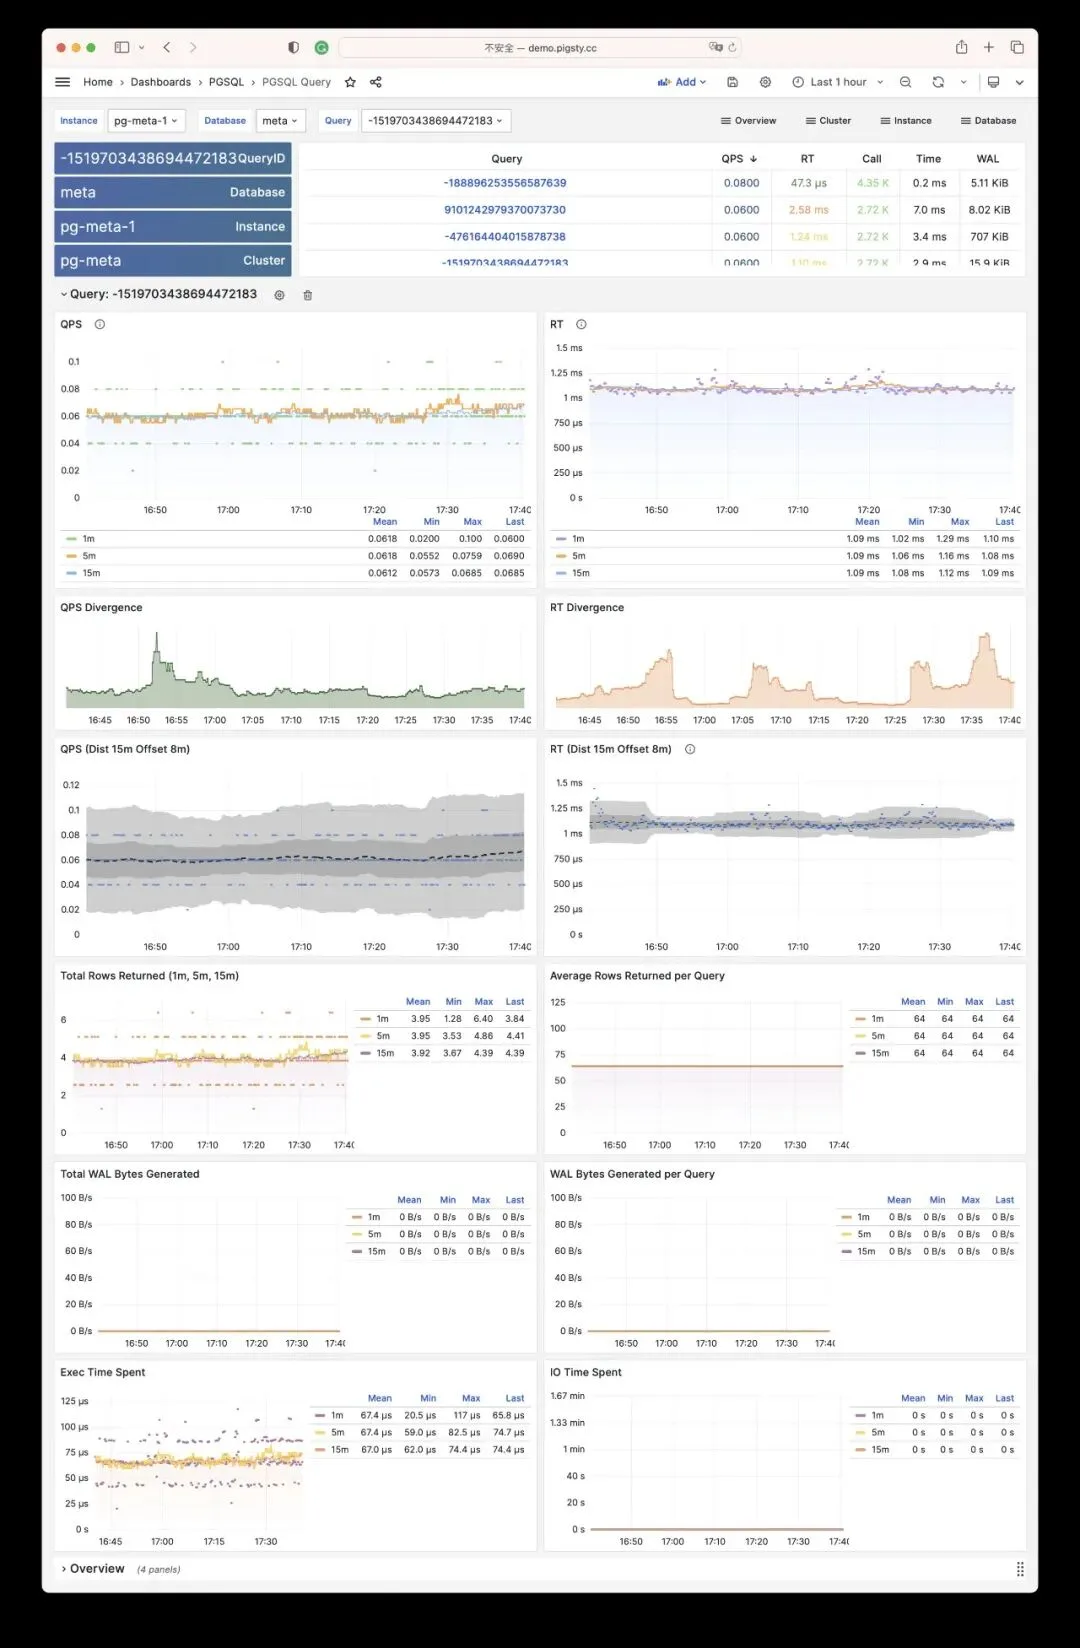
配置可选的数据库数据源后,还可以直接查询系统目录,查看当前锁等待与 Top SQL。
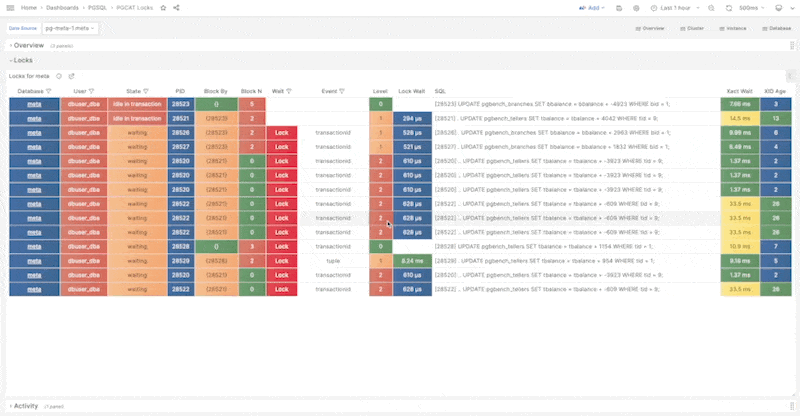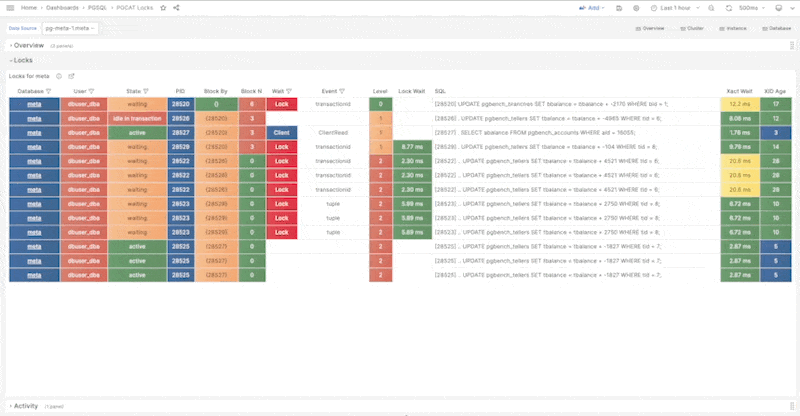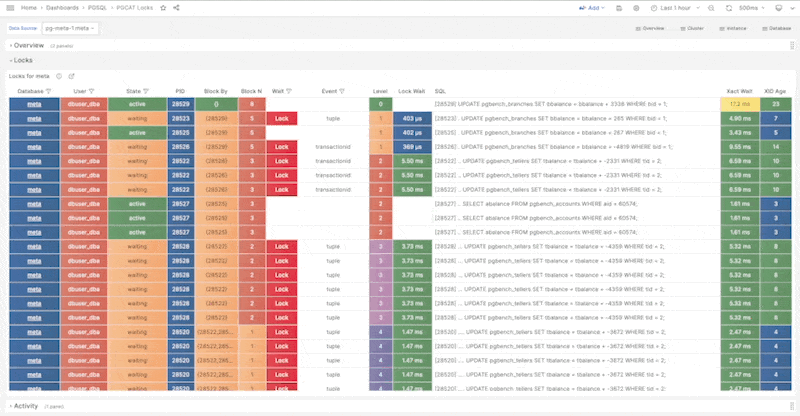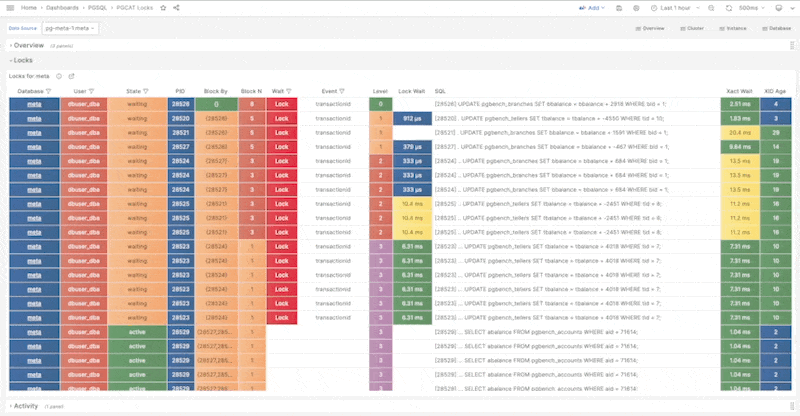
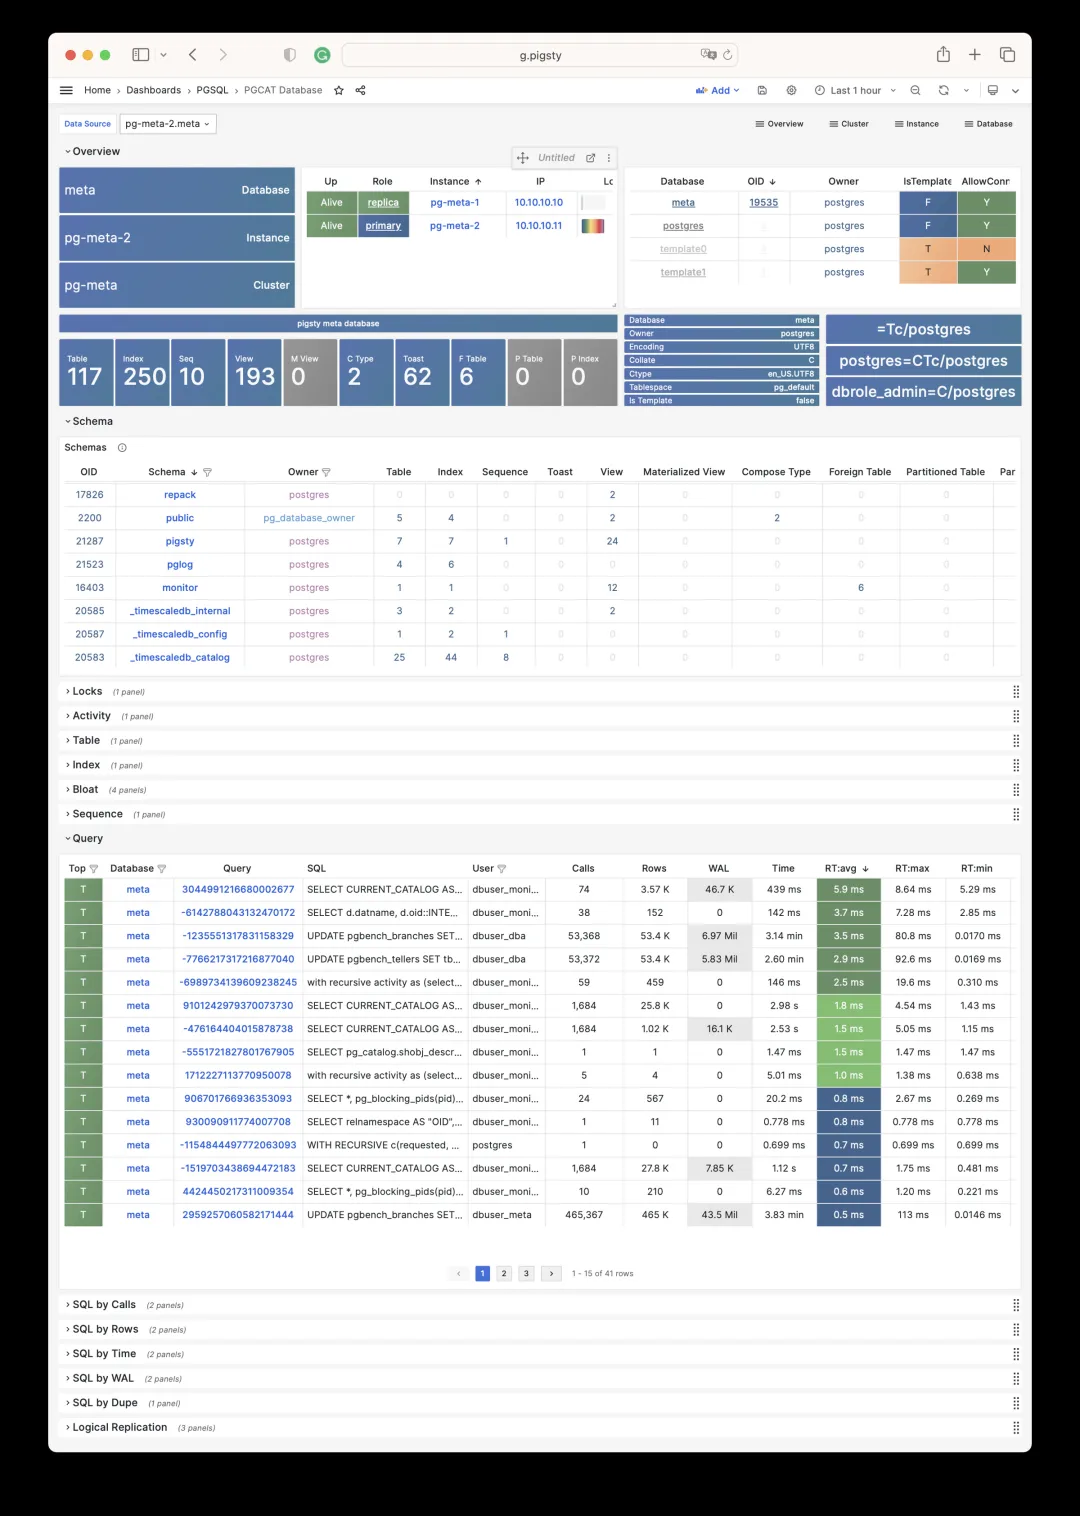
更多细节见 Pigsty 文档、公开演示与本文开头的视频教程。
加入 PGSQL × Pigsty 交流群,可在微信搜索 pigsty-cc 联系 Pigsty 小助手。
1.5 - PostgreSQL 慢查询诊断方法
本文使用 2021 年 2 月的 Pigsty 沙箱与仪表盘演示。
慢查询会占用连接、持有锁,并消耗 CPU 与 I/O。在备库上,长查询还可能与 WAL 重放冲突。PostgreSQL 会根据备库参数延迟重放或取消冲突查询,具体行为见热备冲突处理。
监控可以帮助我们找到受影响的查询,并比较变更前后的表现。
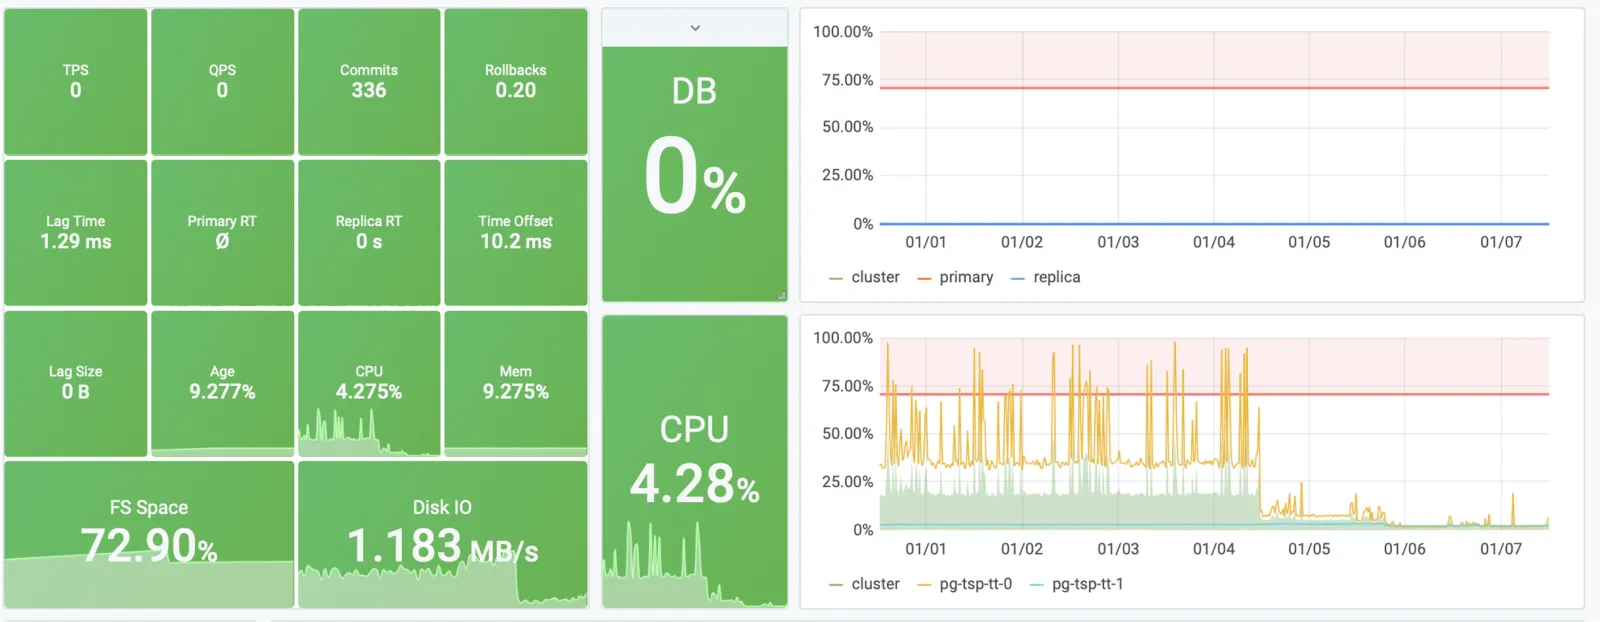
本例中,查询优化将 CPU 使用率从约 40% 降至 4%。
收集查询统计与日志
pg_stat_statements 扩展汇总相似语句的调用次数、执行时间、读取或影响的行数与 I/O 统计。按以下步骤启用:
- 将
pg_stat_statements加入shared_preload_libraries。 - 重启 PostgreSQL。
- 在需要读取统计信息的数据库中执行
CREATE EXTENSION pg_stat_statements。
查询 ID 标识归一化后的语句,不代表一次执行,也不保证使用同一个执行计划。统计列名会随 PostgreSQL 版本变化,使用时查阅对应版本的 pg_stat_statements 参考。
用 log_min_duration_statement 记录执行时间达到阈值的语句。日志适合分析某次慢执行。根据业务设置阈值:记录全部语句会增加日志量与采集开销。
累计平均值可能掩盖近期性能变化。通过连续采样,可以比较故障期间的响应时间、调用速率与 I/O。慢查询阈值应来自业务延迟要求;频繁点查与偶发批处理需要不同的阈值。
在沙箱中复现问题
本实验会主动删除索引,请使用可丢弃的 pgbench 测试数据库。
当时的 Pigsty 沙箱通过 make ri、make ro 和 make rw 初始化并运行 pg-test 集群上的负载。以下命令通过服务端口施加读写负载:
在不同终端运行两组负载,然后在主库上删除主键:
点查失去了索引。本次测试中,平均响应时间从约 1 ms 增至 300 ms,一个备库的 QPS 从 500 降至 7。
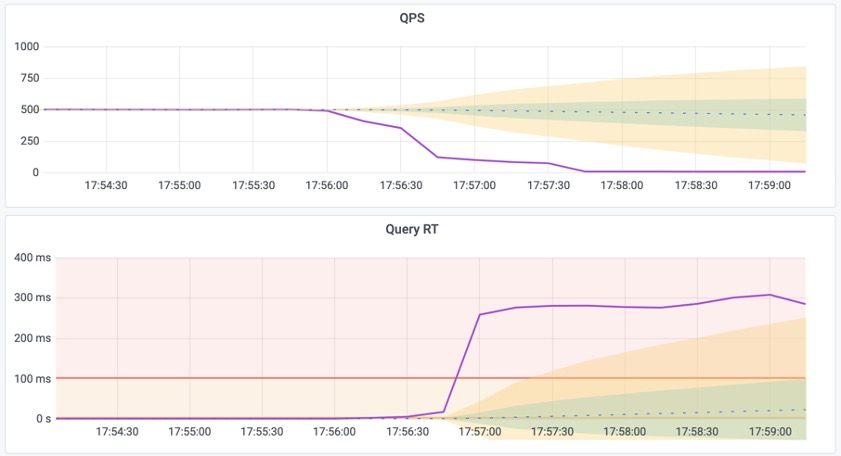
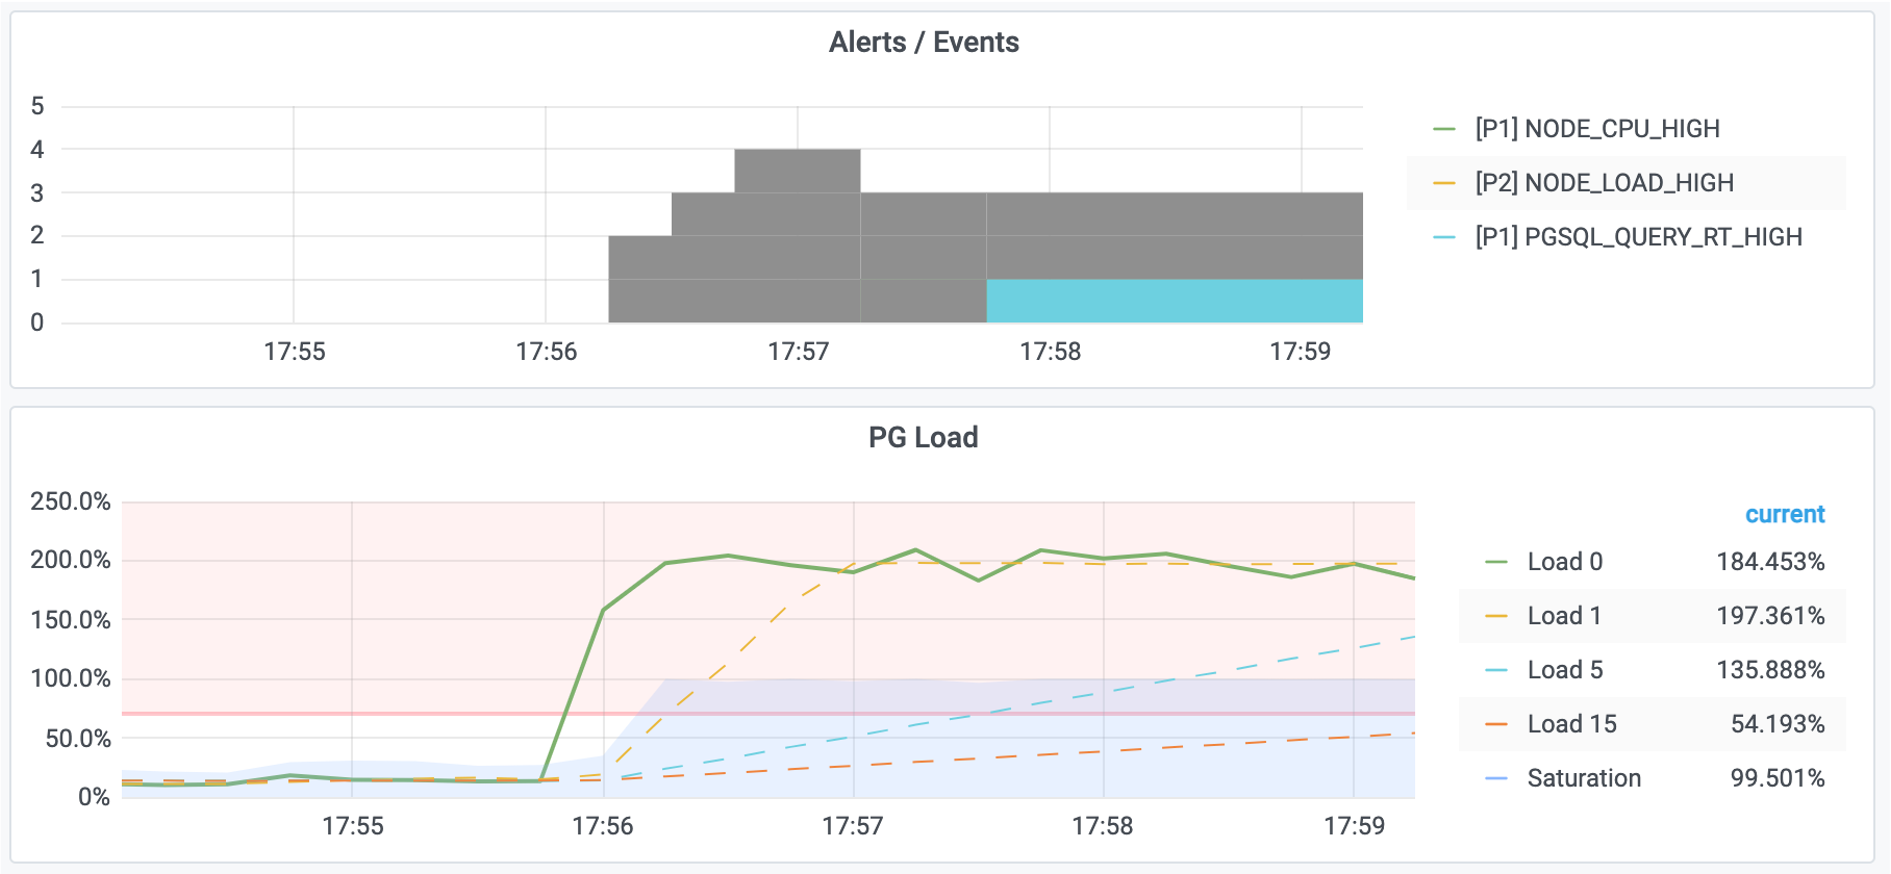
集群负载也随之上升,并触发告警。
定位查询
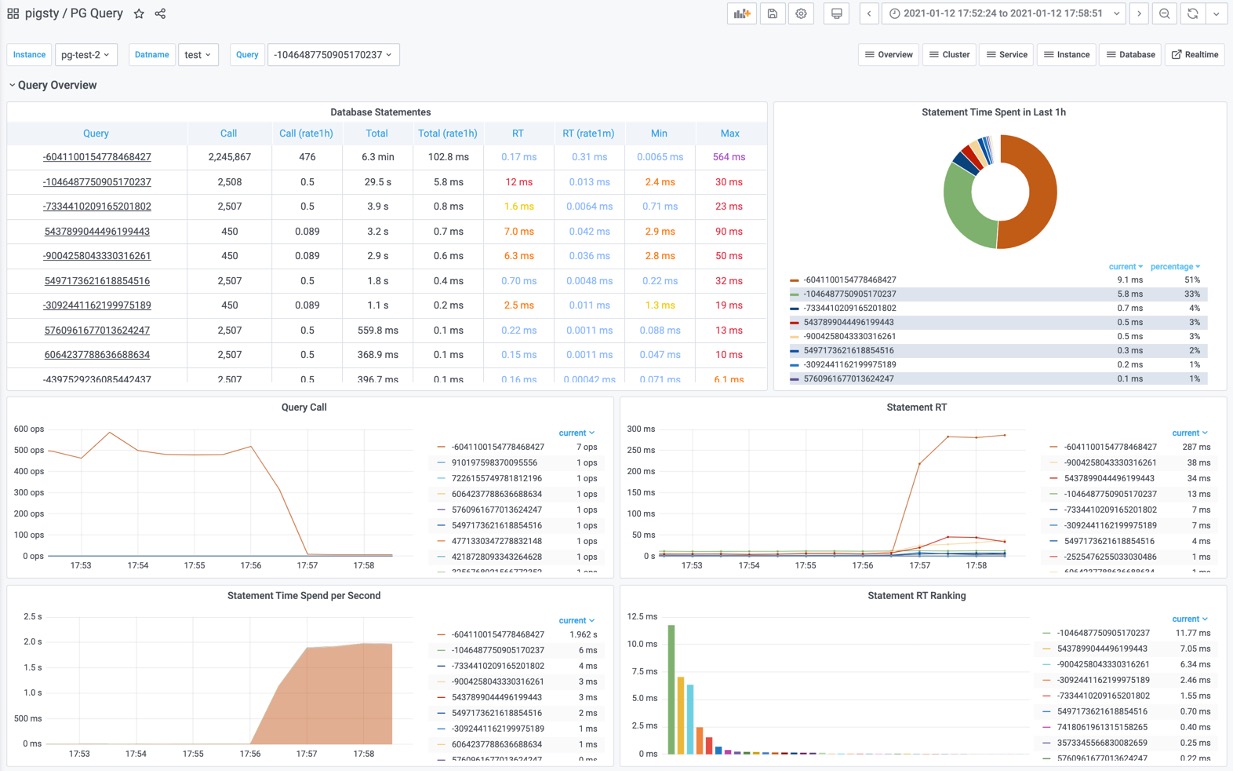
打开 PG Cluster 面板,找到受影响的实例。再打开 PG Query,定位响应时间和执行时间占比上升的语句。
本例中,查询 ID -6041100154778468427 的响应时间从约 17 μs 增至 280 ms,QPS 从 500 降至 7。
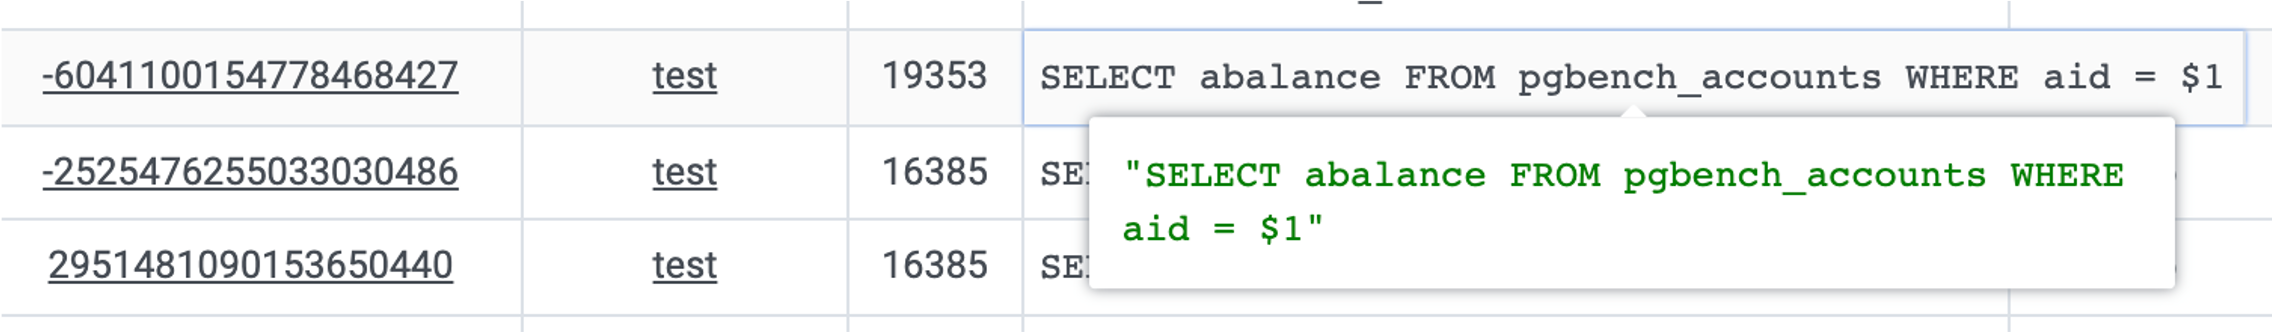
按查询 ID 打开 PG Query Detail,找到对应 SQL:
验证原因
这条语句按 aid 读取一个账户。在 PG Table Catalog 中检查该列是否有索引,再到 PG Table Detail 比较 pgbench_accounts 的索引扫描与顺序扫描次数。
本实验中,删除主键后索引扫描降至零,顺序扫描随之增加,与索引缺失的判断一致。
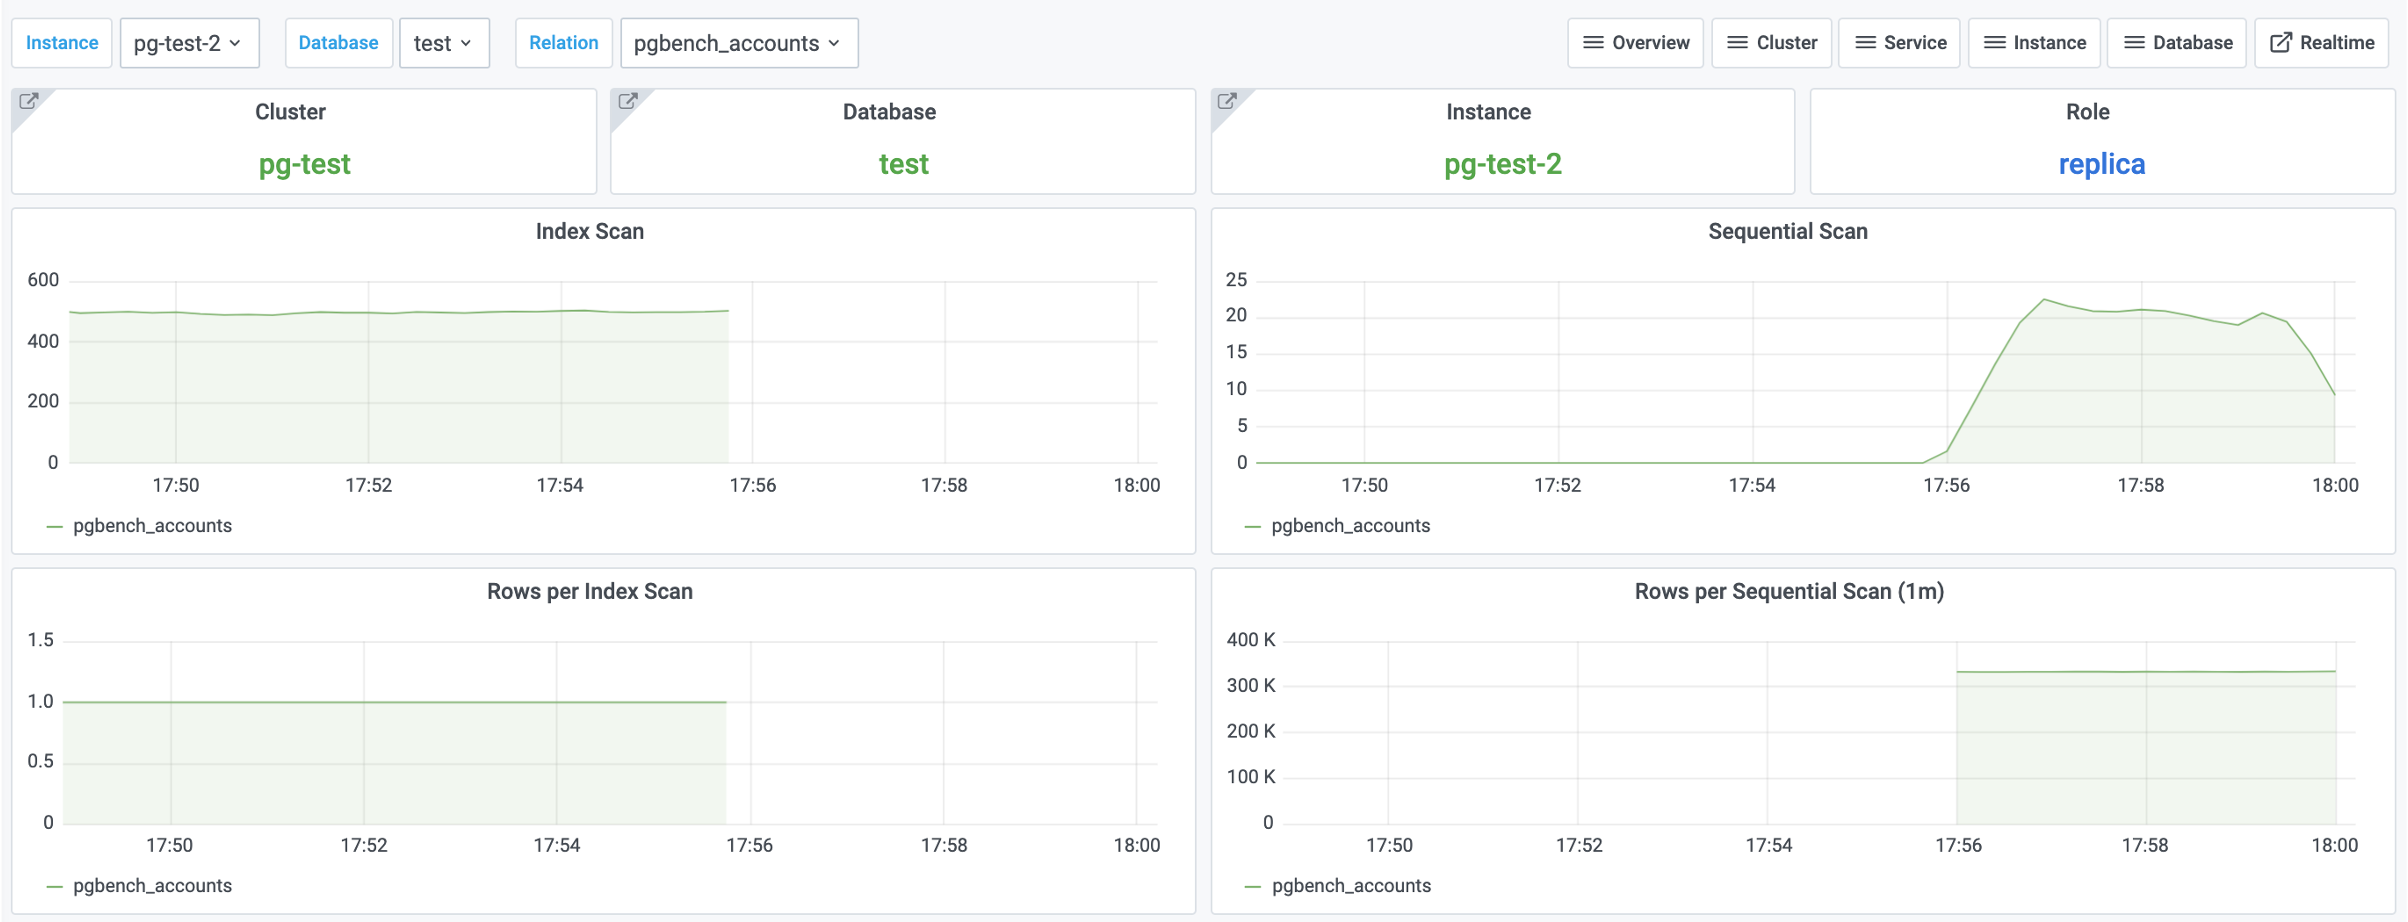
修复并检查结果
在沙箱中为 aid 恢复索引:
这会恢复索引访问路径,但不会重建此前删除的主键约束。
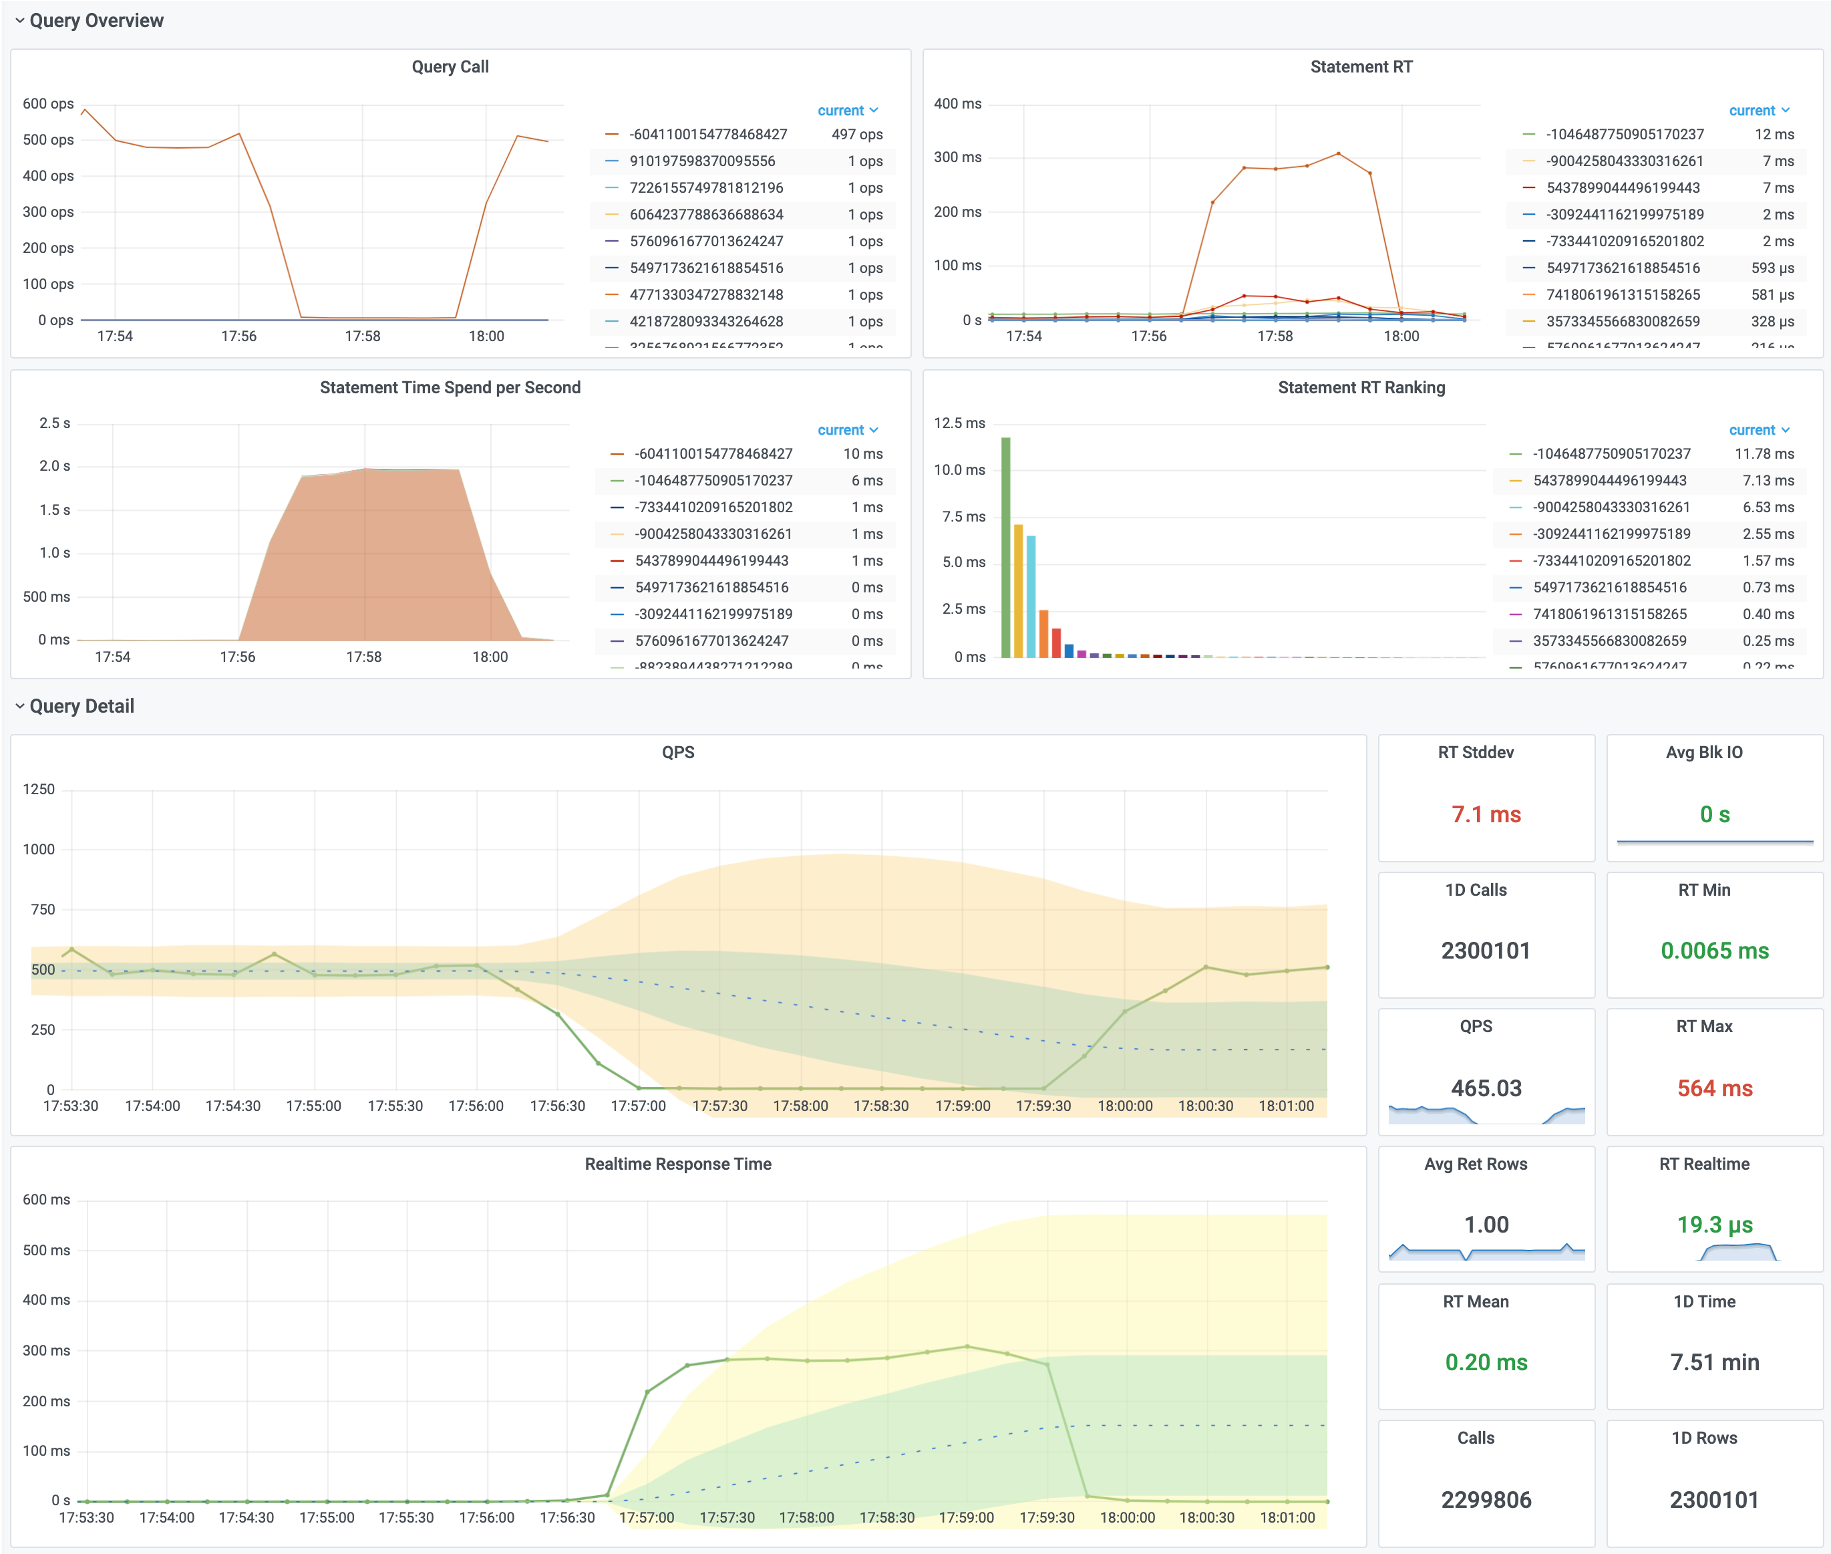
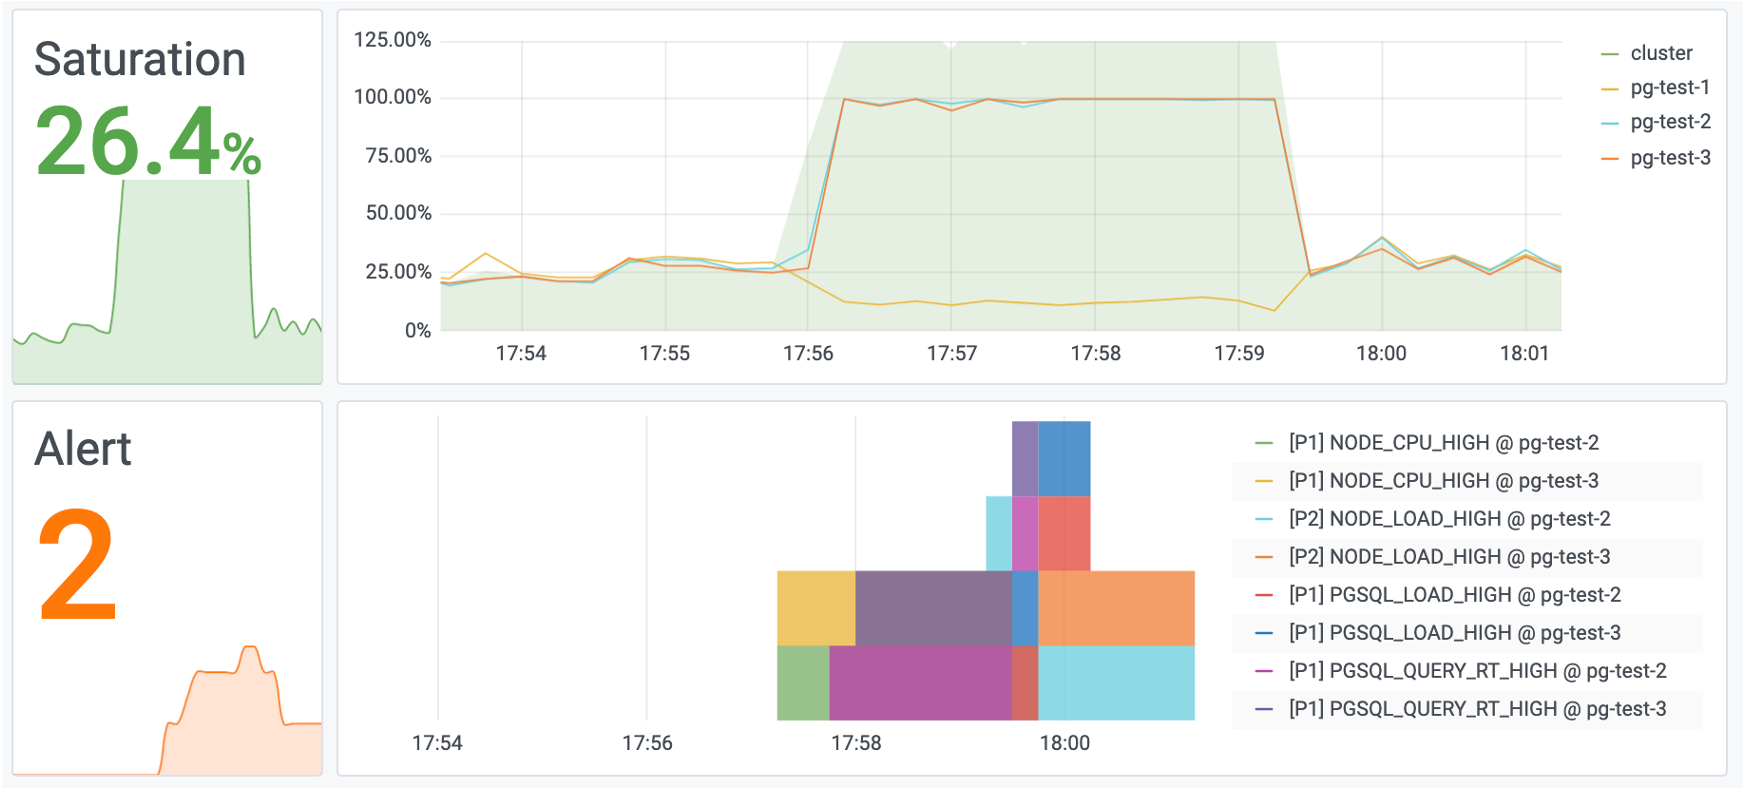
用相同负载与时间区间比较变更前后的结果,记录查询延迟、吞吐量和资源使用情况。完成实验后停止测试负载。
1.6 - Pigsty 首次发布
本文介绍 2021 年 1 月 Pigsty 首次发布时的产品状态。
今天,我发布了 Pigsty。
官方网站:pigsty.cc
Pigsty 是什么?
Pigsty 用于监控大规模 PostgreSQL 集群,也提供高可用集群的自动部署方案。它基于开源组件构建,是免费的开源软件。
我希望通过统一的监控界面与部署流程,减少管理 PostgreSQL 集群所需的手工操作。
监控系统
我需要管理一个大规模 PostgreSQL 集群。在尝试一些开源与商业监控产品后,没有找到满足需求的方案,于是开始开发 Pigsty。
Pigsty 的界面基于 Grafana。首次发布时,它包含 30 多个监控看板、上千个图表面板,约 18 万行 JSON 配置,覆盖数据库与基础设施。
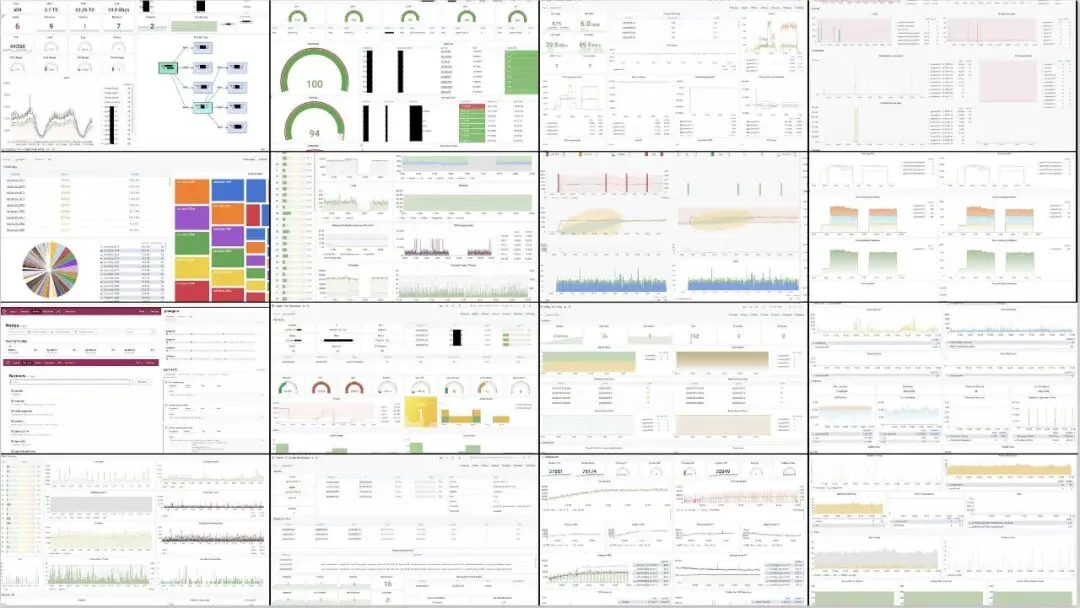
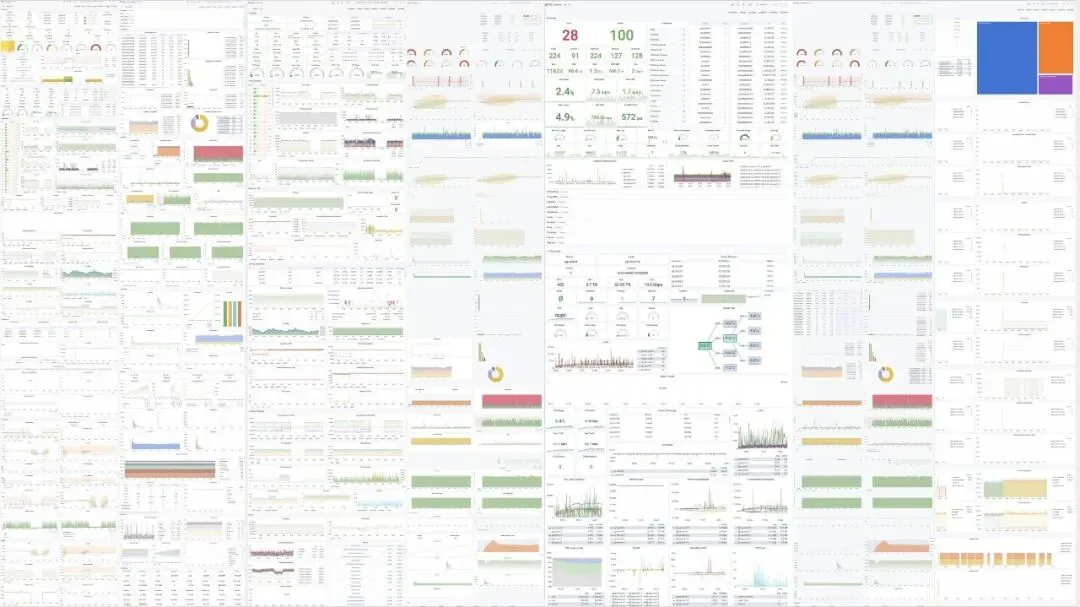
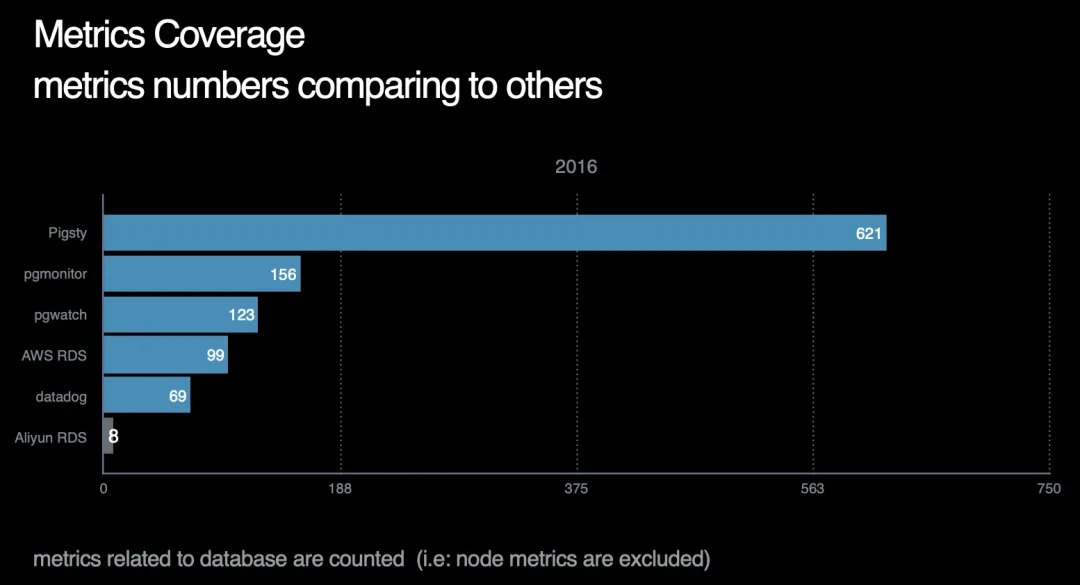
这个版本提供近 1200 个监控指标,可以查看整个集群的汇总数据,也可以继续查看单个数据库对象的读写活动。
集群供给方案
发布和演示监控系统需要可用的数据库环境。已有数据库的部署方式各不相同,因此我把数据库供给方案也纳入了 Pigsty。
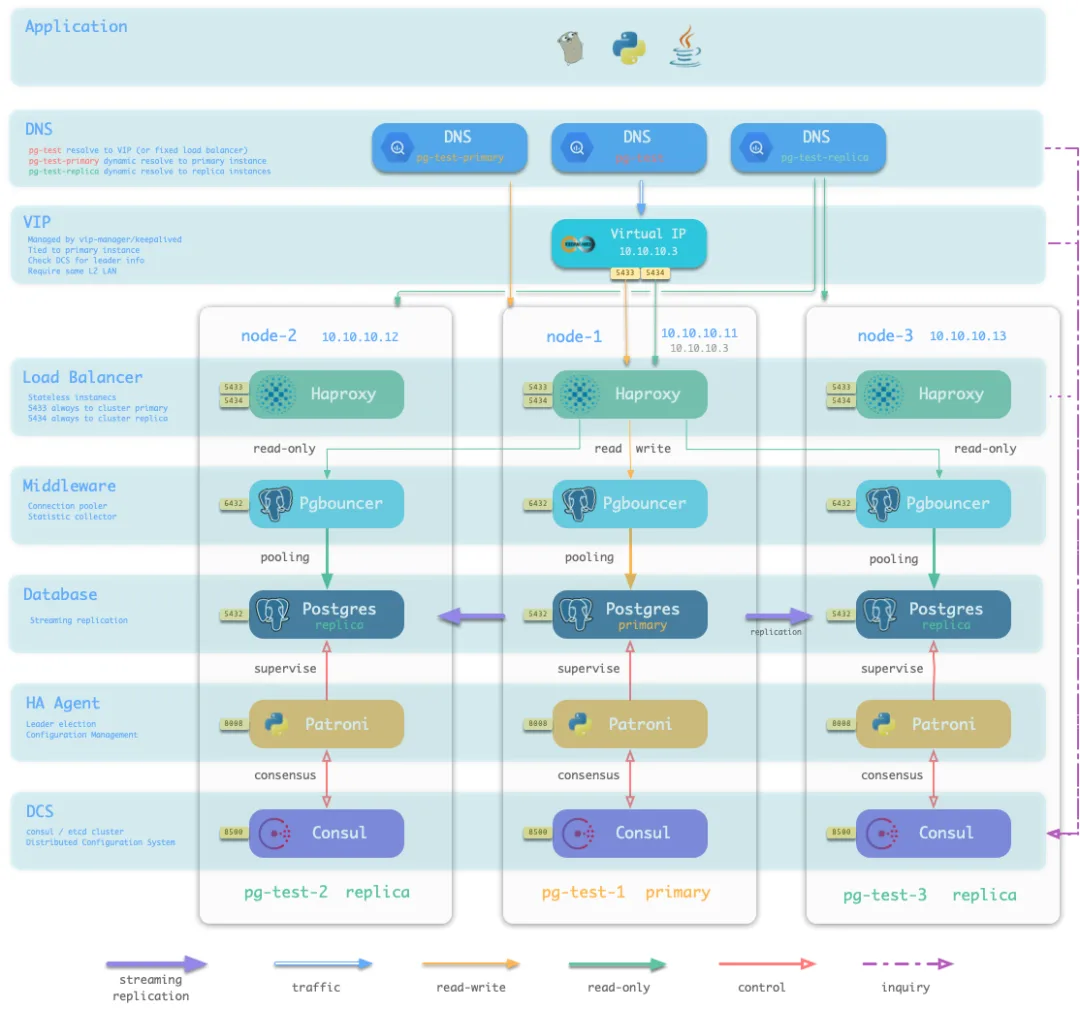
这套方案组合了主从复制、故障切换、流量代理、连接池、服务发现与基本权限配置,减少逐个配置组件的工作。
填写配置文件后,Pigsty 会按配置创建数据库集群。
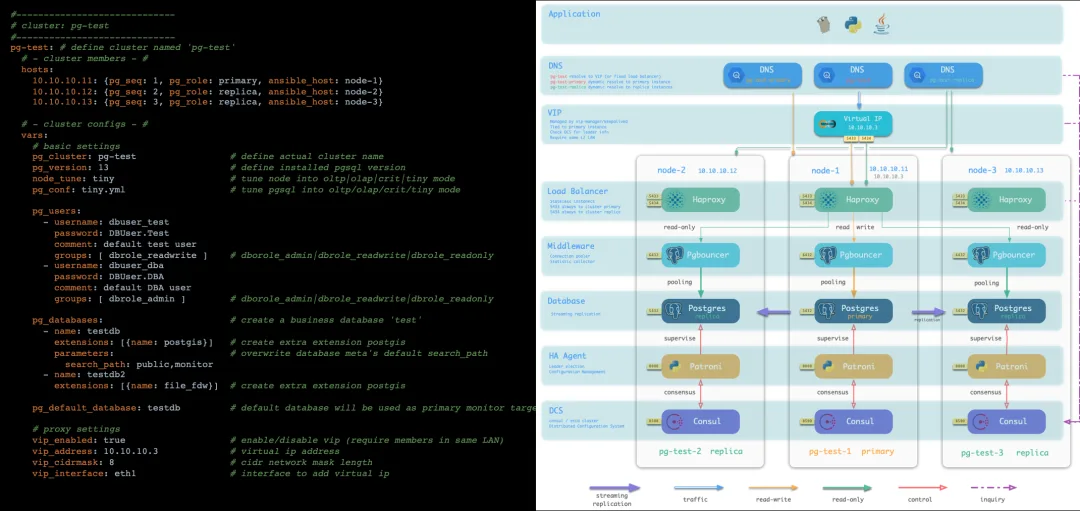
130 多个配置项用于定义数据库与基础设施。部署使用声明式配置和幂等执行机制,在物理机与虚拟机上通过代码管理基础设施,工作方式类似 Kubernetes。
开源组件与许可
此版本的 Pigsty 使用 Apache 2.0 许可证,同时提供专业版与可选的商业支持。欢迎提交 Issue、PR,或通过捐赠与赞助支持项目。
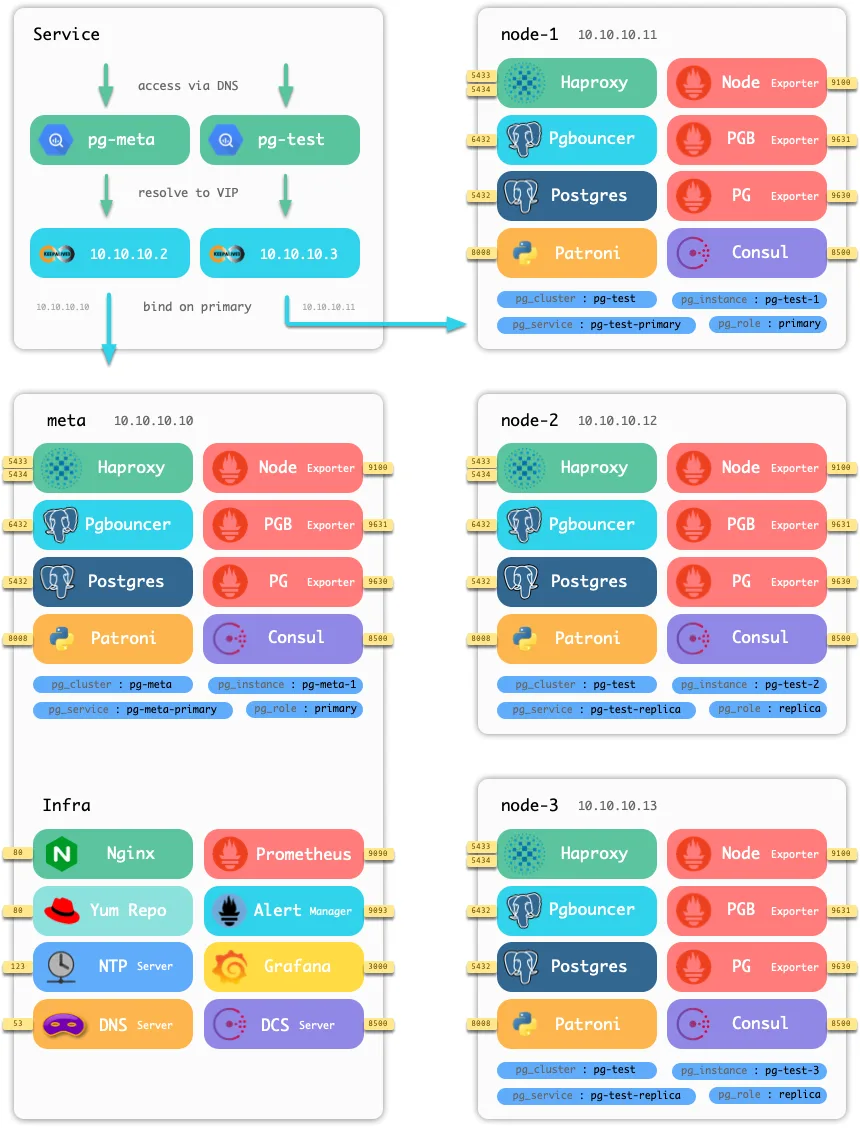
监控系统使用 Prometheus、Grafana、Alertmanager 与 Exporter,并包含 Nginx、Dnsmasq/CoreDNS、NTP/Chrony、Consul/etcd 等基础设施组件。这些组件可以与已有监控系统集成。
供给方案通过 Ansible 部署 PostgreSQL、PgBouncer、Patroni、HAProxy 与 Keepalived。部署逻辑写成 Ansible Role,便于集成和定制。
试用 Pigsty
Pigsty 提供中英文文档、公开演示站点与基于 Vagrant 的本地沙箱。首次发布时,以下命令可以在笔记本上创建包含数据库集群与监控基础设施的沙箱:
生产环境也使用这套部署流程,需要按实际主机、网络与数据库要求调整配置。
项目链接
1.7 - 黄金监控指标:错误延迟吞吐饱和
本文写于 2020 年,指标数量与示例对应当时的部署。
前言
玩数据库和玩车有一个共通之处,就是都需要经常看仪表盘。
仪表盘上的指标显示当前运行状态,帮助我们决定何时采取行动。
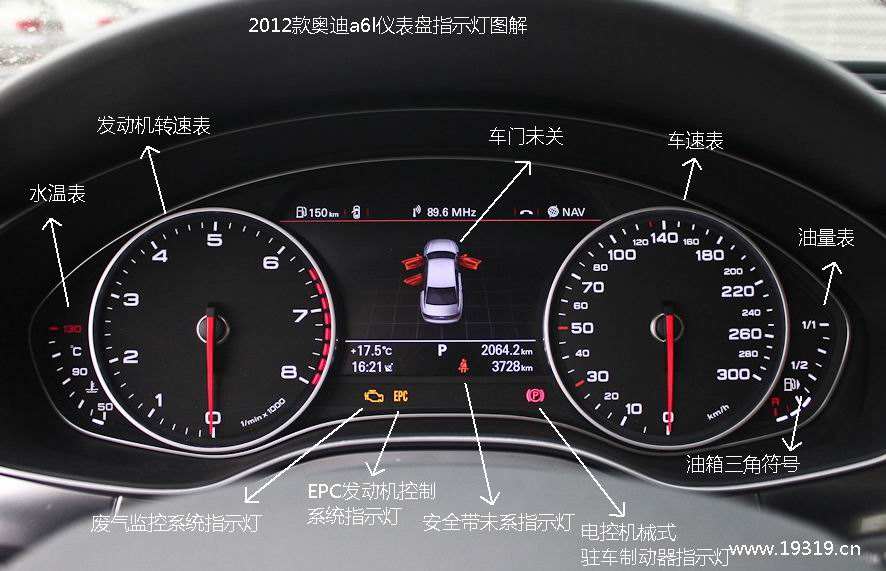
车有很多指标:车速,胎压,扭矩,刹车片磨损,各种温度,等等等等,各式各样。
但人的注意力有限,仪表盘空间也有限。
所以,指标可以分两类:
- 你会去看的:黄金指标 / 关键指标 / 核心指标
- 你不会看的:黑匣子指标 / 冷指标。
黄金指标就是那几个关键性的核心数据,需要时刻保持关注(或者让自动驾驶系统/报警系统替你时刻保持关注),而冷指标通常只有故障排查时才会去看,故障排查与验尸要求尽可能还原现场,黑匣子指标多多益善。需要时没有记录,就很难还原问题。
今天我们来说说PostgreSQL的核心指标,数据库的核心指标是什么?
数据库的指标
在讲数据库的核心指标之前,我们先来瞄一眼有哪些指标。
在本文使用的部署中,这两条查询显示:每个实例有 1,000 多条 PostgreSQL 序列和 2,000 多条主机序列。
这些序列可用于排查问题和可视化分析。
但对于日常管理,只需要少数几个核心指标就可以了。
可用指标千千万,哪些才是核心指标?
核心指标
根据经验和使用频度,不断地做减法,可以筛选出一些核心指标:
| 指标 | 缩写 | 层次 | 来源 | 种类 |
|---|---|---|---|---|
| 错误日志条数 | Error Count | SYS/DB/APP | 日志系统 | 错误 |
| 连接池排队数 | Queue Clients | DB | 连接池 | 错误 |
| 数据库负载 | PG Load | DB | 连接池 | 饱和度 |
| 数据库饱和度 | PG Saturation | DB | 连接池&节点 | 饱和度 |
| 主从复制延迟 | Repl Lag | DB | 数据库 | 延迟 |
| 平均查询响应时间 | Query RT | DB | 连接池 | 延迟 |
| 活跃后端进程数 | Backends | DB | 数据库 | 饱和度 |
| 数据库年龄 | Age | DB | 数据库 | 饱和度 |
| 每秒查询数 | QPS | APP | 连接池 | 流量 |
| CPU使用率 | CPU Usage | SYS | 机器节点 | 饱和度 |
事故发生时,我优先看错误指标。
日常应用监控重点看 QPS 与响应时间。
容量管理重点看数据库饱和度。
为什么是它们?
错误指标
我通常先检查 错误,因为它们往往直接影响用户。
如果只能选一个指标进行监控,那么选 错误指标,比如应用,系统,DB层的每秒错误日志条数可能最合适。
错误次数和错误率可以反映故障,用于告警和诊断,但不能单独说明还有多少可用容量。
连接池队列增长,说明可用连接出现竞争。但单看队列长度,无法确定瓶颈或衡量剩余容量。
要在用户看到错误之前发现压力,还应监控延迟、资源使用和队列。
指标用于衡量系统运行状态。我们还会关注系统其他方面的能力:吞吐量/流量,响应时间/延迟,饱和度/利用率/水位线。这三者分别代表系统的能力,服务质量,负载水平。
关注点不同,后端(数据库用户)关注系统能力与服务质量,DBA(数据库管理者)更关注系统的负载水平。
流量指标
流量类的指标很有潜力,特别是QPS,TPS这样的指标相当具有代表性。
流量指标衡量当前完成的工作量,例如每秒处理的订单数或请求数,不能直接表示容量上限。
车速计显示当前速度,但不表示还能加速多少。吞吐量也有同样的区别。
QPS 和 TPS 衡量完成的工作量,不衡量每次调用的成本。耗时 10 微秒和 10 秒的查询都只算一次调用。应结合查询类型、延迟和资源使用情况比较吞吐量,并通过压测为已知工作负载建立基线。
延迟指标
延迟适合衡量系统的服务质量。
RT(响应时间)衡量服务质量。应按工作负载设置目标,例如某类 OLTP 服务可能要求 1 ms 的响应时间。延迟上升可能表示资源争用,但不能单独用于测量饱和度。平均值也可能掩盖慢请求;有耗时分布数据时,可结合 P99、P99.9 分析。
饱和度指标
饱和度指标类似汽车的发动机转速表,油量表,水温表。
饱和度指标适合衡量系统的负载
饱和度描述受限资源承受的压力。利用率和队列长度有助于识别饱和,但衡量的是不同现象。应根据工作负载基线和响应时间目标设定告警阈值。压力长期偏高时,需要评估容量、查询成本和资源限制。
| 其他可选指标 | ||||
|---|---|---|---|---|
| 每秒事务数 | TPS | APP | 连接池 | 流量 |
| 磁盘IO使用率 | Disk Usage | SYS | 机器节点 | 饱和度 |
| 内存使用率 | Mem Usage | SYS | 机器节点 | 饱和度 |
| 网卡带宽使用率 | Net Usage | SYS | 机器节点 | 饱和度 |
| TCP错误:溢出重传等 | TCP ERROR | SYS | 机器节点 | 错误 |
1.8 - Pigsty PostgreSQL 监控系统介绍
本文介绍 2020 年 5 月的 Pigsty,指标数量与面板名称均对应当时的系统。
我最近开发了一套数据库监控系统,名为 Pigsty。下面介绍它的架构、面板与指标。
Pigsty 使用 Grafana、Prometheus 与 Consul。PIGSTY /pɪɡ staɪ/ 是 “Postgres in Grafana Style” 的缩写。
整体架构
Node、PostgreSQL 与 PgBouncer Exporter 采集指标,Consul 提供服务发现,Prometheus 保存和计算指标,Grafana 展示数据。
服务发现还提供身份标签,用于组织监控目标。Prometheus 的记录规则计算衍生指标,供 Grafana 查询。下面主要介绍 Grafana 面板。
监控层次
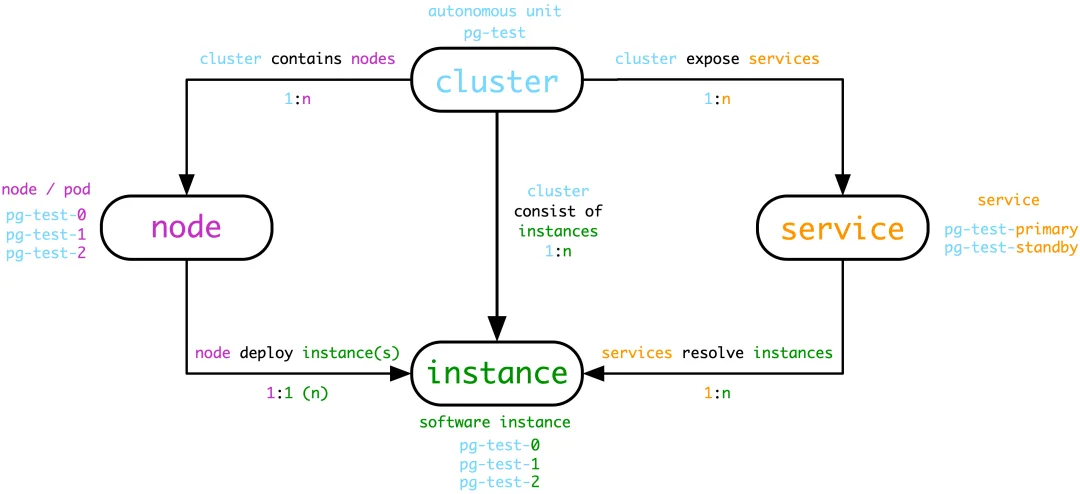
监控模型分为集群、服务、实例、数据库与节点五层。此版本把服务指标纳入集群面板,把数据库指标纳入实例面板,因此主要视图是集群、实例与节点。
cls标识集群,例如pg-test-tt。ins标识实例,例如pg-test-tt-0,由集群名和实例序号组成。在本部署中,序号为 0 的实例通常是主库。ip标识节点。
此外还有全局概览、分片集群、单个数据库、连接池、单条查询与 PgBouncer 专用面板。本文主要介绍核心视图。
功能
系统用于日常巡检、故障诊断与性能优化,包含以下面板:
- PostgreSQL 全局概览。
- PostgreSQL 分片集群监控。
- PostgreSQL 集群监控。
- PostgreSQL 实例监控。
- PostgreSQL 实例故障排查视图。
- PostgreSQL 主机监控。
- 慢查询分析。
- Redis 全局概览。
- Redis 集群监控。
- Redis 实例监控。
- PostgreSQL 集群健康评估。
首页与导航
首页包含 PostgreSQL 和 Redis 两部分。左侧显示全局指标,右侧提供集群导航,中间显示告警与事件。点击导航链接,或分片名、集群名、实例名、IP 地址,可以打开对应面板。
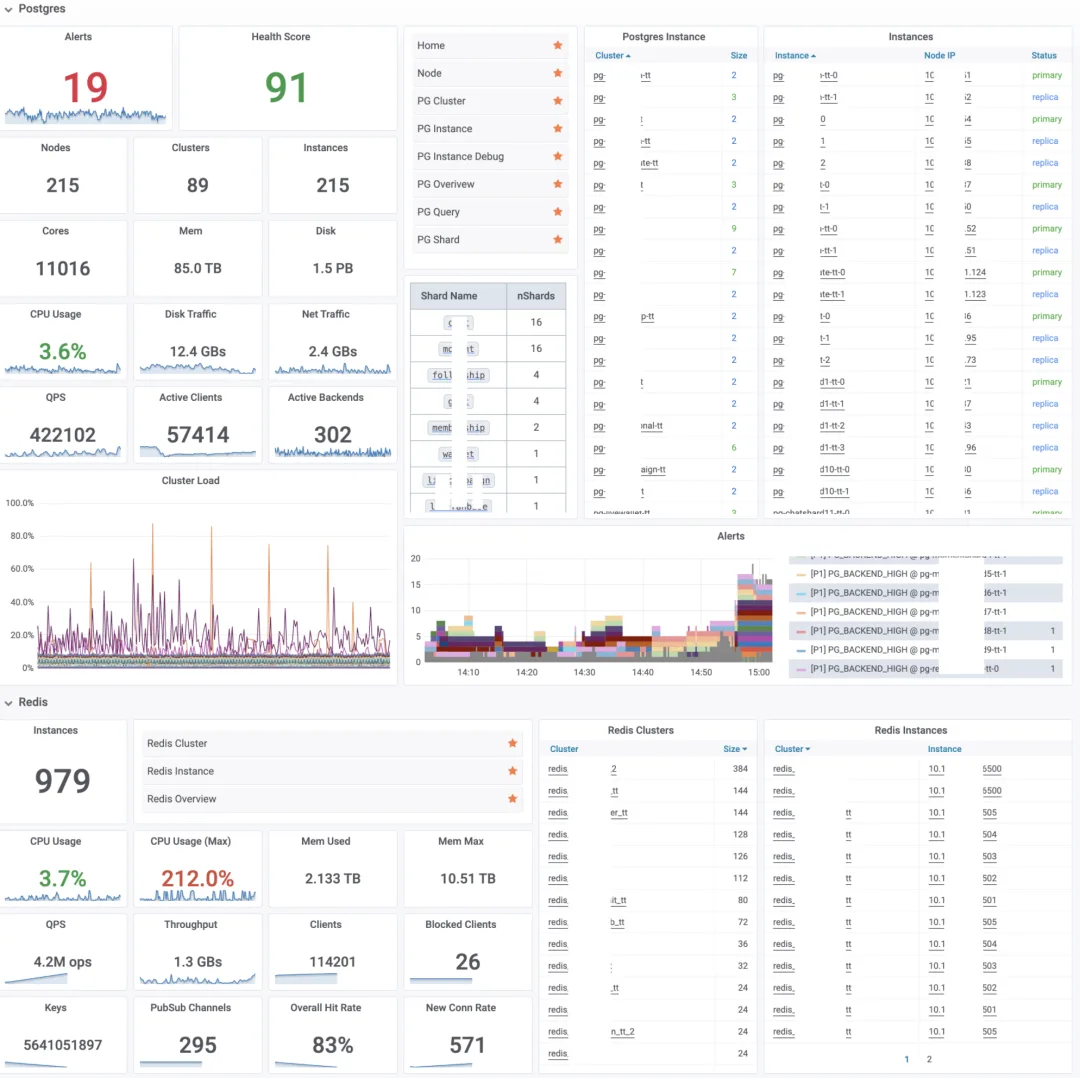
数据库指标
指标覆盖范围
当时每个实例约有 3300 个指标,其中包括:
- 约 1000 个数据库与连接池指标,其中 250 个由记录规则计算。
- 约 2000 个节点指标,其中 700 个由记录规则计算。
例如,QPS 按不同维度聚合后,产生近 30 个相关指标:
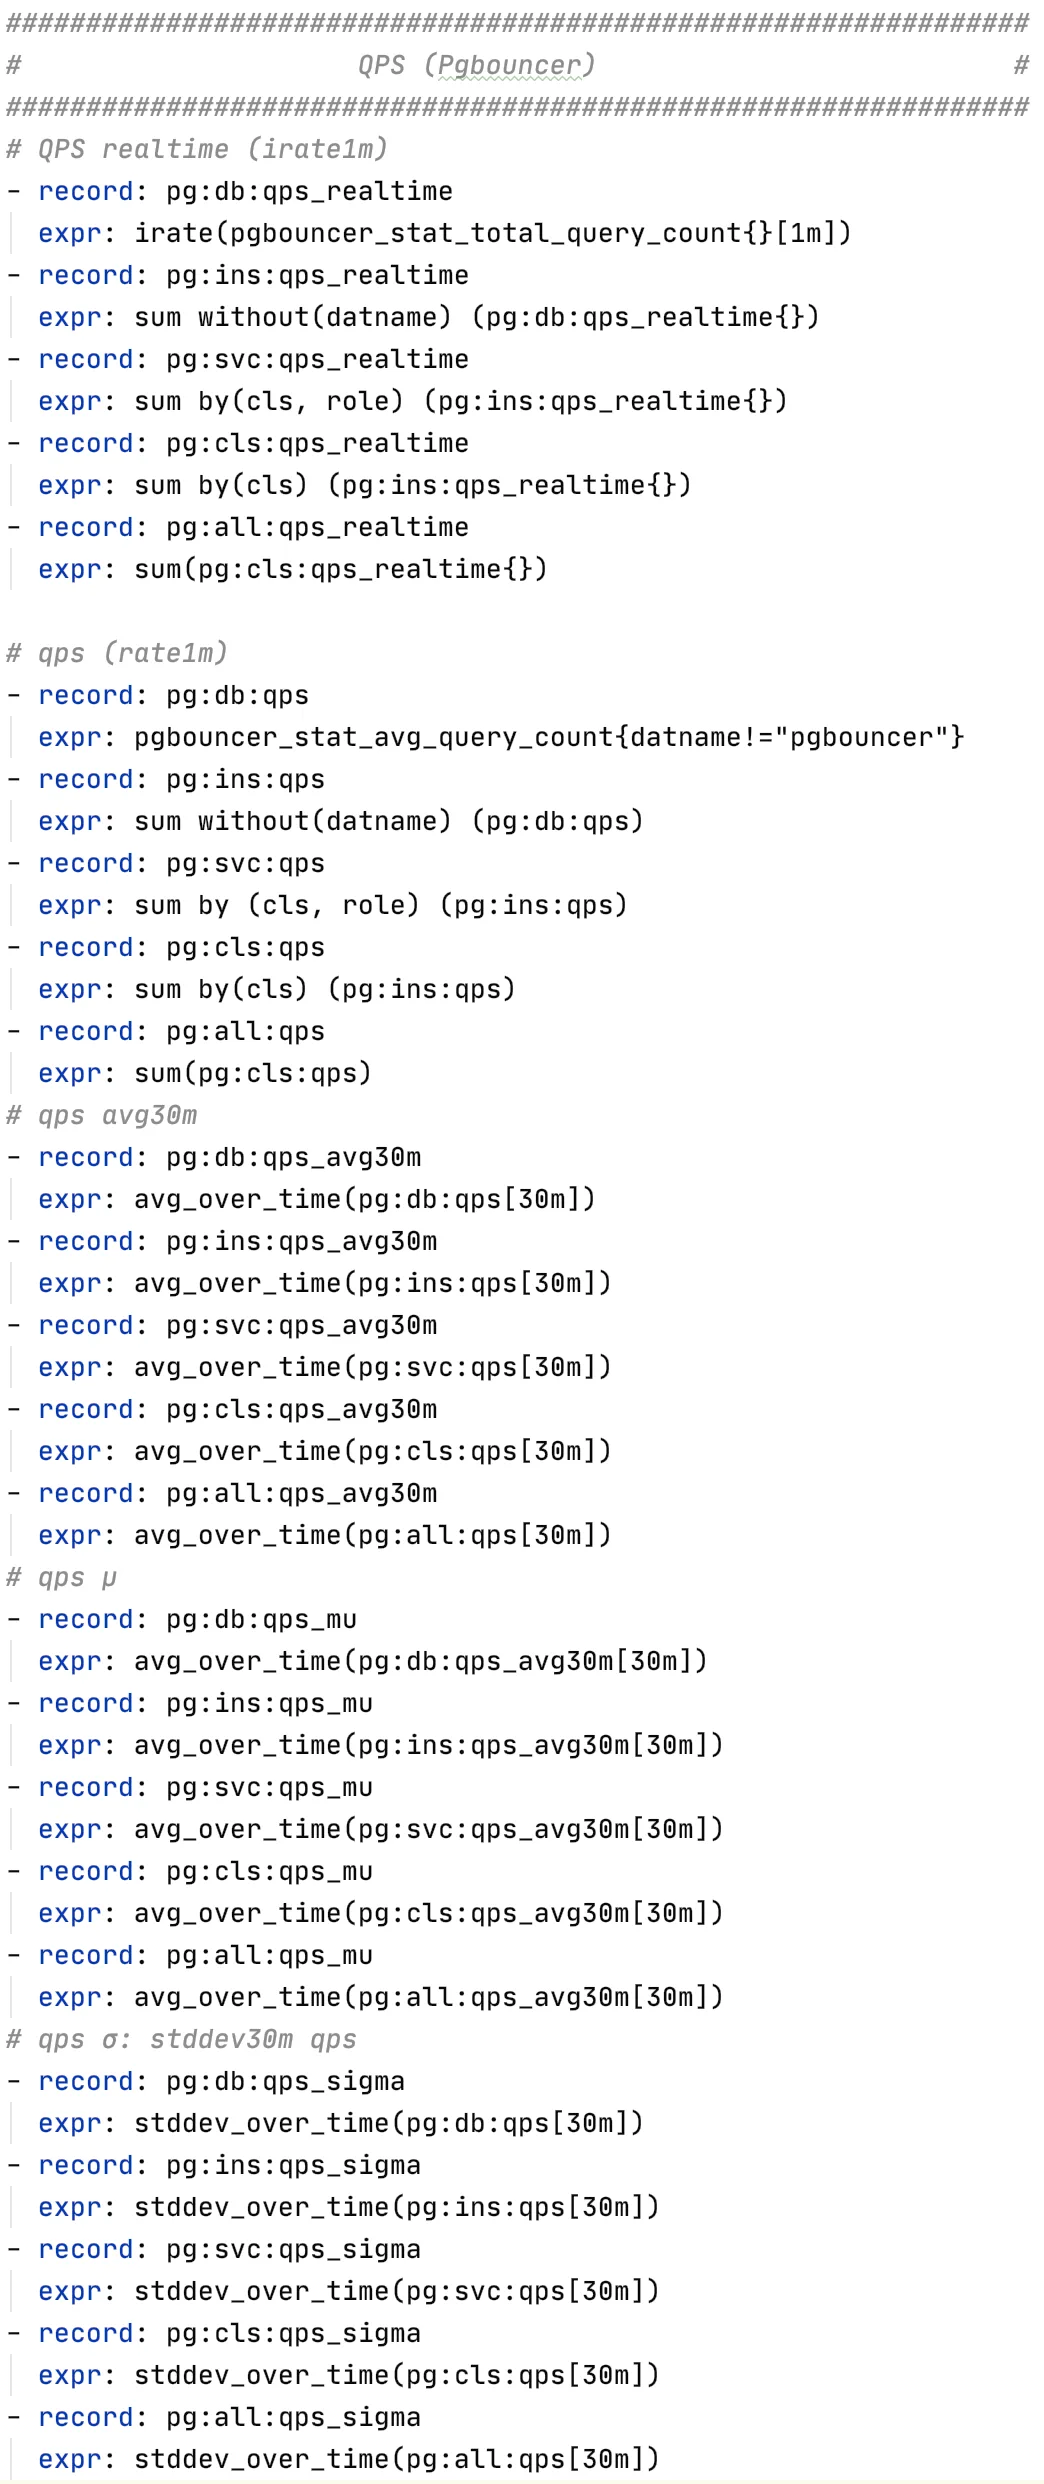
下面介绍一些常用指标。
四类黄金指标
按 Google SRE 的四类黄金指标组织如下。
错误
- 配置检查:数据校验和、NUMA、透明大页、同步提交等设置。
- 内存错误、TCP 错误与时钟偏移。
- 主机、数据库、连接池或监控组件不可用。
- 客户端排队、
idle in transaction连接、长事务、死锁、复制中断、大量回滚与监控错误。
饱和度
- PostgreSQL 负载与主机负载。
- CPU、内存、磁盘与网络利用率,缓存命中率,后端连接与连接池使用率。
流量
- QPS、TPS 与按语句类别统计的 QPS。
- 连接池流量、WAL 生成量、行读写量、块访问量与缓冲区访问量。
- 主机磁盘与网络 I/O,以及内存页面换入换出量。
延迟
- 事务平均响应时间(Xact RT)。
- 查询平均响应时间(Query RT)。
- 按语句统计的平均响应时间。
- 磁盘读写平均延迟。
- 以秒和字节衡量的复制延迟。
- 监控查询耗时。
PostgreSQL 实例监控
实例概览
- 实例身份:集群名、ID、主机、软件版本与其他集群成员。
- 关键配置:目录、端口与配置文件路径。
- 健康状态与角色,例如主库或从库。
- 核心指标:PostgreSQL 负载、复制延迟、活跃后端数、排队连接数、查询延迟、TPS 与数据库年龄。
- 实时负载,以及 1、5、15 分钟平均负载。
- 数据库告警与事件。
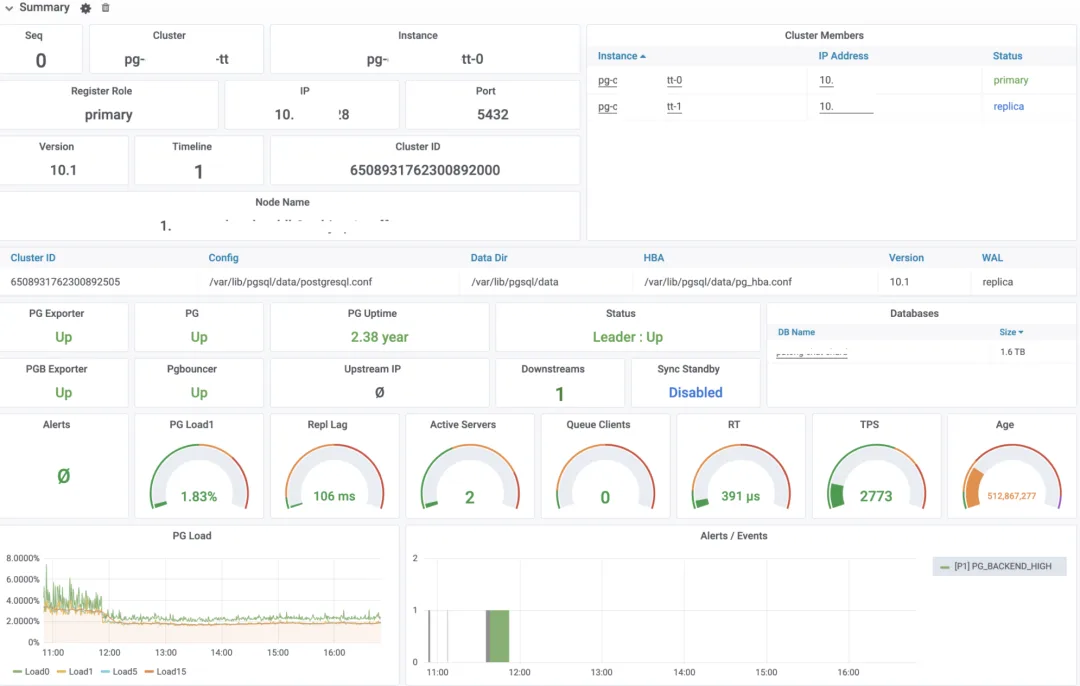
PG Load 的定义见我之前的文章《如何给 PostgreSQL 定 KPI》。
节点概览
节点概览显示 CPU、内存、磁盘与网卡的规格、关键设置和主要指标,右侧列出磁盘与网卡详情。
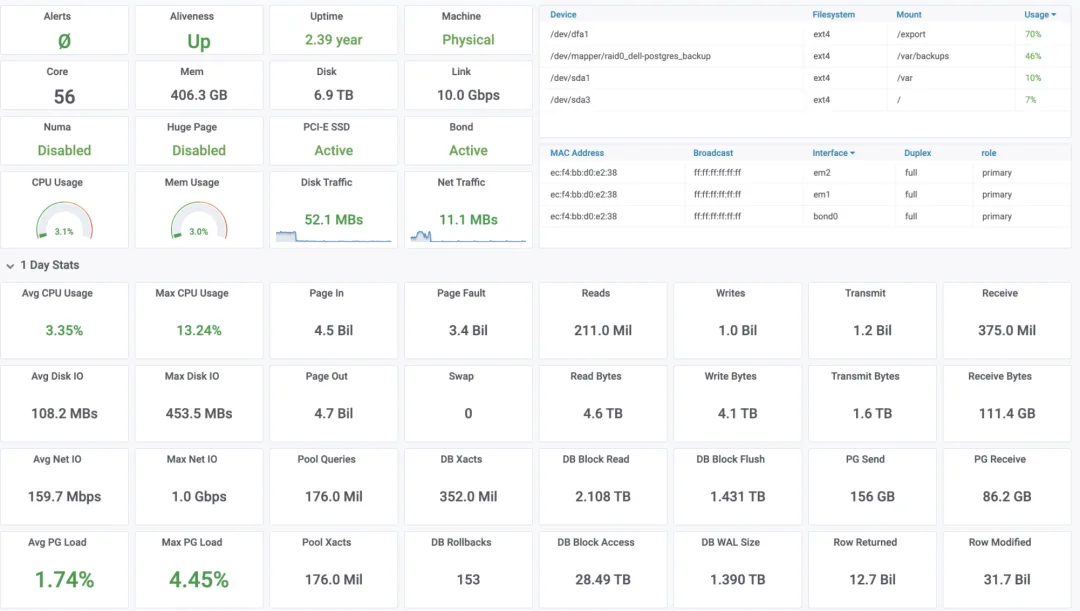
单日统计
这一部分汇总过去 24 小时的查询数、返回行数等。上面两行是节点统计,下面两行主要是 PostgreSQL 统计,可用于用量计量和容量评估。
复制
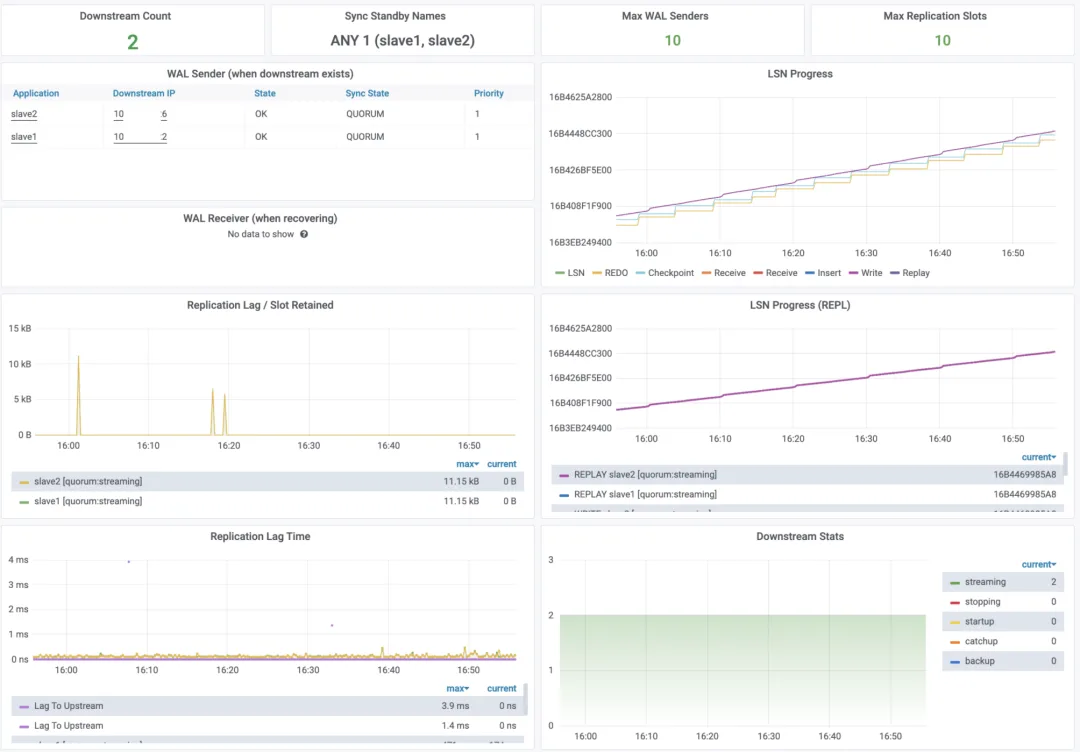
复制区域显示:
- 当前节点的复制配置。
- 以秒和字节衡量的复制延迟,以及复制槽保留的 WAL 量。
- 下游节点对应的 WAL sender 统计。
- 各阶段的 LSN,反映复制进度与持久化状态。
- 下游节点数量,用于发现复制连接中断。
事务
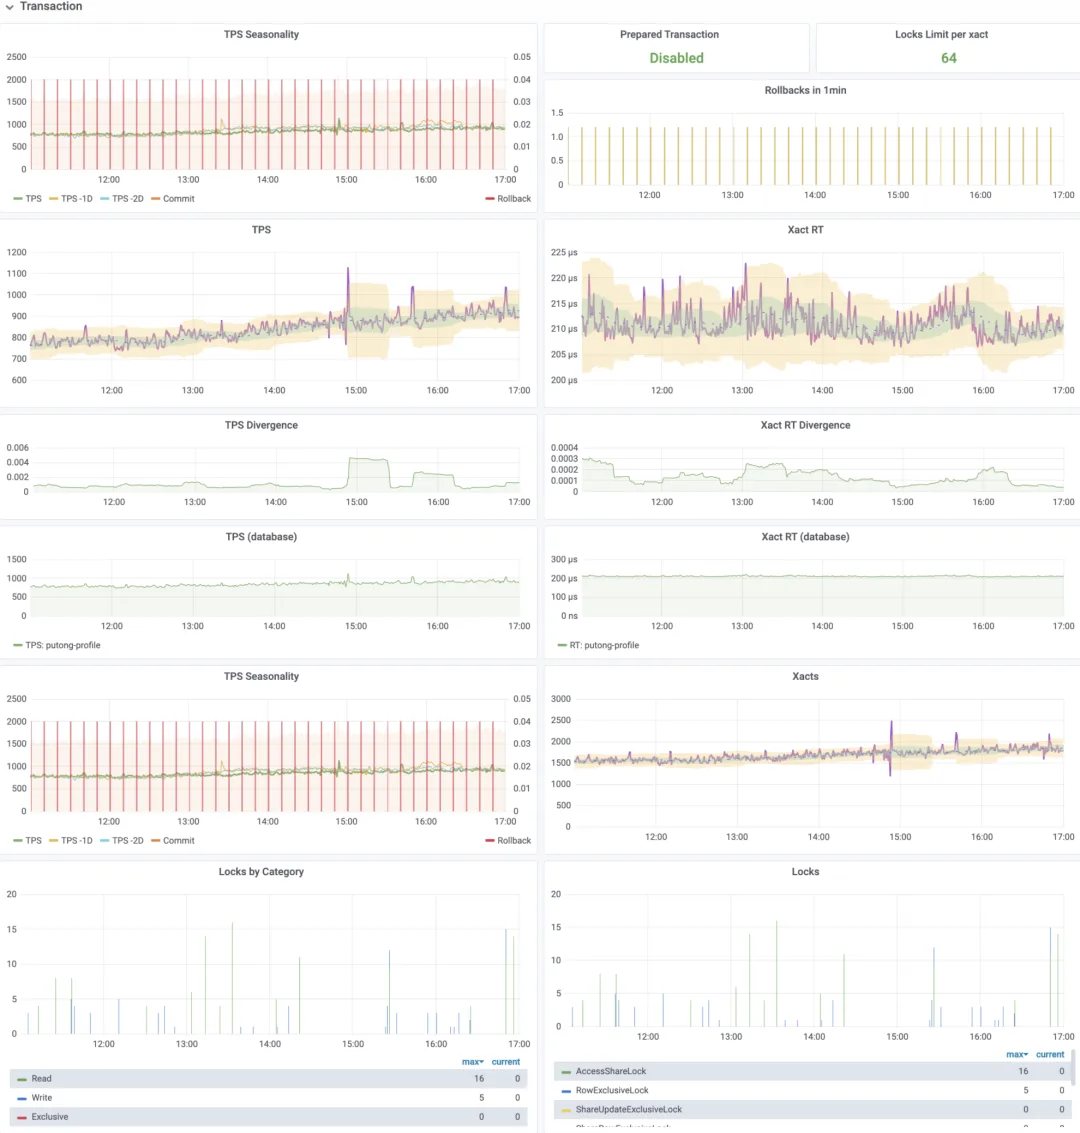
事务区域通过 TPS、响应时间与锁展示实例活动:
- TPS、与前两天的同期比较,以及事务数与回滚数。
- 回滚数量与回滚率。
- TPS 详情:绿色条带为均值上下 1 个标准差,黄色为上下 3 个标准差,使用前 30 分钟的数据计算。超出黄色条带表示相对这段时间出现了较大波动。
- 从连接池采集的事务平均响应时间,使用同样的条带。
- TPS 与响应时间的相对波动,可用无量纲指标
(σ/μ)²衡量;值越大,表示相对均值的波动越大。 - 按数据库统计的 TPS 与事务响应时间。本部署中多数实例只有一个数据库,少量实例有多个。
- 直接从 PostgreSQL 采集的事务与回滚计数,用于配合连接池提供的 TPS。
- 按八种表锁模式,以及读、写、排他等大类聚合的锁数量。
查询
查询区域的指标与事务区域类似,但统计单位是语句。它用于分析慢查询和定位性能瓶颈。
- QPS、查询平均响应时间、两者的波动程度,以及与历史同期的比较。
- 本文以查询平均响应时间 1 毫秒作为警戒线、100 毫秒作为重点排查值的示例。实际阈值按工作负载设置。
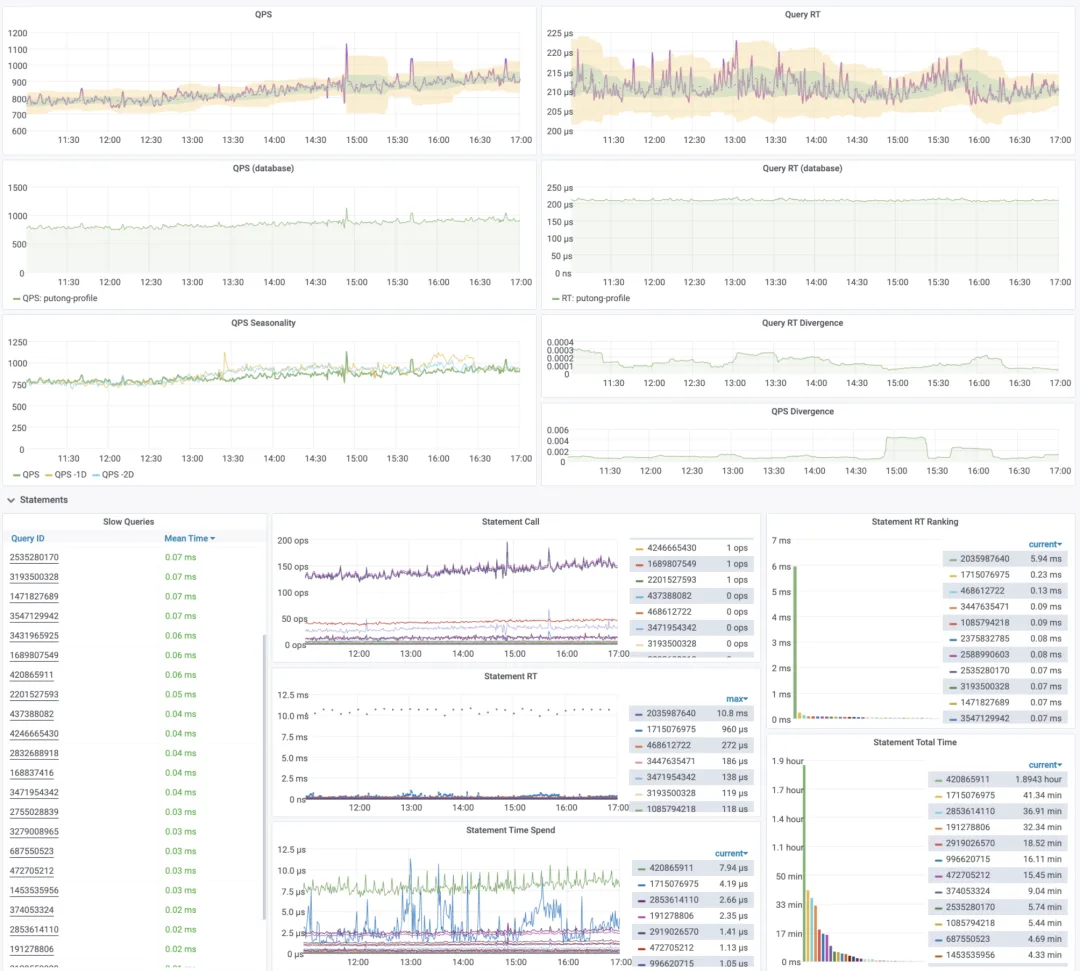
语句
语句区域按归一化查询展示指标。去除常量后具有相同解析结构的语句归入同一类查询,并以查询 ID 标识。慢查询视图提供对应的 SQL 和统计数据。
- 左侧列表按
pg_stat_statements的平均响应时间降序排列。点击查询 ID 打开详情。 - 候选列表选取累计执行时间最长的 32 条查询,排除监控查询和只有零星调用的长查询。
- 右侧显示各查询的实时 QPS、平均响应时间,以及按响应时间和累计耗时的排名。
后端进程
后端指标描述 PostgreSQL 连接。按不同维度分组,有助于排查连接突增、慢查询与等待问题。
- 按后端类型、状态、数据库与等待事件类型统计数量。
- 活跃连接、
idle in transaction连接与长事务。
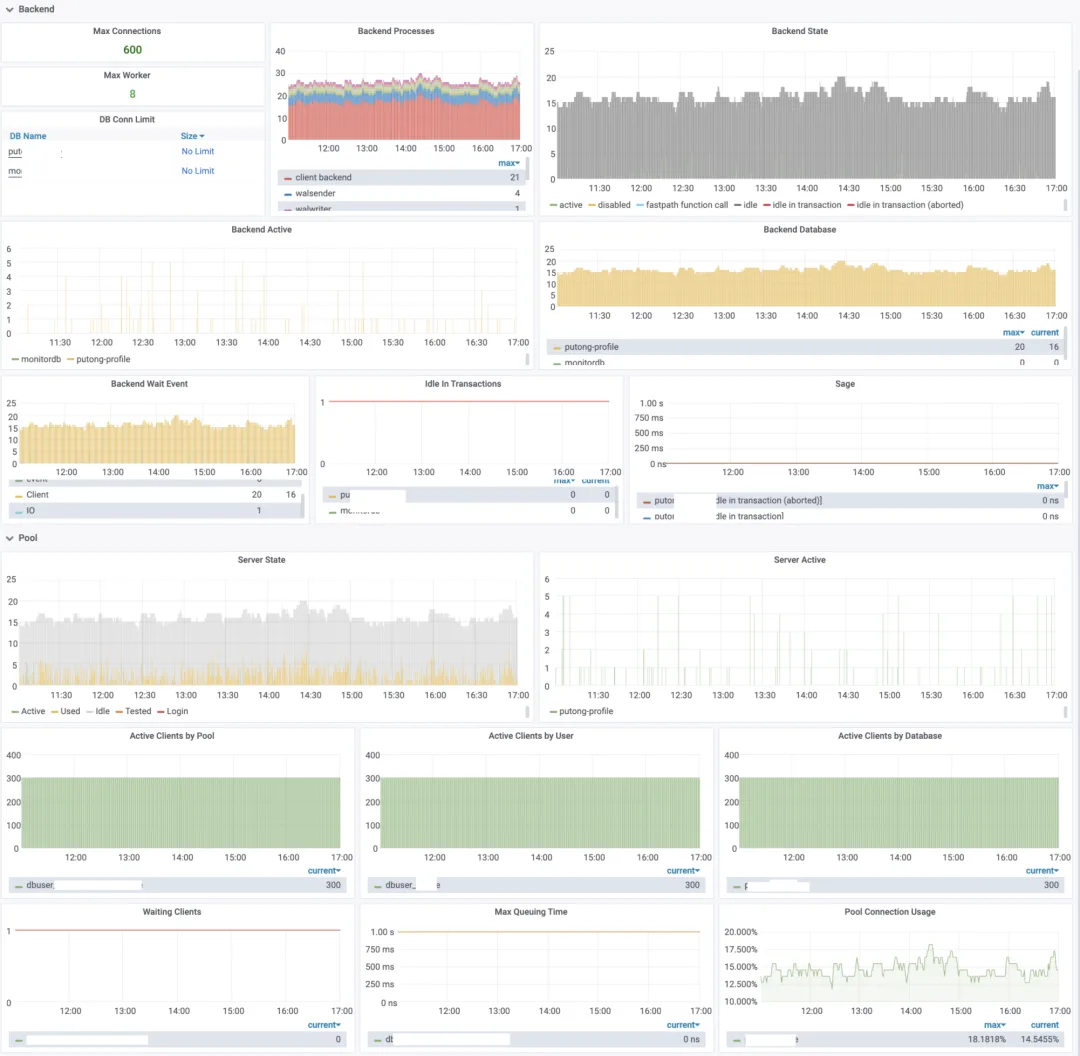
连接池
这一部分的指标来自 PgBouncer:
- 后端连接状态:活跃、刚用过、空闲、已测试、登录中。
- 按用户、数据库与连接池(
user:database)统计的前端连接数。 - 等待客户端数量与队首客户端的等待时间,用于判断连接是否积压。
- 可用池连接的使用比例。
数据库概览
这一部分主要使用 pg_stat_database 与 pg_database,并展示 WAL 指标:
- 每秒生成的 WAL 字节数,反映写入活动。
- shared buffers 命中率。未命中的请求可能由操作系统文件缓存或存储设备处理。
- 每秒读取、插入、更新与删除的行数。
- 临时文件数量与大小,用于分析大查询的影响。
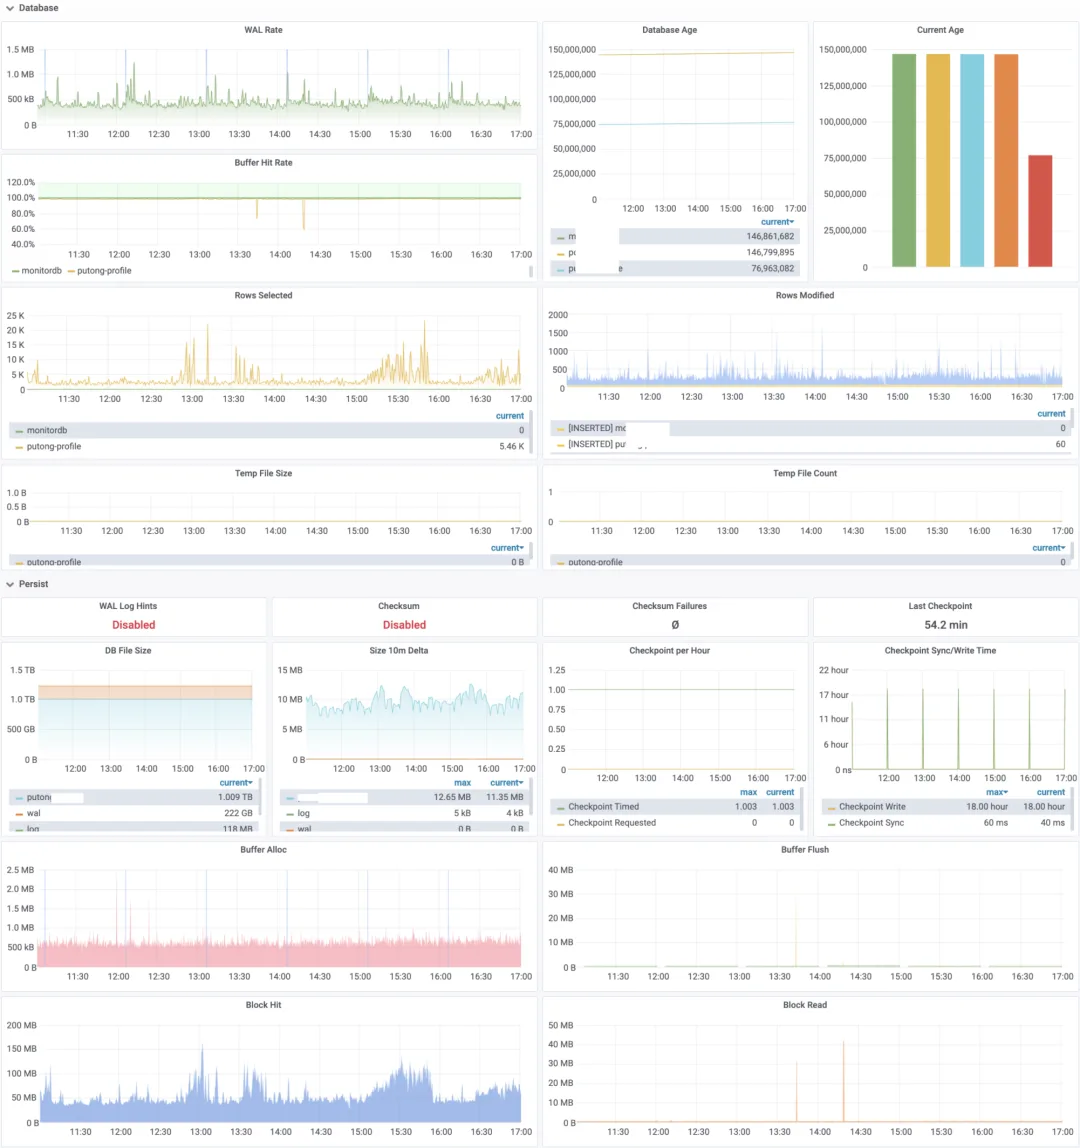
持久化
持久化指标包括写入、检查点与块访问:
- 关键持久化配置,以及启用数据校验和后的校验失败情况。
- 数据库文件、WAL 与日志的大小及增速。
- 检查点次数与耗时。
- 每秒分配、写出、访问和从存储读取的块数,以及对应字节量。本部署的 PostgreSQL 页面为 8192 字节,文件系统块为 4096 字节。
Exporter
这一部分监控 Exporter 自身:
- 存活状态、运行时长与每分钟被抓取的次数。
- 每条监控查询的耗时、输出指标数与错误数。
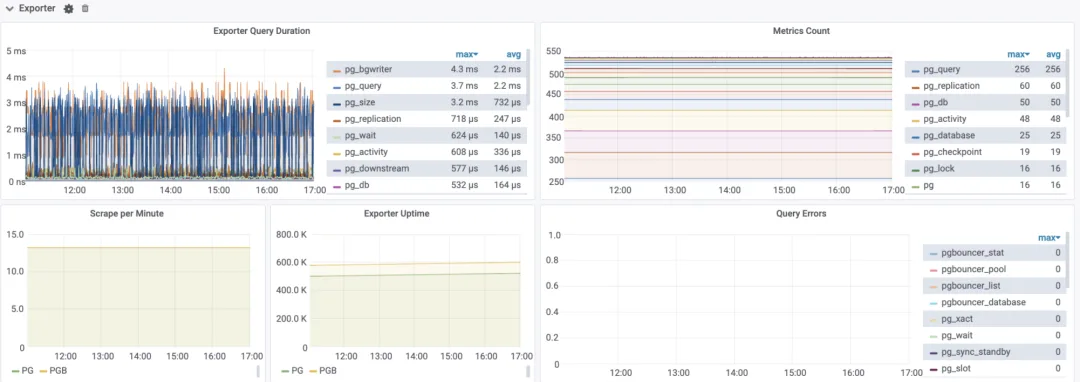
PostgreSQL 集群监控
我最常使用集群面板。这套部署以集群为单位提供数据库服务,因此把各实例和服务的指标放在一起,更方便检查服务状态。
多数图表沿用实例面板的指标,增加实例间的对比,以及集群和服务层面的汇总。
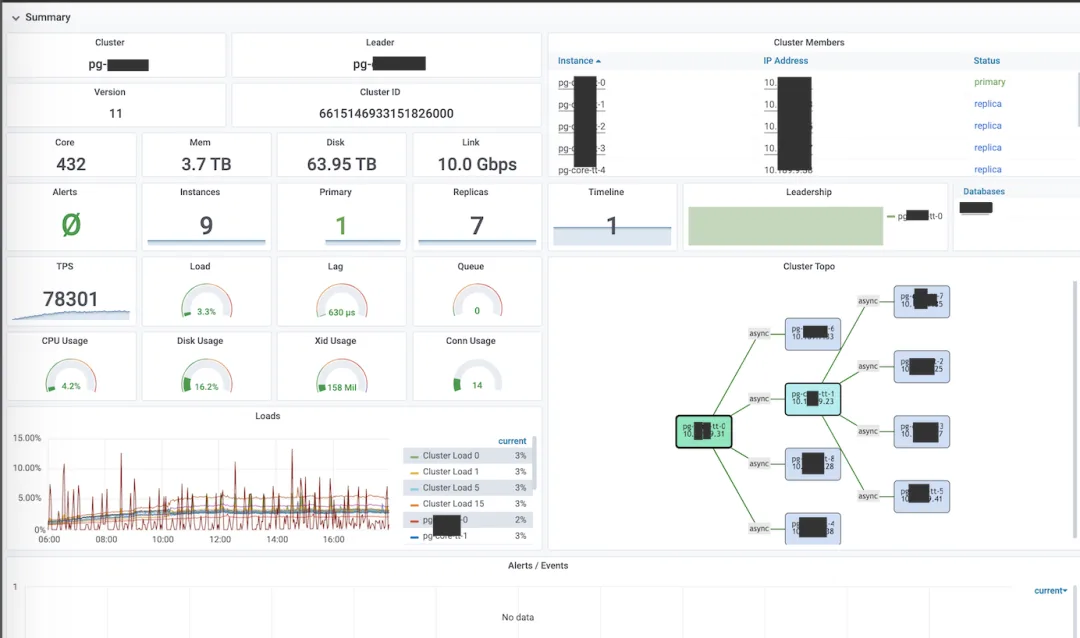
集群概览
相对实例概览,集群概览增加了:
- 时间线与主库身份。故障切换或主动切换会更换主库,并推进时间线。
- 复制拓扑,以及同步或异步复制方式。
- 集群实时负载与 1、5、15 分钟平均负载,以及各节点的 1 分钟平均负载。
- 集群告警与事件。
集群复制
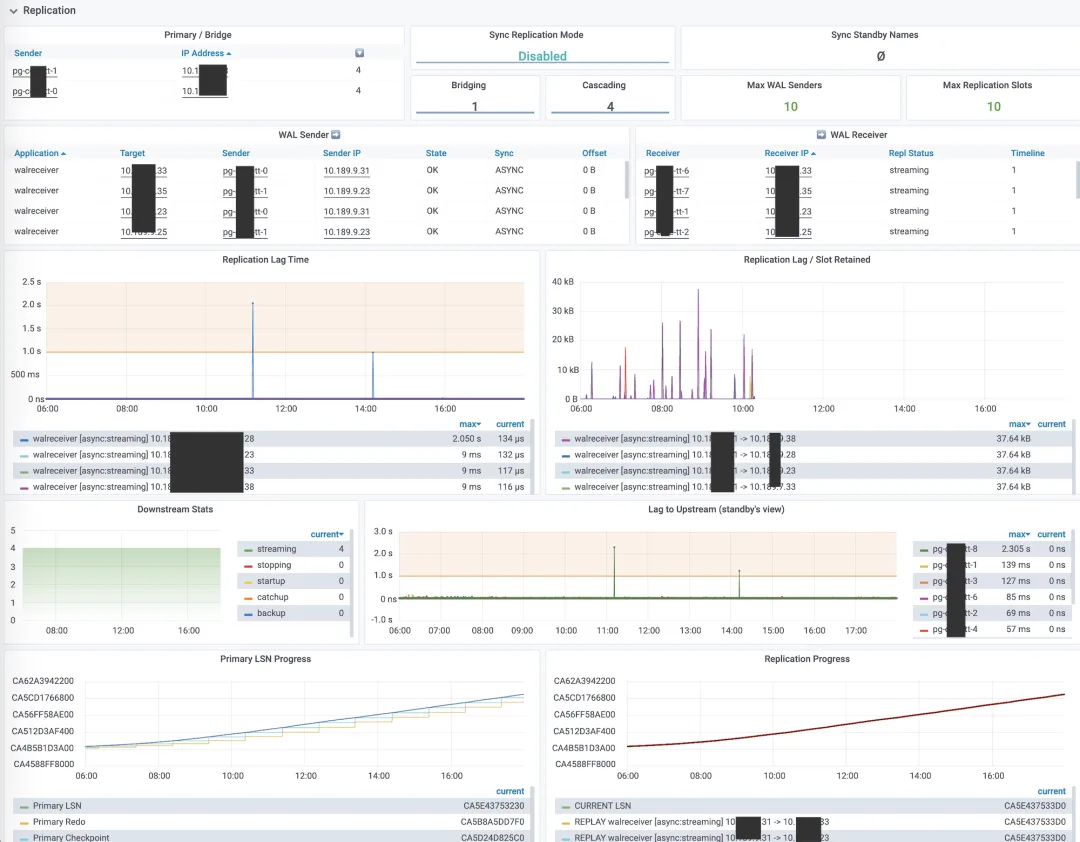
集群面板汇总了整个复制拓扑,包括:
- 主库与级联复制节点、同步提交配置、同步从库名称、下游节点数量与从库数量上限配置。
- 每条复制链路成对出现的 WAL sender 与 WAL receiver。
- 以秒和字节衡量的复制延迟,以及复制槽保留的 WAL 量。例如,WAL 写入速率为 10–100 MB/s 时,1 秒延迟约对应 10–100 MB WAL。
- 从库视角的复制延迟。
- 从库数量,用于检查备份或初始化从库时的拓扑变化。
- 全集群的 LSN,反映复制进度与持久化状态。
节点指标
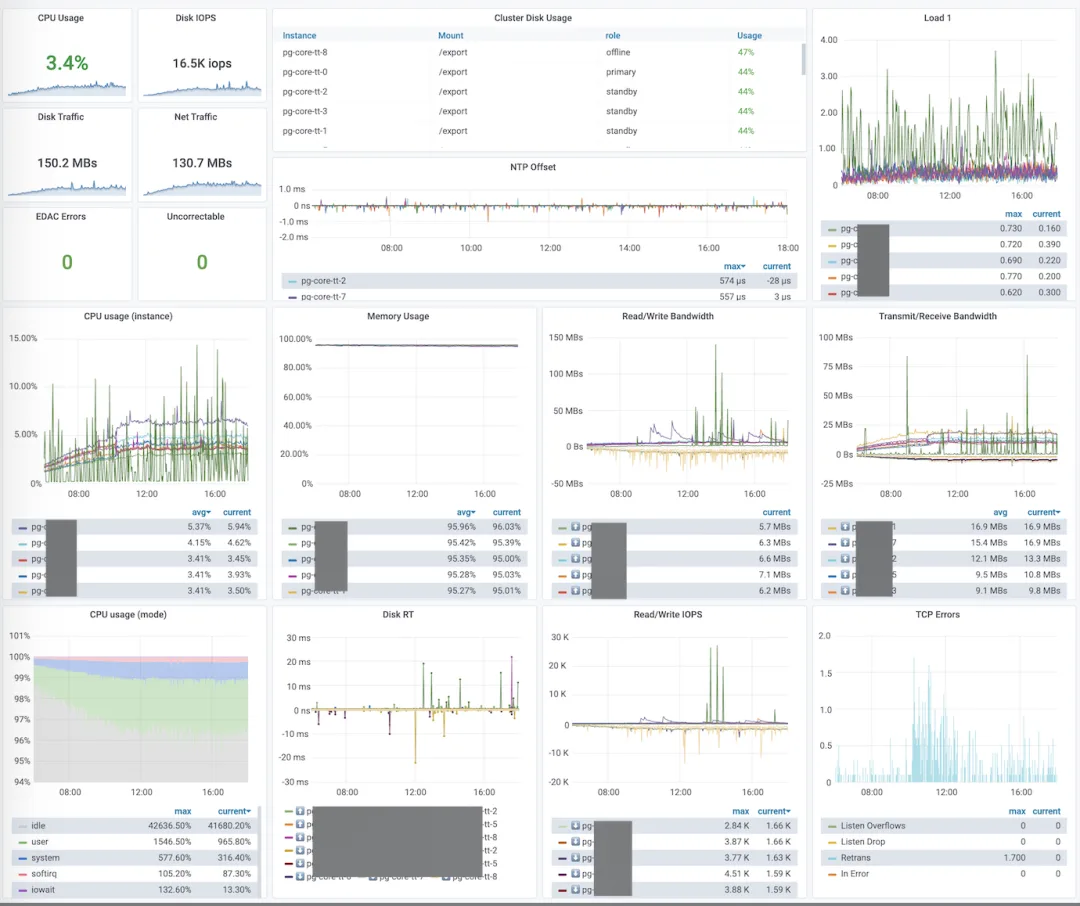
主机指标按 PostgreSQL 集群组织。
事务与查询
图表与实例视图相似,增加了服务层面的汇总。本部署通常为每个集群提供 primary 与 standby 两种服务。
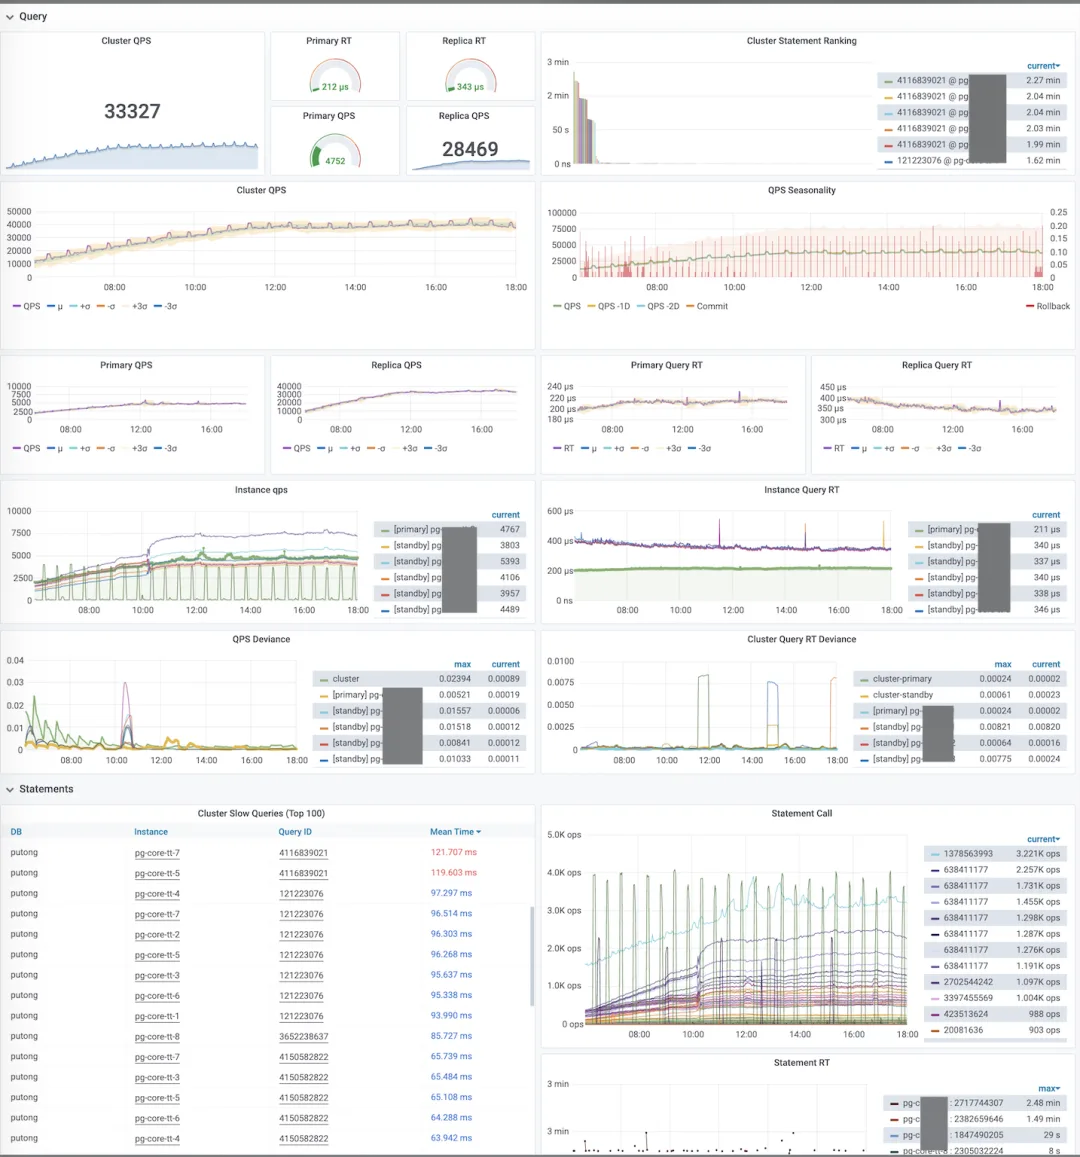
其他指标与实例面板相近。
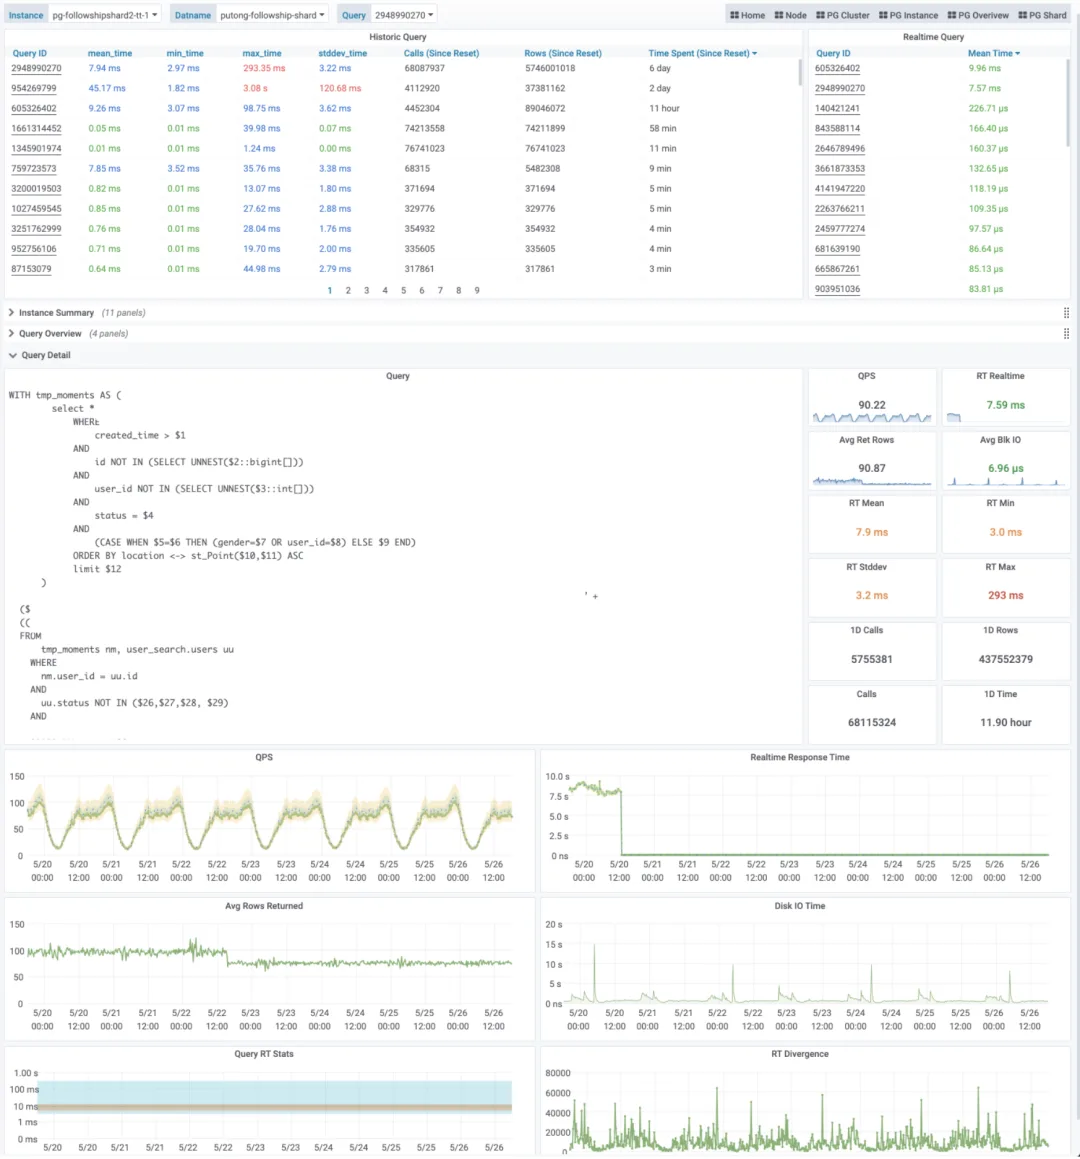
慢查询分析
慢查询视图上方显示实例的查询概览。将鼠标移到查询 ID 上可以查看 SQL,点击 ID 打开 Query Detail。
详情左侧是格式化的 SQL,右侧显示:
- 每秒查询数。
- 当前平均响应时间。
- 每次调用平均返回的行数。
- 每次调用平均块 I/O 耗时。
- 统计周期内响应时间的均值、标准差、最小值与最大值。
- 过去一天的调用次数、返回行数与执行时间,以及自统计重置以来的总调用次数。
下方图表显示所选时间范围内的指标变化。
1.9 - PostgreSQL的KPI
本文写于 2020 年,从 PgBouncer 事务耗时推导负载指标。
PG Load(PG 负载) 将每秒累积的事务耗时除以选定的并发数,同时考虑数据库处理的工作量与耗时。我用它观察负载变化,识别需要排查问题或重新评估容量的实例。
现有指标能说明什么
评估数据库负载,通常需要观察几类指标:
- 流量:每秒查询数(QPS)和每秒事务数(TPS)。
- 延迟:查询响应时间(Query RT)和事务响应时间(Xact RT)。
- 资源使用:机器负载、CPU 利用率、磁盘 I/O 和网络 I/O。
- 故障与争用:错误,以及等待数据库连接的客户端。
每类指标回答的问题不同。错误反映故障,连接池队列增长反映连接争用,但两者都不能单独衡量剩余容量。队列较短时仍可能存在资源瓶颈;队列较长也可能是连接池上限过小。
CPU 和 I/O 指标反映主机压力。当这些资源成为瓶颈时,它们有助于解释数据库性能。但锁或被占用的连接也可能限制数据库工作,此时 CPU 利用率未必很高。因此,还需要数据库自身的指标,与主机指标对照。
QPS 和 TPS 衡量完成的工作量,不衡量每次调用的成本。耗时 10 微秒和 10 秒的查询都只算一次调用。应结合查询类型、延迟和资源使用情况比较吞吐量,并通过压测为已知工作负载建立基线。
RT 衡量服务质量。例如,某类 OLTP 服务可能要求 1 ms 的响应时间。延迟上升可能表示资源争用,但不能单独用于测量饱和度。平均值也可能掩盖慢请求;有耗时分布数据时,P99、P99.9 有助于观察尾部延迟。
PG Load 将事务数量与耗时结合起来,衡量并发工作量。它的推导可以从两个熟悉的主机指标开始:平均负载和 CPU 利用率。
推导 PG Load
Linux 平均负载
top 的第一行显示最近 1、5、15 分钟的平均负载:
Linux 平均负载统计可运行任务和不可中断睡眠任务,后者常在等待 I/O。对单核 CPU 密集型负载,接近 1 表示 CPU 需求接近满载,大于 1 意味着排队。在 n 核上,对应的参考值是 n。除以核数,就能得到用于比较的归一化值。
对于 CPU 密集型负载,可将每核 0.7 和 1.0 作为预警与调查阈值的参考,再根据工作负载调整。不可中断等待也会抬高负载,因此需要结合 CPU 和 I/O 指标判断;它不是 CPU 利用率百分比。
CPU 利用率
单个 CPU 核的利用率可以通过累积空闲时间计算:
node_cpu_seconds_total{mode="idle"} 统计累积空闲秒数。irate 用最近两个采样点计算每秒空闲时长,用 1 减去这个比例,就得到 CPU 核处于忙碌状态的时间占比。对于多核 CPU,对各核利用率求平均即可。
可以用类似的方式衡量 PostgreSQL 后端:计算它处于活跃状态的时间占比。平均负载则给出了扩展到多个后端的思路:累加它们的活跃时长,再按并发数归一化。
从后端时间到数据库负载
先以 1 秒为统计窗口,按可用后端数归一化:
| 场景 | 计算 | 结果 |
|---|---|---|
| 一个后端执行查询 0.6 秒 | 0.6 / 1 / 1 |
60% |
| 两个可用后端分别执行 0.6 秒、0.8 秒 | (0.6 + 0.8) / 1 / 2 |
70% |
| 一个后端执行查询 0.6 秒,事务内空闲 0.2 秒,按事务时间统计 | (0.6 + 0.2) / 1 / 1 |
80% |
第三个例子涉及一个选择:只统计查询执行,还是统计整个事务,包括语句之间的空闲时间?本文采用事务耗时,下文会解释原因。客户端等待后端的时间另行统计,不计入这里的事务耗时。
统计窗口更长或后端更多时,计算方式不变:
pg_load = pg_active_seconds / time_period / parallel
pg_active_seconds是统计窗口内,所观测后端的活跃秒数之和。time_period是统计窗口的秒数。parallel是用于归一化的并发数。
0 表示没有观测到活动;100% 表示每单位选定并发能力,在每秒内累计了一秒活跃时间。这个值本身并不表示容量上限。
如果活跃秒数以累积计数器提供,就使用它的增长速率:
rate(pg_active_seconds[time_period]) / parallel
接下来需要确定如何统计活跃时间,以及用什么并发数归一化。
计算 PG Load
统计查询时间还是事务时间?
对于自动提交事务中的单条查询,查询耗时和事务耗时接近。对于包含多条语句的事务,两者可能相差很大。上面的例子有 0.6 秒查询执行和 0.2 秒 idle in transaction:按查询时间统计得到 60%,按事务时间统计得到 80%。
查询时间衡量执行过程,事务时间衡量后端被事务占用多久。空闲事务可能很少消耗 CPU,但仍占用连接,也可能保留锁或快照。这里采用事务时间,将这种占用也计入负载。
获取累积事务耗时
pg_stat_activity 显示 PostgreSQL 后端的当前状态。反复采样可以估算一段时间内有多少后端活跃,但这个视图本身是状态快照,不是累积耗时计数器。
PgBouncer 提供了计算所需的计数器。它的 SHOW STATS 命令按数据库返回统计信息,包括:
total_xact_count:完成的事务数。total_query_count:执行的查询数。total_xact_time:累积事务耗时。total_query_time:累积查询耗时。
原始时间计数器使用微秒。下文使用的导出序列 pgbouncer_stat_total_xact_time 已经转换为秒。参见 PgBouncer 统计说明。
对该计数器应用 rate,得到最近 1、5、15 分钟内的每秒事务耗时。irate 则使用最近两个采样点,反映最近一个采样间隔的情况。再用 sum without (datname) 对各数据库求和,得到实例级指标:
结果估算了并发事务工作量。一个后端持续被事务占用,每秒就贡献一秒事务时间;64 个这样的后端,每秒贡献 64 秒。这个值可以用于比较同一实例的不同时段,比较不同规格的实例则还需要归一化。
按 CPU 核数归一化
这种方法使用 CPU 核数作为并发参考,适合 CPU 密集型负载,但不是 PostgreSQL 并发能力的实测上限。连接限制、并行工作进程、锁等待和 I/O 也会影响实例能承受的工作量。
在 64 核主机上,64 个后端持续被事务占用,负载为 64 / 64 = 100%;128 个这样的后端,负载为 128 / 64 = 200%。
将每秒事务耗时除以 CPU 核数,就得到 PG Load 序列:
与吞吐量、延迟的关系
每秒活跃时长也可以近似表示为 TPS × 平均事务 RT,或 QPS × 平均查询 RT。两者应使用相同的统计窗口,RT 的单位为秒。例如,每秒 1,000 次查询,每次耗时 1 ms,累积查询时间就是每秒 1000 × 0.001 = 1 秒。
采用事务时间并按 CPU 核数归一化后,得到:
tps * xact_rt / cpu_count
TPS 不包含每个事务的成本,RT 不包含事务数量,两者相乘则同时考虑了这两点。上面的记录规则直接从耗时计数器获取这种累积工作量。
使用 PG Load
告警:慢查询占满连接池
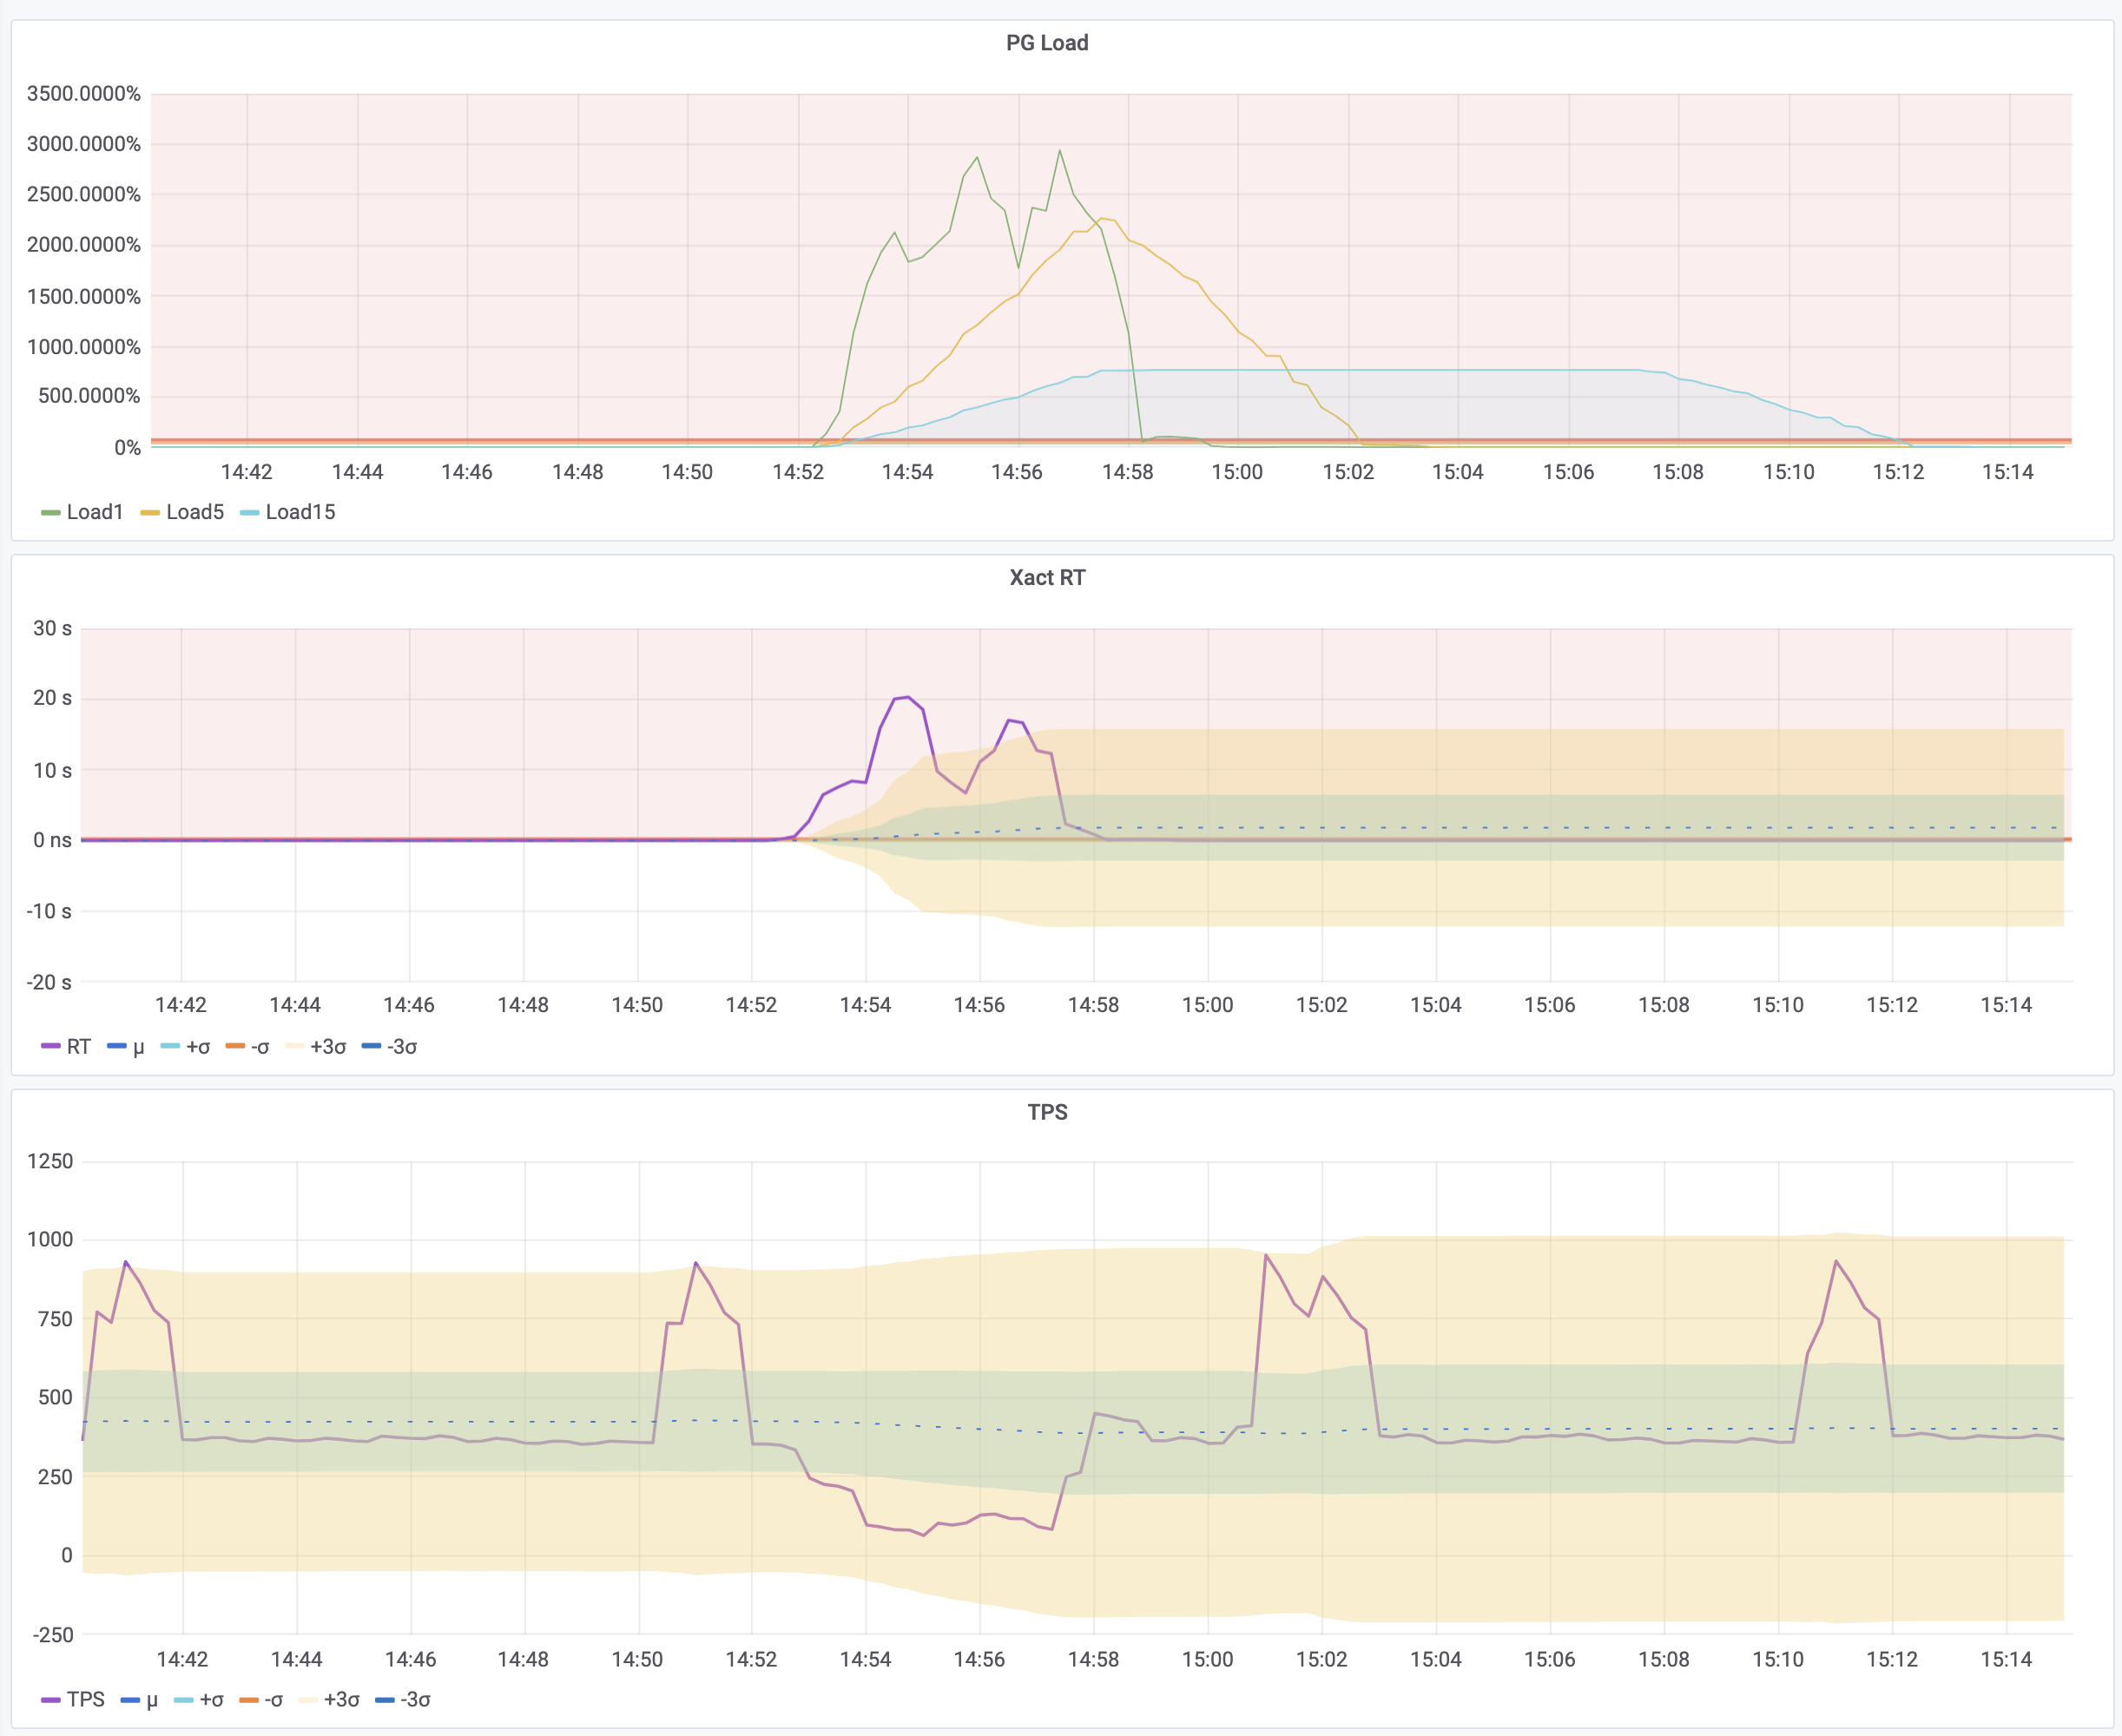
下图是一次生产事故。某次应用变更引入了慢查询,慢查询占用了连接池,请求随之堆积。PG Load 和 RT 都明显上升,TPS 的下降则不太显眼。这次事故后,我们将 PG Load1 和 PG Load0 纳入了告警规则。
本文以 50% 预警线和 70% 告警线为例,具体阈值应根据工作负载基线和响应时间目标设定。达到 500% 意味着累积事务耗时是按 CPU 核数归一化后参考值的五倍;延迟、队列长度和等待指标有助于定位原因。
容量评估
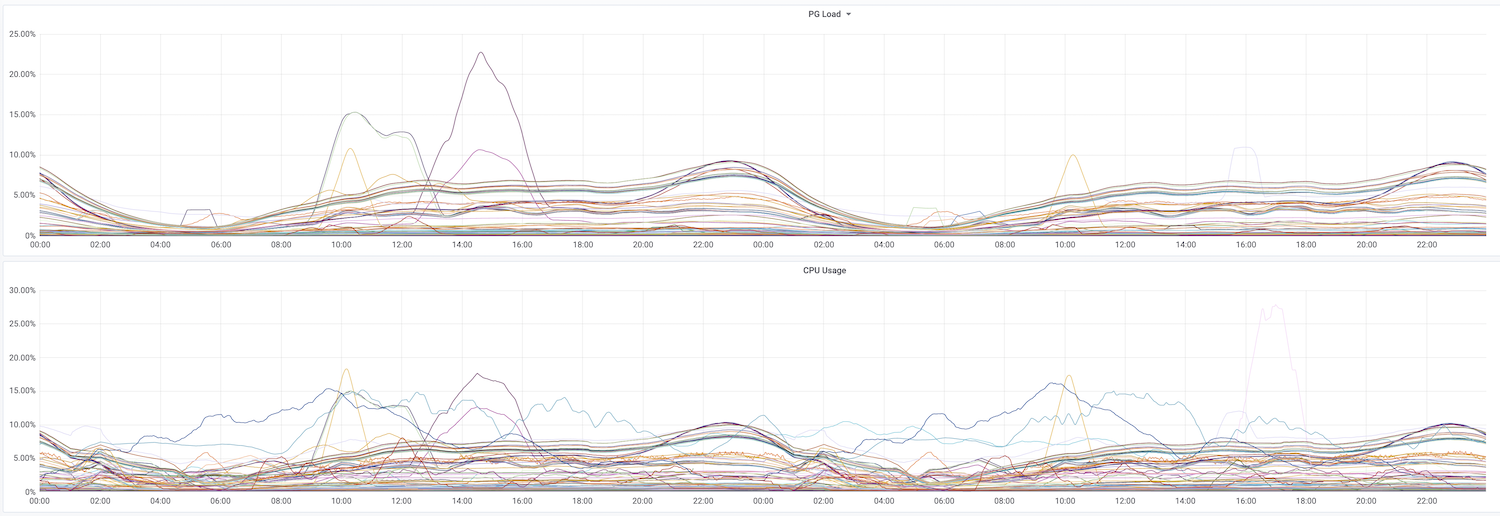
规划容量时,将集群 15 分钟 PG Load 的均值与峰值,同历史基线、响应时间目标和预期增长比较。由此识别需要进一步评估容量、查询成本或资源限制的集群。
同时对照 CPU 利用率。事务计数器不直接包含主机其他任务消耗的 CPU 时间,但备份和维护仍可能通过资源争用增加事务耗时,其影响也就会反映在 PG Load 上。
可将长期处于 30%~50% 作为评估容量的参考起点。是否扩容,还取决于峰值需求和该工作负载所需的余量。
1.10 - PostgreSQL 监控系统概览
本文记录 2018 年 12 月的监控系统,面板与统计收集器机制对应当时版本。
用监控管理 PostgreSQL
管理 PostgreSQL 需要了解数据库的运行状态。监控系统集中展示这些信息,为日常检查、故障诊断与性能优化提供依据。我计划通过一系列文章,介绍这套监控系统的设计、实施与使用。
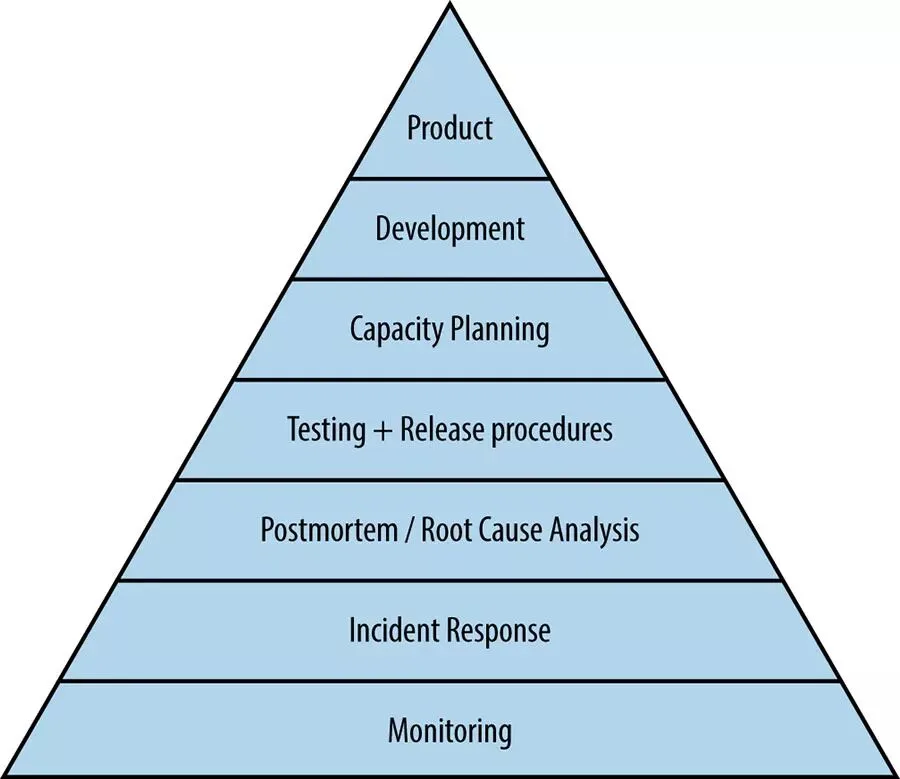
PostgreSQL 监控面板
下面是我在实际环境中使用的监控面板。最常用的单实例面板分为七个区域:概览、操作系统、数据库活动与会话、复制、检查点与 WAL、数据库冲突、数据库对象统计。
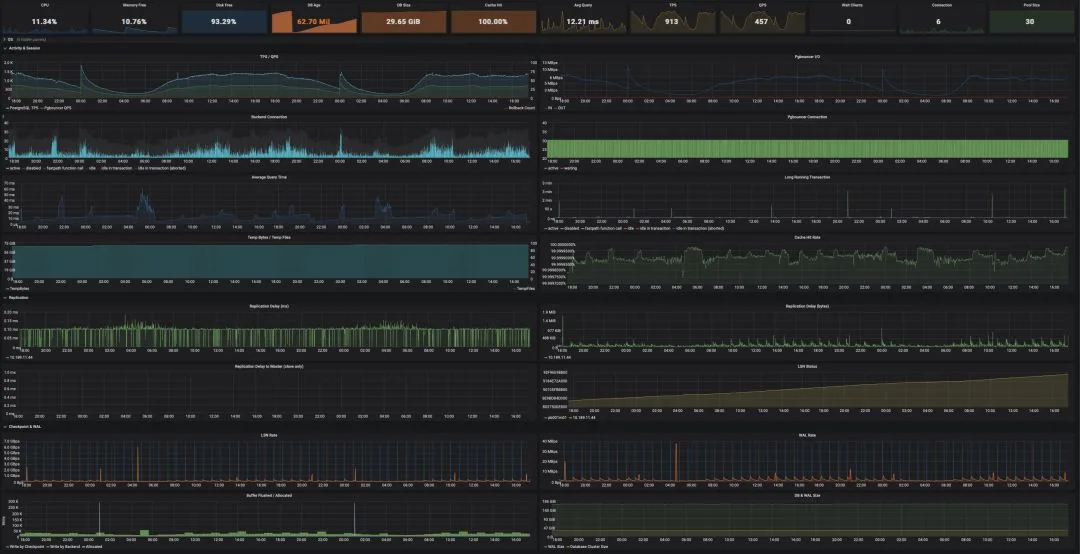
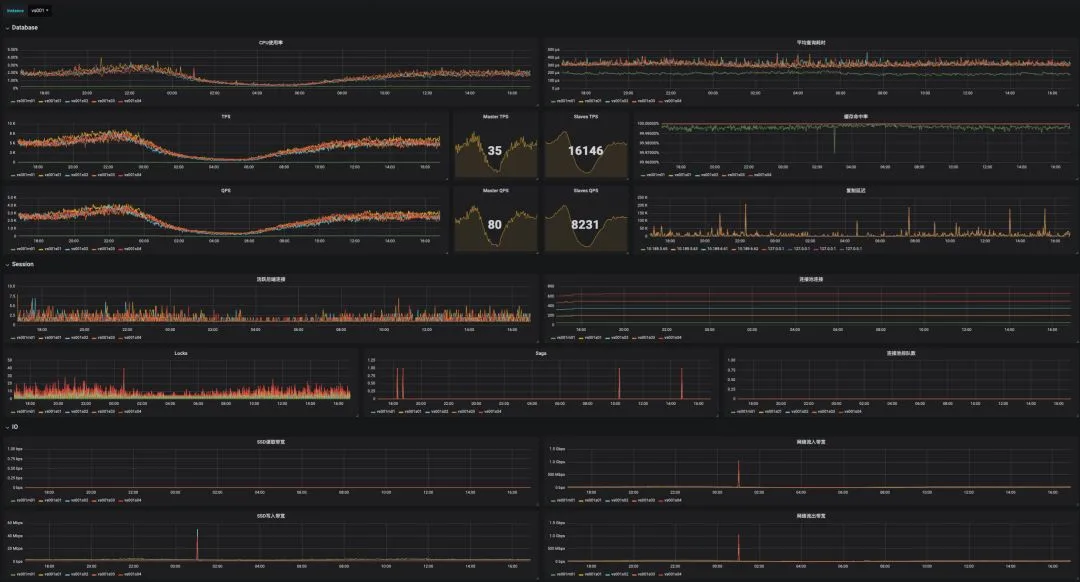
系统架构
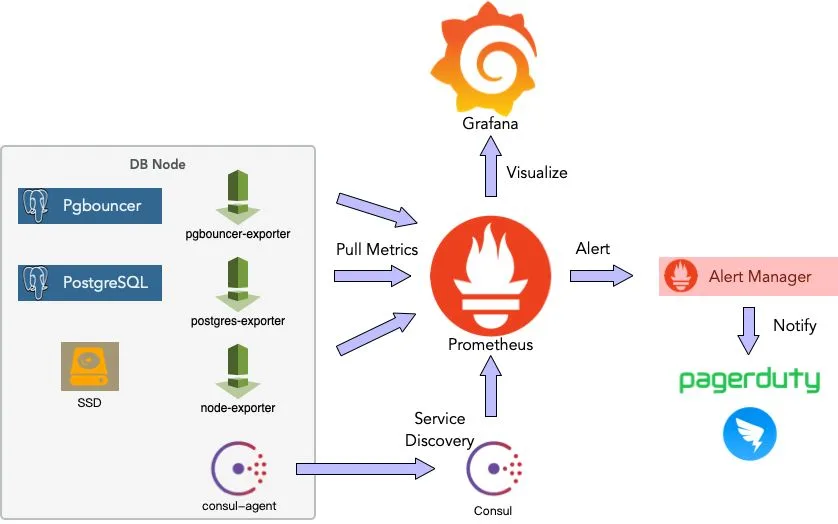
这套系统使用 Prometheus、Grafana、Consul 与各类 Exporter。
Exporter 从数据库、连接池与主机获取指标。Prometheus 通过 Consul 发现 Exporter,再抓取并保存指标。Grafana 展示数据,Alertmanager 处理告警通知。
监控指标
选择指标时,需要明确它回答什么问题、数据来自哪里、数值变化意味着什么。这些信息决定了如何解读图表,也可以指导命令行排查。下面按单实例面板的区域介绍主要指标。
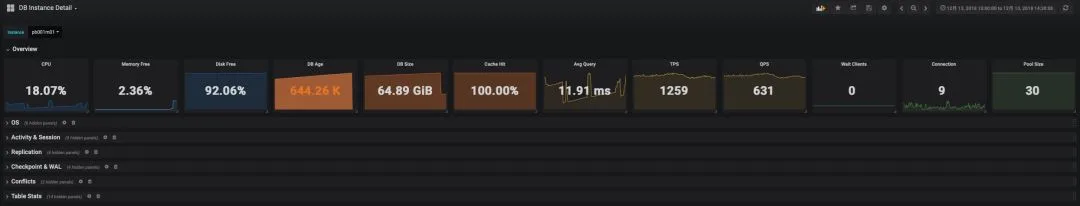
概览
概览用于缩小排查范围,包含以下指标:
- CPU 使用率、平均查询时间、TPS、QPS、连接池排队数与活跃连接数:了解负载水平。
- 内存空闲率:识别可能导致进程被终止的内存压力。
- 磁盘空闲率:检查存储空间是否接近用尽。
- 数据库年龄:评估距离事务 ID 回卷限制还有多远。
- 数据库大小与缓存命中率:观察数据规模和访问模式的变化。
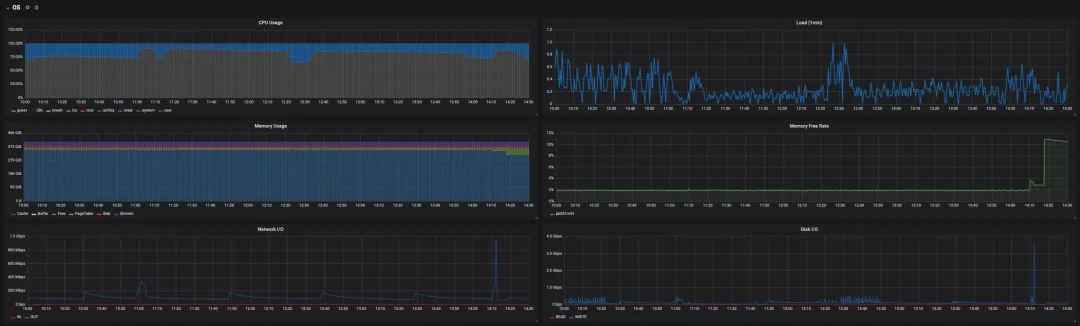
操作系统
操作系统指标包括:
- CPU 使用率与系统负载。
- 内存使用量,特别是操作系统缓存的变化。
- 网络与磁盘吞吐量,以及磁盘 IOPS。
将这些指标与数据库活动放在一起,可以判断资源压力来自哪里,并为硬件故障排查提供线索。
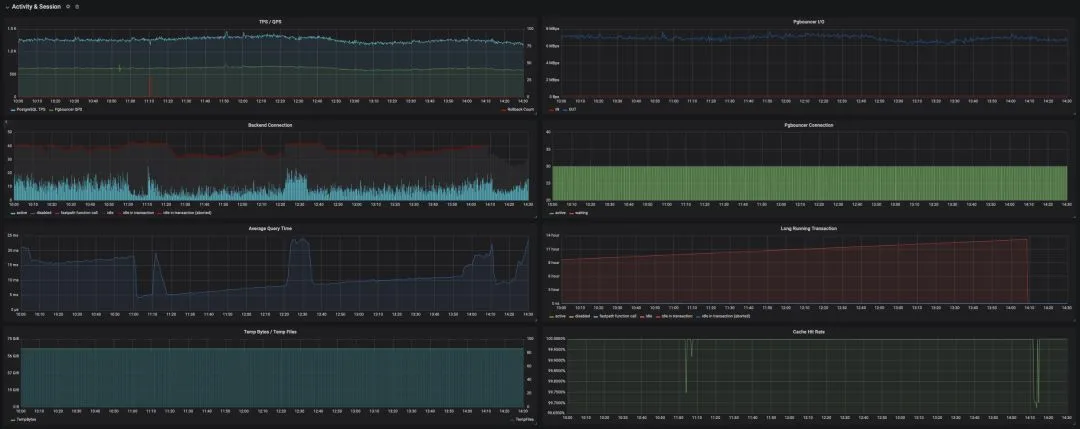
数据库活动与会话
这些指标描述数据库当前的工作负载:
- TPS、QPS 与平均响应时间:请求量和延迟。
- 缓存命中率:这里只统计 PostgreSQL 的 shared buffers,不包含操作系统文件缓存。
- 各状态的连接数:
active连接反映执行中的工作;idle in transaction连接则需要检查事务为何未结束。 - 临时文件数量与大小:复杂查询或大查询可能产生临时文件,大量临时文件 I/O 会影响性能。
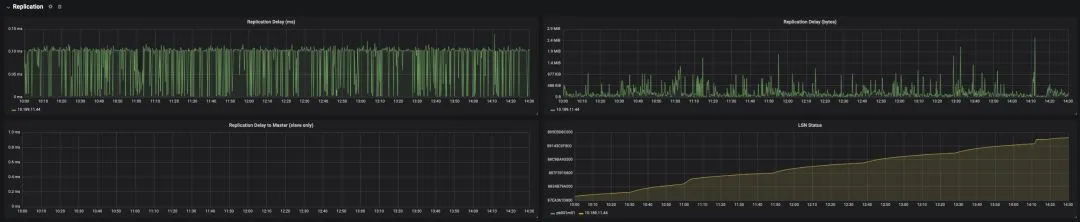
复制
复制延迟有助于判断从库的数据新鲜度,也为复制故障排查提供线索。
主库可以报告从库落后的 WAL 字节数;从 PostgreSQL 10 起,还提供复制延迟时间。从库上可以用最后重放事务的时间估算滞后,但主库空闲时该值也会增长,不能直接等同于实际复制延迟。
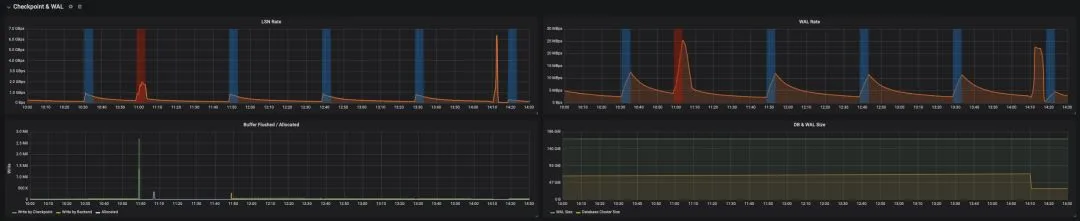
检查点与 WAL
检查点写出脏页,会消耗磁盘 I/O。启用 full_page_writes 后,检查点之后对页面的首次修改还会把完整页面映像写入 WAL,增加磁盘与网络流量。排查写入压力时,可以观察:
- WAL 生成速率。
- LSN 增长速度。
- 检查点与后端进程写出的缓冲区数量。如果后端进程承担大量写出工作,需要检查检查点和后台写入相关配置。
- 数据库与 WAL 的大小。
锁与数据库冲突
按类型统计锁,可以了解数据库正在进行的操作,并为锁冲突排查提供线索。
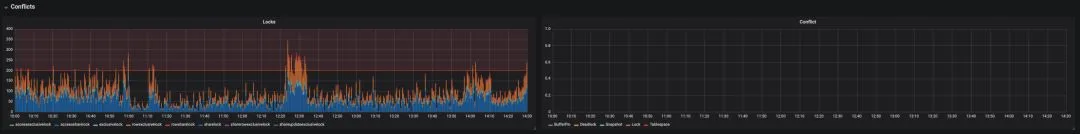
对象级统计
对象级统计用于进一步定位问题:
- 每张表的索引扫描与顺序扫描次数。大表上频繁出现顺序扫描时,结合查询计划检查索引是否适用。
- 元组读写数量、表大小与表年龄。
- 死元组比例:反映清理需求,可辅助排查膨胀,但不等于物理膨胀率。也可以使用统计数据估算表膨胀率。
- 函数调用次数与执行时间。
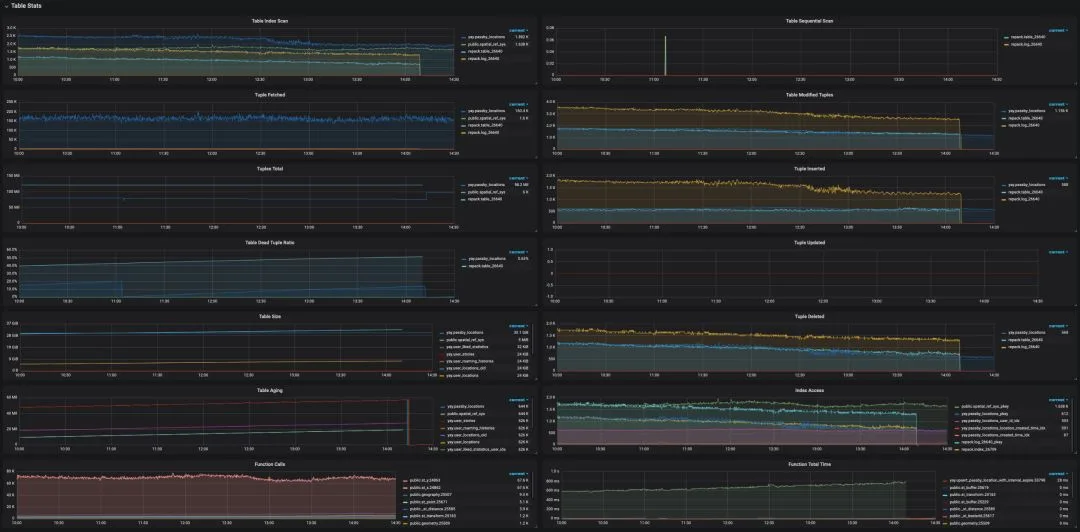
指标来源
统计收集器
本文涉及的 PostgreSQL 版本通过内置统计收集器提供许多监控指标。系统视图以 SQL 接口暴露这些数据,具体定义见 PostgreSQL 文档。下面列出了一些常用视图。
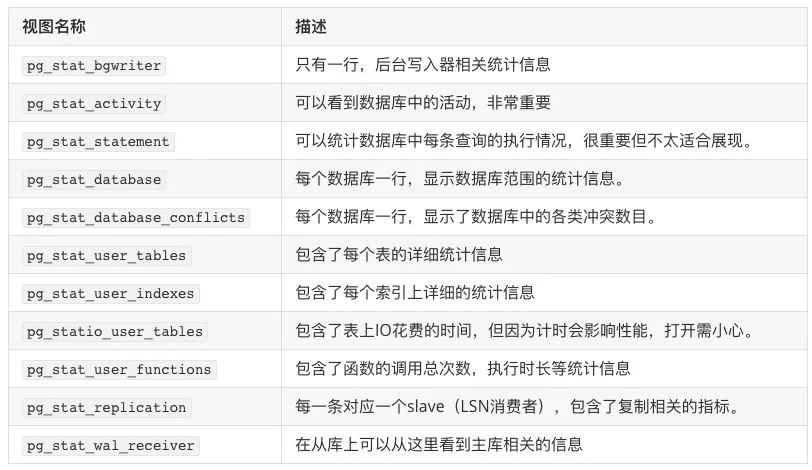
PostgreSQL 11 统计文档说明了统计数据的更新与快照机制:
- 后端进程在进入空闲前报告累计计数,仍在执行的工作尚未完整反映在累计统计中。
- 收集器生成新报告的间隔至少为
PGSTAT_STAT_INTERVAL,默认 500 毫秒。由track_activities控制的当前活动使用另一套机制。 - 同一事务中的统计查询会复用快照。调用
pg_stat_clear_snapshot()清除快照后,下次查询可以取得新快照。 - 在
postgresql.conf中启用所需的track_*选项。
这些规则属于旧版统计收集进程。PostgreSQL 15 改用共享内存保存累计统计;解释更新与快照行为时,使用对应服务器版本的文档。
系统目录与其他视图
其他系统目录和视图也提供监控数据。例如,pg_database 包含计算数据库年龄所需的元数据,pg_locks 提供锁和锁等待信息。数据库大小等指标则由内置函数提供。
后续内容
本文介绍了监控系统的架构和主要指标。后续文章将继续说明具体实现,以及如何用这些指标排查问题。
1.11 - 关系膨胀的监控与治理
本文写于 2018 年,介绍当时基于统计信息估算膨胀及安排维护的方法。
PostgreSQL 使用 MVCC,让事务读取不同的行版本。旧版本可能使表和索引占用的空间超过活数据所需。日常清理让空间可以复用,重写关系则能将多余空间归还文件系统。本文介绍如何衡量膨胀,并选择重整时机。
关系膨胀概述
若一个关系占用 100 GB,压实后的副本只需 60 GB,则估算膨胀率为 (100 - 60) / 100 = 40%。
普通 VACUUM 会回收死元组占用的空间,让表内后续写入复用,也可能截断文件末尾的空页。它不会跨整张表压紧活元组,因此活页之间的空闲空间通常仍留在关系文件中。
VACUUM FULL 将活元组复制到新文件中,把表压实。操作期间持有 AccessExclusiveLock,阻塞读写。pg_repack 允许大部分读写继续进行,但在初始化和最终切换时仍需短暂获取排他锁。
先测量膨胀程度,再选择需要重写的关系。根据负载、可用磁盘和维护窗口设定处理阈值与时间。
关系膨胀的度量
用 1 - 紧实大小 / 实际大小 估算膨胀率。紧实大小包括活元组,以及必需的页面、元组和对齐开销。
PostgreSQL 可以提供关系的实际大小。下一步是测量或估算活元组所需的空间。
测量元组与空闲空间
pgstattuple 扫描关系,报告活元组、死元组和空闲空间。tuple_percent 的范围是 0–100,所以 1 - tuple_percent / 100 才是活元组以外空间的比例,其中还包含必需的存储开销。下方样例将其命名为 bloat,但它不等于重写后能回收的精确比例。
字段定义见 PostgreSQL 10 的 pgstattuple 文档。B-tree 索引还可以使用该扩展中的 pgstatindex 函数。
另外两个随 PostgreSQL 提供的扩展可用于检查关系存储:
- pg_freespacemap:查看各页记录的空闲空间。
- pageinspect:读取单个页面的内容。
日常监控通常用估算值筛选需要进一步检查的关系。精确测量活元组需要扫描整个关系,对大量表重复扫描会增加 I/O 开销。
PostgreSQL 9.5 在 pgstattuple 扩展中加入了 pgstattuple_approx 函数,通过估算部分数值减少扫描量。实际开销取决于需要读取多少页面。
频繁监控大量表时,使用基于统计信息的估算;需要精确测量时,再扫描选定的关系。
膨胀率的估算
估算使用表和列统计中的三个值:
- 元组的平均宽度
avgwidth:从列级统计数据计算而来,用于估计紧实状态占用的空间。 - 元组数:
pg_class.reltuples:用于估计紧实状态占用的空间 - 页面数:
pg_class.relpages:用于测算实际使用的空间
估算公式为:
这里 block_size 是页面大小,默认为8192,pageheader 是首部占用的大小,默认为24字节。页面大小减去首部大小就是可以用于元组存储的实际空间,因此 (reltuples * avgwidth) 给出了元组的估计总大小,而除以前者后,就可以得到预计需要多少个页面才能紧实地存下所有的元组。最后,期待使用的页面数量,除以实际使用的页面数量,就是 利用率,而1减去利用率,就是膨胀率。
难点
估算元组平均长度时,需要考虑:
- 当元组中存在空值时,首部会带有空值位图。
- 首部与数据部分存在Padding,需要考虑边界对齐。
- 一些字段类型也存在对齐要求
计算元组的平均长度
下图展示 PostgreSQL 的元组布局,用于估算元组的平均长度。
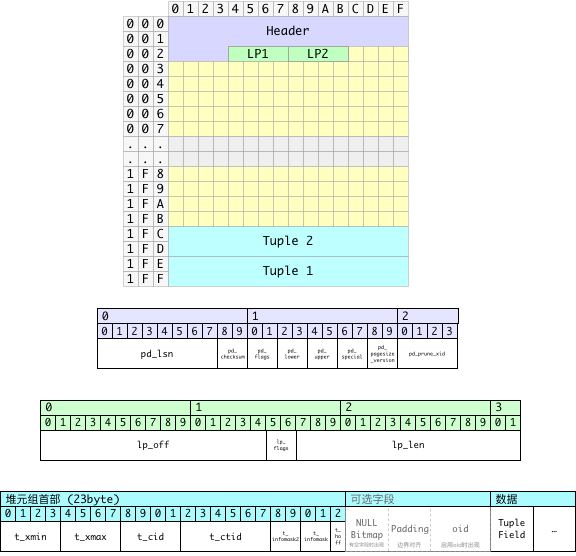
一条元组占用的空间可以分为三个部分:
- 定长的行指针(4字节,严格来说这不算元组的一部分,但它与元组一一对应)
- 变长的首部
- 固定长度部分23字节
- 当元组中存在空值时,会出现空值位图,每个字段占一位,故其字节数为字段数除以 8 后向上取整。
- 在空值位图后需要填充至
MAXALIGN,通常为8。 - 如果表启用了
WITH OIDS选项,元组还会有一个4字节的OID,但这里我们不考虑该情况。
- 数据部分
因此,一条元组(包括相应的行指针)的平均长度可以这样计算:
关键在于求出 首部的平均长度 与 数据部分的平均长度。
计算首部的平均长度
首部平均长度主要的变数在于 空值位图 与 填充对齐。为了估算元组首部的平均长度,我们需要知道几个参数:
- 不带空值位图的首部平均长度(带有填充):
normhdr - 带有空值位图的首部平均长度(带有填充):
nullhdr - 带有空值的元组比例:
nullfrac
首部平均长度的估算公式为:
因为不带空值位图的首部,其长度是23字节,对齐至8字节的边界,长度为24字节,上式可以改为:
将长度向上取整至 8 字节的倍数,可用:
计算数据部分的平均长度
数据部分的平均长度主要取决于每个字段的平均宽度与空值率,加上末尾的对齐。
以下SQL可以利用统计信息算出所有表的平均元组数据部分宽度。
例如,以下SQL能够从 pg_stats 系统统计视图中获取 app.apple 表上一条元组的平均长度。
max(null_frac) 只是“行内存在 NULL 的比例”的近似值。各列统计并不描述 NULL 在不同列之间的重叠关系。
整合
以下函数组合上述估算,假定按 8 字节对齐,并使用服务器实际块大小。缺少统计时返回 NULL。函数只估算堆表;TOAST、fillfactor 和列对齐都会影响结果。
批量计算
对全库监控,可将基于目录统计的批量估算定义为视图。下面是独立的 B-tree 索引膨胀估算示例:
在原来的 3 TB 数据库中,这个视图查询约需 50 ms。它读取目录统计,而非扫描每个索引页;目录访问和关系大小查询仍有开销,过期或不完整的统计也会影响结果。此估算适合筛选需要进一步检查的索引。
表膨胀的处理
维护窗口允许独占表时,可以使用 VACUUM FULL。需要在线重整时,pg_repack 可以缩短持有排他锁的时间。
原 PostgreSQL 10 环境使用下面的 PGDG 软件包。实际安装时选择与 PostgreSQL 大版本对应的软件包:
pg_repack 的使用
pg_repack 使用常见的 PostgreSQL 客户端连接参数。
在使用 pg_repack 之前,需要在待重整的数据库中创建 pg_repack 扩展
命令示例:
-T 控制等锁时间,不限制整个任务的执行时间。未加 --no-kill-backend 时,pg_repack 可能取消冲突查询,随后终止仍有冲突的会话。完整重整表还需要主键,或全部列均为 NOT NULL 的适用唯一索引。详见参数说明。
pg_repack 的策略
将 pg_repack 安排在业务低峰期。它会消耗 CPU、磁盘 I/O 和额外存储,也可能增加查询延迟与复制延迟。
例如,可以在低峰期选择待处理表。下面的视图提供调度示例所需的列,total_mb 是表当前占用的磁盘空间,含索引和 TOAST,单位为 MiB:
以下 shell 函数按行返回表名,并将每个带引号的参数视为一个完整表名:
以下大小门槛均指当前磁盘用量,包含表、索引和 TOAST:
- 从小于 256 MiB,且膨胀率超过40%的小表中,选出TOP64
- 从 256 MiB 到 1 GiB 之间,且膨胀率超过 30% 的中表中,选出TOP16
- 从 1 GiB 到 4 GiB 之间,且膨胀率超过20%的大表中,选出TOP4
此示例在凌晨业务低峰期自动重整选定的表,总磁盘用量超过 4 GiB 的表手工处理。请按实际负载调整执行时间。
pg_repack 的原理
pg_repack 创建紧实副本,并用触发器记录并发变更。重放变更后,通过系统目录交换存储。只重整索引时,先并发创建替代索引,再交换并删除旧索引。
重整表
- 创建一张与原表模式相同,但不带索引的空表。
- 创建一张与原始表对应的日志表,用于记录
pg_repack工作期间该表上发生的变更。 - 为原始表添加一个行触发器,在相应日志表中记录所有
INSERT,DELETE,UPDATE操作。 - 将老表中的数据复制到新的空表中。
- 在新表上创建同样的索引
- 将日志表中的增量变更应用到新表上
- 通过系统目录交换表、索引和 TOAST 存储
- 删除旧存储。
重整索引
- 使用
CREATE INDEX CONCURRENTLY在原表上创建新索引,保持与旧索引相同的定义。 - 在系统目录中交换新旧索引。
- 删除旧索引。
pg_repack 的运行检查
- 避开长事务和冲突的维护任务。先检查等锁情况,再决定是否取消会话。
- 为替代表、索引和变更日志预留磁盘。项目文档建议,完整重整时可用空间约为原表及其索引大小的两倍。
- 在复制和建索引的整个过程中监控 WAL、复制延迟和磁盘余量。WAL 并非只在最终切换时产生。
- 中断后,先按已安装版本的清理说明检查残留对象,再重试。临时对象名称和清理行为因版本而异。
安排维护前请查阅 pg_repack 前置条件与实现说明。
1.12 - 监控 PostgreSQL 表大小
本文写于 2018 年,介绍 PostgreSQL 普通表的物理存储。
表的空间布局
普通表包含自身存储,也可能有一张 TOAST 表:
- 本体表:存储行数据,
relkind='r'。 - TOAST 表:按需存储行外数据,
relkind='t'。部分表没有 TOAST 表。
表本身和它的每个索引都是独立的 关系(Relation):
- 主体关系:存储元组。
- 索引关系:存储索引元组。
每个 关系 又可能会有 四种分支:
-
main: 关系的主文件,编号为0
-
fsm:保存关于main分支中空闲空间的信息,编号为1
-
vm:保存关于main分支中可见性的信息,编号为2
-
init:用于不写 WAL 的 unlogged 表和索引,编号为3
每个分支存储在一个或多个文件中。默认每段最大 1 GiB,编译 PostgreSQL 时可以修改此值。
统计一张表的存储,需要计入以下关系:
- 本体表的主体关系(单个)
- 本体表的索引(多个)
- TOAST表的主体关系(单个)
- TOAST表的索引(单个)
对每个关系,应计入实际存在的 main、fsm、vm 和 init 分支。init 用于 unlogged 关系。
获取表的附属关系
以下查询列出关系 OID。分支共享所属关系的 OID,没有独立 OID。左连接会保留没有 TOAST 表的普通表:
统计函数
PostgreSQL 提供了对应的大小统计函数:
| 函数 | 统计口径 |
|---|---|
pg_total_relation_size(oid) |
整个关系,包括表,索引,TOAST等。 |
pg_indexes_size(oid) |
关系索引部分所占空间 |
pg_table_size(oid) |
表的各个分支和 TOAST(含 TOAST 索引),不含主表索引 |
pg_relation_size(oid) |
获取一个关系主文件部分的大小(main分支) |
pg_relation_size(oid, 'main') |
获取关系 main 分支大小 |
pg_relation_size(oid, 'fsm') |
获取关系 fsm 分支大小 |
pg_relation_size(oid, 'vm') |
获取关系 vm 分支大小 |
pg_relation_size(oid, 'init') |
获取关系 init 分支大小 |
日常监控可将存储分为表与索引两部分。对普通表,pg_table_size 与 pg_indexes_size 之和等于 pg_total_relation_size。
各部分满足以下关系。这是计算公式,不是完整的 SQL 查询:
TOAST 表有一个索引。使用 pg_total_relation_size(reltoastrelid) 可计算 TOAST 表及其索引的总大小。
例:统计表及其附属关系大小
可将查询包装为返回表的函数,方便复用。请将示例 OID 替换为实际数据库中的表:
每行 size 都包含该关系的附属存储。主表行已经包含索引和 TOAST,不能再将这一列求和。tuples 和 pages 来自规划器统计,可能落后于实际数据。
原环境中的返回结果:
例:关系大小详情汇总
1.13 - PostgreSQL 服务器日志配置
本文写于 2018 年。下方表结构对应 PostgreSQL 10 的 23 列 CSV 格式,Filebeat 示例使用当时的 prospectors 配置。
CSV 日志可以导入 PostgreSQL 表,也可以通过 file_fdw 直接查询。
日志配置
最后三项用于运行统计,不控制日志输出。logging_collector 和 track_activity_query_size 需要重启服务器生效。按星期命名的文件每周会重用同一名称,应按所需保留时间设置轮转和清理规则。
日志收集
原方案使用 Filebeat 将本地日志转发到 Kafka。请替换文件路径和 Kafka 地址。这个旧版示例从已有文件末尾开始读取,按时间戳模式合并行,最多合并 20 行;它不能完整识别任意多行消息的 CSV 记录边界。
CSV 日志格式
将日志映射为表后,就能用 SQL 分析。下列表结构与 PostgreSQL 10 的 CSV 字段 一致。后续版本增加了列,导入时应使用产生日志的服务器版本对应的表结构:
导入日志
用 COPY 导入已经关闭的 CSV 日志文件,服务器需要有文件读取权限。文件在客户端机器上时,改用 psql 的 \copy。日志轮转后再导入完整文件,每个文件只导入一次。
映射日志
file_fdw 可以直接查询本地 CSV 文件,无需先复制到表中。用具备扩展和服务器文件访问权限的角色执行以下设置。示例假定文件位于 /pg/data/log,且星期名为英文缩写,请按实际输出调整路径。部分星期文件尚不存在时,先查询已有文件对应的子表。
提取日志字段
这些函数从英文日志消息中提取耗时、语句文本和形似 IPv4 的文本。耗时单位为毫秒。函数仅处理示例中的消息格式,不覆盖所有扩展查询协议或本地化消息:
2 - 设计归档
设计记录解释 PG Exporter 的架构、备选方案与取舍。每篇注明状态、源码边界和最后核验日期。
快照直方图已随 v1.4.0 发布。复制采集器修正与目标状态约定已随 v1.5.0 发布。Composite 模式、缓存 pgBackRest 指标和 PostgreSQL 日志指标已在开发分支实现,尚未进入稳定版 v1.5.0。独立可观测性产品提案已被取代。
2.1 - 目标身份与一致的健康检查响应
状态: 已随 v1.5.0 发布。
决策与最后核验日期: 2026-10-23。
范围: v1.5.0,源码1891254(修复基线9b378cb),涵盖连接串与数据库身份、由元数据驱动的采集器选择、HTTP 健康状态快照、YAML 时间配置及指标路由校验。
交付: 源码已提交并推送,v1.5.0 标签指向18912540fe5edce0ed0ee81fac0d989738ecaa87;CI 与正式发布工作流通过,GitHub Release、RPM/DEB/压缩包和 Docker 镜像已发布。未据此声称生产部署或生产负载验收完成。
目标身份
URL 语法或查询参数转义错误必须阻止启动,且不能打印原始连接串或含有连接串的解析错误。共享 URL 解析器还须拒绝解码后为空、包含 Unicode 空白或 = 的查询参数名,防止这些名称进入驱动解析或绕过密码遮盖。诊断使用固定文本,不包含连接串或错误参数名。静默丢弃错误参数可能连显式 TLS 设置一起丢掉。省略 sslmode 时仍默认使用 disable;有效的显式设置保持不变。
所支持 URL 形式中的数据库名交给现有 lib/pq 解析器确定,涵盖路径、显式查询参数和数据库别名。Exporter 自行模拟它们的优先级容易把 PgBouncer 当成 PostgreSQL,或错误识别自动发现的数据库。发现新库后,替换连接串时移除 dbname、database 两个查询参数,将库名写入唯一且正确转义的路径,保留其他参数及库名的原始字符。Service 文件中的目标解析,以及仅依赖连接默认值推导的 PgBouncer 身份,不在本次修复范围内。
选用 PG_EXPORTER_URL_FILE 时,文件内容为空或仅含空白必须阻止启动。此处检查的是保存连接 URL 的文件,不是 TLS 私钥文件。
采集器选择
元数据预检成功后,用户名、Schema 集合或扩展集合变化也应使查询计划失效,沿用版本、数据库名和恢复状态变化时的处理方式。比较集合而非返回数组顺序。下一轮采集通过既有计划流程重新选择采集器、重建缓存并重置查询统计;元数据不变则保留现有计划和缓存。安装扩展后不再需要手工重载,也不增加后台线程或额外元数据查询。
健康状态快照
只发布一个原子状态枚举:unknown、down、starting、primary、replica。Up() 和 Recovery() 从这个值推导。每个健康检查 HTTP 请求只读取一次,并同时推导状态码和响应正文。三个分别原子更新的字段并不是一份原子快照;重复读取也可能混合不同探测轮次的状态。
沿用既有路由、HTTP 状态码、后台探测间隔和采集结果更新健康状态的方式。此决定保证单次响应内部一致,并不把缓存状态变成数据库实时可用性的同步证明。完整状态可存入一个原子整数,无需增加互斥锁。
指标路由
启动校验必须确认对配置路径的请求选中了指标处理器本身。仅比较匹配的路由字符串并不充分:mux 的重定向也可能返回相同字符串,却没有进入指标处理器。校验时比较返回的处理器与注册的指标处理器,拒绝落入重定向或其他端点的路径,保留在当前 mux 下确实可达的转义路径,无须一概禁止百分号转义。
验证与边界
回归测试覆盖显式数据库身份、特殊字符和冲突参数、错误 URL、Schema/扩展/用户资格变化、元数据顺序不变、并发健康状态切换,以及两种 HTTP mux 下的可达转义路径和重定向。新增用例在修复前失败、修复后通过。
v1.5.0 发布前验收补充了以下验证:
- 错误的 TLS 转义在连接前被拒绝;
verify-full对不提供 TLS 的服务器连接失败。日志不包含连接密码,空 URL 文件被拒绝。 - 含冲突参数和特殊字符的自动发现连接返回正确数据库指标;增加与删除数据库、Schema、
hstore后,采集计划按元数据更新。稳定集合保留缓存。 - 非法单文件重载保留旧定义和缓存;断连后健康检查恢复;物理备库晋升后角色与标签选择更新;并发抓取、健康与重载请求的状态码和正文保持一致。
- Go race 测试、两种 HTTP mux、
go vet、Staticcheck、模块与生成配置一致性、六平台构建、RPM/DEB 安装和 Docker 构建通过。针对有效 UTF-8 URL 身份及实际 HTTP URL 构造的短时模糊测试完成约 60.4 万次输入。 - 以非超级用户重新验证 PostgreSQL 9.1–9.6、10–18、19 RC1 的默认主库采集,以及 PgBouncer 1.26.1。PG10–13 使用已记录的订阅 OID 授权。此范围不代表穷尽扩展、瞬态故障和生产负载。
证书链/主机名/双向 TLS 的全部组合、SQLSTATE 57P03 的真实启动瞬态和生产负载不在本轮完整验证范围内。Docker 的证书验证仍需按手册挂载 CA。目录加载可跳过错误文件;空 YAML 是合法的零采集器配置;SIGTERM 不等待活跃 HTTP 请求。上述既有行为没有改变。
配套配置校验在转换为 time.Duration 前拒绝 YAML 主查询 TTL、查询 timeout 和谓词 TTL 中非有限或正向溢出的秒数,保留零值、默认值及有限负超时的既有语义。本次不迁移驱动,不整合可选组件,不修改指标名称,也不做通用重构。
2.2 - 复制采集器的身份、状态与权限修正
状态: 已随 v1.5.0 发布。
决策日期 / 最近核验: 2026-10-22 / 2026-10-23。
范围: pg_exportermain提交d97ba38fc8390984df994b2f9ea58b43ecfc8b89中的 Collector 修正,基于72f00a4fa4e6eb7524174f2122b3fe1e1d608db4;PostgreSQLREL_19_RC1对应0b8bff042a997fe50fcd1c4c83b9ef1cc9ed8a89,另作 PG9.6–18 的针对性检查。这些修正从 v1.5.0 开始发布,v1.4.1 不包含。
交付: 源码已提交并推送,v1.5.0 标签指向18912540fe5edce0ed0ee81fac0d989738ecaa87;CI 与正式发布工作流通过,GitHub Release、RPM/DEB/压缩包和 Docker 镜像已发布。未据此声称生产部署或生产负载验收完成。
已选定的修正
| 问题 | 决策 | 保留行为 |
|---|---|---|
| 不同数据库的同名订阅产生重复指标样本 | 给全部 pg_sub 版本分支添加 datname |
原指标族,包括 pg_sub_id;cluster 范围、worker 过滤和数值 |
| Receiver CASE 混入 sender 状态名称 | 补足真实 receiver 字典并修正 HELP | 已有效的 0、4、5 编码;未知与 NULL 仍为 -1 |
| 可选 origin 采集器的权限说明不完整 | 保持 skip: true,说明用户自行授权及版本限制 |
原 SQL、指标和默认关闭行为 |
| 发布与订阅的关系数量统计集合不同 | 校正 HELP 与手册 | SQL、标签、数值和缺失样本行为;不新增序列指标 |
订阅身份
(datname, subname) 可以唯一标识同一 PostgreSQL 集群中的订阅。上游对 (subdbid, subname) 有唯一约束,数据库名在同一集群内也唯一。查询必须通过订阅 OID 找到真实归属数据库:
这里的 subscription_id 指现有来源别名:PG19 分支用 s2.subid,更早分支用统计视图中的 subid。把 d.datname 加入结果并声明为 LABEL。不能使用 CURRENT_DATABASE(),不能仅按订阅名关联,也不能把连接库名作为常量标签代替实际归属。
查询仍必须保持每个订阅一行。保留 apply leader 过滤和 PG19 对 sequence synchronization worker 的排除。数据库身份区分不同订阅;worker 过滤避免同一订阅重复出行,两者分别必要。
PG10–13 的额外权限前提
PG10–13 遗漏了 pg_subscription.oid 的默认公开读取权限。上游明确只为 PG14 修正,没有修改旧分支。因此,数据库标签方案在这些旧版本上有一项升级前提:
应替换为实际监控角色。授权应在每个可能作为 exporter 主连接的数据库中执行,不能只在订阅所在库执行;它不会授予 subconninfo 权限。PG14+ 在标准目录 ACL 下无需为此关联增加授权;用户自行收紧的 ACL 仍由用户管理。
这是一项部署成本,不是自动权限修复。PG10–13 必须先授权,再部署修改后的配置。缺权限时查询失败,订阅指标缺失,但 HTTP 仍可能是 200;因此验收必须同时检查预期样本与查询错误,不能只检查 HTTP 状态。
替代方案与迁移代价
额外增加 subid 标签可以省掉两个关联及旧版本授权。此次选定数据库身份,是为了便于按数据库阅读、筛选,并与其他 Collector 的标签习惯一致。在此需求下,两个目录关联和一项明确的旧版列授权,比新建权限包装函数或运行时 fallback 更小。不同时添加两种身份标签。
保留 id GAUGE,不把它改成 LABEL 而删除 pg_sub_id。指标族名称与样本数量保持不变,但新标签会产生新时序;应检查对标签敏感的 PromQL 联接与聚合。数据库或订阅改名也会改变身份。跨集群仍由目标标签区分。
Receiver 状态字典
已逐个对照 PG9.6 至 PG19 RC1 的发布边界源码。PG9.6–18 有六个 receiver 状态,PG19 增加 connecting。
| Receiver 字符串 | 编码 | 适用范围 |
|---|---|---|
| streaming | 0 | PG9.6–19 |
| stopping | 4 | PG9.6–19 |
| connecting | 5 | PG19;旧服务器不会产生此值 |
| starting | 6 | PG9.6–19 |
| waiting | 7 | PG9.6–19 |
| restarting | 8 | PG9.6–19 |
| stopped | 9 | PG9.6–19 |
| 其他或 NULL | -1 | 全部分支 |
从 receiver CASE 与 HELP 中移除 startup、catchup、backup。旧编码 1–3 留空,不重新赋义。对当前三个分支及 legacy 的 pg_recv_96 使用一致字典,无需新版本分支或 Go 状态逻辑。
内部枚举存在不代表统计视图一定有可见行。RC1 在 PID 为零或统计未准备好时不返回 receiver 行;无行时不能制造 stopped 或 streaming 样本。保留连接中 sender host / port 为 NULL 的处理。
对抗性测试还发现,legacy receiver 查询在 PG9.6 上调用了 PG10 才引入的 regexp_match()。将两处取首个捕获组的表达式改为标量 substring(... FROM ...),即可让查询在 PG9.6 执行,不增加版本分支、集合返回函数或 conninfo 解析器。正则表达式与得到的 host / port 标签保持一致。这一直接前提随字典修正一起处理。
PG9.6 自身只向非超级用户展示 receiver PID,其余统计字段为 NULL,因此该角色下状态为 -1。修复 SQL 兼容性不会绕过这种可见性规则,也不意味着应向监控账号授予超级用户权限。
最终 legacy 查询已在 PG9.6–12 执行。真实 PG9.6.24 备库向管理员返回 streaming 状态 0,向普通 monitor 返回状态 -1;该监控角色的 HTTP 抓取返回 200 与 11 个 receiver 样本。host / port fixture 覆盖缺失字段、NULL、Unix 路径、IPv6、重复键与带引号输入;PG10–12 的新旧提取表达式结果一致。这里保留原有正则语义,包括其对含空格引号值的既有限制。
可选复制源采集
当前与 legacy 配置已经设置 skip: true,应原样保留。文档明确由用户先准备权限,再显式启用。
采用标准目录 ACL 的 PG14+ 可由管理员给实际监控角色授权:
授权在 exporter 主连接使用的数据库中执行。PG13 及以前保留函数内部的超级用户检查,仅 GRANT 不能让普通监控角色直接使用;除非管理员另行选择并维护访问方案,否则保持可选入口关闭。本次不添加 SECURITY DEFINER 包装函数、自动 GRANT、切换身份重试或伪造零值。
标准 ACL 已允许公开读取 pg_replication_origin 目录,因此不需要重复授权。若部署收紧过目录 ACL,管理员还需自行准备查询所需的目录读取权限。
发布与订阅计数
文档描述当前真实行为:
pg_pubrel_count统计pg_get_publication_tables()返回的表,不包括序列。现有 CROSS LATERAL 查询对空发布、纯序列发布不输出行;缺失不是显式的零。- PG19 的
pg_subrel_count按同步状态统计pg_subscription_rel中的表与序列。PG19 表状态为 i/d/f/s/r,序列状态为 i/r。 - 两端计数不构成复制健康的等式。多 publication、对象重叠、分区、refresh 和异步同步都会影响解释。
只修改说明与手册。保留订阅关系查询的 DISTINCT subid, subname,不在此补丁增加 pg_pubseq_count、relkind 标签、补零或新的对象计数定义。
验证证据与剩余关口
最终配置和从上述 main 基线构建的二进制,已由非超级用户监控角色在 PG10.21、11.16、12.22、13.23、14.23、15.18、16.14、17.10、18.4 和 19 RC1 上验证。两个数据库中的同名订阅得到不同标签,重复样本键为零。PG10–13 在列授权前失败,仅在订阅库授权后仍失败,在主连接库授权后通过;始终不能读取 subconninfo。PG10–14 分支输出 14 个样本,PG15–18 输出 18 个,PG19 输出 42 个,差异来自原有指标族数量。
RC1 完整配置验证覆盖 disabled、active、自动发现开关及物理备库。针对性 HTTP 验证在抓取前后均捕获 table-sync / sequence-sync 与 apply worker 并存,订阅样本仍为 42 个。完整默认计划未选择 pg_origin。Receiver 枚举 fixture 覆盖 PG9.6 和 PG10–19 各大版本;另实际观察 RC1 streaming 与 connecting,后者 sender 字段为 NULL 时 HTTP 仍正确输出状态 5。枚举 fixture 不等于实际观察过所有瞬态。
使用真实 origin 条目的测试确认:仅授权视图不足;PG14+ 补充文档中的函数授权后成功,PG13 及更早版本仍拒绝非超级用户。空 origin 目录不足以证明权限正确,因为 LEFT JOIN 可能不调用受限函数。RC1 中,混合发布输出一个表,订阅端统计一个表加一个序列;空发布和纯序列发布不输出行。
本地 Go race 测试、兼容 HTTP-mux 模式、go vet、依赖一致性,以及已有的 schema、版本覆盖、生成文件一致性、常量标签冲突检查均通过。无需修改 Go 实现或依赖。源码验证与双语文档构建独立于发布和生产验收。
实施边界
源码范围限于七个拆分 Collector 文件及两个生成配置包;companion 范围为成对的 Collector 手册和本 Design 记录。手册区分已有权限 / 计数语义与 v1.5.0 的身份、状态字典、PG9.6 SQL 修正。源码审阅、提交、推送、标签与正式制品发布均已完成;生产部署仍是独立动作。
不包含驱动迁移、Gatherer 重构、运行时权限管理、新 Collector 分支、新指标族、订阅关系聚合改写或无关 legacy SQL 修复。
上游依据
2.3 - 把 PostgreSQL CSV 日志转成持久指标
PostgreSQL 日志会记录 SQL 快照可能错过的事件:死锁、认证失败、自动清理取消、检查点、临时文件删除和客户端断连。根据服务端日志策略,还可以记录语句耗时。
状态: 已实现,未发布。
决策日期: 2026-08-24。
最后核验: 2026-10-13。
范围: 源码提交c0ba58a的 PostgreSQL 14+ CSV 日志采集器,默认关闭;稳定版v1.4.1尚未包含。
取代: 独立可观测性产品提案。
交付进度: 本地测试通过;未合入main或发布标签;软件包、部署与生产运行未核验。
本采集器读取一个本地 CSV 日志目录,保存有限的聚合状态,并在 /metrics 暴露 Counter 和 Histogram。原始日志保留在 PostgreSQL 日志文件中。
范围与启用方式
采集器运行在现有 PG Exporter 进程中。指定非空日志目录即可启用:
对应环境变量为 PG_EXPORTER_PG_LOG_DIR、PG_EXPORTER_PG_LOG_STATE_FILE 和 PG_EXPORTER_PG_LOG_POLL_INTERVAL。默认目录为空,状态路径如上,轮询间隔为一秒。
关闭时不创建后台任务、状态锁、状态文件或日志指标,也不增加文件扫描或抓取协调。--dry-run 与 --explain 不启动后台任务。
范围限于本地 PostgreSQL CSV 日志和聚合指标,不包括其他格式、日志发送、查询界面、会话时间线、任意正则表达式或自动根因分析。日志设置仍由 PostgreSQL 配置管理,采集器不提供 pg_log_setting_* 指标。
读取完整 CSV 记录
PostgreSQL 14 到 18 文档采用相同的 26 列 CSV 布局,包含时间戳、进程和会话标识、严重级别、SQLSTATE、消息、应用、后端类型、并行主进程 PID 与查询 ID。
字段可以包含逗号、引号、回车和换行,因此读取器先识别完整 CSV 记录,再解码。逐物理行扫描无法正确处理该格式。
文件末尾尚未写完的记录保持待处理,完整后才提交其偏移量。单条记录上限为 16 MiB。畸形或超大输入触发有界重新同步,并增加解析错误和输入缺口计数。连续结构不匹配会使组件保持不可用,直到恢复有效输入。
文件身份与轮转
后台任务轮询并核对目录。仅靠文件通知无法恢复遗漏事件,也无法在重启后重建状态。
每个游标保存文件身份、代次、路径哈希、字节偏移、大小、内容指纹和读取状态。状态文件不保存明文日志路径。
重命名轮转按文件身份跟踪:读取器继续读完旧文件,为新文件建立游标。文件大小低于已提交偏移时,视为截断,从零开始新代次,并记录轮转和输入缺口。复制后截断可能在轮询发现前丢弃未读字节,采集器无法恢复这些字节。
未读完的文件消失或内容指纹变化,也会记录缺口。已读完且消失的游标可以移除。状态最多跟踪 256 个文件身份,并保留仍有未读内容的游标。
无状态文件的首次启动,从各现有文件的当前末尾开始读取,同时增加状态重置和输入缺口计数,标明新的计数起点。本设计不回填历史日志。
先提交状态,再发布指标
日志 Counter 与 Histogram 必须在 Exporter 重启后保留。游标偏移和聚合值共同提交;只推进其中一个,会导致观测丢失或重复。
一轮后台周期准备候选状态,然后执行:
状态文件上限为 4 MiB。在 Unix 上,必须是权限 0600 的普通文件;符号链接和不安全权限会被拒绝。非阻塞状态锁防止两个进程共用同一状态,保存的目录身份必须与配置来源一致。
重命名前崩溃会留下上一份已提交状态。重命名后崩溃,重启可以恢复新状态并重建对应指标。/metrics 只读取已发布快照,不扫描文件、解析 CSV 或写状态。
每轮最多处理 100,000 条记录或 64 MiB。仍有输入时,立即开始下一轮。
指标与序列上限
核心指标族为:
其他指标覆盖具体 SQLSTATE 代码、检查点与重启点、自动清理、锁等待、临时文件、连接和会话时长。
日志 Histogram 是与游标一同持久化的累计观测,可使用 rate() 等普通 Counter Histogram 查询。显式状态重置会开始新的计数周期。这与描述当前总体、使用 Gauge 序列的 SQL 快照直方图不同。
标签采用固定取值。查询时长的 kind 只有 statement、execute、parse、bind 和 other。具体 SQLSTATE 指标仅接受官方代码,最多保存 128 个已观察代码序列,自定义和未知代码归入 other。总输出上限为 1,200 条序列。
原始 SQL、消息、数据库名、用户名、应用名、关系名、查询 ID、地址、进程与会话 ID、事务 ID 和文件路径都不进入标签或持久状态。一条记录可以更新多个聚合值,但最多产生一个主要分类事件。例如,指标可以显示死锁增加,而不保留相关 SQL 文本。
读取器健康
读取器暴露以下指标:
它还使用 pg_exporter_component_*{component="postgres_log"}。输入、权限、解析、状态、上限或指标族冲突错误只将日志组件标为不可用,最后提交的快照继续提供。结合健康、最后成功时间和缺口计数判断数据的新鲜度与完整性。
--disable-intro 移除 Exporter、组件和读取器自监控,保留 pg_log_* 业务指标。
日志策略决定覆盖范围
指标只覆盖 PostgreSQL 实际输出的记录。查询时长分布取决于 log_duration、log_min_duration_statement、采样和协议行为。例如,慢语句阈值产生的是已记录慢语句的分布,而非全部查询的分布。
检查点、自动清理、连接、断连、锁等待和临时文件指标也需要对应服务端日志设置。基于消息文本的事件解析依赖支持的语言和格式;基于 SQLSTATE 的错误分类不依赖本地化措辞。
为服务用户授予指定日志的读取权限和状态目录的写入权限。源日志可能包含 SQL 与客户端数据,应限制访问范围。
备选方案与非目标
- 在
/metrics中读取日志,会给数据库抓取增加解析和持久化耗时。后台任务将这些工作分开。 - 文件通知可以加快发现,但不能替代保证正确性所需的轮询与核对。
- 首次启动重放全部历史文件,会让初始计数取决于日志保留策略。从文件末尾开始可明确建立基线。
- 持久化前发布指标可能导致崩溃后重复计数,因此先提交状态。
- 动态标签与用户匹配规则会使序列数量和保存结构取决于输入,因此采用固定指标目录。
- 独立端点或可执行文件会为同一有限数据源增加部署单元,因此复用现有进程和端点。
核验与剩余工作
实现位于 exporter/postgres_log*.go。测试覆盖 PostgreSQL 14、16、18 样例;引号与多行字段;未完成记录;重命名与截断;重启、锁和权限;崩溃位置;事件分类;序列上限;冲突;重叠抓取与关闭。
外部 CSV 集成测试待核验。设置 PG_EXPORTER_TEST_PG_LOG_DIR,使用预定服务用户验证真实日志的轮转与重启恢复。
协调规则见 Composite Exporter。CSV 定义和日志设置见 PostgreSQL 14 与 PostgreSQL 18 官方文档。
2.4 - 把 pgBackRest 指标移出抓取路径
pgbackrest info --output=json 提供备份状态。命令可能访问远程仓库并等待存储响应。若在 Prometheus 请求中执行,数据库监控也要承担这段延迟。
状态: 已实现,未发布。
决策日期: 2026-08-23。
最后核验: 2026-10-13。
范围: 源码提交c0ba58a的可选--pgbackrest组件;稳定版v1.4.1尚未包含。
交付进度: 本地测试通过;未合入main或发布标签;软件包、部署与生产运行未核验。
因此,PG Exporter 在后台执行 pgBackRest,验证结果后发布不可变快照。/metrics 读取最新快照,无需等待命令。
执行上限
后台任务直接执行配置的程序,不经过 shell。
| 控制项 | 默认值 | 规则 |
|---|---|---|
| 命令 | pgbackrest |
使用固定的版本与 info 参数 |
| 刷新间隔 | 2 分钟 | 最小 10 秒 |
| 刷新超时 | 30 秒 | 版本检测与 info 共用一个截止时间 |
| 标准输出 | 16 MiB | 超限取消命令 |
| 标准错误 | 64 KiB | 超限取消命令 |
后台先执行 version --output=num,旧版本回退到 version,随后执行 info --output=json。取消操作终止直接子进程;一秒的等待上限约束输出管道清理时间。
发布前验证
命令正常退出后,还要检查 JSON 结构、数值字段,以及 stanza 和仓库引用关系。输入最多包含 256 个 stanza 和 4,096 个备份;输出最多包含 20,000 个样本,Prometheus 文本不超过 4 MiB。
只有完整合法的结果才能替换快照。指标族在发布前完成验证,抓取路径只需检查元数据和所有权。
按 Composite 所有权顺序,pgBackRest 排在 PostgreSQL、进程自监控、Patroni 和 PgBouncer 之后。冲突指标族会被省略,组件标记为不可用;其他合法指标族仍可保留。
保留最后一次成功结果
首次成功刷新后,命令、超时、解析或资源上限错误会保留上一份业务指标。组件报告 up=0,增加错误计数,并保留最后成功时间。
刷新失败时,后台仍会根据保留的 JSON 重算备份年龄,使其按刷新间隔反映经过的时间。/metrics 不解析 JSON,也不执行 pgBackRest。
首次成功前没有备份业务指标。PostgreSQL 与其他有效来源继续工作。
健康与并发请求
组件健康使用 component="pgbackrest"。up 表示最近一次采集结果,最后成功时间说明备份数据有多旧。命令失败使用 exec;标准输出超限使用 limit;解析和合并错误使用各自原因。标准错误超限归类为执行错误。
重叠抓取可以读取同一份快照,不会启动第二条命令,也不会更新已保存的组件健康历史。指标冲突仍按 Composite 所有权规则处理。
备选方案与非目标
每次抓取都执行命令,会把 Prometheus 超时和并发请求绑定到仓库操作。后台任务使执行超时和刷新间隔独立于抓取。
独立 Exporter 提供进程隔离,但增加一个服务、端口、软件包和目标。集成组件提供另一种部署选择,不自动迁移现有部署。
通用 shell 命令插件不适合此处。pgBackRest 需要专用 JSON 校验、版本处理、指标定义与恢复规则。本组件接受 pgBackRest 可执行程序,不接受任意命令模板。
核验与运维
exporter/pgbackrest.go 负责命令执行与快照发布,exporter/pgbackrest_metrics.go 负责 JSON 校验与指标构造。测试覆盖版本回退、畸形与过量输出、超时、保留最后成功结果、指标族冲突和关闭。
服务用户需要执行 pgBackRest、读取其配置和仓库凭据的权限。PG Exporter 软件包不捆绑 pgBackRest,使用主机上的备份软件安装。
对组件健康和最后成功时间设置告警。采集失败后,旧备份指标仍可能可见。替换独立 Exporter 前,使用预定服务用户,对同一个仓库比较两者的输出。
2.5 - 我们最终没有做的 PostgreSQL 可观测性产品
我们最初考虑做一个本地 PostgreSQL 事故工作台:读取结构化日志,重建会话时间线,提供交互过滤与终端界面,后续再作为 Agent 运行。
状态: 已于 2026-08-24 被 PostgreSQL 日志指标方案取代。
决策日期: 2026-08-13 开始研究;2026-08-24 调整范围。
最后核验: 2026-10-13。
范围: 独立 PostgreSQL 事故工作台与 Agent 提案。
交付进度: 止于提案,未实现、发布或部署。
眼前需求更小:从 PostgreSQL 日志中提取可靠的运维指标。最终选择是在 PG Exporter 中增加后台采集器。本文记录保留的研究结论,以及放弃独立产品的原因。
最初提案
事故发生时,DBA 可能只有本机日志,没有集中日志服务。理解 PostgreSQL CSV、SQLSTATE、会话与轮转的工具,可以在不上传 SQL 文本的情况下生成时间线。
提案包括:
- PostgreSQL 14+ CSV 解析,包括多行字段;
- 按时间、严重级别、SQLSTATE、数据库、用户、应用和会话过滤;
- 跨重命名日志文件保留上下文;
- 交互式终端界面;
- 本地处理与低基数 Prometheus 指标;
- 后续增加持久游标和多个输出目标的守护进程。
保留的结论
PostgreSQL 14 到 18 文档给出了相同的 26 列 CSV 布局。示例导入表以 (session_id, session_line_num) 为主键。CSV 字段可包含逗号、引号和换行,因此解析器必须读取完整记录。
SQLSTATE 比本地化消息文本稳定,是错误分类的主要依据。检查点、自动清理、锁等待、临时文件和连接消息,需要针对支持版本和语言测试匹配规则。
原始 SQL、用户名、数据库名、客户端地址和会话标识不适合作为默认指标标签。它们会暴露源数据,并使序列数量随工作负载变化。固定事件类别和有限分布更适合 Prometheus。
轮转、部分写入、重启恢复和游标持久化决定计数是否可靠,必须从一开始就纳入功能契约。
调整范围的原因
工作台需要独立的命令、输出结构、界面、软件包、文档和发布周期。Agent 还需要队列、重试、保留策略和服务管理。这些职责超过了指标导出器的范围。
PG Exporter 已有抓取目标、/metrics、打包和 Pigsty 集成;开发中的协调层也提供组件健康指标。有限范围的日志采集器可以复用这些能力,满足眼前需求。
因此,我们停止独立产品、仓库和品牌工作,将交互调查与日志发送移出范围。
替代方案
2026-08-24 的决策是:
为 PG Exporter 增加默认关闭的 PostgreSQL CSV 日志后台采集器,在现有
/metrics端点发布有限的运维指标。
替代方案保留完整 CSV 解析、文件身份、轮转与截断处理、持久游标与聚合值、原子持久化、不可变快照、固定标签和明确的输入缺口指标。
日志发送、交互查询、会话时间线、任意正则表达式和自动根因分析仍不在范围内。实现契约见 PostgreSQL 日志指标。
何时重新评估
独立工作台需要一个现有日志工具无法满足的本地调查场景,也需要用户验证事件模型,以及维护者承担发布和支持周期。在这些需求明确之前,PG Exporter 继续提供聚合指标。
来源
CSV 要求来自 PostgreSQL 14 与 PostgreSQL 18 官方日志文档。替代方案的源码边界和测试证据记录在链接的设计文章中。
2.6 - 一个端点,多种来源:Composite Exporter 契约
Composite 模式把 PostgreSQL、PgBouncer、Patroni、pgBackRest 和 PostgreSQL 日志指标合并到同一个 /metrics 端点,减少数据库节点上的进程和抓取目标。PostgreSQL 是主数据源;各可选来源独立报告故障和健康状态。
状态: 已实现,未发布。
决策日期: 2026-08-11;2026-08-23 与 2026-08-24 增加缓存组件。
最后核验: 2026-10-13。
范围: 源码提交c0ba58a的 Composite 协调层;稳定版v1.4.1尚未包含。
交付进度: 本地测试通过;未合入main或发布标签;软件包、部署与生产运行未核验。
PostgreSQL 保持主导
只有 PostgreSQL 的指标汇总错误会使 Composite 汇总失败。可选组件故障只影响自身指标和健康状态。只要 PostgreSQL 汇总成功,端点仍返回 HTTP 200。
所有可选组件默认关闭。全部关闭时,启动过程不创建可选后台任务、客户端或文件读取器,抓取路径也不增加 Composite 协调锁。
实时采集与缓存快照
PostgreSQL 与 PgBouncer 使用现有 SQL 采集器及查询缓存。Patroni 的角色和主节点状态变化较快,因此在每次完整抓取中请求其指标端点。
pgBackRest 与 PostgreSQL 日志由后台任务采集,并发布不可变快照。HTTP 请求只读取快照,命令执行、日志解析和状态持久化不会拖慢数据库采集。刷新与恢复规则见缓存 pgBackRest 指标和持久 PostgreSQL 日志指标。
超时与并发请求
PgBouncer 与 Patroni 在 --scrape-timeout 限制下并发执行,默认 10 秒。PostgreSQL 同时采集,沿用自身查询超时;可选组件的超时不会取消 PostgreSQL 采集。
若已有一轮完整 Composite 抓取正在运行,重叠请求只采集 PostgreSQL、进程指标和缓存快照。它跳过 PgBouncer 与 Patroni 的实时采集,并在本次响应中将这两个组件的 up 设为零,不更新已保存的错误计数和最后成功时间。这样可选采集不会形成请求队列。
指标族所有权
业务指标的优先级如下:
进程与 HTTP 自监控在 PostgreSQL 之后、可选来源之前合并。组件健康指标最后合并。
先占用名称的来源拥有整个指标族。即使类型、说明和标签一致,低优先级来源也不能追加样本。Histogram 与 Summary 的派生名称同样保留:高优先级 foo Histogram 会阻止低优先级 foo_count 指标族加入。
发生冲突时,省略冲突指标族,并将可选组件标记为 gather 错误。该组件的其他合法指标族仍可保留。
Patroni 指标接入
PG Exporter 抓取、解析、验证并重新编码 Patroni 的经典 Prometheus 文本,保留指标族名称、说明、类型、标签和值,不为业务指标添加 component 标签。
响应上限为 1 MiB、10,000 行样本和 256 个指标族。HTTPS 使用系统信任根及可选的 --http-ca-file。证书错误会将 Patroni 标记为不可用;没有跳过证书验证的参数。
组件健康
除非设置 --disable-intro,Composite 模式会暴露以下自监控指标:
enabled 表示组件是否启用,关闭的组件为零。up 表示采集结果。耗时和最后成功时间对实时来源表示抓取,对缓存来源表示后台周期。错误原因使用固定枚举,例如 connect、timeout、tls、parse 和 gather。
既有 /up、/health、/primary 和 /replica 端点继续描述 PostgreSQL。这些端点用于数据库健康检查与路由,可选组件不改变其含义。--disable-intro 移除自监控指标,保留业务指标。
备选方案与非目标
- 独立 Exporter 提供进程隔离,但需要独立的目标、软件包和服务配置。Composite 是一种可选部署方式。
- 串行采集使总耗时依赖来源顺序。并发实时采集共用一个可选组件超时。
- 原样转发 Patroni 文本无法检查指标所有权和响应上限。解析后可以同时检查两者。
- 通用插件注册机制会在集成尚未稳定时暴露生命周期和优先级规则。本设计采用具名组件和固定优先级。
- 要求所有来源成功,会让数据库监控依赖可选服务。协调层将故障限制在所属组件内。
本设计不改变指标命名空间,也不负责迁移 Pigsty 目标、仪表盘、告警或现有独立 Exporter。
核验与运维影响
实现位于 exporter/composite.go、exporter/patroni.go 及启动、重载路径。测试覆盖关闭行为、超时、TLS 与格式错误、指标族冲突、并发请求、重载和关闭。
同一个进程需要所有已启用来源的权限,只授予实际所需权限。替换独立 Exporter 前,在目标环境验证正式软件包、目标标签、仪表盘和告警。
2.7 - 快照直方图是 Gauge,不是 Counter
一个标量指标无法描述变化中的总体分布。一个 30 分钟事务与一百个 18 秒事务的总年龄相同,但数量、最大年龄和运维影响不同。
状态: 已随 v1.4.0 发布。
决策日期: 2026-07-11;2026-07-17 修订。
最后核验: 2026-10-13。
范围: 稳定版v1.4.1的HISTOGRAM列与pg_xact_age采集器,并对照开发提交c0ba58a核验。
交付进度: 已实现、合并、打标签并发布软件包。针对性本地测试已通过;部署与生产运行未核验。
PG Exporter 快照直方图对一次 SQL 执行返回的观测值分组。每次执行都重建分布。由于值可能下降,桶、计数和总和都以 Gauge 序列输出。
时间语义
事务开始时进入总体,随时间增长移入更大的年龄桶,结束时离开总体。这与持续累计事件的 Histogram 不同。
输出沿用常见的桶结构:
这三个指标族都是 Gauge。桶内计数按当前快照的上界累计,不跨抓取累计。直接使用 histogram_quantile():
当前平均年龄由总和除以计数得到:
不要对这些快照序列使用 rate()、irate() 或 increase()。这些函数会把数值下降解释为计数器重置。
配置与 SQL
用 usage: HISTOGRAM 声明观测列,并指定桶上界:
每个非 NULL 值是一次观测。完整标签元组相同的行归入同一分布;多个 Histogram 列独立聚合。
桶包含上界,边界必须有限且严格递增。配置加载时拒绝空列表、重复值、NaN 和无穷值。PG Exporter 自动追加 +Inf。le 标签及生成的 _bucket、_count、_sum 名称为保留名称,冲突配置会被拒绝。
scale 在分桶和求和前生效。时间戳与布尔值沿用标量转换规则,不进行缩放。显式 default 将 NULL 转为观测值;未指定时忽略 NULL。
查询、缓存与失败行为
每次 SQL 执行都从空累加器开始。PG Exporter 对观测分组、计算累计桶,并在读完全部结果后发布指标。
查询出错、缺少必需列或出现非有限观测值时,整份查询结果都被拒绝,包括同一查询的标量指标。刷新失败会将缓存替换为空结果,不保留上一份分布。
缓存命中直接返回上一份结果,不追加观测。下一次 SQL 执行从零开始。重载丢弃旧采集器和缓存,包括旧桶布局。
备选方案与非目标
prometheus.NewConstHistogram将数据标为 Counter Histogram,其时间语义不适合变化中的 SQL 总体。- OpenMetrics GaugeHistogram 能直接表达该语义,但需要为此功能改变输出协议。显式 Gauge 可沿用经典文本端点。
- Native Histogram 解决存储和分辨率问题,不改变观测是事件还是当前总体这一事实。
- 在 SQL 中预聚合桶,会让每个采集器重复分组逻辑。
- 跨抓取保留观测需要事件身份、重启处理和去重。持久事件采集不在本设计范围内;日志 Histogram 使用独立契约。
参考采集器与验证
pg_xact_age 按数据库统计未结束事务的年龄和事务内空闲时长,只选择客户端后端,TTL 为 10 秒。其桶边界支持计算当前分位数、超过阈值的数量和平均年龄。
以下 pgbench 脚本产生多档查询时长和事务内空闲时长。可在测试数据库中运行,观察事务进入和离开各桶:
实现与测试覆盖多个 Histogram 列独立聚合、NULL、缩放、桶边界、查询失败、缓存复用、确定性输出、并发采集与重载。
运维影响
Exporter 无需保存事件历史,就能提供可聚合的当前分布。虽然序列使用常见 Histogram 后缀,仪表盘查询仍须遵循快照语义。
完整语法见采集器配置,发布内容见 v1.4.0。普通累计 Histogram 的查询方法见 Prometheus Histograms and summaries。
3 - 发布注记
归档覆盖从 v0.0.1 到 v1.5.0 的全部 36 个仓库标签,每个版本各有一篇中英文注记。
其中 34 个版本有 GitHub Release;v0.0.1 和 v0.0.5 仅有 Git 标签。日期采用 GitHub 发布时间,标签版本采用提交时间,统一为 Asia/Shanghai(UTC+08:00)。
当前软件包和安装命令见下载页。
3.1 - PG Exporter v1.5.0
PG Exporter v1.5.0 升级 Go 工具链与依赖,修正复制采集器的身份与状态映射,并修复目标 URL、自动发现、健康检查、采集计划、时间配置和 HTTP 路由六类运行时缺陷。
默认配置仍包含 58 个 YAML 文件、96 个采集器分支、59 个命名空间、460 个不同指标定义。指标数量跨全部版本分支去重,包含默认关闭的采集器和两个尚未展开的 SQL 直方图;它不表示每次抓取都会输出 460 条时序。
变更摘要
- 连接 URL 更安全: URL 语法、查询参数转义或解码后的参数名非法时,启动立即失败,诊断不再暴露原始连接串。规范化错误参数时,不会再静默丢弃显式 TLS 选项。选中的
PG_EXPORTER_URL_FILE为空或仅含空白时也会拒绝启动。 - 自动发现连接正确数据库: 数据库身份复用
lib/pq解析,包括dbname与database别名。替换发现数据库的路径时清除冲突参数,保留库名特殊字符,避免多个连接重复采集同一库、产生重复指标并使 HTTP 返回 500。 - 健康响应保持一致: 每次响应从一个原子状态快照生成 HTTP 状态码和正文,避免并发探测、抓取与重载时出现 HTTP 200 搭配
down或starting。健康检查仍使用目标状态缓存。 - 采集计划跟随元数据: 元数据预检成功后,连接用户、Schema 集合或扩展集合变化会使计划失效。下一次抓取选中新增的合格采集器;依赖移除后不再选中相应采集器。集合不变时保留缓存。
- 拒绝非法时间配置: YAML TTL、timeout 与谓词 TTL 拒绝 NaN、无穷大和导致正向时长溢出的值;零值、默认值及有限负超时关闭期限的语义不变。
- 保证指标路径可达: 启动时检查当前 HTTP mux 实际选择的指标处理器,覆盖解码路径与重定向,避免校验成功但请求进入首页或重定向。
- 修正复制身份与状态: 全部
pg_sub_*样本增加datname标签,区分不同数据库中的同名订阅。pg_recv_state改用真实接收器状态字典,legacy 查询改用 PG9.6 兼容的substring()。 - 校准采集器描述: 明确可选复制 origin 的权限要求、发布端表数量与订阅端表/序列数量的区别,并将
pg_backend的说明修正为按后端类型分组。这些说明修改不新增指标族,也不启用可选采集器。
指标、仪表盘与告警兼容性
与同一 PostgreSQL 版本上的 v1.4.1 相比,v1.5.0 没有新增、删除或改名内置 SQL 指标。类型和单位不变,但标签与状态映射有变化。PostgreSQL 19 支持最早随 v1.3.0 发布;升级数据库还可能改变所选 SQL 分支与指标含义。
| 变化来源 | 指标 | 兼容性处理 |
|---|---|---|
| v1.5.0 配置 | pg_sub_* |
每条样本增加 datname。连接与聚合时保留数据库和订阅身份;新标签集会产生新时序。 |
| v1.5.0 配置 | pg_recv_state |
真实接收器状态 starting、waiting、restarting、stopped 从 -1 改为 6–9。更新值映射和状态告警;编码 1–3 保留。 |
| PG18 → PG19 | PG18 已有的指标名 | 本配置的 PG19 分支没有删除或改名这些指标;这不保证 PostgreSQL 自身提供的语义和标签取值不变。 |
| PG19 | pg_sub_sync_error_count |
名称保留,值变为表与序列同步错误之和。只监控表同步时用 pg_sub_sync_table_error_count,序列分量由 pg_sub_sync_seq_error_count 提供。不要把分量和总和重复相加。 |
| PG19 | pg_sub_has_worker、pg_sub_reset_time、pg_sub_confl_* |
新增 worker 存在标记、重置时间与八个冲突计数器。没有 apply worker 时仍可能保留订阅行,不能仅凭指标存在判断 worker 健康。 |
| PG19 | pg_subrel_count |
同时包含表和序列;pg_pubrel_count 仍只统计表。检查面板名称与数量比较规则。 |
| PG19 | pg_wal_fpi_bytes、pg_lock_stat_*、pg_recovery_state_*、pg_vacuum_score_* |
属于新增指标。恢复状态仅用于备库,自动清理评分仅用于主库;原有 WAL、锁分布和恢复指标族保留。 |
从 PG17 或更早版本升级的用户还需迁移旧名:检查点指标自 PG17 起移出 pg_bgwriter_*,而 pg_wal_write、pg_wal_sync、pg_wal_write_time、pg_wal_sync_time 自 PG18 起不再输出。完整兼容性指南逐项列出替代指标、标签/聚合差异与混合版本 PromQL。
部署前应执行实际仪表盘和告警表达式,并测试时序缺失的情况。抓取成功不代表所有预期指标都存在;告警表达式返回空结果时可能静默失效。缺失指标检查提供逐目标规则,并说明哪些缺失属于正常情况。PG19 指标对照表链接到发布标签中的精确定义;PostgreSQL 验证范围仍为 19 RC1。
工具链与依赖
| 组件 | v1.4.1 | v1.5.0 |
|---|---|---|
| Go | 1.26.5 | 1.27.3 |
prometheus/client_golang |
1.23.2 | 1.25.0 |
prometheus/common |
0.70.0 | 0.72.1 |
prometheus/exporter-toolkit |
0.17.1 | 0.20.0 |
golang.org/x/net |
0.57.0 | 0.61.0 |
golang.org/x/crypto |
0.54.0 | 0.58.0 |
golang.org/x/text |
0.40.0 | 0.43.0 |
数据库驱动仍为 lib/pq 1.12.3,本版没有驱动迁移或新增可选数据源。Prometheus client/model/procfs、YAML、压缩、OAuth2 等传递依赖也随之更新;不能仅凭版本升级就声称修复了应用可利用的 CVE。
安全更新
本次升级纳入上游安全修复,不表示每个 CVE 都能通过 PG Exporter 利用。下表比较 v1.4.1 源码、原始依赖和 Go 1.26.5:S 表示静态符号匹配,P 表示导入包匹配但未找到受影响符号调用,M 表示只匹配模块、未导入受影响包。静态符号匹配也可能是保守分析结果,不等于攻击复现。
Go 标准库与构建工具
Go 1.27.3 包含 CVE-2026-111943 的 X.509 不可信中间证书拒绝列表,以及累计的 HTTP、TLS、模板与解析器修复。旧基线中存在以下受影响标准库记录;匹配层级取自 Darwin/arm64,平台专属问题仍需满足相应前提。
| CVE | 组件 | 首个修复版本 | 旧基线匹配 |
|---|---|---|---|
| CVE-2026-39821 | net/http, net/http/internal/http2 | 1.26.6, 1.27.0-rc.3 | P |
| CVE-2026-46600 | net | 1.26.6, 1.27.0-rc.3 | P |
| CVE-2026-33818 | encoding/asn1 | 1.26.6, 1.27.0-rc.3 | S |
| CVE-2026-56859 | encoding/xml | 1.26.6, 1.27.0-rc.3 | M |
| CVE-2026-56853 | net/http | 1.26.6, 1.27.0-rc.3 | S |
| CVE-2026-56862 | crypto/tls | 1.26.6, 1.27.0-rc.3 | S |
| CVE-2026-56858 | html/template | 1.26.6, 1.27.0-rc.3 | S |
| CVE-2026-56860 | net/url | 1.26.6, 1.27.0-rc.3 | P |
| CVE-2026-94448 | html/template | 1.26.9, 1.27.2 | S |
| CVE-2026-97030 | html/template | 1.26.9, 1.27.2 | S |
| CVE-2026-78659 | net/http, net/http/internal/http2 | 1.26.9, 1.27.2 | S |
| CVE-2026-56857 | internal/syscall/windows, os | 1.26.9, 1.27.2 | P |
| CVE-2026-56866 | net/http, net/http/httputil | 1.26.9, 1.27.2 | P |
| CVE-2026-97031 | crypto/tls | 1.26.9, 1.27.2 | S |
| CVE-2026-94440 | mime/multipart, net/textproto | 1.26.9, 1.27.2 | S |
| CVE-2026-78667 | net/http | 1.26.9, 1.27.2 | P |
| CVE-2026-78660 | net/http, net/http/internal/http2 | 1.26.9, 1.27.2 | P |
| CVE-2026-78669 | net/http, net/http/internal/http2 | 1.26.9, 1.27.2 | S |
| CVE-2026-78663 | net/http, net/http/internal/http2 | 1.26.9, 1.27.2 | S |
| CVE-2026-94439 | net/http | 1.26.9, 1.27.2 | S |
| CVE-2026-97032 | net/http, net/http/internal/http2 | 1.26.9, 1.27.2 | S |
| CVE-2026-111943 | crypto/x509 | 1.26.10, 1.27.3 | S |
构建工具链还包含模块/工具链下载校验修复 CVE-2026-56865、CVE-2026-56864、CVE-2026-94444、CVE-2026-94447。这些属于构建环境加固,不是 Exporter 运行时漏洞。官方公告分别列于 Go 1.26.6、Go 1.27.2 和 Go 1.27.3。
Go 模块
| 依赖升级 | 纳入的修复 | 与 PG Exporter 的关系 |
|---|---|---|
x/net 0.57.0 → 0.61.0 |
CVE-2026-78659、CVE-2026-78660、CVE-2026-78669、CVE-2026-78663、CVE-2026-97032,0.60.0 修复 | HTTP/2 内存放大、畸形响应 framing、CPU 消耗、流控额度计算与 HPACK 竞态。旧基线有四项静态符号匹配和一项包匹配;相同 CVE 也影响 Go 内置的 HTTP/2 副本,不应重复计数。 |
x/crypto 0.54.0 → 0.58.0 |
CVE-2026-56854,0.55.0 修复;CVE-2026-56855 与 CVE-2026-78662,0.56.0 修复 | SSH source-address 认证限制与死锁;本程序未导入受影响包,仅属模块级升级。 |
x/text 0.40.0 → 0.43.0 |
CVE-2026-56851,0.41.0 修复 | secure/precis Nickname 变换 panic;本程序未导入受影响包。 |
2026-10-23 的 govulncheck 核验中,v1.5.0 候选在 Darwin/arm64、Linux/amd64 和 Windows/amd64 均 没有符号级或导入包级已知漏洞。未导入的 OpenPGP 包仍保留无修复版本的模块级公告 GO-2026-5932,因此不宣称所有依赖模块零告警。只升级 Go、保留旧依赖仍有五项 x/net 匹配,工具链与依赖升级都不可省略。
请使用重新构建的发行制品:只更新主机上的 Go 编译器,不会改变已经编译的 Exporter 二进制。
升级提示
-
同步部署采集器配置。 仅替换二进制不会应用 SQL 与标签修正。替换
/etc/pg_exporter.yml前,请先合并本地自定义配置。 -
检查
pg_sub_*标签变化。 新增datname会产生新时序;按需在 PromQL 连接与聚合中保留数据库身份。pg_sub_id仍为 Gauge。 -
补齐 PG10–13 的订阅权限。 管理员须在每个用作 Exporter 主连接数据库 的库中,对实际监控角色执行以下授权。仅在订阅所属数据库授权并不足够。它不开放
subconninfo;PG14+ 在标准目录 ACL 下无需额外授权。 -
检查接收器状态告警。
streaming=0、stopping=4、connecting=5(PG19+)、starting=6、waiting=7、restarting=8、stopped=9,未知/NULL 为-1,编码 1–3 保留。没有接收器行时仍不输出样本。 -
修正过去被容忍的非法输入。 错误 URL 转义、空 URL 文件、非有限时间值与不可达指标路径现在会校验失败。为兼容两种 HTTP mux,建议使用
/metrics。
未指定 sslmode 时仍默认 disable,远程连接需显式配置 TLS;scratch 容器验证证书时仍须挂载 CA。空 YAML 重载仍会替换为零个配置采集器,目录中的非法文件可能被跳过,SIGTERM 也不会等待活跃 HTTP 请求结束。完整运行约定见安全指南、HTTP API与内置采集器。
验证范围
发布前验证覆盖竞态测试、新旧 HTTP mux、静态分析、模块与生成配置一致性、约 60.4 万次短时模糊测试,以及六个目标平台构建。非超级用户默认采集通过 PostgreSQL 9.1–9.6、10–18、19 RC1 和 PgBouncer 1.26.1 实测。运行场景包括冲突数据库别名、特殊库名、Schema/扩展变化、失败重载、断连恢复、物理备库晋升与并发 HTTP 请求;另验证了 RPM/DEB 安装与 Docker 构建。
这些检查只覆盖记录中的版本与场景,不等于所有扩展组合和生产负载均已验证。Composite、Patroni、pgBackRest 与 PostgreSQL 日志组件仍属开发工作,不包含在 v1.5.0 中。
v1.5.0 ·
3.2 - PG Exporter v1.4.1
v1.4.1 是一次聚焦监控准确性与 RPM 升级兼容性的维护版本。
变更摘要
- 修复
pg_subrel_count在并行逻辑复制工作进程场景下重复计数的问题:先按订阅 ID 与名称去重pg_stat_subscription,再汇总各订阅关系状态 - 查询结果缺少配置声明的
LABEL列时,该采集器本轮采集会整体失败,不再生成空标签或沿用旧结果;其他非致命采集器仍会继续工作 - 官方 RPM 包名及产物文件名前缀由
pg_exporter统一为pg-exporter;新包声明兼容并替换旧包名,可直接升级 - 更新版本与独立安装包元数据,增加缺失标签列的回归测试,并在 CI 中校验 RPM 配置、产物名称及兼容元数据
升级提示
- 自定义采集器的 SQL 必须返回全部
LABEL列;即使结果为零行,返回结果的列定义也必须完整 - 若脚本直接匹配 GitHub RPM 文件名,请将
pg_exporter-*.rpm更新为pg-exporter-*.rpm
v1.4.1 ·
3.3 - PG Exporter v1.4.0
v1.4.0 引入快照直方图(Snapshot Histogram)指标类型与新的 pg_xact_age 事务年龄采集器,并对 HTTP 路由、打包与构建链进行了一轮系统性加固。
新功能
- 新增
HISTOGRAM列类型:SQL 观测按标签分组为快照分布,派生的_bucket、_count和_sum三个指标族均为 Gauge。桶边界必须有限且严格递增,自动追加+Inf。le为保留标签,重载时替换桶布局 - 新增
pg_xact_age采集器:以直方图暴露开放事务年龄(pg_xact_age_seconds)与事务中空闲年龄(pg_xact_age_idle_seconds)的分布,集群级采集,仅统计客户端后端,TTL 10 秒 - 默认配置包从 57 个定义文件增加到 58 个;
pg_xact_age编号0450,原pg_lock/pg_lock_stat/pg_query顺延为0460/0470/0480(内容不变)
修复与改进
- HTTP 路由注册隔离到私有 ServeMux,不再使用全局
DefaultServeMux,杜绝第三方库注册的端点被意外暴露 --web.telemetry-path启动时严格校验:空路径、不以/开头、含?#{}、与内置端点冲突、以及//metrics这类注册后永远无法命中的非规范路径,一律启动即报错退出- 落地页对 telemetry path 进行 HTML 转义
--fail-fast预检失败退出时正确关闭主连接池- RPM / DEB 打包修复(#105):
prometheus系统用户 HOME 指向/var/lib/prometheus(libpq 查找~/.pgpass的惯例位置),打包默认连接串补上/postgres数据库名,避免回退到以用户名命名的库 - 版本串统一为
v前缀:官方发布二进制的--version输出、/version端点与pg_exporter_build_info{version=...}标签现在为v1.4.0(此前 GoReleaser 产物为无前缀的1.3.0);产物文件名、包版本号与 Docker 镜像 tag 命名规则不变 - 直方图值转换与标量路径语义对齐:时间戳与布尔列不应用
scale缩放 - 修正 GoReleaser 内嵌包元数据:支持范围描述更新为 PostgreSQL
9.x - 19+与 PgBouncer1.8 - 1.25+ make docker恢复GOPROXY/GOSUMDB构建参数透传
工程与构建
- 构建链更新到 Go
1.26.5、exporter-toolkitv0.17.1、prometheus/commonv0.70.0 - 新增常规 CI 验证工作流:模块 tidy 校验、生成配置漂移校验(
make conf结果与config/*.yml强一致)、race 测试与六平台交叉编译 - Docker 构建工具链整合:移除
docker/目录脚本与make docker-release,多架构发布镜像统一由 GoReleaser 构建 - 配置覆盖测试泛化:测试不再假设特定采集器必然存在于配置目录中,便于裁剪自定义配置包
升级提示
-
若此前使用了非规范的 telemetry path(如
//metrics),升级后进程将拒绝启动——此前虽能启动,但指标端点实际上不可达 -
解析
pg_exporter_build_info的version标签或--version输出的自动化脚本,需要适配v前缀 -
配置了
HISTOGRAM采集器时,le不可再用作常量标签 -
对快照桶直接使用
histogram_quantile(),不要使用rate()或increase()。详见快照直方图语义。
校验和
v1.4.0 ·
3.4 - PG Exporter v1.3.0
v1.3.0 提供对 PostgreSQL 19 新指标的支持,同时刷新默认采集器包、构建链和配置覆盖测试。
变更摘要
- 默认支持范围从 PostgreSQL 10-18+ 扩展到 10-19+
- 默认配置包包含 57 个
config/*.yml定义文件 - 构建依赖更新到 Go
1.26.4、lib/pq v1.12.3、Prometheus clientv1.23.2、exporter-toolkitv0.16.0。 pg_recovery_state:在恢复节点上采集pg_stat_recovery,暴露提升触发、回放 LSN、时间线、恢复事务时间与暂停状态。pg_lock_stat:采集 PG19pg_stat_lock,按locktype暴露等待次数、等待时间和 fast-path 溢出次数。pg_vacuum_score:采集pg_stat_autovacuum_scores当前数据库摘要,暴露最大 autovacuum 分数和候选表数量。pg_wal_19:在 PG19 上暴露wal_fpi_bytes,指标名为pg_wal_fpi_bytes。pg_sub_19:基于pg_stat_subscription_stats适配序列同步与逻辑复制冲突统计,继续提供兼容旧仪表盘的sync_error_count。pg_recv:PG13+ WAL receiver 分支识别 PG19connecting状态。pg_slot:识别 PG19 replication slotidle_timeout失效原因。pg_db_confl:改为显式列清单,避免未来视图新增列被意外导出。pg_backup、pg_vacuuming、pg_clustering继续复用现有稳定分支,避免为低价值 PG19 字段改变已有指标面。
校验和
v1.3.0 ·
3.5 - PG Exporter v1.2.2
v1.2.2 将发布构建使用的 Go 更新到 1.26.2。Exporter 功能与配置不变。
校验和
v1.2.2 ·
3.6 - PG Exporter v1.2.1
v1.2.1 更新构建工具,统一配置格式,并增加配置一致性测试。采集器行为不变。
变更摘要
- 刷新构建链:发布流程与 Docker 构建基础镜像升级到 Go
1.26.1 - 统一配置样式:将当前配置与 Legacy 配置中的内联
description统一改为双引号写法,并重新生成合并后的pg_exporter.yml/legacy/pg_exporter.yml - 增加配置一致性测试:新增 split/merged config 等价性校验,以及内联指标描述风格检查,减少配置漂移风险
- 刷新打包元数据:RPM / DEB 描述中的支持范围更新为 PostgreSQL
9.x - 18+与 PgBouncer1.8 - 1.25+,并更新 Pigsty 文档入口链接
校验和
v1.2.1 ·
3.7 - PG Exporter v1.2.0
v1.2.0 更新启动流程、热重载、健康检查和配置校验,并新增 PostgreSQL 9.1–9.6 配置套件。
新功能
- 支持配置热重载:新增平台相关的信号重载(
SIGHUP/SIGUSR1),并强化POST /reload工作流,可在不重启进程情况下更新配置与查询计划 - 启动流程改为非阻塞:即使目标库预检失败,也会先启动 HTTP 服务,便于监控系统先接入后恢复
- 新增 PostgreSQL 9.1-9.6 Legacy 配置套件:提供
legacy/配置目录与make conf9目标,便于 EOL 老版本平滑接入 - 健康检查机制重构:引入缓存健康快照与周期探测,读写角色类健康端点行为更一致,重载期间更平滑
- 工程链路增强:Release 工作流增加
go test与go vet,并升级构建链到 Go 1.26.0
Bug 修复
- 修复多处配置解析边界问题:拒绝非法 metrics 定义、无效目录加载失败场景可正确报错,并补齐运行时回退逻辑
- 修复命令行布尔参数解析:正确处理
--flag=false风格传参,避免被误判为启用 - 修复
/explain输出与渲染安全性:调整内容类型并改用更安全的模板渲染路径 - 修复谓词查询与连接 URL 处理细节:增强 BOOL/BOOLEAN 条件支持、完善
dbname查询参数解析与 URL 脱敏输出 - 修复自动发现目标移除时的资源释放行为:异步关闭已移除数据库连接,降低采集阻塞风险
- 修复指标与标签校验细节:补齐常量标签冲突检查、默认值缩放处理与若干 Prometheus 规则校验
校验和
v1.2.0 ·
3.8 - PG Exporter v1.1.2
修复 pg_timeline 配置问题,并更新 Go 依赖。
校验和
v1.1.2 ·
3.9 - PG Exporter v1.1.1
小版本更新,新增采集器和 Bug 修复。
新功能
- 新增
pg_timeline采集器,用于时间线监控 - 新增
pg_sub_16采集器分支,排除订阅中的并行操作(PostgreSQL 16+ 兼容性)
Bug 修复
- 修复:为
pg_recv采集器的 slotname 添加 coalesce 以处理 NULL 值
校验和
v1.1.1 ·
3.10 - PG Exporter v1.1.0
更新依赖,使用 Go 1.25.5 构建。
采集器变更
pg_setting:针对 PG10-18 兼容性进行重大重构,支持missing_ok- 新增 15 个指标:
max_parallel_workers、max_parallel_workers_per_gather、max_parallel_maintenance_workers、shared_buffers、maintenance_work_mem、effective_cache_size、fsync、full_page_writes、autovacuum、autovacuum_max_workers、checkpoint_timeout、checkpoint_completion_target、hot_standby、synchronous_commit、io_method - 将
work_memory_size重命名为work_mem - min_version 从 9.6 改为 10,显式
::int类型转换
- 新增 15 个指标:
pg_size:修复日志目录大小检测,使用logging_collector检查代替路径模式匹配pg_table:性能优化,用 JOIN 替换 LATERAL 子查询以提升查询性能;修复tuples和frozenxid指标类型从 COUNTER 改为 GAUGE;超时从 1s 增加到 2spg_vacuuming:新增 PG17 采集器分支,包含新指标indexes_total、indexes_processed、dead_tuple_bytes用于索引 vacuum 进度跟踪pg_query:超时从 1s 增加到 2s 以应对高负载场景pg_io:修复reuses描述中的拼写错误(“in reused” -> “is reused”)pg_checkpointer:修复 pg_checkpointer_10 描述(“9.4+” -> “9.4-17”)pg_db_confl:修复 pg_db_confl_15 描述(“9.1 - 16” -> “9.1 - 15”)pg_db、pg_indexing、pg_clustering、pg_backup格式对齐修复
其他变更
- 由 @anayrat 修复发布年份
校验和
v1.1.0 ·
3.11 - PG Exporter v1.0.3
校验和
v1.0.3 ·
3.12 - PG Exporter v1.0.2
- 更新依赖,使用 Go 1.25.0 构建。
- 新增 PG Exporter 独立网站。
- 使用 GoReleaser 通过 CI/CD 流水线发布更多操作系统/架构:
- 新增 Windows amd64 支持
- 新增 Linux ppc64le 支持
校验和
v1.0.2 ·
3.13 - PG Exporter v1.0.1
- 新增 Docker Hub 镜像:pgsty/pg_exporter
- 更新 Go 依赖,使用 Go 1.24.5 构建。
- 默认禁用
pg_tsdb_hypertable采集器,因为timescaledb目录已变更
校验和
v1.0.1 ·
3.14 - PG Exporter v1.0.0
变更
新增 PostgreSQL 18 采集器分支:
| 分支 | 变更 |
|---|---|
pg_wal_18 |
移除 write、sync、write_time 和 sync_time;PostgreSQL 已将这些统计移至 pg_stat_io |
pg_checkpointer_18 |
新增 num_done 和 slru_written |
pg_db_18 |
新增 parallel_workers_to_launch 和 parallel_workers_launched |
pg_table_18 |
新增 table_parallel_workers_to_launch 和 table_parallel_workers_launched |
pg_io_18 |
新增 WAL 统计与 read_bytes、write_bytes、extend_bytes;移除 op_bytes |
pg_vacuuming_18 |
新增 delay_time |
校验和
GitHub Release 公布的 MD5 校验和:
v1.0.0 ·
3.15 - PG Exporter v0.9.0
默认采集器
- 新增
timescaledb超表指标采集器 - 新增
citus分布式节点指标采集器 - 新增
pg_wait_sampling等待事件采集器 pg_slot全面改进:新增 16/17 pg_replication_slot 指标- 允许
pg_slot采集器从 16/17 开始在从库上运行 - 重构
pg_wait采集器,从所有进程聚合 - 限制 pg_clustering、pg_indexing、pg_vacuuming 只在主库运行
- 将所有
reset_time标记为GAUGE而非COUNTER - 修复
pg_recovery_prefetch_skip_fpw类型从GAUGE改为COUNTER - 修复
pg_recv.state类型从LABEL改为GAUGE - 采集器格式改为紧凑模式
- 新增默认指标
pg_exporter_build_info/pgbouncer_exporter_build_info - 为
pg_meta采集器新增server_encoding
- 为
pg_setting新增 12 个指标:wal_block_size、segment_size、wal_segment_size、wal_level、work_memory_size、shared_memory_size、hugepage_count、hugepage_status、max_wal_size、min_wal_size、max_slot_wal_keep_size、archive_mode。
导出器代码库
- 使用最小 PG 版本后缀规范化采集器分支名称
- 为二进制包添加许可证文件
- 将仓库从
Vonng/pg_exporter迁移至pgsty/pg_exporter。 - 重构
server.go以降低Compatible和PostgresPrecheck复杂度 - 使用额外数字前缀重命名指标采集器以便排序
- 更新依赖。
- 在所有非致命采集器之前执行致命采集器,快速失败
v0.9.0 ·
3.16 - PG Exporter v0.8.1
变更
- 更新依赖。
- 升级 golang.org/x/net 从 0.35.0 到 0.36.0 #67
- 更新 Docker 镜像构建标签
v0.8.1 ·
3.17 - PG Exporter v0.8.0
变更
- 新增 PgBouncer 1.24 新指标支持(stat、pool、database)
- 修复:
310-pg_size.yml在日志目录设置不正确时失败 #64,由 @Süleyman Vurucu 贡献 - 使用最新 Go 1.24 构建并升级所有依赖
- 使用标准
log/slog重构日志,替代go-kit完整变更日志
v0.8.0 ·
3.18 - PG Exporter v0.7.1
变更
使用 dependabot 进行例行更新
- 功能:支持将配置指定为 Reader,由 @ringerc 在 #62 贡献
- 升级 golang.org/x/crypto 从 0.21.0 到 0.31.0,由 @dependabot 在 #63 贡献
- 修复一些拼写错误 完整变更日志
v0.7.1 ·
3.19 - PG Exporter v0.7.0
变更
更新代码库以使用 Go 1.22.4。
-
PostgreSQL 17 指标支持,由 @Vonng 贡献
-
pg_exporter: “bind: address already in use” 后不再 panic,由 @ringerc 贡献
-
修复一些拼写错误和指标描述错误,由 @ringerc 贡献
-
新增 PgBouncer 1.23 指标(源码提交)。
-
修正日志调用位置(#55,@ulysseskk)。
v0.7.0 ·
3.20 - PG Exporter v0.6.1
变更
- 将
golang.org/x/net从v0.10.0升级到v0.17.0,并将golang.org/x/crypto升级到v0.17.0,纳入安全修复(#38 对应x/crypto) - 修复
connect-timeout传递问题(#37),由 @mouchar 贡献
校验和
原始 Release 为压缩包与软件包发布了 MD5 校验和:
v0.6.1 ·
3.21 - PG Exporter v0.6.0
变更
- 更新依赖,修复已报告的漏洞。
- 新增 PostgreSQL 16 采集器,并修复 PostgreSQL 15 兼容问题(#35,@japinli)。
- 新增 ARM64 软件包。
- 移除
pg_query查询中固定的monitor模式。pg_stat_statements须通过search_path可见,例如安装在public中。 - 配置目录同时接受
.yml与.yaml文件(#34,@japinli)。 - 将 PgBouncer 版本解析日志从 info 级别改为 debug。
- 为
pg_table_10_12补充缺失的relid列。
v0.6.0 ·
3.22 - PG Exporter v0.5.0
导出器变更
- 使用 nFPM 构建 RPM 和 DEB 包。
- 新增
column.default,用指定值替代 NULL。 - 新增
column.scale,用于数值缩放,例如将微秒转换为秒。 - 修复
/stat输出。 - 新增
pgsty/pg_exporterDocker 镜像。
采集器变更
- 将
pg_wal、pg_query、pg_db、pg_bgwriter、pg_ssl和pgbouncer_stat的时间指标统一为秒。 - 将
pg_class指标移入pg_table与pg_index。 - 默认启用
pg_table_size。
v0.5.0 ·
3.23 - PG Exporter v0.4.1
变更
- 对象监控排除 Citus 与 TimescaleDB 内部模式。
- 移除重复的
pg_statio行。 - 新增 PgBouncer 1.16 支持。
- 修复 PostgreSQL 12 上
pg_repl采集器分支重叠的问题。 - 新增
-T、--connect-timeout和PG_EXPORTER_CONNECT_TIMEOUT,用于控制本地或远程目标的连接超时。 - 将 RPM 中的配置文件从
pg_exporter.yaml改名为pg_exporter.yml。
v0.4.1 ·
3.24 - PG Exporter v0.4.0
变更
- 新增 PostgreSQL 14 支持。
- 调整默认指标配置,继续支持旧配置文件。
- 新增
--auto-discovery、--include-database和--exclude-database。 - 通过自动发现支持多数据库采集。
v0.4.0 ·
3.25 - PG Exporter v0.3.2
变更
- 修复脱敏连接串的边界情况。
- 修正文档与拼写错误。
v0.3.2 ·
3.26 - PG Exporter v0.3.1
变更
修复默认配置错误,主要影响 PostgreSQL 13 之前的版本:
- 将
primary_conninfo采集限制在支持它的采集器分支。 - 为
pg_func增加funcid标签,区分同名函数。 - 将版本输出中的程序名修正为
pg_exporter。
v0.3.1 ·
3.27 - PG Exporter v0.3.0
变更
- 更新默认配置,支持 PostgreSQL 13 指标,包括
pg_slru、pg_shmem、pg_query13和pg_backup。 - 新增健康与恢复状态检查的 HTTP 端点。
- 在初始化完成前提供 HTTP 服务,并报告
pg_up 0。 - 连接 URL 未指定
sslmode时,补充sslmode=disable。 - 修复程序与拼写错误。
v0.3.0 ·
3.28 - PG Exporter v0.2.0
变更
- 新增供 YUM 安装的 RPM 包及 Linux 服务定义。
- 为查询配置新增
skip选项。 - 修复
pgbouncer_up指标。 - 新增配置重载支持。
v0.2.0 ·
3.29 - PG Exporter v0.1.2
变更
- 修复
pgbouncer_up指标。 - 新增动态配置重载。
- 移除分片相关逻辑。
- 在默认配置中新增
bulky模式。
v0.1.2 ·
3.30 - PG Exporter v0.1.1
变更
- 修复查询失败导致启动挂起的问题。
v0.1.1 ·
3.32 - PG Exporter v0.0.5
这是一个只有 Git 标签、没有独立 GitHub Release 对象的早期版本;本文依据标签提交与历史汇总文档归档。
变更
- 为每个采集器查询增加超时控制
- 以
fatal采集器策略替代早期的skip_error行为 - 调整采集器优先级语义
- 修复内置的
pg_up指标 - 为每个内置采集器补充文档
v0.0.5 ·
3.33 - PG Exporter v0.0.4
变更
在 200 多个生产节点上测试约两周。
v0.0.4 ·
3.34 - PG Exporter v0.0.3
变更
通过生产环境测试;项目当时仍处于快速开发阶段。
v0.0.3 ·
3.36 - PG Exporter v0.0.1
此早期版本只有 Git 标签,没有独立 GitHub Release。本文依据标签和历史发布摘要整理。
变更
- 新增 PgBouncer 模式。
v0.0.1 ·